278
Содержание
- Что такое kafka-get-offsets.sh
- Как Kafka считает офсеты в партиции
- Базовый запуск команды kafka-get-offsets.sh
- Флаг --time. Earliest, latest и поиск по метке времени
- Фильтрация по топику и партиции
- Все флаги kafka-get-offsets.sh
- Практические сценарии
- Сценарий 1. Подготовка к kafka-delete-records.sh
- Сценарий 2. Ручной подсчёт размера топика
- Сценарий 3. Поиск точки входа после инцидента
- Сценарий 4. Мониторинг в скрипте
- Как kafka-get-offsets.sh соотносится с другими утилитами
- Аналог через kcat
- Диаграмма - как работает запрос офсетов
- Что дальше
- Референсные ссылки
- Все уроки курса
В уроке 25 мы разбирались с kafka-broker-api-versions.sh — смотрели, какие версии протокола поддерживает брокер, и учились диагностировать ошибки UNSUPPORTED_VERSION при rolling upgrade. Там речь шла о низкоуровневой совместимости на уровне API.
Сегодня спускаемся на уровень ниже — не к протоколу, а к данным. Конкретно к офсетам. Любой, кто разбирается с lag-ом консьюмеров, готовится запустить kafka-delete-records.sh или просто хочет понять, сколько сообщений накопилось в партиции, в первую очередь задаёт один вопрос: «Какой сейчас earliest и latest офсет?» Именно для этого существует kafka-get-offsets.sh.
Утилита простая, но незаменимая в повседневной диагностике. В курсе «Администрирование кластера Kafka» мониторинг офсетов разбирают в блоке операционных задач — рядом с retention-политиками и управлением лагом consumer-групп.
Что такое kafka-get-offsets.sh
kafka-get-offsets.sh — утилита командной строки из стандартного набора Apache Kafka, которая возвращает офсеты для топиков и партиций. Она напрямую опрашивает брокер через API ListOffsets и выдаёт результат в виде строк формата топик:партиция:офсет.
Это не метрика и не лог — это снимок текущего состояния границ лога. Утилита показывает два принципиально разных типа офсетов: начало (earliest) и конец (latest) видимого диапазона каждой партиции. Кроме того, она умеет принимать временную метку и возвращать первый офсет, который был записан не раньше этого момента.
Важно: kafka-get-offsets.sh работает без consumer group. Она не читает сообщения и не трогает committed offsets. Это чистый query к брокеру о состоянии партиции.
Как Kafka считает офсеты в партиции
Прежде чем идти дальше, стоит разобраться с тем, что именно возвращает утилита. В каждой партиции Kafka поддерживает два ключевых показателя.
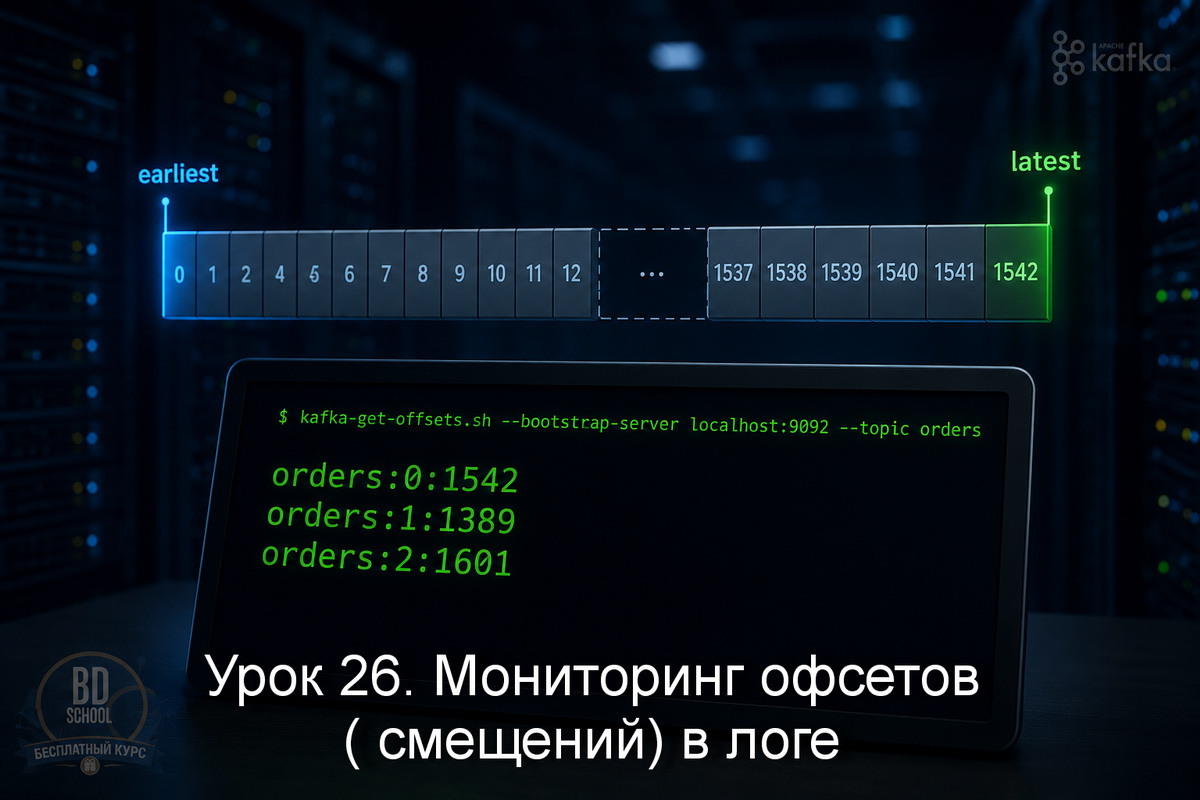
Log start offset (он же earliest, он же low watermark) — это минимальный офсет, доступный для чтения. Всё, что ниже этой границы, уже удалено по retention-политике или через kafka-delete-records.sh. Новый консьюмер с позицией auto.offset.reset=earliest начнёт читать именно отсюда.
Log end offset (он же latest, он же high watermark) — это офсет следующей записи, которая будет добавлена в партицию. Последнее доступное сообщение имеет офсет на единицу меньше. Консьюмер с позицией auto.offset.reset=latest начнёт читать начиная с этого значения — то есть только новые сообщения после запуска.
Разница между latest и earliest показывает, сколько сообщений сейчас доступно в партиции. Это не то же самое, что общее количество записанных сообщений — часть могла уже уйти по retention. Это и есть «видимый» размер лога.
Apache Kafka: администрирование кластера
Код курса
KAFKA
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Базовый запуск команды kafka-get-offsets.sh
Без дополнительных флагов утилита возвращает latest-офсеты для всех партиций всех топиков кластера:
kafka-get-offsets.sh --bootstrap-server localhost:9092
Вывод — по одной строке на каждую партицию. Например, для кластера с двумя топиками по три партиции вы получите шесть строк:
# Пример вывода: топик:партиция:офсет
orders:0:1542
orders:1:1389
orders:2:1601
payments:0:842
payments:1:756
payments:2:819
Формат топик:партиция:офсет постоянный — его удобно парсить в скриптах через awk или cut.
Без флага —time утилита по умолчанию возвращает latest. Если нужен earliest — указывайте явно.
Флаг —time. Earliest, latest и поиск по метке времени
Ключевой флаг утилиты — —time. Он принимает три варианта значений.
- latest — вернуть log end offset (значение по умолчанию).
- earliest — вернуть log start offset, то есть первый доступный офсет.
- числовая метка времени в миллисекундах — вернуть первый офсет, чья временная метка не меньше указанной. Это позволяет найти «точку входа» для конкретного момента времени.
Запрос earliest-офсетов для конкретного топика выглядит так:
kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --time earliest
Сравнив вывод с latest, можно сразу посчитать, сколько сообщений сейчас живёт в каждой партиции топика.
Поиск по временной метке особенно полезен при инцидентах. Скажем, нужно найти офсет, соответствующий 6:00 UTC 1 мая 2025 года. Переводим метку в миллисекунды и передаём значение:
# 2025-05-01 06:00:00 UTC = 1746075600000 мс

kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --time 1746075600000
Брокер вернёт первый офсет в каждой партиции, чья временная метка больше или равна указанной. Если в тот момент данных ещё не было — вернёт -1. Если все данные уже ушли по retention — тоже -1.
Фильтрация по топику и партиции
Запускать утилиту по всему кластеру не всегда разумно — в production-среде топиков могут быть сотни. Для адресного запроса есть два флага. —topic ограничивает вывод одним топиком. Его можно указать несколько раз, если нужно запросить несколько конкретных топиков:
kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --topic payments \
  --time latest
—partitions принимает список номеров партиций через запятую. Используется вместе с —topic:
# Получить latest-офсет только для партиций 0 и 2 топика orders
kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --partitions 0,2 \
  --time latest
Такая фильтрация сокращает нагрузку на брокер при частых опросах — особенно если скрипт мониторинга гоняется каждые 30 секунд.
Все флаги kafka-get-offsets.sh
Утилита немногословна по части опций, но каждый флаг нужен в своём сценарии. Вот полная таблица:
| Флаг | Значение / формат | Описание |
|---|---|---|
| —bootstrap-server | host:port | Адрес брокера. Обязательный параметр |
| —topic | имя топика | Фильтр по топику. Можно указать несколько раз |
| —partitions | 0,1,2 (через запятую) | Фильтр по номерам партиций. Только вместе с —topic |
| —time | earliest / latest / мс | Какой офсет вернуть. По умолчанию latest |
| —exclude-internal-topics | нет значения (флаг) | Исключить служебные топики (__ |
| —command-config | путь к файлу .properties | Файл с настройками безопасности (SASL/SSL) |
Флаг —exclude-internal-topics удобен при полном сканировании кластера — без него в вывод попадёт __consumer_offsets и другие служебные топики, что засоряет картину.
Apache Kafka для инженеров данных
Код курса
DEVKI
Ближайшая дата курса
7 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практические сценарии
Сценарий 1. Подготовка к kafka-delete-records.sh
Перед сдвигом log start offset нужно знать текущие границы. Правильный порядок действий — сначала запросить earliest и latest, убедиться, что понимаете что и где лежит, и только потом писать JSON-файл для удаления.
# Шаг 1: смотрим нижнюю границу
kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --time earliest

# Шаг 2: смотрим верхнюю границу
kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --time latest
После этого вы точно знаете, в каком диапазоне лежат данные каждой партиции — и можно безопасно задавать целевые офсеты для kafka-delete-records.sh.
Сценарий 2. Ручной подсчёт размера топика
Быстро оценить, сколько сообщений сейчас доступно в топике, можно одной командой с небольшим конвейером:
# Считаем сумму latest-офсетов по всем партициям топика orders

kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --time latest \
  | awk -F: '{sum += $3} END {print "Total latest offsets:", sum}'
Результат — не точное количество сообщений (часть могла уйти по retention), а сумма latest-офсетов. Для оценки объёма и сравнения с предыдущими снимками этого достаточно.
Сценарий 3. Поиск точки входа после инцидента
Инцидент случился в 10:30 UTC. Нужно передать консьюмеру офсет, с которого начинались проблемные данные. Узнаём метку времени в миллисекундах и делаем запрос:
# Получить Unix timestamp в миллисекундах для 2025-05-03 10:30:00 UTC
TS=$(date -u -d "2025-05-03 10:30:00" +%s%3N)
echo "Timestamp: $TS"

kafka-get-offsets.sh \
  --bootstrap-server localhost:9092 \
  --topic orders \
  --time $TS
Полученные офсеты можно передать в kafka-consumer-groups.sh —reset-offsets —to-offset или использовать напрямую в consumer-коде через метод seek().
Сценарий 4. Мониторинг в скрипте
Минимальный bash-скрипт для периодического снятия снимка состояния топиков и сохранения в файл:
#!/bin/bash

# Снимок latest-офсетов для мониторинга. Запускать через cron каждые 5 минут.

BOOTSTRAP="localhost:9092"
SNAPSHOT_DIR="/var/log/kafka-offsets"
mkdir -p "$SNAPSHOT_DIR"

TIMESTAMP=$(date -u +"%Y%m%d_%H%M%S")
OUTPUT="$SNAPSHOT_DIR/offsets_${TIMESTAMP}.txt"

kafka-get-offsets.sh \
  --bootstrap-server "$BOOTSTRAP" \
  --exclude-internal-topics \
  --time latest > "$OUTPUT"

echo "Saved: $OUTPUT ($(wc -l < "$OUTPUT") partitions)"
Накопленные снимки позволяют строить тренды роста топиков и замечать аномальные скачки без Prometheus и Grafana — достаточно простого diff или awk.
Как kafka-get-offsets.sh соотносится с другими утилитами
Офсеты в Kafka можно получить несколькими инструментами — разница в том, что именно каждый из них показывает.
| Инструмент | Что показывает | Когда использовать |
|---|---|---|
| kafka-get-offsets.sh | Log start / end offset партиции (earliest, latest, по времени) | Диагностика топика, подготовка к delete-records, поиск офсета по времени |
| kafka-consumer-groups.sh | Committed offset группы, lag, текущее положение каждого консьюмера | Мониторинг и управление consumer group, сброс офсетов |
| kafka-dump-log.sh | Содержимое лог-сегментов с диска, офсеты внутри батчей | Глубокая диагностика, анализ отдельных файлов сегментов |
| kcat -Q | Офсеты через low-level query к брокеру | Быстрый разовый запрос без установки Kafka bin |
Разница между kafka-get-offsets.sh и kafka-consumer-groups.sh важна на практике. Первый показывает, что есть в партиции. Второй показывает, где находится группа внутри этого диапазона. Lag — это разница между тем, что видит второй, и верхней границей, которую показывает первый.
Аналог через kcat
Если Kafka bin недоступен, те же данные можно получить через kcat (kafkacat). Флаг -Q делает именно то, что нужно — запрашивает офсет для заданного топика, партиции и временной метки:
# Получить earliest-офсет для orders, партиция 0
kcat -b localhost:9092 -Q -t orders:0:0

# Получить latest-офсет для orders, партиция 0
kcat -b localhost:9092 -Q -t orders:0:-1

# Поиск по временной метке (ms) для партиции 1
kcat -b localhost:9092 -Q -t orders:1:1746075600000
Синтаксис -t топик:партиция:timestamp при этом использует те же зарезервированные значения: 0 = earliest, -1 = latest, число в мс = поиск по времени. Для ad hoc запросов kcat удобнее — одна строка вместо полного пути к kafka-get-offsets.sh.
Apache Kafka: администрирование кластера
Код курса
KAFKA
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Диаграмма — как работает запрос офсетов
flowchart LR
    CLI["kafka-get-offsets.sh\n--bootstrap-server\n--topic / --time"] --> BK["Брокер-лидер\nпартиции"]
    CLI -->|"ListOffsets API\n(API Key 2)"| BK
    BK -->|"earliest"| LSO["Log Start Offset\n(low watermark)"]
    BK -->|"latest"| LEO["Log End Offset\n(high watermark)"]
    BK -->|"timestamp"| TSO["Первый офсет\n>= timestamp"]
    LSO --> OUT["Вывод:\nтопик:партиция:офсет"]
    LEO --> Out2["Вывод:\nтопик:партиция:офсет"]
    TSO --> OUT3["Вывод:\nтопик:партиция:офсет\n(-1 если нет данных)"]
Запрос идёт напрямую к лидеру каждой партиции. Для топика с тремя партициями на разных брокерах утилита выполнит три отдельных ListOffsets-запроса — по одному к каждому лидеру.
Что дальше
В следующем уроке переходим к kafka-verifiable-producer.sh и kafka-verifiable-consumer.sh. Эта пара утилит создана специально для тестирования — они отправляют и читают сообщения с подробным логированием каждого события: что отправлено, с каким офсетом, на какую партицию, было ли подтверждение. Незаменимо при проверке надёжности кластера и экспериментах с acks, retries и delivery semantics.
Референсные ссылки
- Apache Kafka Documentation — ListOffsets API: kafka.apache.org/documentation — consumer lag and offsets
- Apache Kafka 4.2 Release Notes (2025): kafka.apache.org/blog
- Confluent Developer — Offset Management in Apache Kafka (2025): developer.confluent.io — consumers-and-offsets
- kcat (kafkacat) — Query Offsets with -Q: github.com/edenhill/kcat
- KIP-392: Allow consumers to fetch from closest replica — использование офсетных запросов (Apache Kafka Wiki, актуально для Kafka 4.x): cwiki.apache.org — KIP-392