
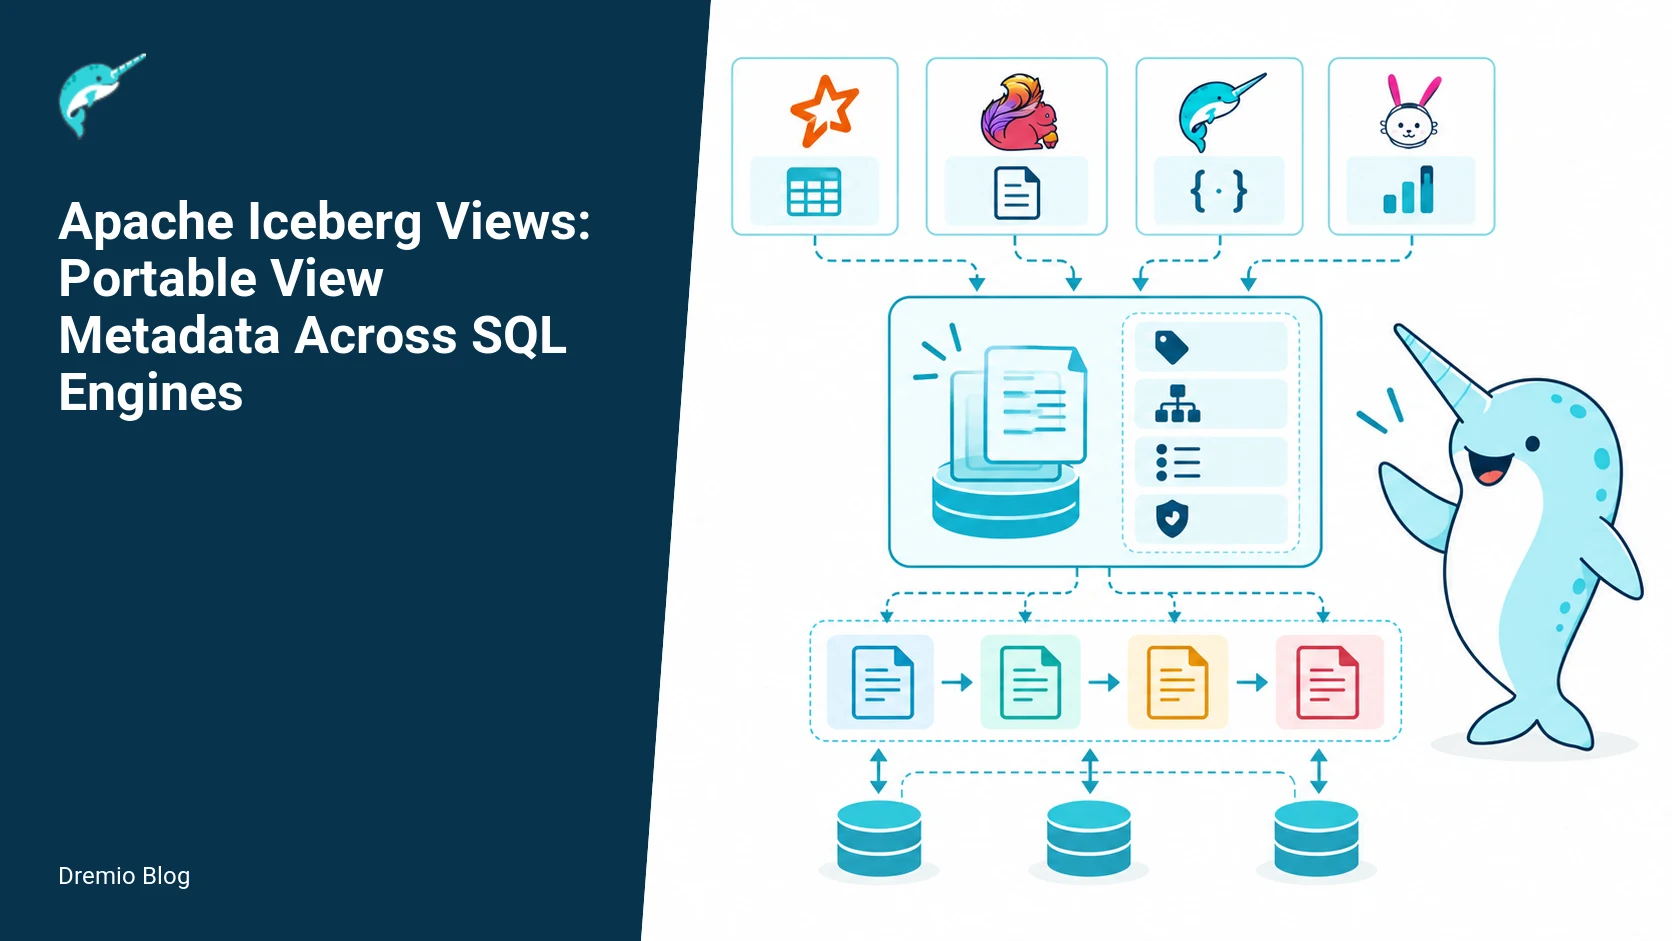
Apache Iceberg добавил в спецификацию поддержку представлений с хранением метаданных прямо в каталоге. Теперь SQL-запрос, схема, версии и зависимости описываются один раз и становятся доступны разным движкам без пересоздания. Это решает задачу совместного использования views в Sp
ClickHouse исправил причину лишней задержки в 32 мс на простых SELECT-запросах через Native-протокол. После простоя соединения больше двух секунд окно перегрузки TCP сбрасывалось, а несколько мелких пакетов метаданных не помещались в него сразу. Это вызывало дополнительный круг о
Статья на Habr сравнивает практические варианты мониторинга и логирования корпоративного хранилища. Авторы показывают, как инструменты закрывают конкретные уровни контроля - от состояния серверов до качества данных и влияния сбоев на downstream. Разбор помогает инженерам понять,
Разработчики распределённых аналитических баз часто сталкиваются с ситуацией, когда тяжёлый запрос внезапно зависает. План EXPLAIN показывает структуру, но не даёт ответа, на каком этапе сейчас находится выполнение и что именно тормозит: перекос данных, spill на диск или ожидание
В корпоративных хранилищах данных сбой может возникнуть на любом участке конвейера: при выгрузке из источников, во время трансформаций или на уровне СУБД. Техническая доступность кластера ещё не означает, что данные приходят вовремя и в полном объёме. Observability позволяет соби
Компания столкнулась с разросшимся корпоративным DWH на PostgreSQL, где цепочка загрузки и обработки данных стала непрозрачной. Разработчики тратили дни на восстановление логики расчётов, а обновление отчётов занимало часы. Переход на ClickHouse и XLTable позволил пересобрать кон
ClickHouse добавил удобный способ загружать данные из Parquet-файлов напрямую в MySQL. Инженеры получают инструмент для разовых и регулярных задач миграции без написания отдельного ETL-кода. Решение опирается на table functions и named collections, что упрощает подключение и повт
ClickHouse всегда нуждался в строгой координации для репликации, распределённых DDL и назначения блоков, хотя сами данные расходятся по eventually consistent модели. ZooKeeper давал нужную семантику сессий, эфемерных узлов и последовательных znode, но требовал отдельного Java-про
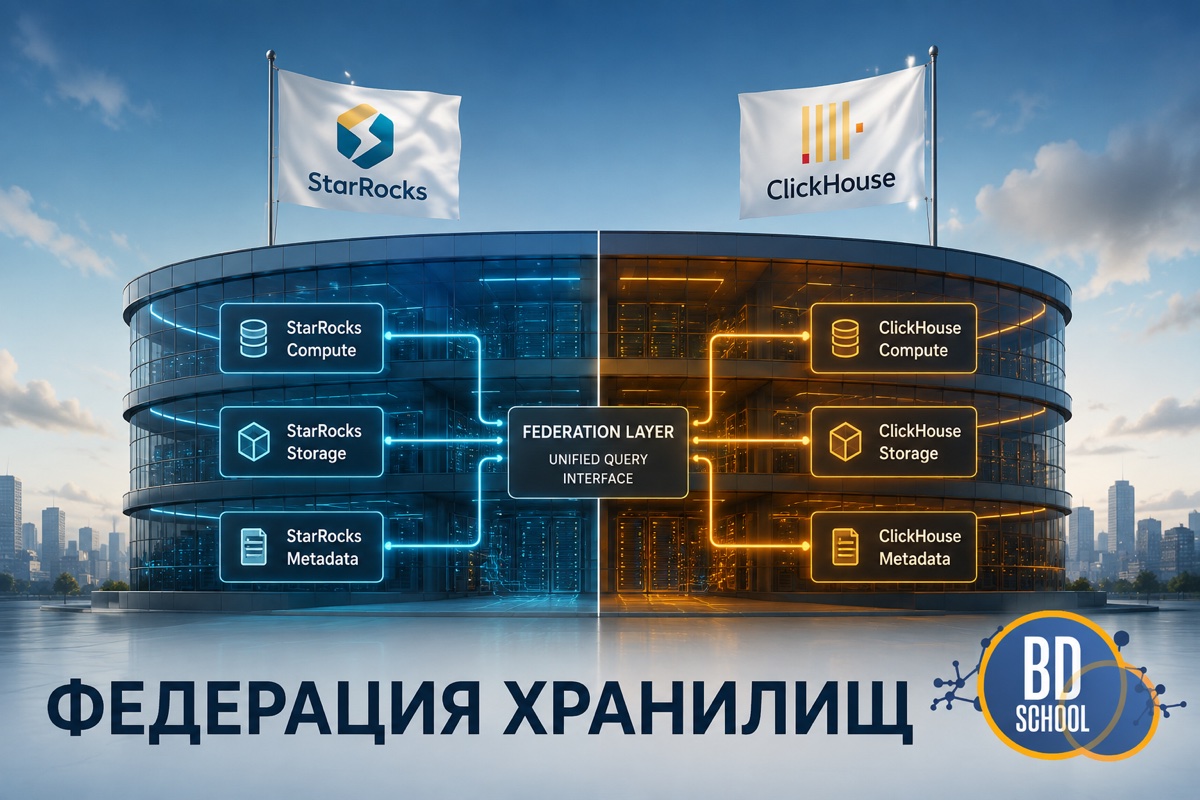
Выбор между StarRocks и ClickHouse часто ставят как или-или. Но зрелый ландшафт данных строят иначе: две базы не конкурируют, а дополняют друг друга. ClickHouse отлично держит холодные петабайты логов и событий, а StarRocks выступает вычислительным слоем для сложных ad-hoc запросов BI. Связать их позволяет федерация данных. В этой статье...
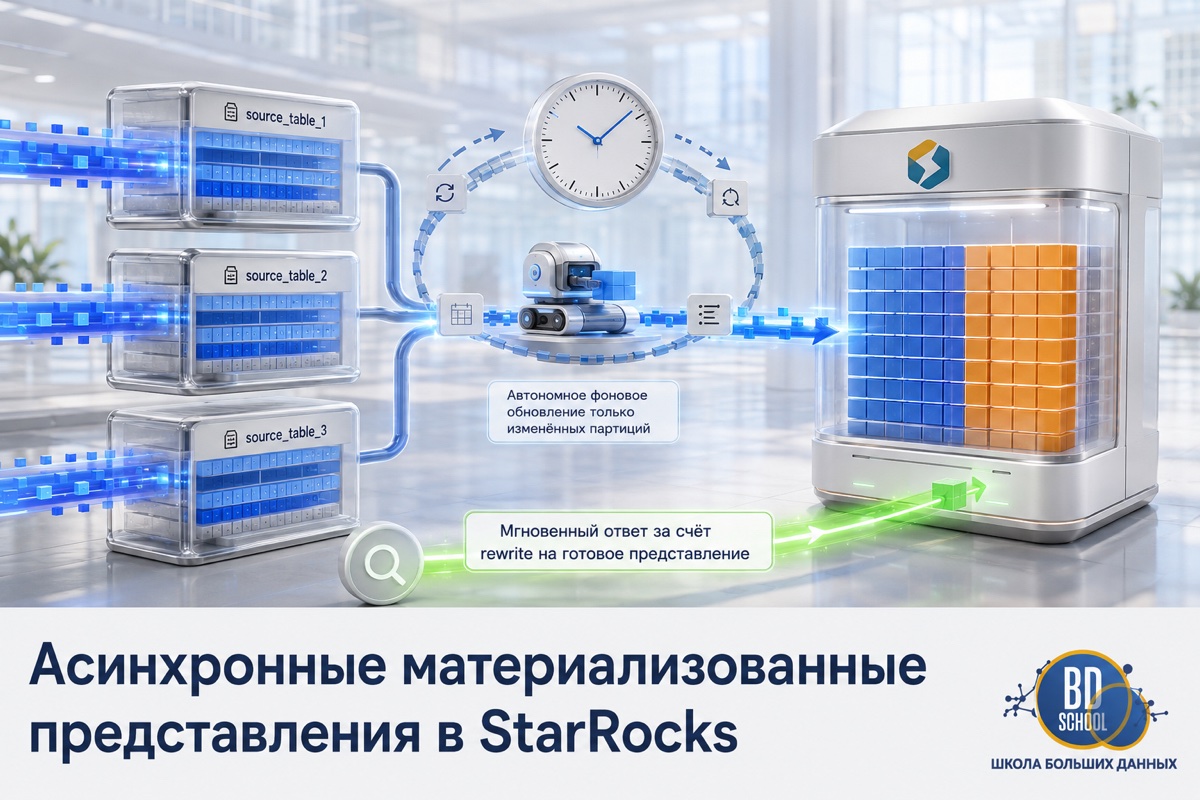
Типичное хранилище со временем обрастает зоопарком витрин. Десятки скриптов на cron пересчитывают агрегаты, гоняют одни и те же джойны по кругу и жгут процессорное время. Часть этой работы можно убрать внутрь самой СУБД. В StarRocks для этого есть асинхронные материализованные представления, которые обновляются по расписанию и инкрементально, по одной партиции....
Аналитика реального времени начинается с того, что данные попадают в хранилище с минимальной задержкой после появления в источнике. Для StarRocks таким мостом из Apache Kafka служит Routine Load, встроенный механизм непрерывной загрузки потока прямо в таблицу. В этой статье соберем рабочий пайплайн: продюсер шлет JSON-события заказов в Kafka, а StarRocks...
Наша школа проводит открытый вебинар по теме: "On‑line аналитика: как строить хранилище, которое пишет и считает одновременно" . Узнайте, как объединить потоковую загрузку и быстрые аналитические запросы без компромиссов, какие технологии реально работают в production и как строится потоковая архитектура (CDC → Kafka → Flink → StarRocks → BI). Приглашаем...
Инженеры данных часто спорят, какая колоночная СУБД быстрее. Спор бессмысленный без контекста нагрузки. ClickHouse и StarRocks решают разные задачи, хотя обе относятся к классу аналитических OLAP-движков. В этой статье мы разберем их архитектуру, покажем разницу в обработке соединений таблиц и соберем локальный стенд для честного нагрузочного теста на нормализованной...
До этого момента все наши DAG-и жили по расписанию. schedule_interval='@daily' - это классика. Но современный бизнес не хочет ждать "утреннего отчета". Если данные прилетели в 14:00, отчет должен быть готов в 14:10, а не на следующее утро. Здесь мы сталкиваемся с фундаментальным конфликтом: Airflow - это Batch-инструмент (запускает задачи...
Поздравляем! Если вы читаете эти строки, значит, вы прошли полный путь от первого изучения ClickHouse до понимания его самых глубоких механизмов. За эти десять статей мы превратились из новичков, задающихся вопросом "Что такое колоночная СУБД?", в уверенных пользователей, способных не только писать сложные аналитические запросы, но и проектировать, оптимизировать и...
Мы с вами научились виртуозно писать запросы, строить сложные аналитические отчеты и интегрировать ClickHouse с другими системами. Но чтобы вся эта мощь работала стабильно и предсказуемо в production, кластер требует внимания и ухода. Написание запросов — это работа аналитика или разработчика, а поддержание здоровья системы — это задача администратора баз...
Оконные функции ClickHouse и работа с массивами данных. Мы с вами уже прошли большой путь: научились эффективно хранить данные, оптимизировать таблицы, выполнять базовые и сложные запросы и даже интегрироваться с внешними системами. Казалось бы, мы можем практически всё. Но как ответить на такие вопросы: "Каково время между последовательными действиями каждого...
До сих пор мы рассматривали ClickHouse как самостоятельную систему: создавали в нем таблицы и загружали данные. Однако в реальном мире данные редко живут в одном месте. Транзакционная информация находится в реляционных базах вроде MySQL или PostgreSQL, архивы логов — в объектных хранилищах типа Amazon S3, а потоки событий в реальном...
Итак, вы освоили типы данных, создали таблицы на правильных движках MergeTreeи даже научились писать сложные запросы. Кажется, что вы готовы к работе с реальными данными. Однако на больших объемах вы можете столкнуться с ситуацией, когда даже на мощном "железе" запрос выполняется не так быстро, как хотелось бы. В чем же...
В предыдущих статьях мы узнали, что семейство движков MergeTree — это основа для хранения аналитических данных в ClickHouse. Мы создавали таблицы с помощью базового MergeTree и даже упоминали о его специализированных версиях. Теперь пришло время для глубокого погружения. Эти движки — не просто вариации, а мощные инструменты, которые выполняют часть...