
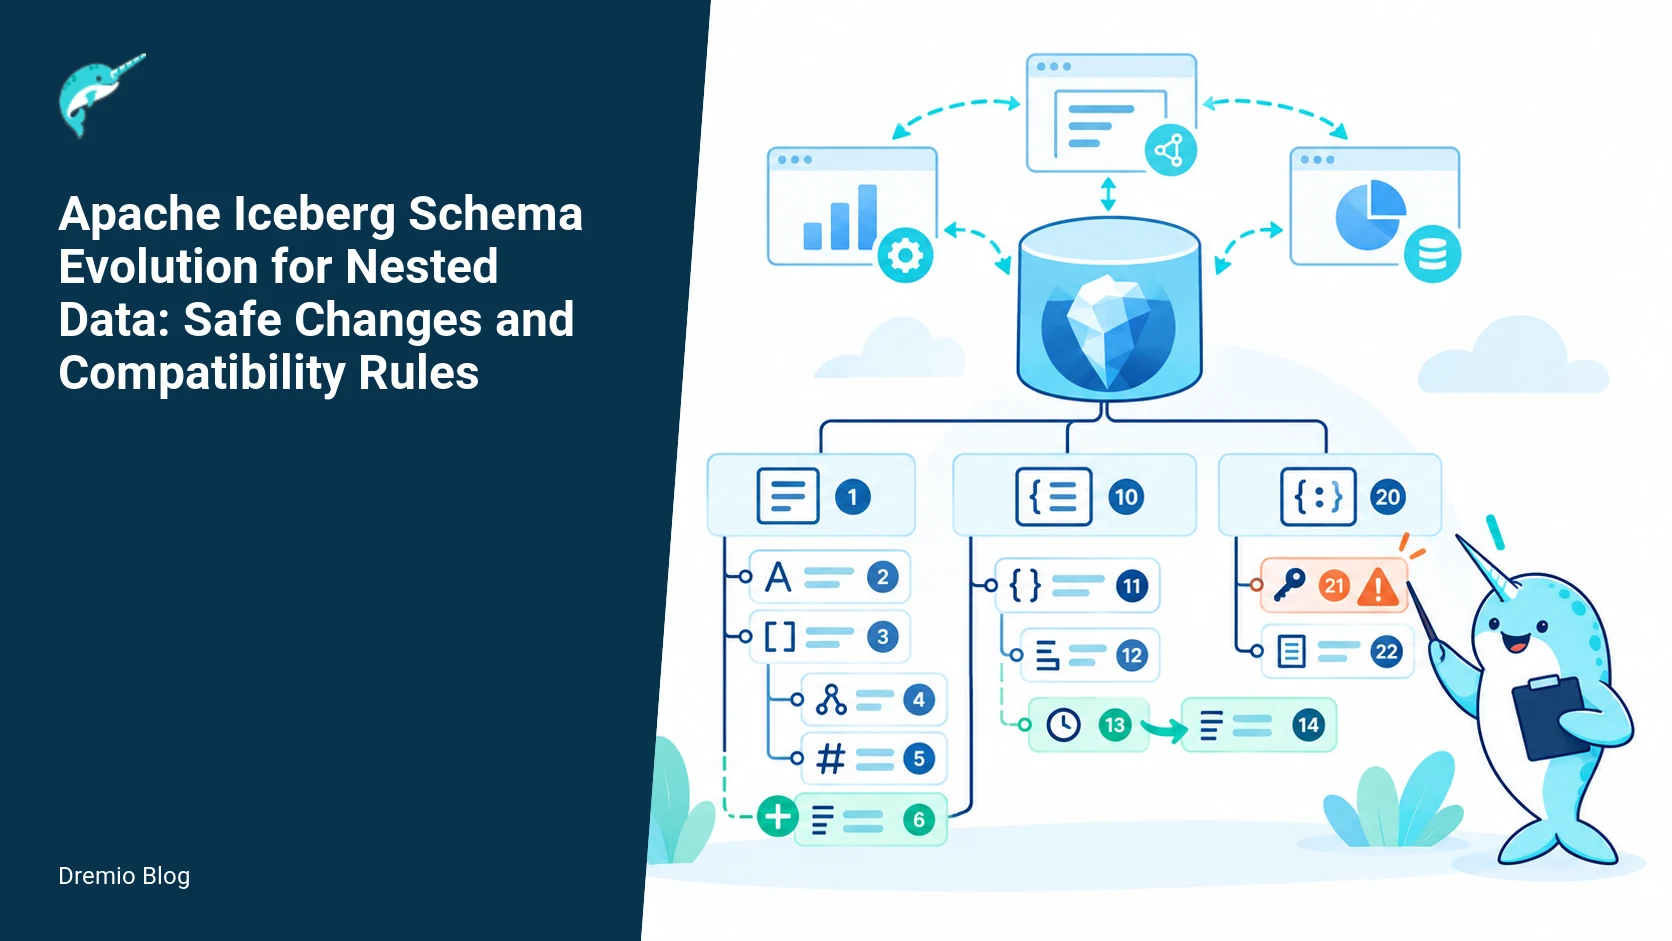
Dremio опубликовала разбор правил эволюции схем для вложенных структур Apache Iceberg. Материал показывает, как менять вложенные struct, list и map так, чтобы таблицы оставались читаемыми в Spark, Trino и других движках. Главный акцент сделан на field ID, правилах nullability и t
MinIO потерял статус стандартного решения для on-premise lakehouse. Комьюнити-редакция ушла в архив, а Iceberg-таблицы требуют точного набора операций с объектами. Командам нужно оценить альтернативы по реальным паттернам чтения и записи, а не по общей фразе «S3-совместимость».
Delta Lake предлагает отказаться от Hive-стильного сегментирования в облачных хранилищах и перейти к кластеризации данных. Hive-стильное сегментирование подразумевает создание отдельных папок для значений ключевых колонок, например по дате или региону, что приводит к большому чис
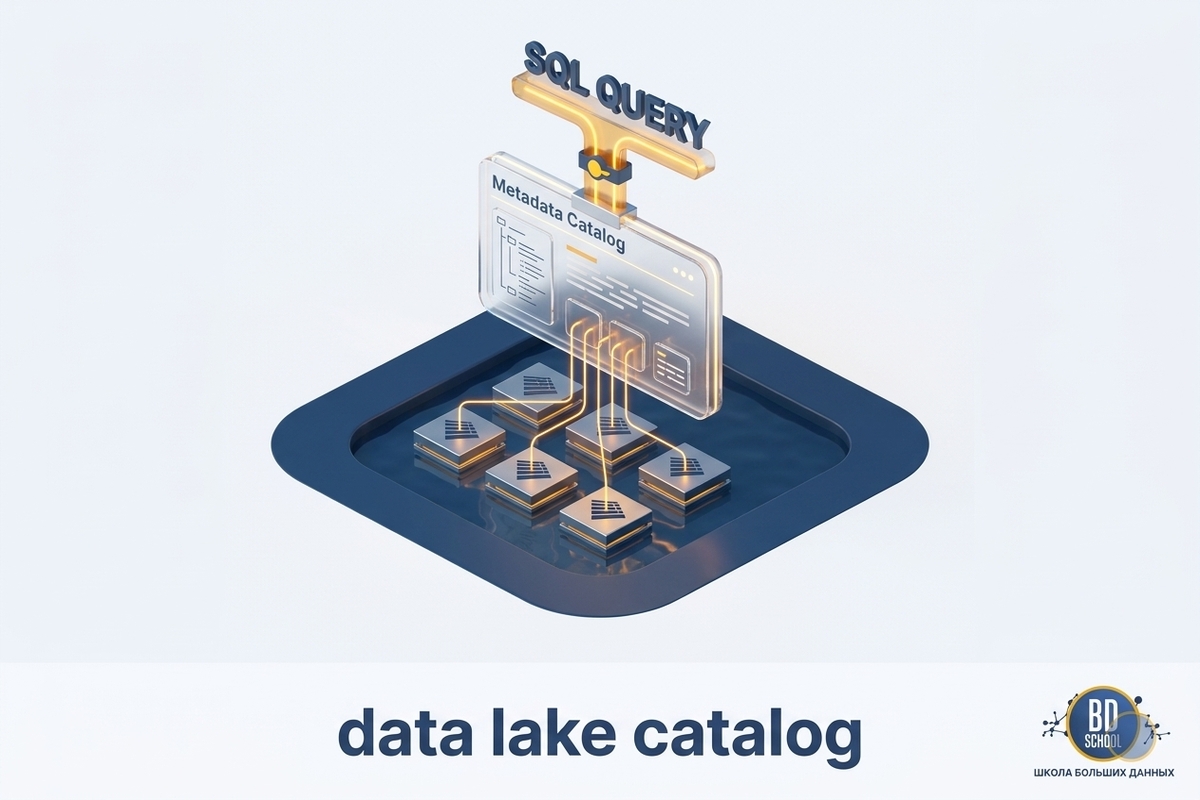
7 октября 2026 года команда DuckDB показала, как собрать каталог озера данных (data lake catalog) из файла DuckDB, в котором нет ни одной строки данных. В файле лежат только представления (view) над Parquet в объектном хранилище (object storage), а коллеги подключают его по ссылке и сразу пишут SQL. Приём...
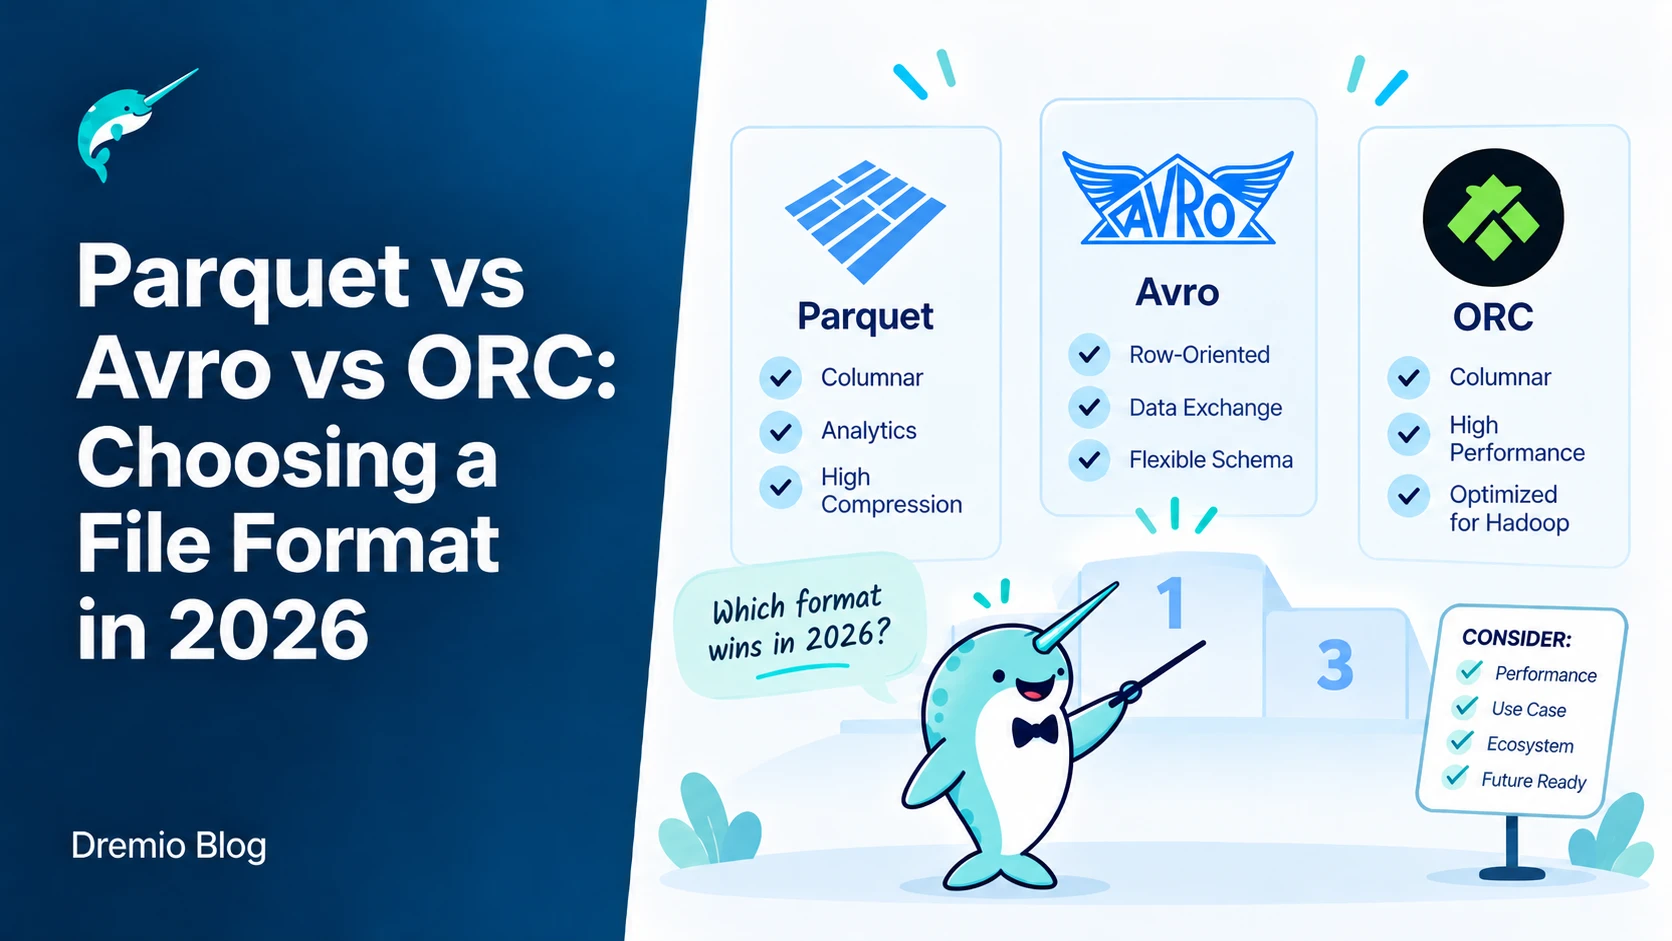
Сравнение Parquet, Avro и ORC помогает инженерам DWH подобрать формат под конкретные нагрузки чтения и записи. Parquet и ORC оптимизированы для аналитических запросов за счёт колоночной организации, Avro лучше справляется с частыми изменениями схемы при потоковой записи. Apache I
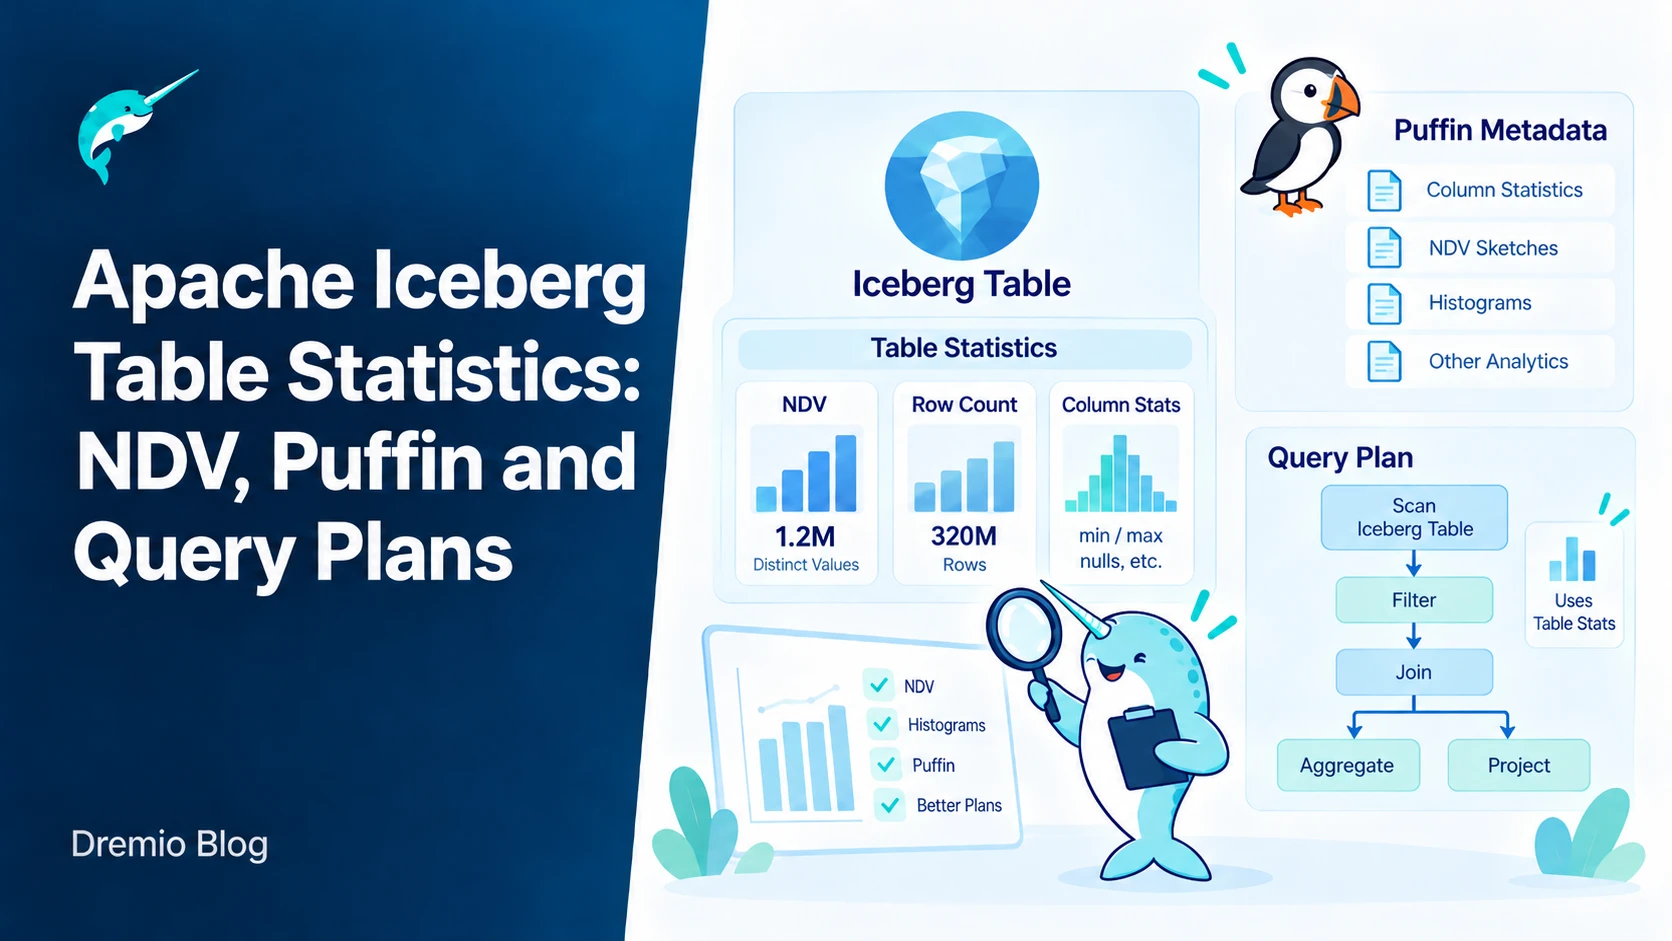
Dremio описала, как Apache Iceberg хранит границы значений на уровне файлов автоматически, но точные NDV-статистики на уровне таблицы требуют отдельного вычисления. Без них планировщик запросов часто выбирает неоптимальный порядок соединений и сканирования, особенно в больших озё
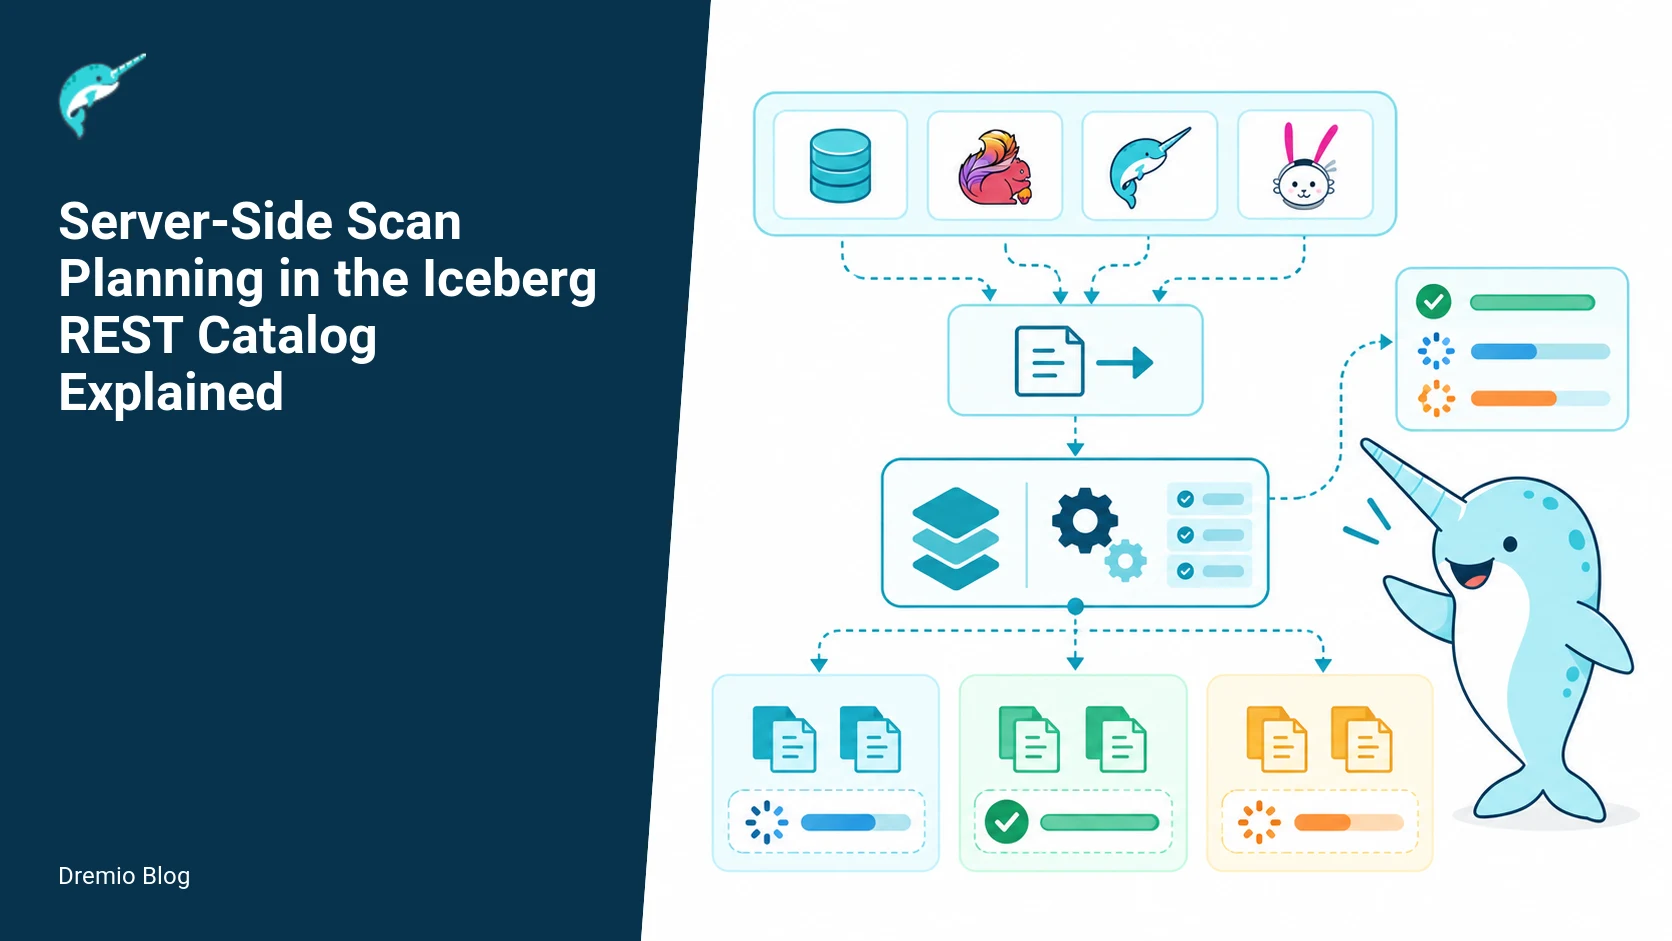
Серверное планирование сканирований переносит основную работу по разбору метаданных и формированию плана запроса с клиента на каталог. Это снижает сетевой трафик и нагрузку на аналитические движки при работе с большими таблицами Iceberg. Подход особенно полезен в распределённых с
VK Tech опубликовала детали реализации своей Data Lakehouse-платформы. Это помогает оценить, как именно отечественное решение справляется с хранением разнородных данных, потоковой обработкой и одновременной работой нескольких вычислительных движков без дублирования информации. Дл
DuckDB научился хранить в файле базы только определения представлений, которые указывают на Parquet-файлы в объектном хранилище. Такой файл остаётся размером в сотни килобайт независимо от объёма данных и позволяет любому потребителю подключаться к готовым именованным отношениям.
DuckDB предлагает переносить повторяющиеся длинные строки в отдельную таблицу измерений с узкими целочисленными ключами. Агрегация выполняется только по этим ключам, а строки подставляются уже на финальном этапе. Такой приём снижает объём работы хеш-таблицы и уменьшает расход пам
Статья показывает, как компании теряют доверие к дата-агентам после пилота: модель, промпт и метрики меняются, а никто не проверяет, остались ли ответы верными. Решение - создать фиксированный набор «золотых вопросов» с известными ответами и прогонять его при каждом изменении. Та
Apache Iceberg 1.12.0 вышел после 777 коммитов от 142 участников. Релиз добавляет заметные улучшения в работу с Variant, геопространственными типами и потоковой обработкой удалений. Инженерам стоит оценить обновление, если в проектах уже используются semi-structured данные или пл
Релиз Apache Iceberg 1.12.0 вышел в конце сентября 2023 года и добавляет поддержку спецификации v3 в большем числе движков, расширяет операции REST-каталога и повышает стабильность потоковой записи. Изменения касаются Spark, Flink и Kafka, поэтому инженерам стоит оценить совмести
Apache Polaris 1.8.0 вышел с набором изменений, которые напрямую влияют на безопасность и стабильность каталога метаданных Iceberg. Главные новшества касаются прав на семантические модели, более безопасной обработки коммитов и управления постраничной выдачей. Обновление требует в
Команды ежедневно запускают expiration в Iceberg, чтобы метаданные не разрастались и расходы на хранение оставались под контролем. Регуляторные запросы требуют точного состояния таблицы на конкретную дату квартала или года, и обычное окно хранения в несколько дней эти точки не по
VK Cloud построил Cloud Tracing на Jaeger-совместимом API и OpenTelemetry. Сервис принимает спаны от сотен независимых клиентов, хранит десятки терабайт и отдаёт данные через привычные Jaeger UI и Grafana. Выбор хранилища при этом свёлся к двум вариантам из шести заявленных бэкен
Статья на Habr сравнивает практические варианты мониторинга и логирования корпоративного хранилища. Авторы показывают, как инструменты закрывают конкретные уровни контроля - от состояния серверов до качества данных и влияния сбоев на downstream. Разбор помогает инженерам понять,
Разработчики распределённых аналитических баз часто сталкиваются с ситуацией, когда тяжёлый запрос внезапно зависает. План EXPLAIN показывает структуру, но не даёт ответа, на каком этапе сейчас находится выполнение и что именно тормозит: перекос данных, spill на диск или ожидание
В корпоративных хранилищах данных сбой может возникнуть на любом участке конвейера: при выгрузке из источников, во время трансформаций или на уровне СУБД. Техническая доступность кластера ещё не означает, что данные приходят вовремя и в полном объёме. Observability позволяет соби
Lakekeeper и Apache Polaris решают одну и ту же задачу: хранят указатели на актуальные версии таблиц Iceberg, выполняют коммиты и проверяют права доступа. Без надёжного каталога даже правильно записанные parquet-файлы быстро теряют целостность при параллельной работе Spark, Trino