MinIO потерял статус стандартного решения для on-premise lakehouse. Комьюнити-редакция ушла в архив, а Iceberg-таблицы требуют точного набора операций с объектами. Командам нужно оценить альтернативы по реальным паттернам чтения и записи, а не по общей фразе «S3-совместимость».
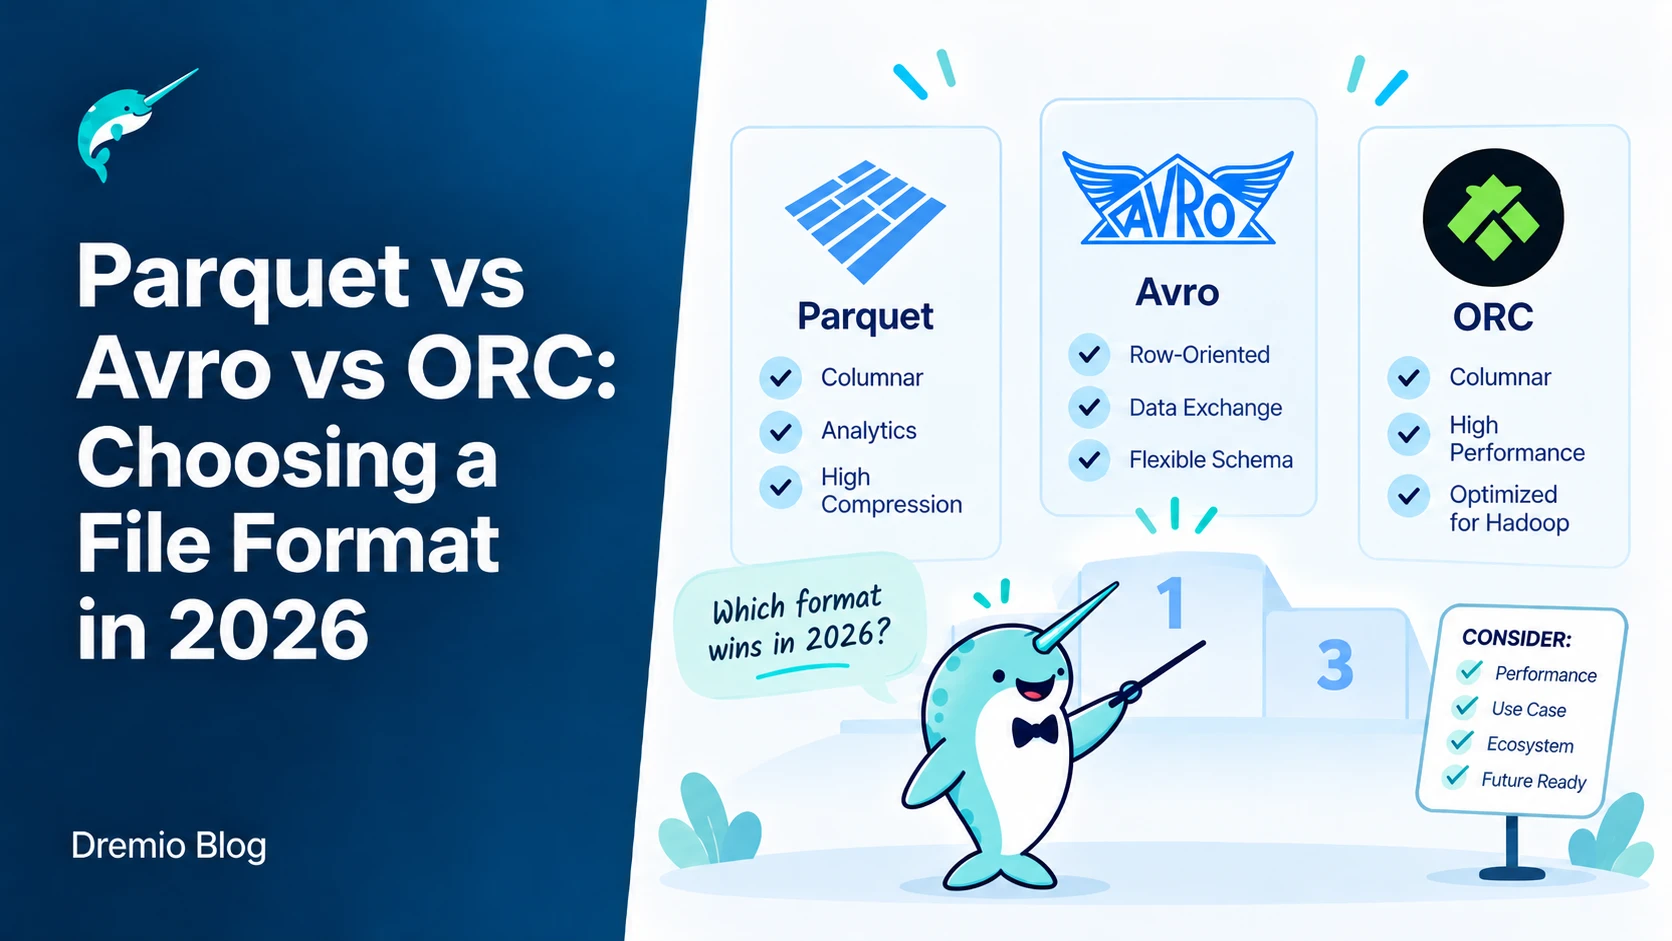
Сравнение Parquet, Avro и ORC помогает инженерам DWH подобрать формат под конкретные нагрузки чтения и записи. Parquet и ORC оптимизированы для аналитических запросов за счёт колоночной организации, Avro лучше справляется с частыми изменениями схемы при потоковой записи. Apache I
Zabbix 8 добавил встроенную поддержку отправки истории измерений в ClickHouse. Это позволяет разгрузить основную PostgreSQL или MySQL от потока сырых значений, сохранив сбор данных, обработку и срабатывание триггеров на сервере. Решение закрывает задачу долгосрочного хранения мет
В сентябре 2026 года ClickHouse выпустила ClickHouse provider for Apache Airflow (провайдер ClickHouse для Airflow), официальный пакет apache-airflow-providers-clickhousedb, и интеграция двух популярных инструментов дата-инженера впервые получила поддержку от самих разработчиков СУБД и сообщества Airflow. Новость короткая, а вопросы за ней длинные. Чем провайдер отличается от того, чем DAG ходили...
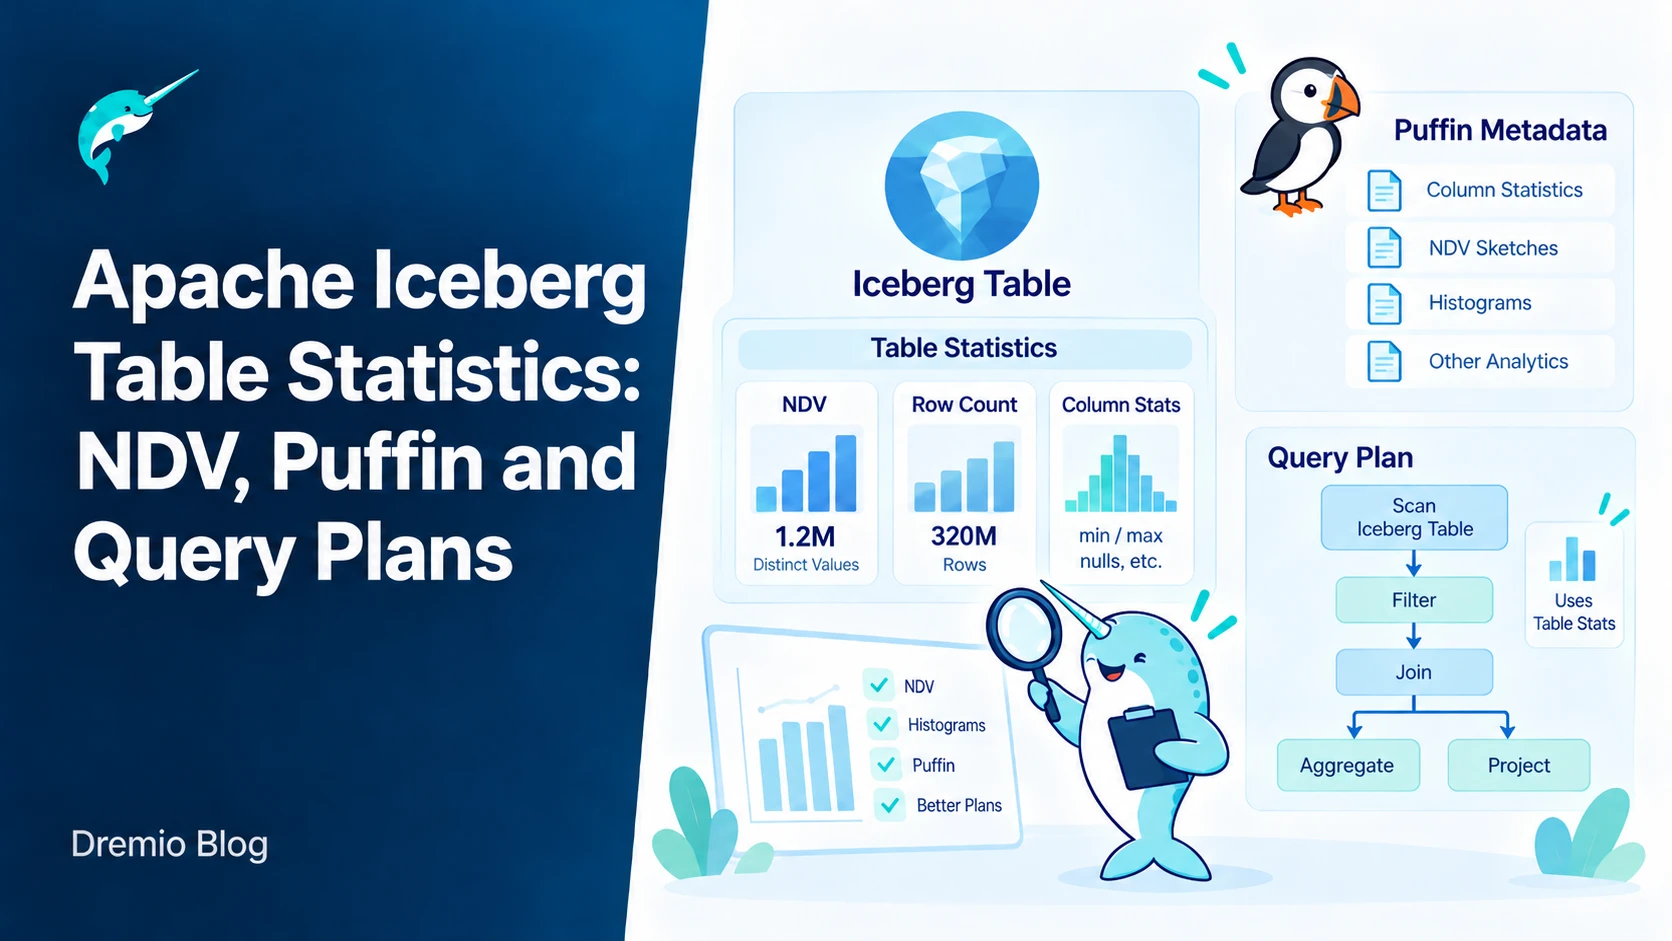
Dremio описала, как Apache Iceberg хранит границы значений на уровне файлов автоматически, но точные NDV-статистики на уровне таблицы требуют отдельного вычисления. Без них планировщик запросов часто выбирает неоптимальный порядок соединений и сканирования, особенно в больших озё
Бенчмарк на машине с двумя ядрами и 5,8 ГБ памяти показал, что для типичных аналитических задач переход на Spark часто избыточен. Вместо кластера можно обойтись DuckDB или Polars, которые справляются с файлами до 5 ГБ без падений по памяти и без настройки JVM. Тест охватил загруз
Статья показывает, как компании теряют доверие к дата-агентам после пилота: модель, промпт и метрики меняются, а никто не проверяет, остались ли ответы верными. Решение - создать фиксированный набор «золотых вопросов» с известными ответами и прогонять его при каждом изменении. Та
Astronomer выпустил Astro IDE в общий доступ и добавил расширение для VS Code. Параллельно готовится версия для Cursor, а в перспективе меняется Astro CLI. Эти шаги позволяют работать с DAG Airflow в браузере, в привычном редакторе и через агентов без постоянной настройки локальн
Astronomer выпустила плагин astronomer-data, который позволяет инженерам работать с Airflow прямо внутри ChatGPT Work и Codex. Решение снимает необходимость постоянно переключаться между чатом, терминалом и веб-интерфейсом оркестратора. Плагин поддерживает как облачные, так и соб
Astronomer представила de-bench - набор из 139 задач, построенных на реальных производственных окружениях Airflow. Инструмент проверяет, насколько хорошо кодовые агенты справляются с оркестрацией, а не только с SQL или dbt. Airflow здесь выступает как система оркестрации, которая
StarTree добавил в Apache Pinot framework Custom Hash Function, который позволяет описывать сложные правила партиционирования прямо в конфигурации таблицы. Это решает проблему, когда Kafka и Pinot расходятся в способе расчёта номера партиции, из-за чего broker не может выполнять
VK Cloud построил Cloud Tracing на Jaeger-совместимом API и OpenTelemetry. Сервис принимает спаны от сотен независимых клиентов, хранит десятки терабайт и отдаёт данные через привычные Jaeger UI и Grafana. Выбор хранилища при этом свёлся к двум вариантам из шести заявленных бэкен
Вторая часть разбора Arenadata показывает, как потребитель Kafka получает данные, управляет отставанием и делит партиции. Понимание этих процессов помогает инженерам правильно настраивать poll-циклы, лимиты и группы, чтобы избежать простоев и растущего лага. Разбор фокусируется н
Статья на Habr сравнивает практические варианты мониторинга и логирования корпоративного хранилища. Авторы показывают, как инструменты закрывают конкретные уровни контроля - от состояния серверов до качества данных и влияния сбоев на downstream. Разбор помогает инженерам понять,
ИИ-модели уже генерируют backend и frontend по одному промпту, включая связки с Kafka, PostgreSQL и Redis. Однако на практике такой код часто содержит скрытые ошибки, которые проявляются только при реальной нагрузке. Разработчик по-прежнему нужен, чтобы эти ошибки найти и исправи
В корпоративных хранилищах данных сбой может возникнуть на любом участке конвейера: при выгрузке из источников, во время трансформаций или на уровне СУБД. Техническая доступность кластера ещё не означает, что данные приходят вовремя и в полном объёме. Observability позволяет соби
Приложение на Gin и GORM записывало время в таблицу через Go, а база добавляла значения через NOW(). В итоге одна и та же запись хранила метки из трёх разных источников: UTC из приложения, времени сессии базы и момента транзакции. Разница в три часа приводила к тому, что фоновая
Wildberries перевела управление доступом к данным на единую точку входа через Trino и Open Policy Agent. Это позволило уйти от ручной раздачи прав в десятках СУБД и получить сквозной аудит. Решение выросло из задачи одного отдела в кросс-департаментный процесс, где техническая ча
Сторонние MCP позволяют агентам напрямую работать с GitHub, таск-трекерами и PostgreSQL без дополнительного кода. Это ускоряет интеграцию, но одновременно открывает канал для промпт-инъекций, которые модель не умеет фильтровать по источнику. В итоге агент может выполнить вредонос
Ivory перешел от узкого инструмента для PostgreSQL и Patroni к универсальной платформе управления кластерами. В версии 2.0.0 появилась новая архитектура с Keeper, добавилась поддержка MongoDB, Redis, ClickHouse, ZooKeeper и etcd, а также возможность развертывать кластеры из шабло