
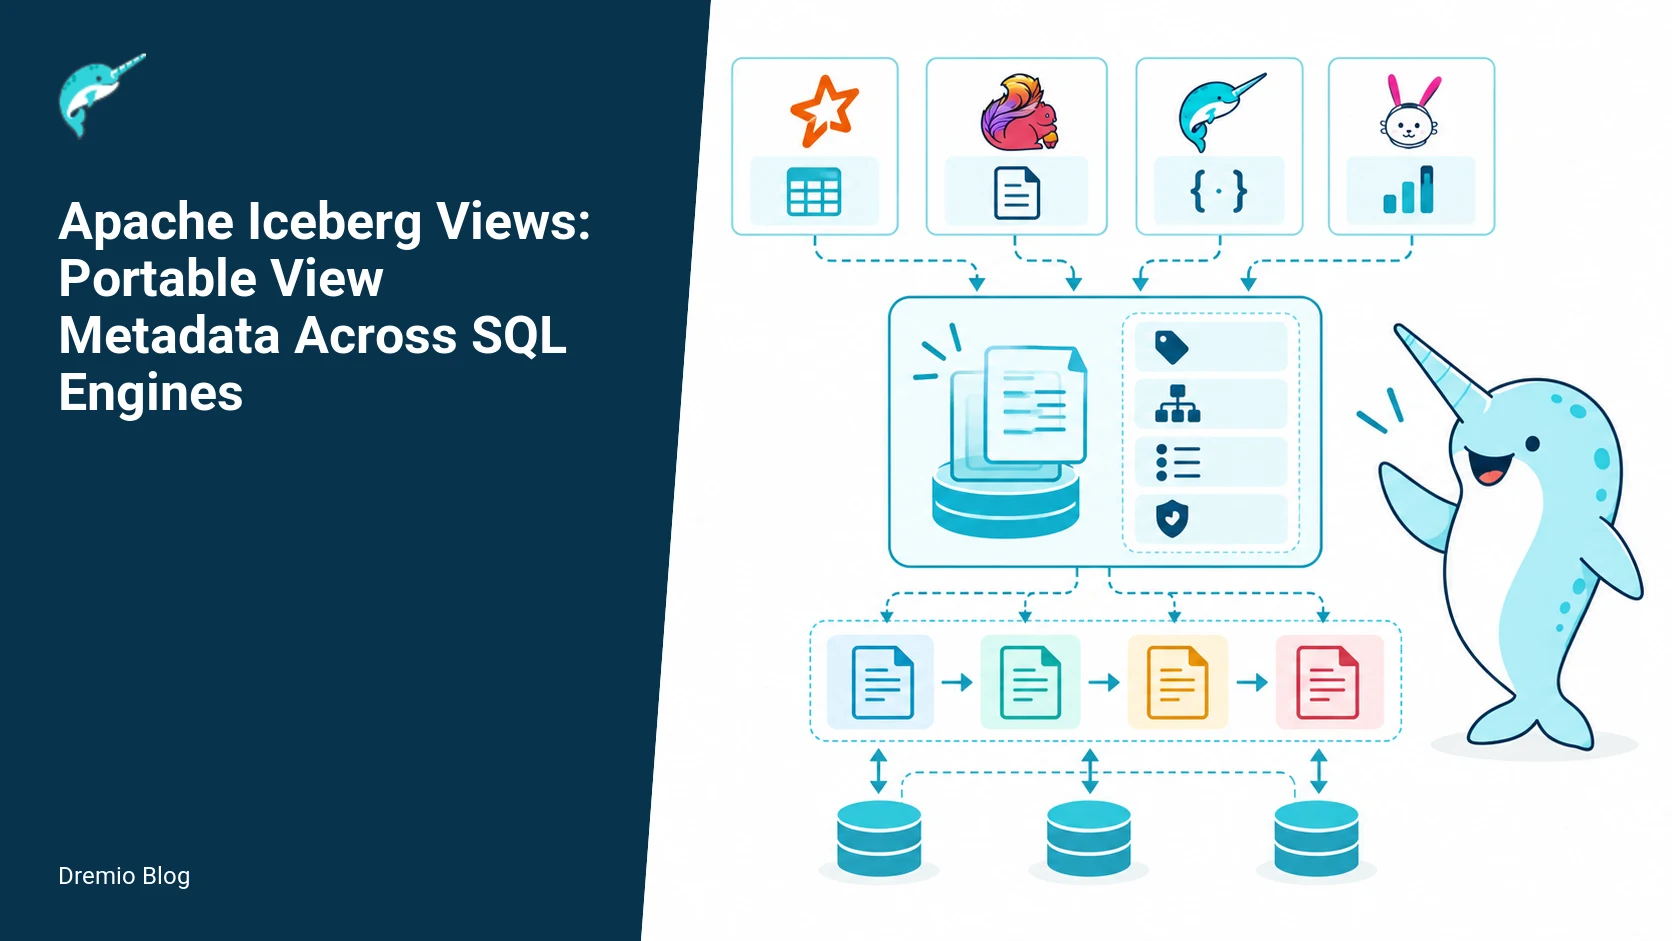
Apache Iceberg добавил в спецификацию поддержку представлений с хранением метаданных прямо в каталоге. Теперь SQL-запрос, схема, версии и зависимости описываются один раз и становятся доступны разным движкам без пересоздания. Это решает задачу совместного использования views в Sp
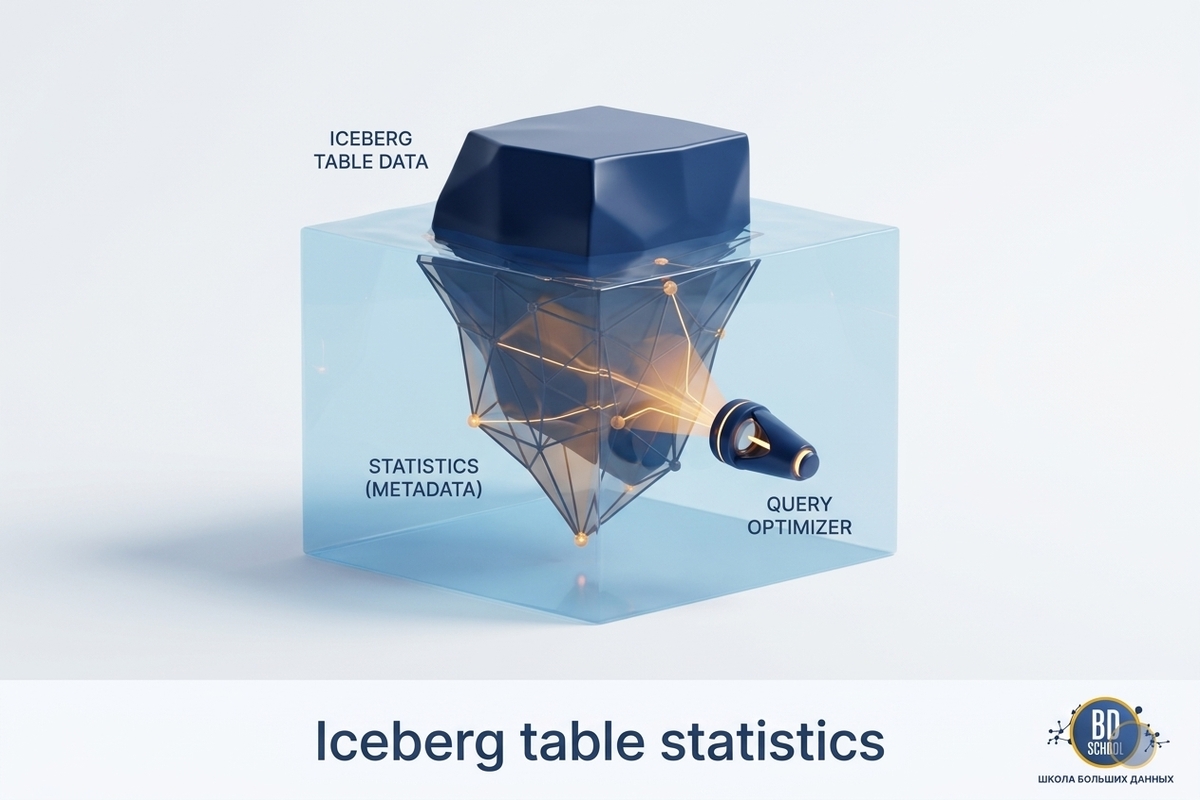
12 октября 2026 года в блоге Dremio, компании-разработчика lakehouse-платформы поверх Apache Iceberg, вышел обзор того, как устроена статистика таблиц Iceberg (Iceberg table statistics) и почему оптимизатор запросов без неё работает вслепую. Обзор перечисляет виды статистики, но оставляет за кадром три практических вопроса. Кто именно пишет число уникальных значений колонки...
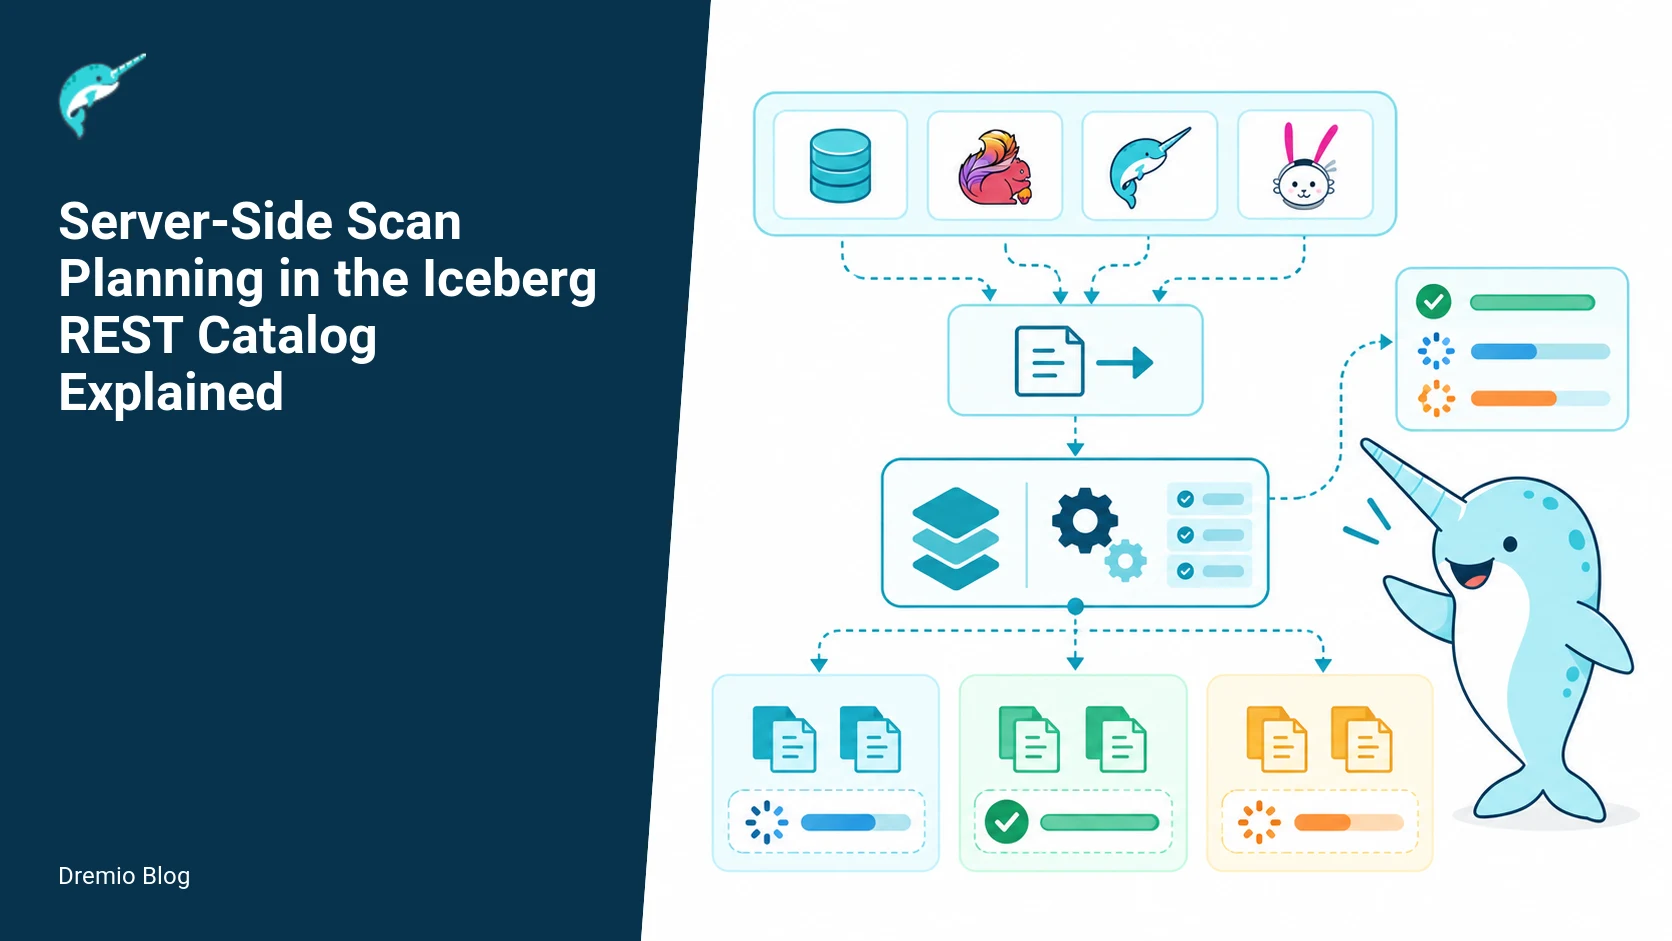
Серверное планирование сканирований переносит основную работу по разбору метаданных и формированию плана запроса с клиента на каталог. Это снижает сетевой трафик и нагрузку на аналитические движки при работе с большими таблицами Iceberg. Подход особенно полезен в распределённых с
VK Tech опубликовала детали реализации своей Data Lakehouse-платформы. Это помогает оценить, как именно отечественное решение справляется с хранением разнородных данных, потоковой обработкой и одновременной работой нескольких вычислительных движков без дублирования информации. Дл
Статья на Habr сравнивает практические варианты мониторинга и логирования корпоративного хранилища. Авторы показывают, как инструменты закрывают конкретные уровни контроля - от состояния серверов до качества данных и влияния сбоев на downstream. Разбор помогает инженерам понять,
Разработчики распределённых аналитических баз часто сталкиваются с ситуацией, когда тяжёлый запрос внезапно зависает. План EXPLAIN показывает структуру, но не даёт ответа, на каком этапе сейчас находится выполнение и что именно тормозит: перекос данных, spill на диск или ожидание
Wildberries перевела управление доступом к данным на единую точку входа через Trino и Open Policy Agent. Это позволило уйти от ручной раздачи прав в десятках СУБД и получить сквозной аудит. Решение выросло из задачи одного отдела в кросс-департаментный процесс, где техническая ча
Lakekeeper и Apache Polaris решают одну и ту же задачу: хранят указатели на актуальные версии таблиц Iceberg, выполняют коммиты и проверяют права доступа. Без надёжного каталога даже правильно записанные parquet-файлы быстро теряют целостность при параллельной работе Spark, Trino
Trino решает задачу прямого доступа к таблицам Iceberg, хранящимся в S3, через стандартный SQL без переноса данных и без запуска Spark-кластера. Раньше аналитикам приходилось копировать содержимое в PostgreSQL или ClickHouse, теряя преимущества озера данных и создавая проблемы си
Для популяризации нашего нового курса для дата-инженеров по Trino мы проводим очередной бесплатный митап для аналитиков, архитекторов, инженеров данных, разработчиков, DataOps- инженеров и тех, кто интересуется современными технологиями обработки данных. Поскольку Trino является движком для онлайн-обработки больших объемов данных с помощью распределенных SQL-запросов, ему нужна повышенная отказоустойчивость для стабильной работы...
Что общего у StarRocks с Trino, чем они отличаются, когда и что выбирать для практического использования: сравниваем движки для быстрой аналитики больших данных из Data Lake. Чем похожи StarRocks и Trino Вчера мы разбирали, что такое StarRocks, как устроена и где пригодится эта высокопроизводительная аналитическая база данных с открытым исходным...
Вместо Trino и ClickHouse: что такое StarRocks и как оно устроено, архитектура и принципы работы, сценарии использования и место в корпоративной архитектуре данных. Архитектура и принципы работы StarRocks Хотя ClickHouse сегодня считается одним из наиболее популярных колоночных хранилищ для аналитики больших объемов данных в реальном времени, это не единственный представитель...
Что такое Apache Wayang, чем он похож на Beam и в чем разница с Trino: архитектура и принципы работы еще одного распределенного фреймворка интеграции данных. Что такое Apache Wayang и чем это отличается от Trino Trino – это мощный, но далеко не единственный инструмент распределенного выполнения аналитических запросов, способный обрабатывать...
В поддержку нашего нового курса для дата-инженеров Школа Больших Данных проводит очередной бесплатный митап для аналитиков, архитекторов, инженеров данных, разработчиков, DataOps- инженеров и тех, кто интересуется современными технологиями обработки данных. Trino – это распределенный SQL-движок с массово-параллельной архитектурой и открытым исходным кодом. Он предназначен для работы с большими объемами данных в...
Пишем собственный плагин Trino для работы с пользовательским типом данных: практический пример создания и регистрации своих классов и pom-файла. Пример реализации своего плагина Trino О том, что гибкость Trino обеспечивается благодаря его плагинной архитектуре, я недавно писала здесь. Сегодня рассмотрим пример создания своего плагина, который реализует возможность работы с пользовательским...
Почему Trino такой гибкий: плагинная архитектура SQL-движка, зависимости SPI-интерфейса и последовательность создания пользовательского плагина. Плагинная архитектура Trino и как она работает Благодаря настраиваемым коннекторам Trino может подключаться к любым источникам, от реляционных баз данных до NoSQL-хранилищ. При этом коннекторы – это частный случай плагина. С точки зрения проектирования ПО, Trino...
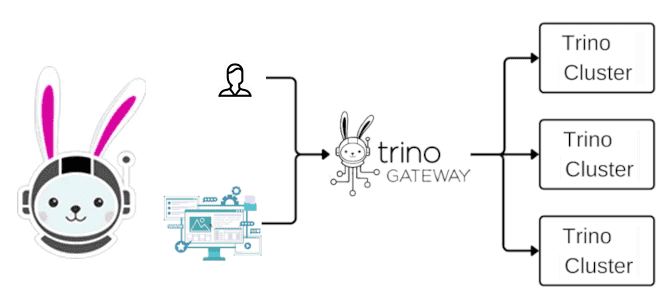
Что такое Trino Gateway, зачем он нужен и как работает: для чего делить один большой кластер Trino на несколько маленьких и как к ним обращаться без изменений на стороне клиентов. Проблемы бесконечного масштабирования кластера Благодаря горизонтальному масштабированию, о котором мы говорили вчера, кластер Trino можно расширять, добавляя новые рабочие узлы....
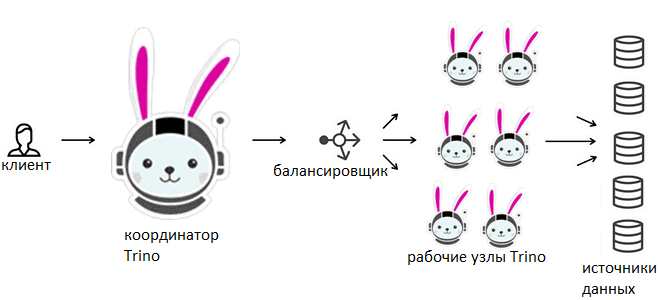
Как ускорить работу Trino при росте нагрузки и сэкономить на кластере при ее сокращении: автомасштабирование рабочих узлов и операций записи, а также настройка групп ресурсов. Масштабирование кластера Классическим способом справиться с растущими вычислительными нагрузками в гомогенной распределенной системе является горизонтальное масштабирование кластера. Это сводится к добавлению новых узлов, которые отвечают...
Мы уже писали о том, как Trino работает с удаленными объектными хранилищами и файловыми системами. Сегодня поговорим о том, какие изменения выпущены в февральском релизе 2025 года, почему в Trino удалена поддержка доступа к Azure Storage, Google Cloud Storage, S3 и S3-совместимым файловым системам через Hive и что использовать вместо...
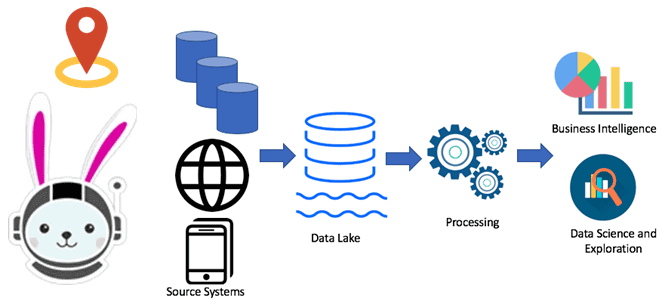
Почему Trino не заменит Flink, Spark и Airflow: границы применимости MPP-движка распределенного выполнения SQL-запросов к реляционным и нереляционным источникам данных. Почему Trino не заменит Flink, Spark и Airflow Хотя Trino отлично подходит для быстрой ad-hoc аналитики, позволяя SQL-запросами в реальном времени обращаться к различным базам данных, включая нереляционные хранилища и...