
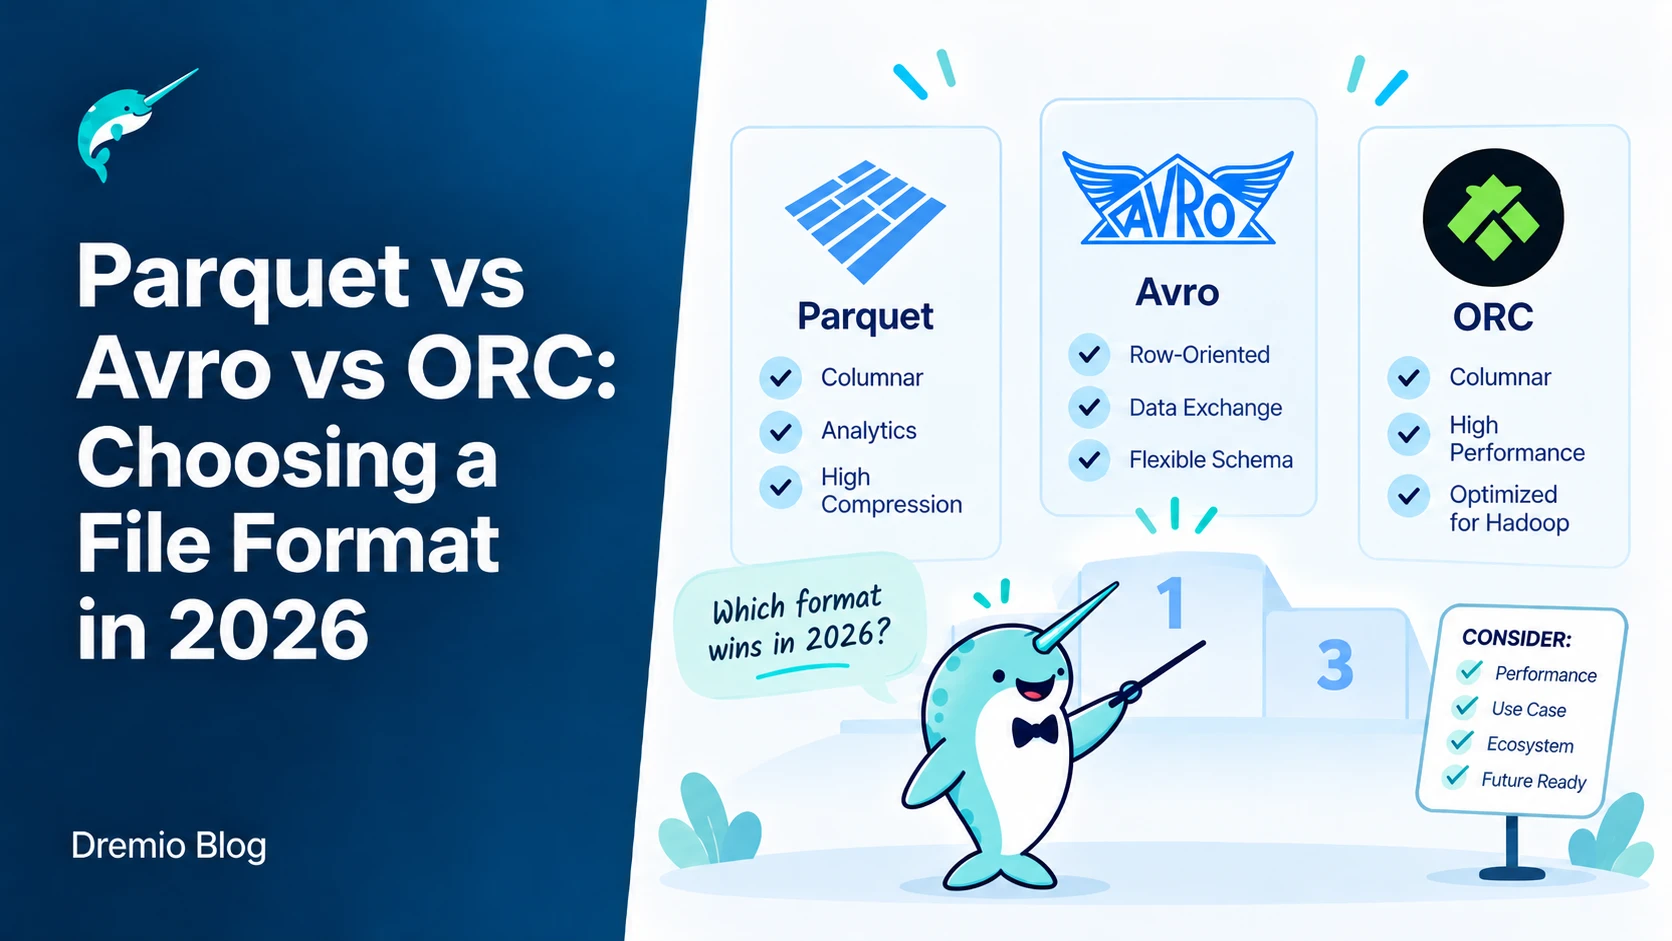
Сравнение Parquet, Avro и ORC помогает инженерам DWH подобрать формат под конкретные нагрузки чтения и записи. Parquet и ORC оптимизированы для аналитических запросов за счёт колоночной организации, Avro лучше справляется с частыми изменениями схемы при потоковой записи. Apache I
Zabbix 8 добавил встроенную поддержку отправки истории измерений в ClickHouse. Это позволяет разгрузить основную PostgreSQL или MySQL от потока сырых значений, сохранив сбор данных, обработку и срабатывание триггеров на сервере. Решение закрывает задачу долгосрочного хранения мет
ClickHouse исправил причину лишней задержки в 32 мс на простых SELECT-запросах через Native-протокол. После простоя соединения больше двух секунд окно перегрузки TCP сбрасывалось, а несколько мелких пакетов метаданных не помещались в него сразу. Это вызывало дополнительный круг о
VK Cloud построил Cloud Tracing на Jaeger-совместимом API и OpenTelemetry. Сервис принимает спаны от сотен независимых клиентов, хранит десятки терабайт и отдаёт данные через привычные Jaeger UI и Grafana. Выбор хранилища при этом свёлся к двум вариантам из шести заявленных бэкен
Статья на Habr сравнивает практические варианты мониторинга и логирования корпоративного хранилища. Авторы показывают, как инструменты закрывают конкретные уровни контроля - от состояния серверов до качества данных и влияния сбоев на downstream. Разбор помогает инженерам понять,
Разработчики распределённых аналитических баз часто сталкиваются с ситуацией, когда тяжёлый запрос внезапно зависает. План EXPLAIN показывает структуру, но не даёт ответа, на каком этапе сейчас находится выполнение и что именно тормозит: перекос данных, spill на диск или ожидание
MindWise построила инструмент o_rabbit, который переносит данные из разных источников в Parquet-файлы на S3, регистрирует их как таблицы Iceberg и делает доступными для запросов через Project Antalya. Это не просто замена вставок в ClickHouse, а перестройка всего ETL-контура под
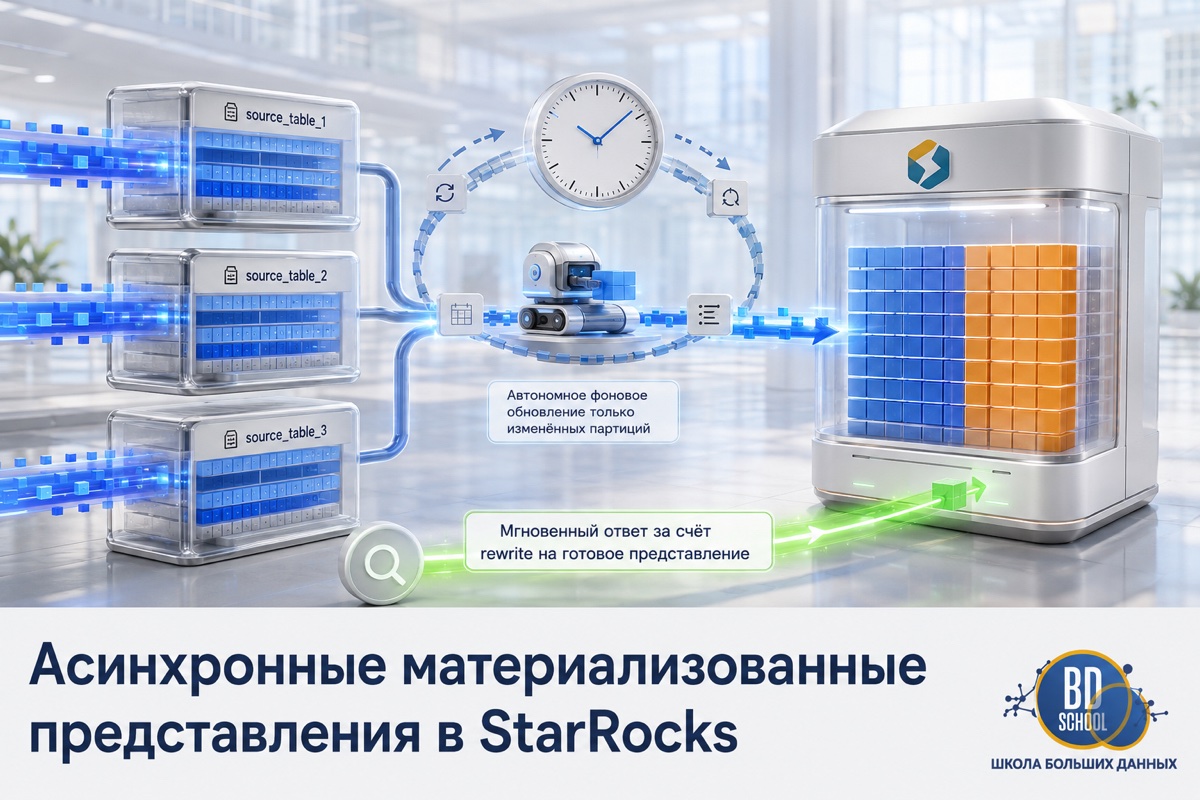
Типичное хранилище со временем обрастает зоопарком витрин. Десятки скриптов на cron пересчитывают агрегаты, гоняют одни и те же джойны по кругу и жгут процессорное время. Часть этой работы можно убрать внутрь самой СУБД. В StarRocks для этого есть асинхронные материализованные представления, которые обновляются по расписанию и инкрементально, по одной партиции....
Аналитика реального времени начинается с того, что данные попадают в хранилище с минимальной задержкой после появления в источнике. Для StarRocks таким мостом из Apache Kafka служит Routine Load, встроенный механизм непрерывной загрузки потока прямо в таблицу. В этой статье соберем рабочий пайплайн: продюсер шлет JSON-события заказов в Kafka, а StarRocks...
Один и тот же SQL-запрос в StarRocks может выполниться за секунды или упасть по памяти. Разница не в железе, а в плане, который построил оптимизатор. За выбор плана отвечает Cost-Based Optimizer, а его точность целиком зависит от статистики данных. В этой статье разберем, как StarRocks собирает статистику, как читать...
Наша школа проводит открытый вебинар по теме: "On‑line аналитика: как строить хранилище, которое пишет и считает одновременно" . Узнайте, как объединить потоковую загрузку и быстрые аналитические запросы без компромиссов, какие технологии реально работают в production и как строится потоковая архитектура (CDC → Kafka → Flink → StarRocks → BI). Приглашаем...
Инженеры данных часто спорят, какая колоночная СУБД быстрее. Спор бессмысленный без контекста нагрузки. ClickHouse и StarRocks решают разные задачи, хотя обе относятся к классу аналитических OLAP-движков. В этой статье мы разберем их архитектуру, покажем разницу в обработке соединений таблиц и соберем локальный стенд для честного нагрузочного теста на нормализованной...
Если Postgres - это надежный банковский сейф, где каждая транзакция на вес золота, то ClickHouse - это промышленная мясорубка. Ему все равно, уникальны ли ваши записи (по умолчанию), он не поддерживает классические транзакции, но зато он умеет делать SELECT count(*) FROM hits по миллиарду строк за доли секунды. Для...
До этого момента все наши DAG-и жили по расписанию. schedule_interval='@daily' - это классика. Но современный бизнес не хочет ждать "утреннего отчета". Если данные прилетели в 14:00, отчет должен быть готов в 14:10, а не на следующее утро. Здесь мы сталкиваемся с фундаментальным конфликтом: Airflow - это Batch-инструмент (запускает задачи...
В прошлых статьях мы выяснили: если задача тяжелая и требует Java (Spark), мы используем SparkSubmitOperator. Но что делать, если у вас "тяжелый" Python? Типичная ситуация когда вы написали отличный код на Pandas внутри PythonOperator. На тестовом файле в 100 Мб все летало. В продакшене пришел файл на 10 Гб. Как...
Оркестратор сам по себе бесполезен. Apache Airflow - это дирижер, а не музыкант. Его задача - не хранить данные и не (всегда) обрабатывать их, а говорить другим системам, что делать. "Postgres, выполни этот запрос", "Spark, посчитай эту витрину", "S3, отдай файл". Но чтобы сказать "Postgres, выполни запрос", Airflow должен...
Эта статья открывает наш цикл посвященный бесплатному курсу лекций по "Apache Airflow для новичков" и закладывает фундамент для осовения всей темы. Мы разберемся, зачем вообще нужен оркестратор, как Airflow устроен внутри и как его запустить за пять минут, чтобы начать первые эксперименты. Архитектура и философия: почему Apache Airflow...
Поздравляем! Если вы читаете эти строки, значит, вы прошли полный путь от первого изучения ClickHouse до понимания его самых глубоких механизмов. За эти десять статей мы превратились из новичков, задающихся вопросом "Что такое колоночная СУБД?", в уверенных пользователей, способных не только писать сложные аналитические запросы, но и проектировать, оптимизировать и...
Мы с вами научились виртуозно писать запросы, строить сложные аналитические отчеты и интегрировать ClickHouse с другими системами. Но чтобы вся эта мощь работала стабильно и предсказуемо в production, кластер требует внимания и ухода. Написание запросов — это работа аналитика или разработчика, а поддержание здоровья системы — это задача администратора баз...
Оконные функции ClickHouse и работа с массивами данных. Мы с вами уже прошли большой путь: научились эффективно хранить данные, оптимизировать таблицы, выполнять базовые и сложные запросы и даже интегрироваться с внешними системами. Казалось бы, мы можем практически всё. Но как ответить на такие вопросы: "Каково время между последовательными действиями каждого...