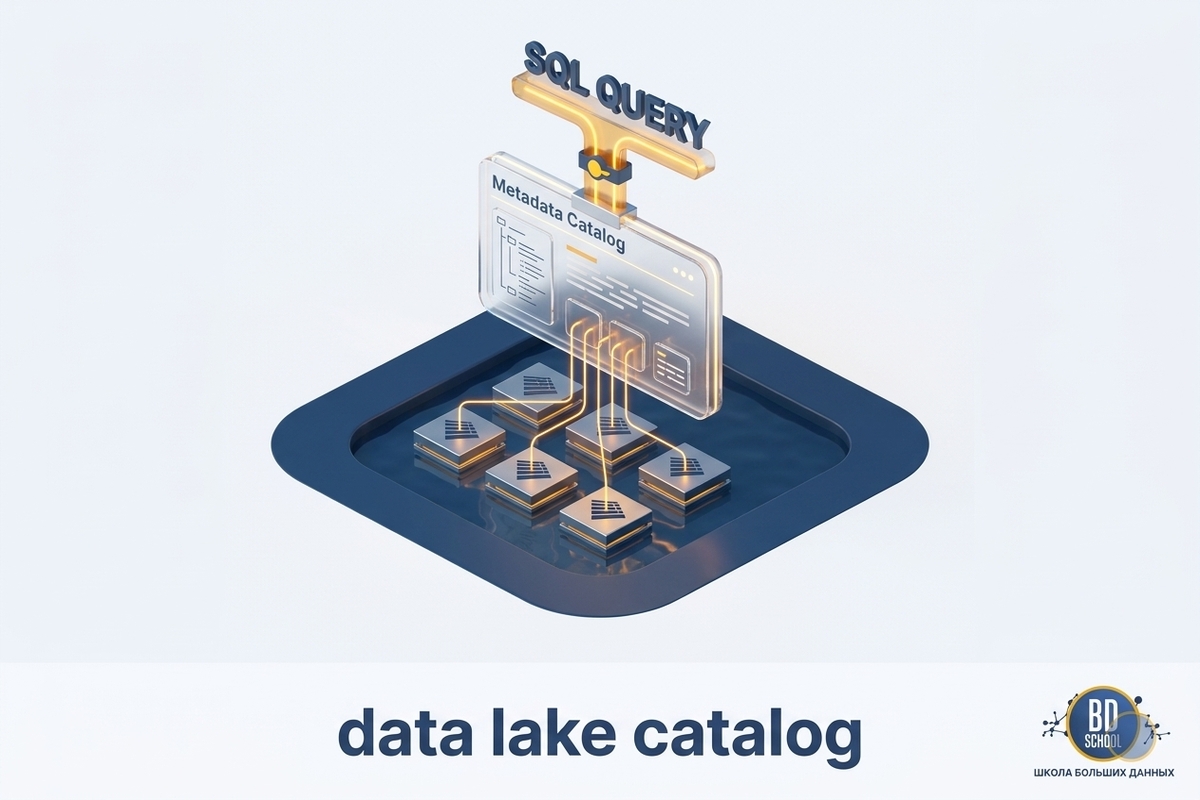
7 октября 2026 года команда DuckDB показала, как собрать каталог озера данных (data lake catalog) из файла DuckDB, в котором нет ни одной строки данных. В файле лежат только представления (view) над Parquet в объектном хранилище (object storage), а коллеги подключают его по ссылке и сразу пишут SQL. Приём...
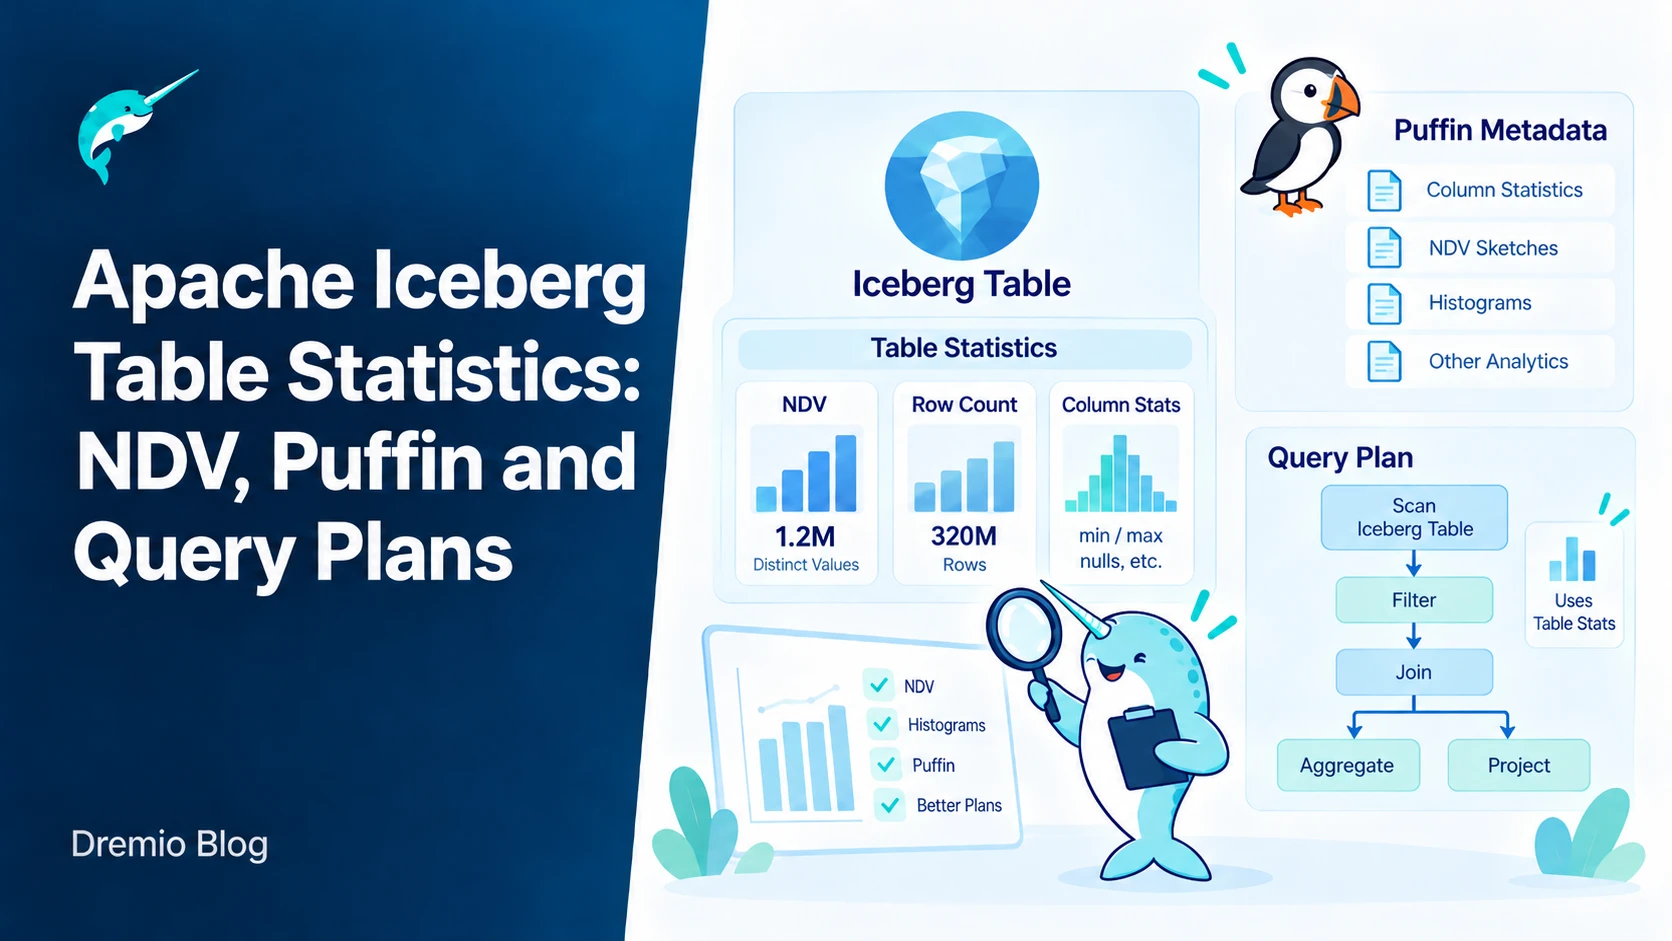
Dremio описала, как Apache Iceberg хранит границы значений на уровне файлов автоматически, но точные NDV-статистики на уровне таблицы требуют отдельного вычисления. Без них планировщик запросов часто выбирает неоптимальный порядок соединений и сканирования, особенно в больших озё
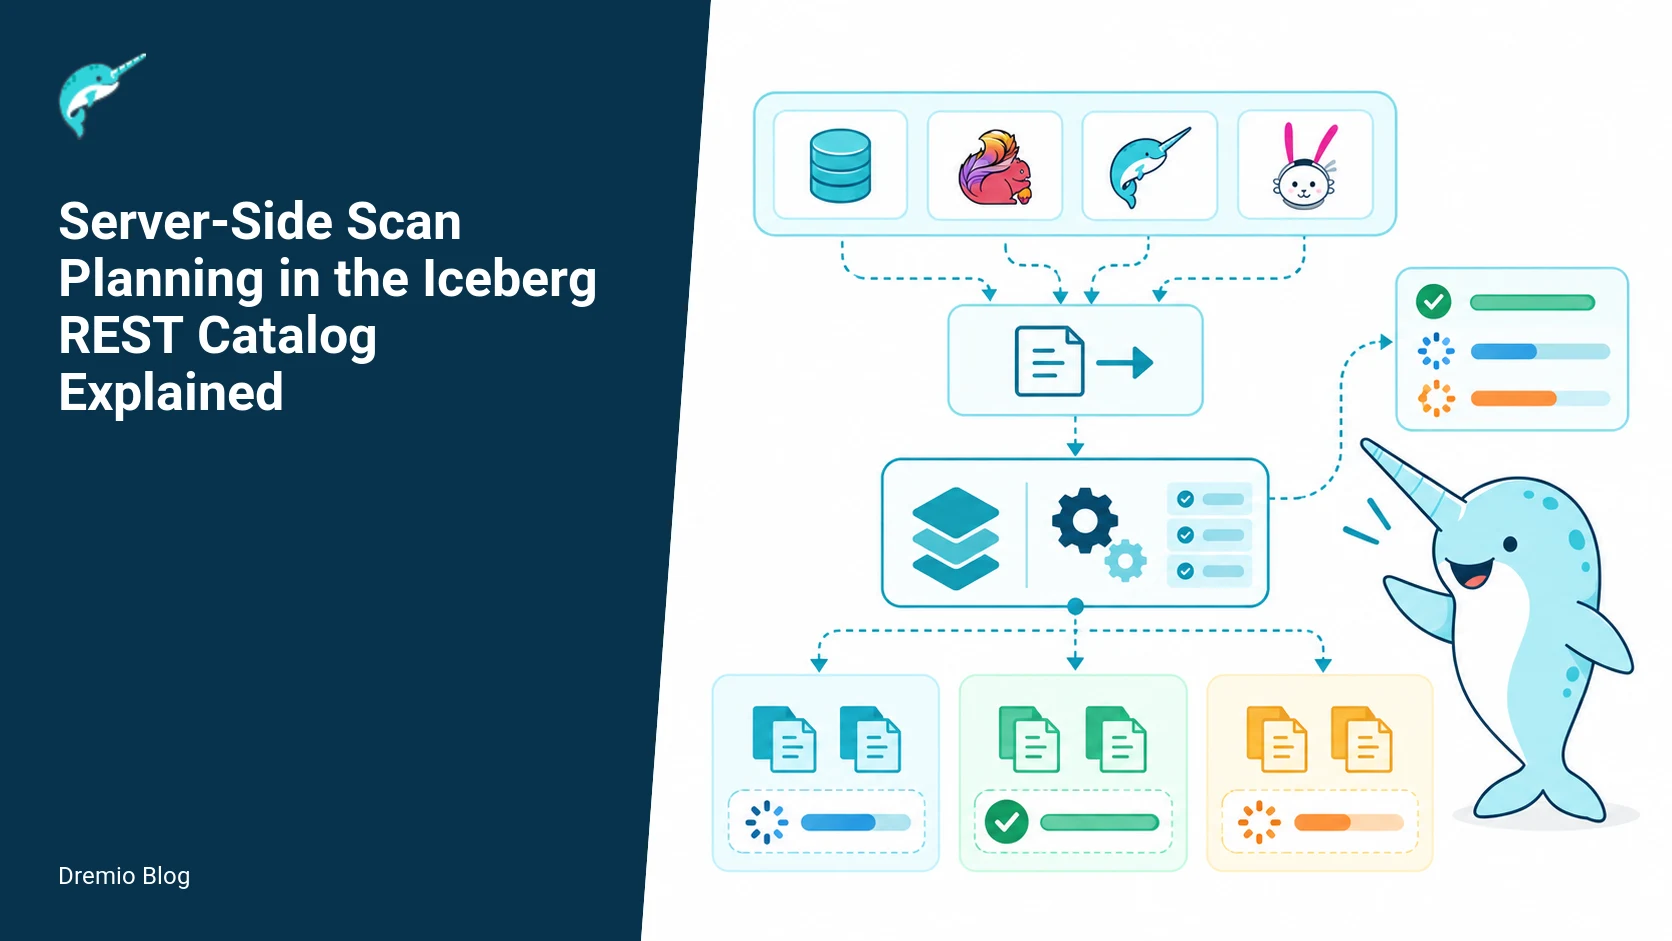
Серверное планирование сканирований переносит основную работу по разбору метаданных и формированию плана запроса с клиента на каталог. Это снижает сетевой трафик и нагрузку на аналитические движки при работе с большими таблицами Iceberg. Подход особенно полезен в распределённых с
Статья показывает, как компании теряют доверие к дата-агентам после пилота: модель, промпт и метрики меняются, а никто не проверяет, остались ли ответы верными. Решение - создать фиксированный набор «золотых вопросов» с известными ответами и прогонять его при каждом изменении. Та
Pinterest представил механизм partition finalization, который даёт downstream-потребителям явный сигнал о том, что данные за часовой интервал полностью загружены и больше не изменятся. Решение построено на связке Kafka, Flink и Iceberg и решает проблему, которая возникает при пер
Apache Iceberg 1.12.0 вышел после 777 коммитов от 142 участников. Релиз добавляет заметные улучшения в работу с Variant, геопространственными типами и потоковой обработкой удалений. Инженерам стоит оценить обновление, если в проектах уже используются semi-structured данные или пл
Релиз Apache Iceberg 1.12.0 вышел в конце сентября 2023 года и добавляет поддержку спецификации v3 в большем числе движков, расширяет операции REST-каталога и повышает стабильность потоковой записи. Изменения касаются Spark, Flink и Kafka, поэтому инженерам стоит оценить совмести
Команды ежедневно запускают expiration в Iceberg, чтобы метаданные не разрастались и расходы на хранение оставались под контролем. Регуляторные запросы требуют точного состояния таблицы на конкретную дату квартала или года, и обычное окно хранения в несколько дней эти точки не по
Lakekeeper и Apache Polaris решают одну и ту же задачу: хранят указатели на актуальные версии таблиц Iceberg, выполняют коммиты и проверяют права доступа. Без надёжного каталога даже правильно записанные parquet-файлы быстро теряют целостность при параллельной работе Spark, Trino
Trino решает задачу прямого доступа к таблицам Iceberg, хранящимся в S3, через стандартный SQL без переноса данных и без запуска Spark-кластера. Раньше аналитикам приходилось копировать содержимое в PostgreSQL или ClickHouse, теряя преимущества озера данных и создавая проблемы си
В феврале Polaris перешел под крыло Apache и получил статус полноценного проекта. Это не просто смена лицензии, а перенос контроля над указателями версий таблиц Iceberg в открытый репозиторий. Для инженеров, строящих lakehouse, такой каталог определяет, кто и как видит актуальные
MindWise построила инструмент o_rabbit, который переносит данные из разных источников в Parquet-файлы на S3, регистрирует их как таблицы Iceberg и делает доступными для запросов через Project Antalya. Это не просто замена вставок в ClickHouse, а перестройка всего ETL-контура под
Что не так с классическими ETL/ELT-конвейерами транзакционных и аналитических систем в гибридное хранилище LakeHouse, и как дата-инженеры платформы Confluent хотят решить эти проблемы с помощью Tableflow, передавая события из Kafka в таблицы Iceberg. Очередная попытка унификации пакетной и потоковой парадигмы Чтобы обеспечивать потребности современного бизнеса в пакетной и потоковой аналитике,...
Недавно мы писали про Apache NiFi 1.18. А 28 ноября опубликован новый выпуск - 1.19.0 и спустя немного времени первый баг-фикс к нему. Разбираемся с новинками свежего релиза самого популярного потокового ETL-маршрутизатора: новые процессоры, исправления ошибок и улучшения, о которых следует знать дата-инженеру и администратору кластера. Главные новости Apache NiFi...
Недавно мы рассматривали, как дата-инженеры Airbnb перевели аналитические нагрузки корпоративного озера данных с Apache Hive на Iceberg и Spark. Продолжая разговор про эти фреймворки реализации Data Lake, сегодня разберем стратегии миграции озера данных с Apache Hive на Iceberg. Зачем уходить с Apache Hive на Iceberg и как это сделать Напомним,...
Какова роль каталогов метаданных в корпоративных Data Lake, почему Hive Metastore не отвечает всем потребностям современной дата-инженерии в гибком управлении данными и в чем преимущества формата открытых таблиц Iceberg над таблицами Hive и Delta Lake. Каталоги метаданных в Data Lake Для организации данных в корпоративных озерах используются каталоги метаданных, которые...
Рассмотрим, как дата-инженеры Airbnb делятся своим опытом перевода корпоративного Data Lake на Apache HDFS в облачное объектное хранилище AWS S3. Почему пришлось переводить аналитические нагрузки с Apache Hive на Iceberg и Spark, и какие результаты это принесло. Предыстория: Data Lake на HDFS и Apache Hive Будучи крупнейшей онлайн-площадкой для размещения...
Недавно мы писали про Lakesoul – новое унифицированное решение для хранения потоковых и пакетных таблиц, которое реализует архитектуру данных LakeHouse. Сегодня заглянем под капот этого унифицированного механизма на базе Apache Spark и разберемся с преимуществами его последнего релиза. Как работает LakeSoul: краткий обзор Напомним, LakeSoul от команды DMetaSoul представляет собой...
Сегодня рассмотрим новое унифицированное решение для хранения потоковых и пакетных таблиц, созданное на основе Apache Spark. Что такое Lakesoul, чем это лучше Apache Iceberg, Hudi и Deta Lake. Также разберем, в чем конкурентные преимущества этого табличного хранилища по сравнению с этими форматами открытых таблиц, включая поддержку upsert, управление метаданными и...
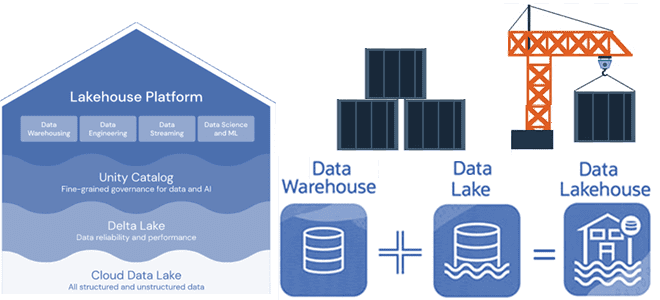
Недавно мы писали про новую гибридную архитектуру Lakehouse, которая объединяет лучше из мира озер и хранилищ данных. Сегодня разберем принципы работы и особенности построения этой архитектуры данных, включая технологии ее реализации с точки зрения дата-инженера и уделим внимание организации конвейеров аналитики больших данных. Архитектурная парадигма Lakehouse Напомним, Lakehouse — это...