
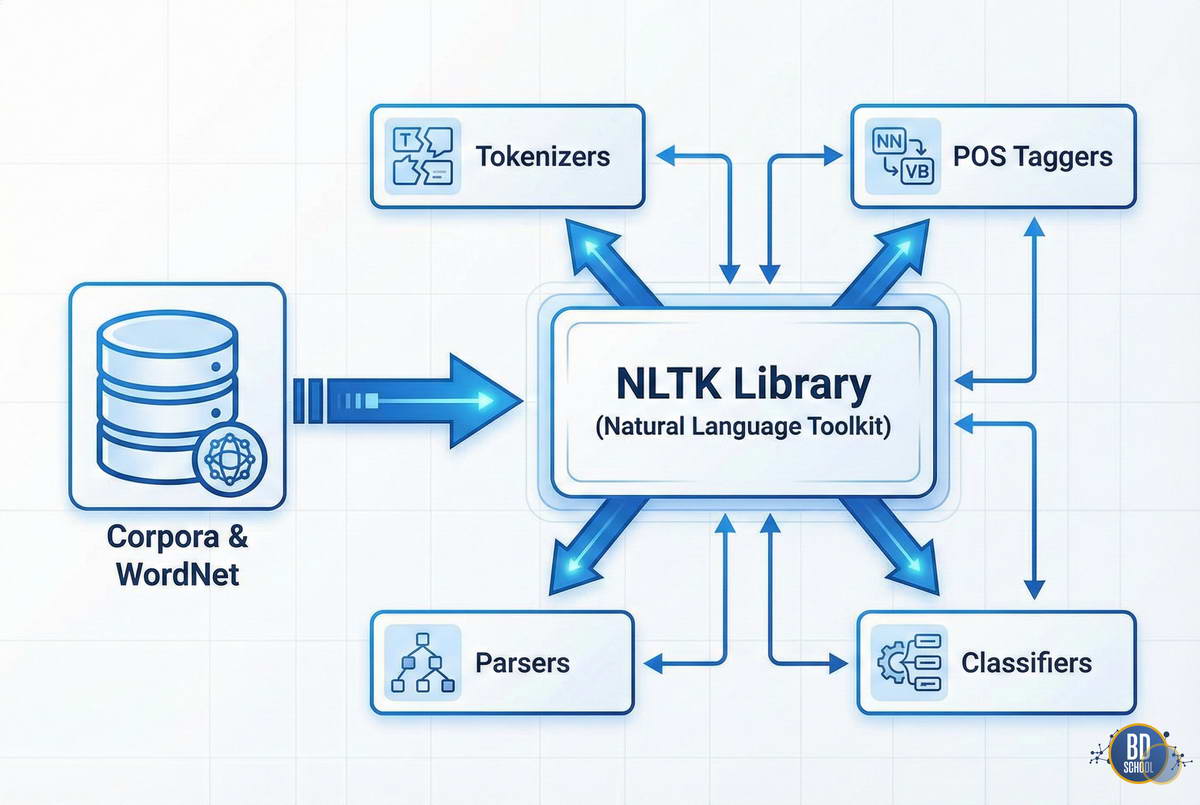
NLTK - это ведущая платформа для создания программ на языке Python для работы с данными на естественном языке. Она предоставляет простые интерфейсы для более чем 50 корпусов и лексических ресурсов. Библиотека включает набор инструментов для обработки текста, таких как токенизация, классификация и тегирование. NLTK часто называют «учебной лабораторией» для...
NoSQL (Нереляционные базы данных) - это базы данных, которые используют для хранения информации модели, отличающиеся от привычных нам плоских таблиц. Термин NoSQL ("Not Only SQL") означает, что эти решения не ограничиваются жесткими рамками реляционной логики. Они предлагают более гибкие способы организации данных. В отличие от классического подхода, где структура данных...
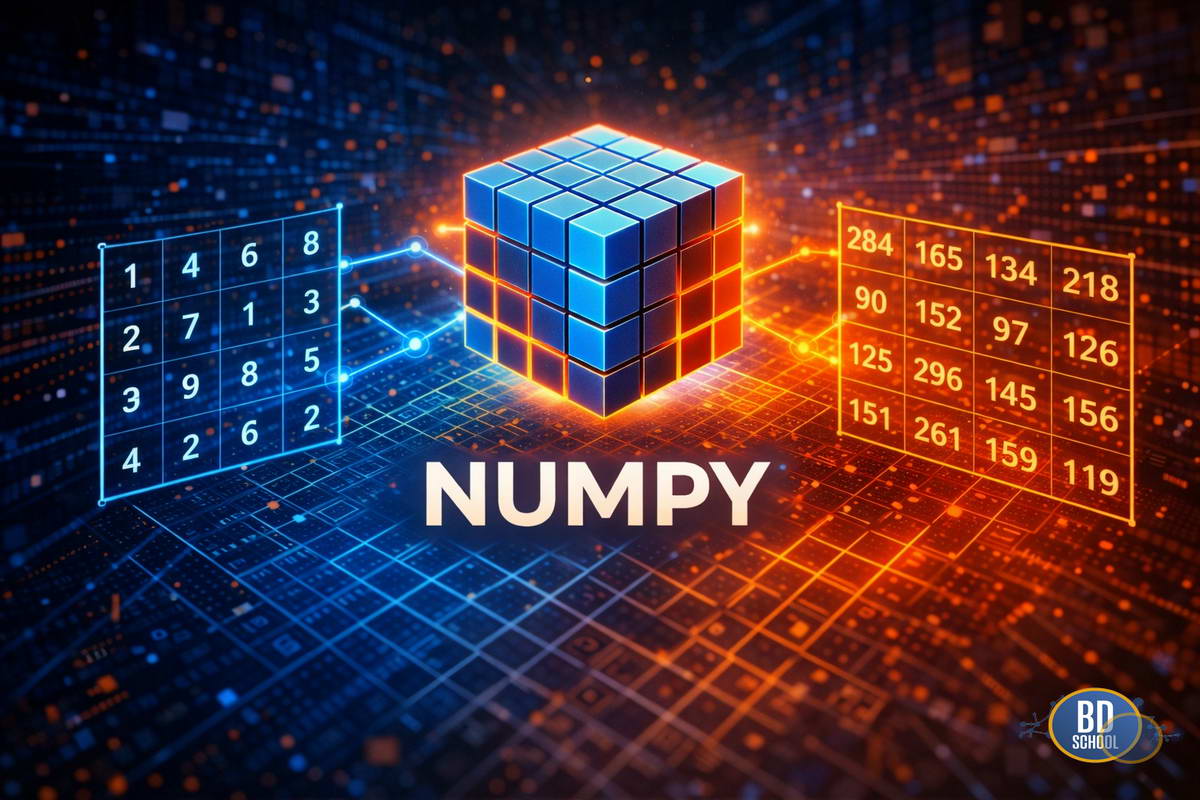
NumPy (Numerical Python) - это фундаментальная библиотека для языка Python, предназначенная для высокопроизводительных численных вычислений, обеспечивающая работу с многомерными массивами, векторизованными операциями и базовыми инструментами линейной алгебры, статистики и научных расчётов. Это база, на которой стоит вся экосистема Data Science. Без понимания NumPy невозможно эффективно работать с Pandas,...

Object detection – технология, связанная с компьютерным зрением (computer vision) и обработкой изображений, заключающаяся в обнаружении объектов определенных классов на цифровых изображениях и видео. Причем, обнаружение объектов заключается в определении границ объекта на цифровом изображении или видео. В качестве примера мы можем использовать открытую программную библиотеку для машинного обучения TensorFlow, разработанную...
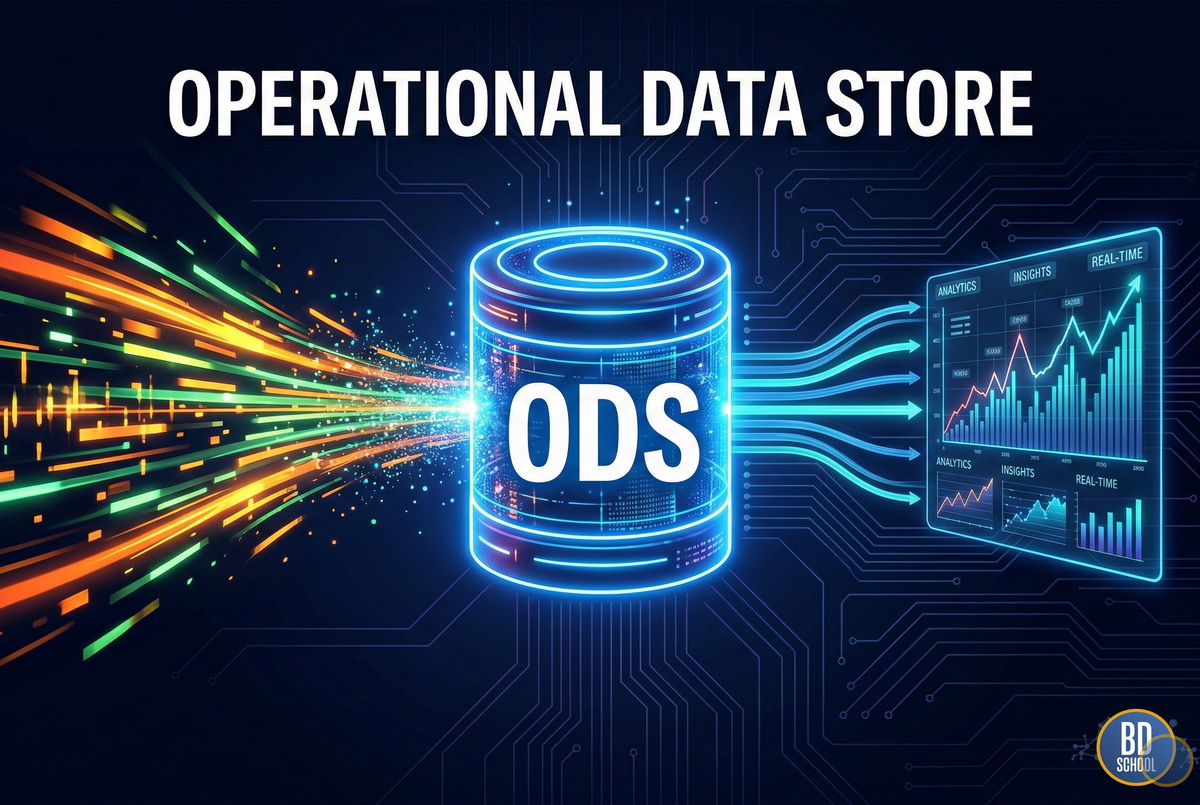
ODS (Operational Data Store) — это интеграционный слой хранилища данных, предназначенный для консолидации и оперативного хранения очищенных и согласованных данных из нескольких транзакционных систем с целью поддержки оперативной аналитики и последующей загрузки в аналитические хранилища. Эта база располагается между источниками сырой информации и аналитическим хранилищем. Транзакционные системы (OLTP) отлично...
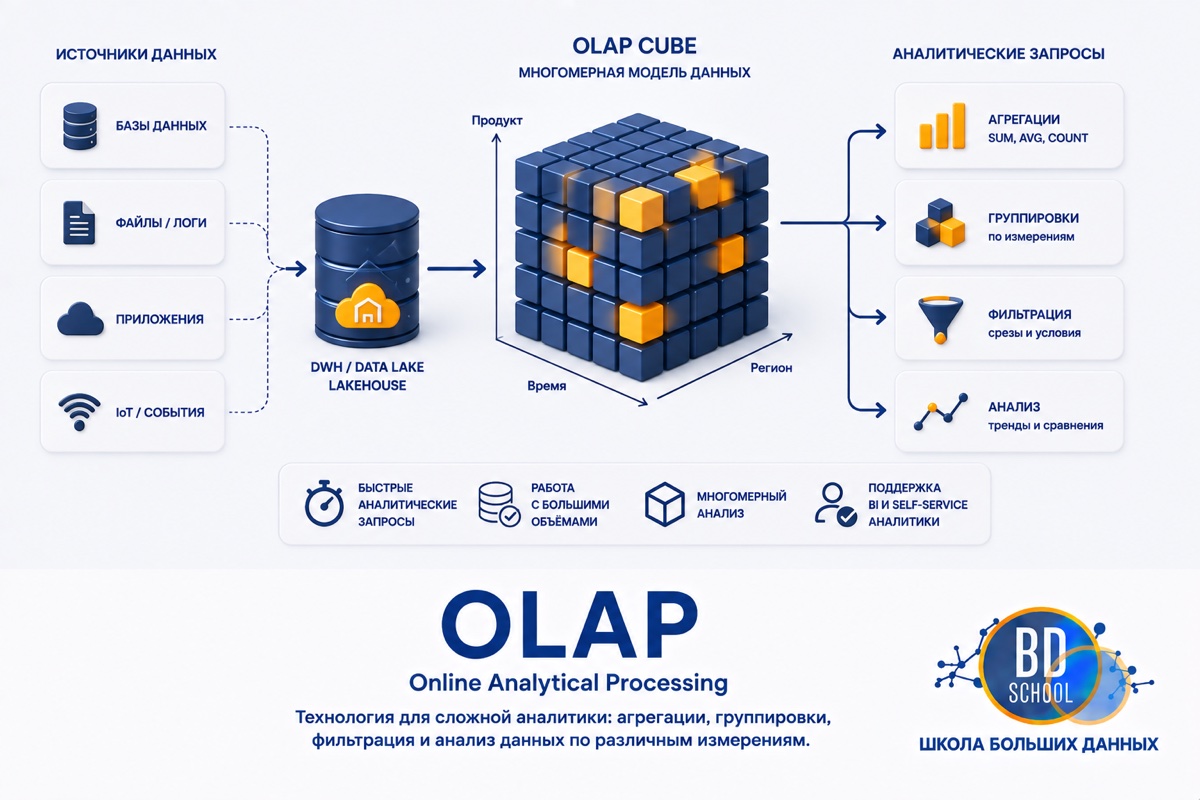
OLAP (Online Analytical Processing, оперативная аналитическая обработка) это парадигма организации и запроса данных, заточенная под быстрые агрегатные вопросы поверх больших объёмов бизнес-данных, а не под запись отдельных транзакций. Пока OLTP-система (Online Transaction Processing) фиксирует каждую продажу отдельной короткой транзакцией, OLAP отвечает на вопрос вроде «какая выручка по категории и...
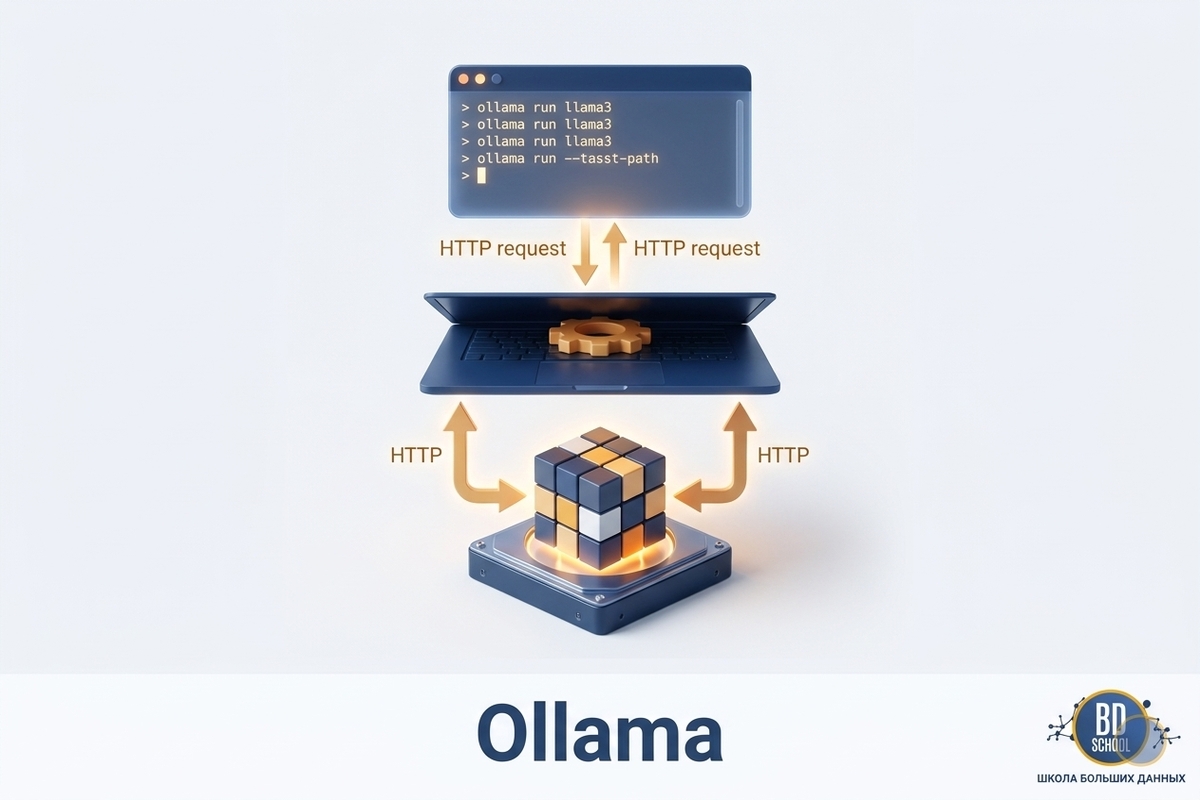
Ollama это инструмент для локального запуска и обслуживания больших языковых моделей (large language model, LLM) через связку CLI-клиента и REST API сервера, который поднимается на обычном ноутбуке или на собственном сервере без похода в облако. Разработчик скачивает готовую квантованную (quantized) модель одной командой, обращается к ней через локальный HTTP-эндпоинт...
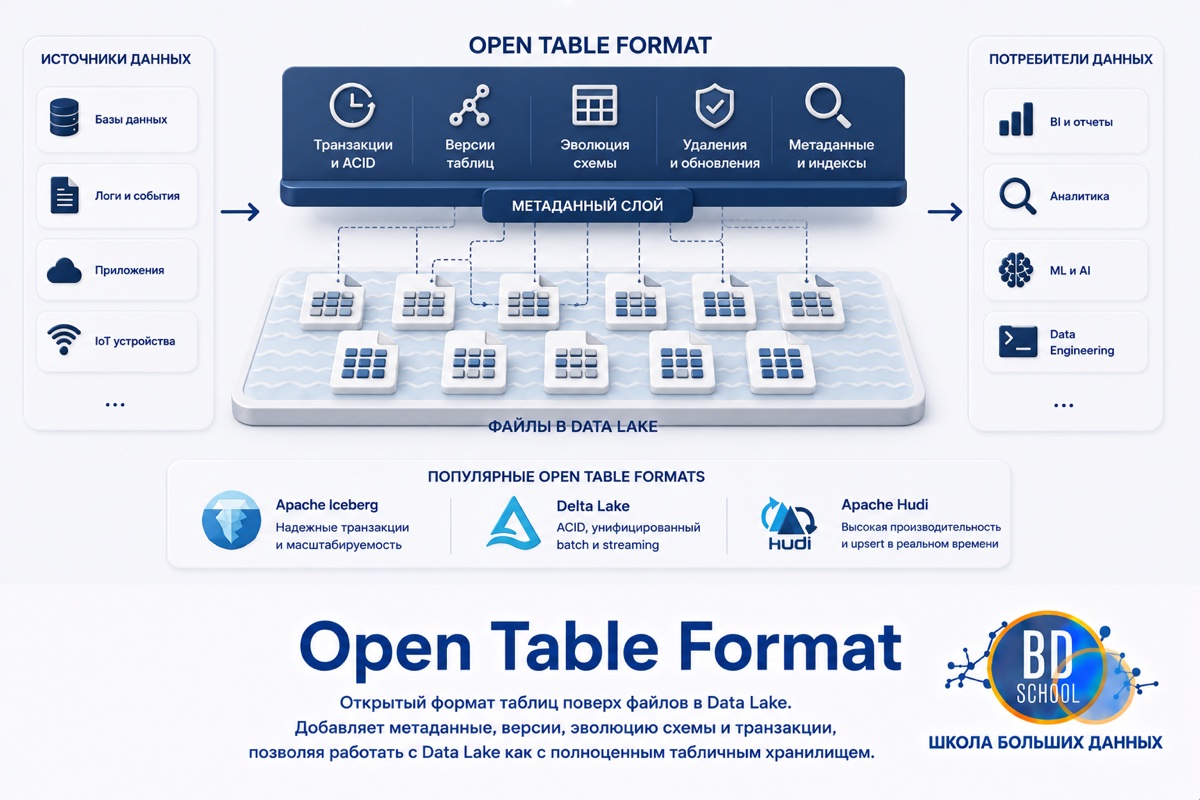
Open Table Format (Открытый табличный формат) представляет собой открыто управляемую спецификацию, которая добавляет ACID-транзакции, эволюцию схемы (schema evolution) и time travel поверх обычных файлов Parquet или ORC в облачном хранилище. Термин описывает архитектурный слой, а не единственный продукт. К категории относятся Apache Iceberg, Delta Lake, Apache Hudi и более...
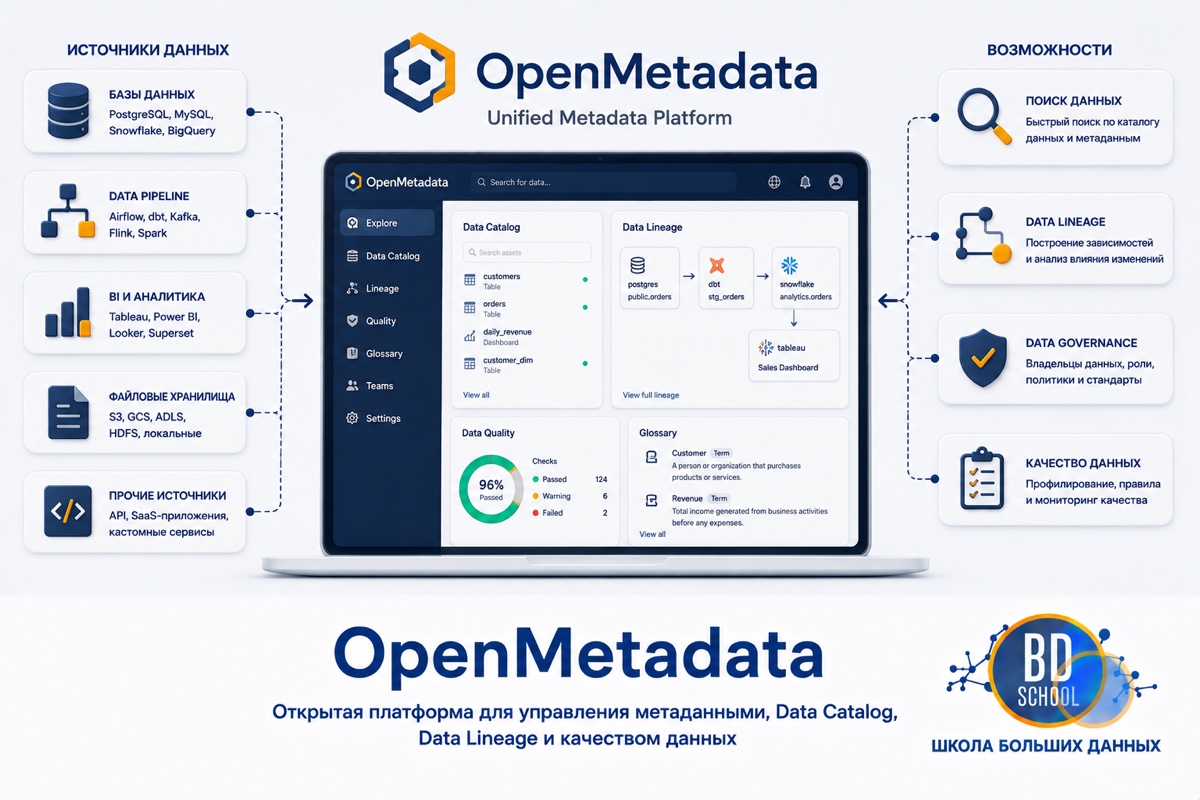
OpenMetadata это открытая платформа управления метаданными, которая объединяет каталог данных, governance и observability в одной системе и отдаёт проверенный контекст о данных не только людям, но и AI-агентам. В официальном README проекта на момент версии 2.0.0 она описана как «the open platform for trusted data context and business semantics...
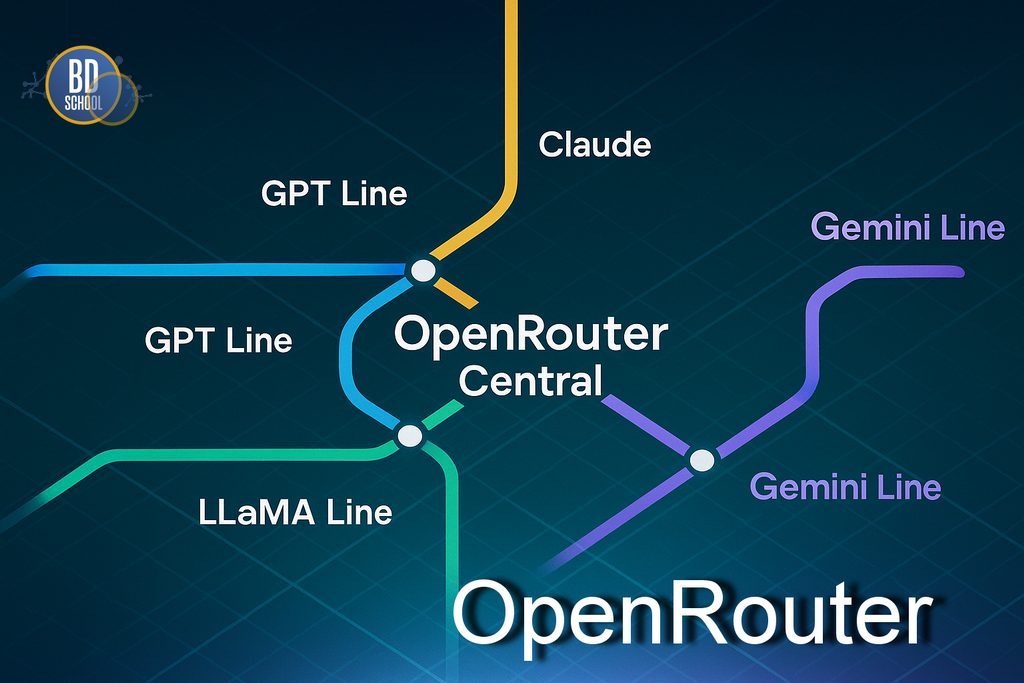
OpenRouter — это API-агрегатор для больших языковых моделей (LLM), который предоставляет единый интерфейс доступа к множеству нейросетей. Он выступает как унифицированный шлюз к моделям от разных провайдеров, включая OpenAI (GPT-4), Anthropic (Claude 3.5), Google (Gemini), Meta (Llama), Mistral и десятки других. Чтобы понять его ценность, проще всего использовать аналогию....
ORC (Optimized Row Columnar) – это колоночно-ориентированный (столбцовый) формат хранения Big Data в экосистеме Apache Hadoop. Он совместим с большинством сред обработки больших данных в среде Apache Hadoop и похож на другие колоночные форматы файлов: RCFile и Parquet. Формат ORC был разработан в феврале 2013 года корпорацией Hortonworks в сотрудничестве...
OSMNX - это пакет Python, который позволяет загружать пространственные геометрии и моделировать, проектировать, визуализировать и анализировать реальные уличные сети из API-интерфейсов OpenStreetMap.

PageIndex это движок поиска по документам для LLM-приложений, который обходится без векторной базы и без нарезки текста на чанки. Вместо эмбеддингов он строит из документа иерархическое дерево (document tree), похожее на оглавление, и заставляет модель ходить по этому дереву рассуждением. Разработку выпустила компания Vectify AI в сентябре 2025 года,...
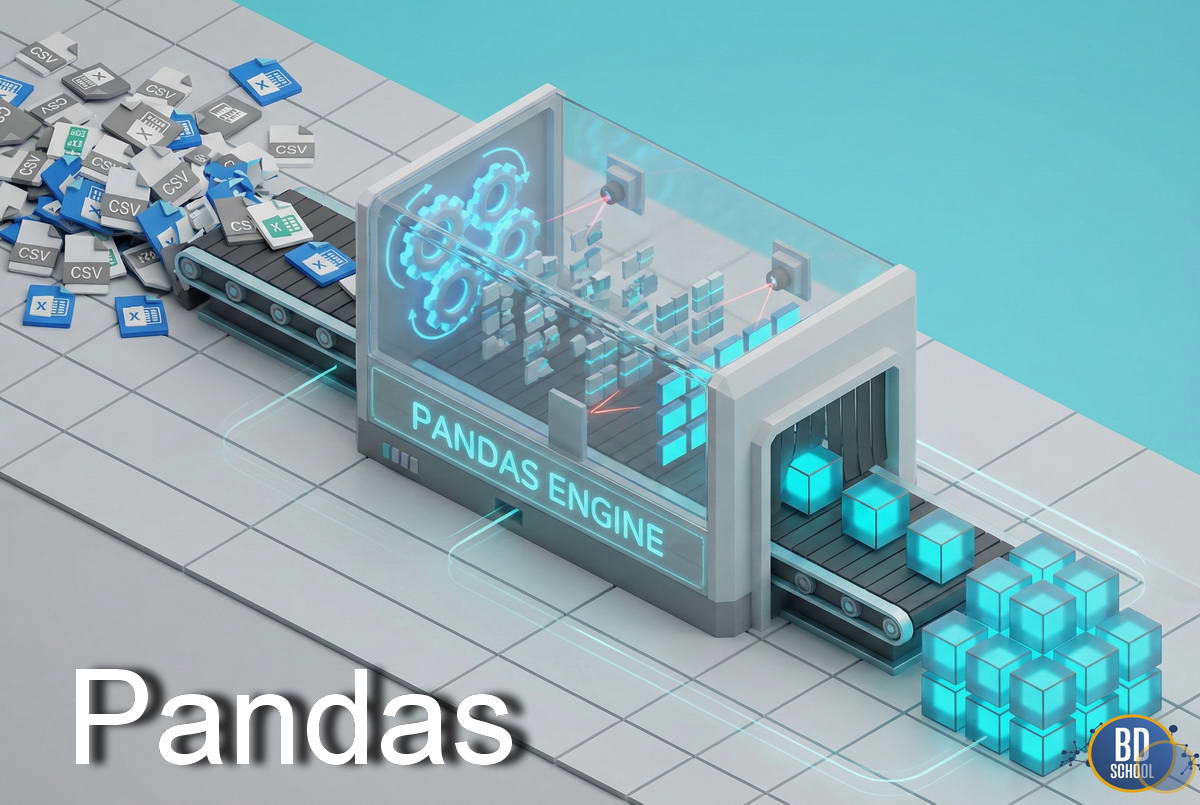
Pandas - это высокопроизводительная библиотека с открытым исходным кодом для обработки и анализа данных на языке Python. Она предоставляет удобные структуры данных для работы с таблицами и временными рядами. Инструмент де-факто является стандартом в индустрии Data Science и машинного обучения. Библиотека построена поверх NumPy. Это обеспечивает ей высокую...
Apache Parquet - это бинарный, колоночно-ориентированный формат хранения больших данных, изначально созданный для экосистемы Hadoop, позволяющий использовать преимущества сжатого и эффективного колоночно-ориентированного представления информации. Паркет позволяет задавать схемы сжатия на уровне столбцов и добавлять новые кодировки по мере их появления [1]. Вместе с Apache Avro, Parquet является очень популярным форматом...
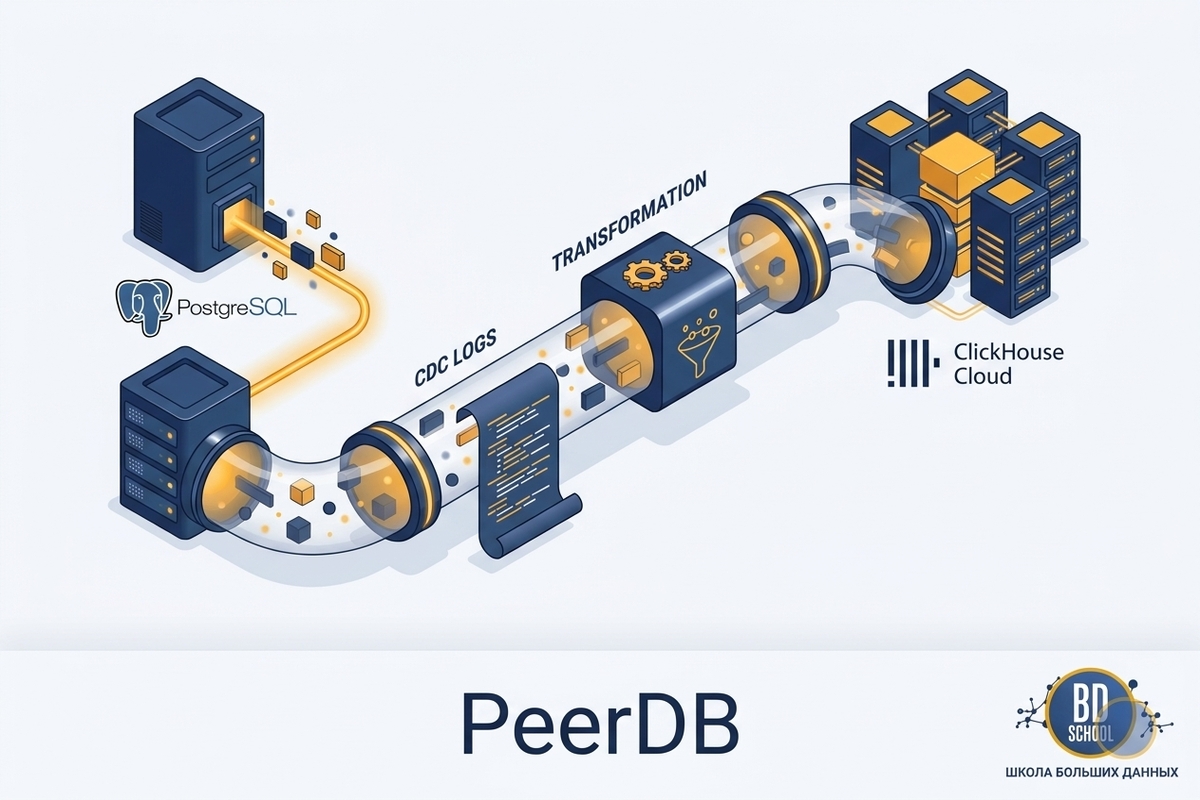
PeerDB это инструмент для потоковой репликации данных методом фиксации изменений (Change Data Capture, CDC) из PostgreSQL в аналитические хранилища, очереди и объектные хранилища. Проект вышел как самостоятельный open-source ETL/CDC-движок с лицензией AGPL-3.0, последний релиз открытого репозитория v0.37.5 датирован 26 августа 2024 года. В июле того же года PeerDB купила...
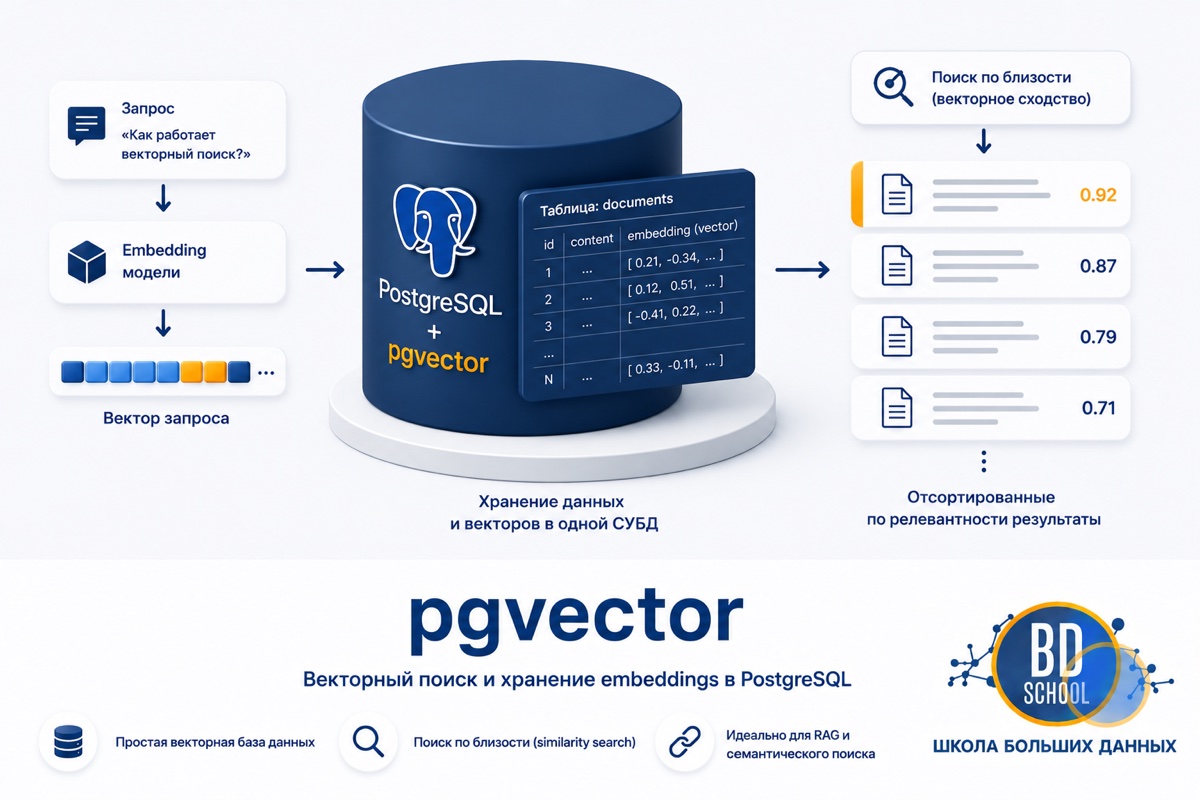
pgvector (PostgreSQL extension) - это открытое расширение PostgreSQL, добавляющее тип данных для хранения векторов, индексы приближённого поиска ближайших соседей (ANN, Approximate Nearest Neighbor) и операторы расстояния внутри реляционной СУБД. На момент подготовки статьи актуальна версия 0.8.6, вышедшая 29 июля 2026 года. Расширение решает ту же задачу, что специализированные векторные...
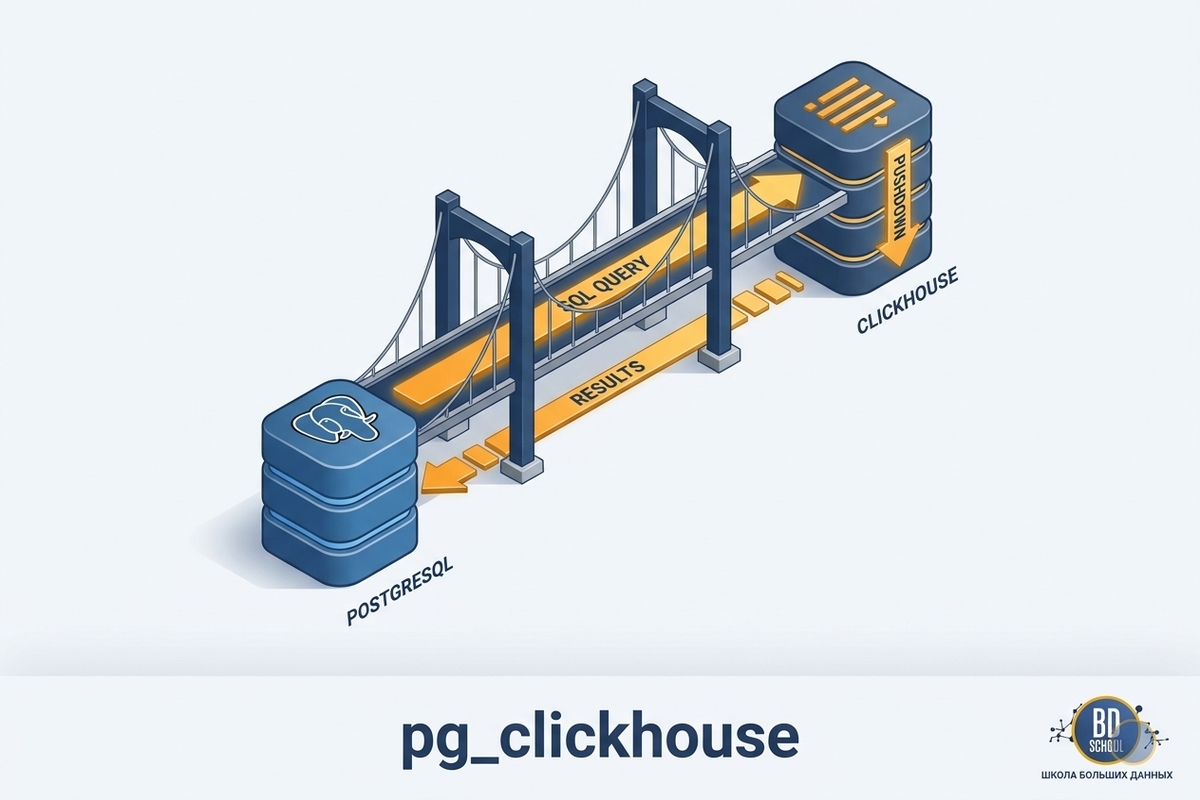
pg_clickhouse это открытое расширение PostgreSQL, которое отправляет часть SQL-запроса прямо на выполнение в ClickHouse через Foreign Data Wrapper (FDW), вместо того чтобы копировать данные между базами. PostgreSQL строит план запроса как обычно, а для операций над foreign-таблицами ClickHouse включается механизм проталкивания (pushdown), и часть работы, а именно фильтры, агрегаты...

Pi agent является минималистичным фреймворком и агентным CLI-инструментом с открытым исходным кодом. Лицензия MIT гарантирует свободное использование и модификацию продукта. Инструмент предназначен для автоматизации процессов написания кода, рефакторинга и управления проектами. Разработчики выполняют все операции непосредственно через терминал. Pi Agent реализует архитектурную концепцию тонкого ядра. Программа предоставляет языковой модели...
Polars - это высокопроизводительная библиотека для обработки и анализа данных, написанная на языке Rust, реализующая колоночную модель вычислений и поддерживающая ленивые (lazy) и eager-вычисления, ориентированная на эффективную работу с большими объёмами данных и предоставляющая интерфейс для Python. В отличие от традиционных инструментов, Polars изначально проектировался для параллельной обработки данных и...