 6
Содержание
- Что такое pgvector
- Архитектура и ключевые особенности
- Типы данных vector, halfvec, sparsevec и bit
- Индексы HNSW и IVFFlat
- Операторы расстояния между векторами
- Принцип работы pgvector
- Построение индекса и выполнение ANN-запроса
- Итеративные сканы против overfiltering
- Ограничения и когда pgvector не подходит
- Эволюция pgvector от 0.7.0 до 0.8.6
- Сценарии использования и отличительные черты
- Практика
- Заключение
- Референсные ссылки
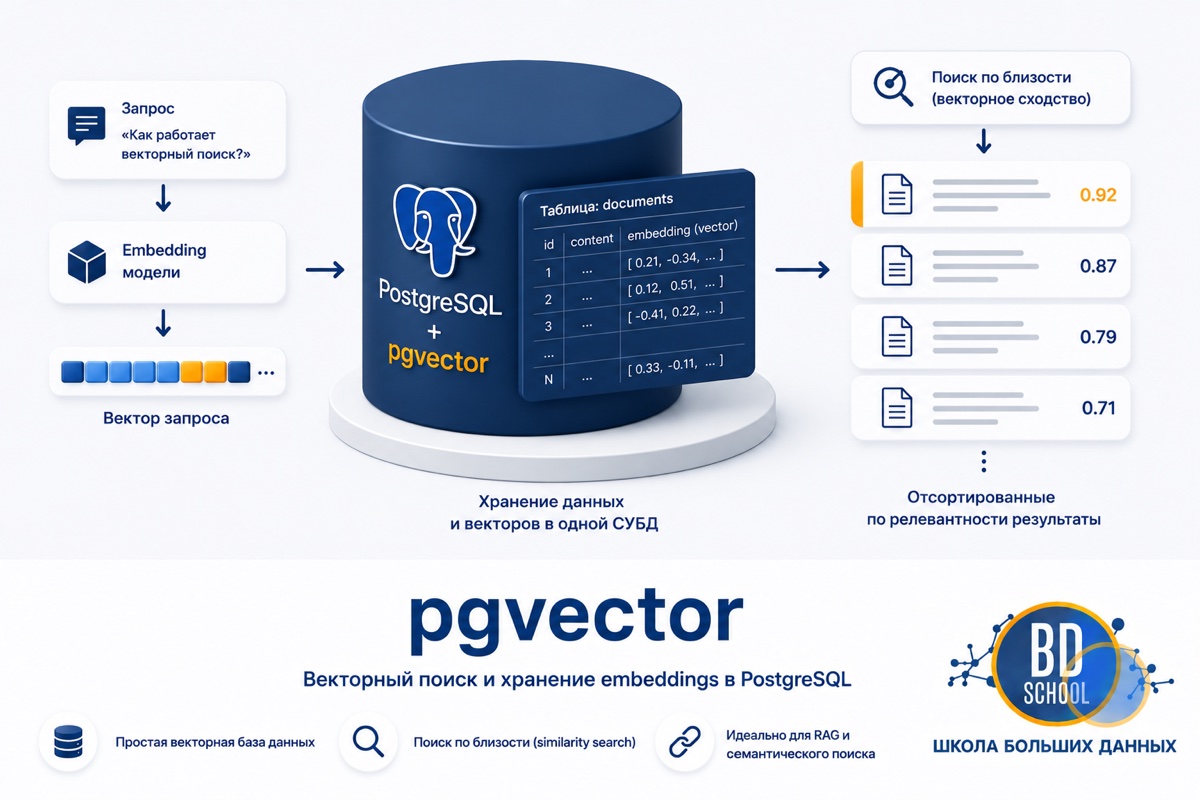
pgvector (PostgreSQL extension) — это открытое расширение PostgreSQL, добавляющее тип данных для хранения векторов, индексы приближённого поиска ближайших соседей (ANN, Approximate Nearest Neighbor) и операторы расстояния внутри реляционной СУБД. На момент подготовки статьи актуальна версия 0.8.6, вышедшая 29 июля 2026 года. Расширение решает ту же задачу, что специализированные векторные базы вроде Milvus, Qdrant или ChromaDB, но эмбеддинги остаются в той же таблице, что и обычные бизнес-данные, без выноса во внешнее хранилище.
Что такое pgvector
pgvector решает задачу поиска похожих объектов по эмбеддингам (embeddings), то есть векторным представлениям текста, изображений или другого контента, без выноса векторов в отдельное хранилище. Общий принцип устройства систем такого рода разобран в статье «ИИ и векторные базы данных», здесь же в фокусе то, что даёт pgvector внутри самого PostgreSQL и когда реляционного подхода достаточно.
Ключевая идея в том, что вектор хранится в той же строке таблицы, что и обычные бизнес-данные. Поиск пишется обычным SQL с операторами расстояния в ORDER BY и работает через стандартный планировщик запросов PostgreSQL, участвуя в тех же ACID-транзакциях, что и остальная логика приложения.
Архитектура и ключевые особенности
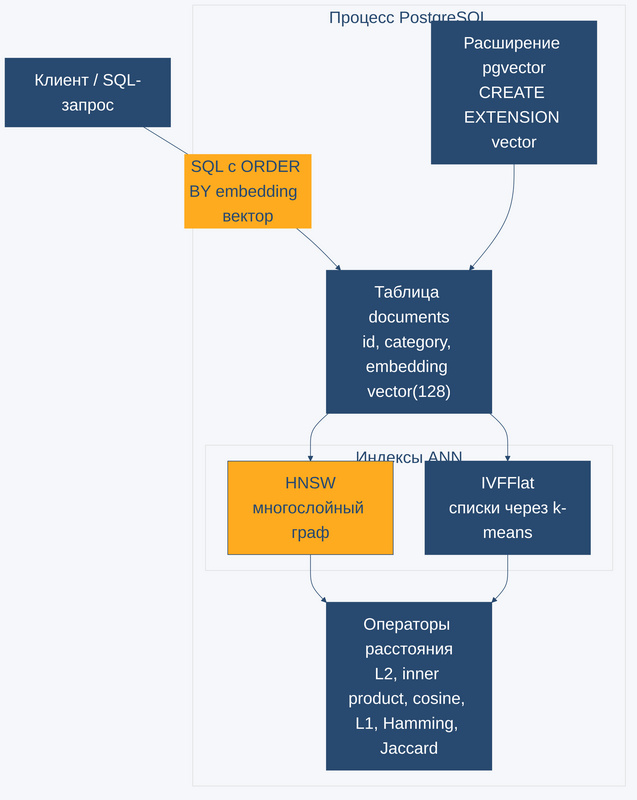
Расширение работает как обычный индекс и тип данных PostgreSQL, отдельного сервера или процесса у pgvector нет. Все векторные вычисления идут внутри самого движка Postgres, поэтому база с векторной колонкой ничем не отличается от обычной с точки зрения администрирования, репликации и мониторинга.
Типы данных vector, halfvec, sparsevec и bit
Под разные компромиссы точности, объёма хранения и совместимости с индексами pgvector предлагает четыре типа.
- vector. Базовый плотный (dense) тип, числа с одинарной точностью, до 16 000 измерений, на диске занимает 4 байта на измерение плюс 8 байт служебных данных.
- halfvec. Тот же плотный вектор, но с половинной точностью чисел, 2 байта на измерение вместо 4. Пригождается для эмбеддингов высокой размерности, которые не укладываются в лимит индексации обычного vector.
- sparsevec. Разреженный (sparse) вектор, хранит только ненулевые элементы, до 16 000 таких элементов, экономит место там, где большая часть измерений равна нулю.
- bit. Бинарный вектор до 64 000 бит, под бинарную квантизацию эмбеддингов и метрики расстояния вроде Hamming и Jaccard.
Выбор типа — компромисс между точностью, местом на диске и лимитом индексируемой размерности.
Индексы HNSW и IVFFlat
HNSW (Hierarchical Navigable Small World) строит многослойный граф соседства без фазы обучения, индекс можно создавать сразу на заполненной таблице, как в демо ниже. IVFFlat разбивает векторы на списки (lists) через кластеризацию k-means, поэтому имеет фазу обучения на данных и его разумнее строить после загрузки хотя бы части таблицы.
IVFFlat строится быстрее HNSW и занимает меньше памяти, но даёт худшее соотношение скорости и recall (полноты, доли действительно ближайших соседей среди найденных) на запросах. HNSW требует больше памяти и времени на построение, зато на запросах обычно быстрее и точнее. По одной из оценок, не подтверждённой напрямую в README, для коллекций от примерно 50 миллионов векторов экономия IVFFlat по памяти и времени сборки становится заметной, поэтому цифру стоит перепроверять на своих данных, а не полагаться на общее правило.
Индексировать можно не всю размерность без ограничений. HNSW и IVFFlat для vector работают максимум с 2000 измерениями, для halfvec максимум поднимается до 4000, а для bit до 64 000 бит. Разрыв между 16 000 хранимых измерений и 2000-4000 индексируемых означает, что для «широких» эмбеддингов часть размерности приходится урезать, переходить на halfvec или мириться с точным поиском без индекса.
Операторы расстояния между векторами
Расстояние pgvector считает шестью операторами. <-> — L2 (евклидово), <#> — inner product со знаком минус, <=> — cosine, самая частая метрика для эмбеддингов языковых моделей и использованная в демо статьи, <+> — L1 (манхэттенское), а <~> и <%> — Hamming и Jaccard для бинарного типа bit.
Принцип работы pgvector
Без индекса поиск по вектору в pgvector точный, полный перебор таблицы со стопроцентным recall. Индекс превращает поиск в приближённый (ANN), меняя часть recall на скорость, и именно этот компромисс демонстрируют примеры ниже на таблице из 5000 строк со 128-мерными случайными векторами.
Построение индекса и выполнение ANN-запроса
После CREATE INDEX … USING hnsw с параметрами по умолчанию m=16 и ef_construction=64 запрос с сортировкой по <=> и LIMIT идёт через индекс сам, без подсказок планировщику. План запроса это подтверждает строкой Index Scan using documents_embedding_idx. Ширину поиска по графу на этапе запроса регулирует параметр hnsw.ef_search, по умолчанию 40, чем он больше, тем точнее и медленнее поиск.
Итеративные сканы против overfiltering
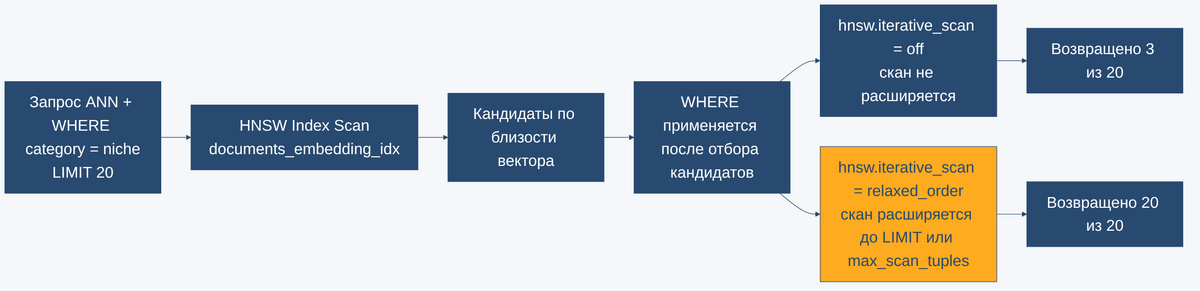
С версии 0.8.0 в pgvector появились итеративные сканы индекса, решающие проблему overfiltering, когда приближённый индекс находит кандидатов по близости вектора, а фильтр WHERE по обычной колонке применяется уже после отбора. Если искомая категория редкая, кандидатов может не хватить до LIMIT, и запрос вернёт меньше строк, чем просили, хотя подходящие строки в таблице есть.
Демо воспроизводит эффект на той же таблице из 5000 строк, где 250 отмечены редкой категорией niche. При hnsw.iterative_scan = off запрос на 20 строк этой категории вернул всего 3, величина случайная, но куда меньше 20. При hnsw.iterative_scan = relaxed_order, когда скан расширяется до нужного числа строк или лимита hnsw.max_scan_tuples (20000 по умолчанию), тот же запрос вернул все 20 из 20, ценой точного порядка по расстоянию. Похожий параметр ivfflat.max_probes управляет тем же поведением для IVFFlat.
Ограничения и когда pgvector не подходит
Официальная документация pgvector не формулирует раздел «когда не рекомендуется», но пределы видны по лимитам и механике планировщика PostgreSQL. Первый предел это память и нагрузка одной машины, на которой стоит PostgreSQL, расширение масштабируется вертикально вместе с базой, а не горизонтально через отдельные узлы под индексацию и поиск, как в распределённых векторных базах.
Второй предел виден на демо. Планировщик PostgreSQL выбирает путь запроса по стоимости, а не по факту наличия индекса: для селективного фильтра на 5000 строках он сам выбирает Seq Scan вместо HNSW-индекса, оценив узел плана в 25 строк (при реальных 250 строках категории niche), и такую оценку дешевле перебрать, чем идти через граф. Индекс пришлось форсировать параметром enable_seqscan = off, на таблице промышленного размера планировщик выбирает индекс сам.
Третий предел это разреженность экосистемы вокруг векторного поиска, специализированные базы чаще предлагают готовые интеграции ранжирования и гибридного поиска из коробки, а в pgvector это собирается поверх SQL самостоятельно. Альтернативная архитектура RAG разобрана в статье «Не только векторные БД», где поиск строится по связям графа, а не по вектору.
| Технология | Модель развёртывания | Когда предпочтительнее |
|---|---|---|
| pgvector | Расширение уже существующего PostgreSQL, отдельного сервера нет | Векторный поиск нужен внутри уже работающей реляционной базы приложения, без выноса данных наружу |
| Milvus | Embedded (Lite), Standalone, распределённый кластер на Kubernetes | Нагрузка растёт за пределы одной машины, нужна отдельная инфраструктура под векторный поиск |
| Qdrant | Один процесс на Rust, поддерживает кластерный режим | Нужен компактный сервер с REST/gRPC API без внешних зависимостей вроде etcd или очереди сообщений |
| ChromaDB | Встраиваемая Python-библиотека | Локальная разработка и небольшие RAG-прототипы, где отдельная БД вообще не нужна |
Строка pgvector в таблице не значит, что расширение всегда проще специализированной базы, она значит, что для команды с PostgreSQL в проде цена входа минимальна, а переход на выделенное хранилище остаётся доступен позже.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
12 октября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Эволюция pgvector от 0.7.0 до 0.8.6
К версии 0.7.0 pgvector уже поддерживал единственный тип vector с индексами IVFFlat и HNSW (HNSW добавлен в версии 0.5.0) по трём метрикам, L2, inner product и cosine. Версия 0.7.0 добавила типы halfvec и sparsevec, бинарную квантизацию и конкатенацию векторов, расширив расширение от одного типа вектора до многотипового хранилища.
Версия 0.8.0 добавила итеративные сканы индекса из раздела выше, решающие проблему overfiltering. Дальнейшие релизы до актуальной 0.8.6, вышедшей 29 июля 2026 года, по официальному репозиторию на GitHub в основном касаются исправлений памяти и стабильности индексов, а не новых возможностей, следующая версия 0.8.7 отмечена в CHANGELOG как ещё не выпущенная. За два минорных релиза pgvector прошёл путь от одного типа данных до четырёх и обзавёлся механизмом, отдельно решающим гибридный поиск, а индексы HNSW и IVFFlat появились раньше.
Сценарии использования и отличительные черты
Основной сценарий для pgvector это RAG-приложение (Retrieval-Augmented Generation), где эмбеддинги базы знаний живут в той же базе, что и остальные сущности приложения, а языковая модель дополняет ответ найденными по сходству фрагментами. Гибридный запрос, где к сортировке по расстоянию добавляется SQL-фильтр по правам доступа или тегам, пишется как один запрос, без похода во второе хранилище.
Практика встраивания таких инструментов в производственные ИИ-агенты раскрыта на курсе «ИИ-агенты для оптимизации бизнес-процессов», где PgVector прямо назван в программе.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Практика
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо прогнано на PostgreSQL 18.4 (Homebrew, arm64) с pgvector 0.8.6, сначала регистрируется расширение и функция генерации случайного вектора, затем таблица documents из 5000 строк, 250 (5%) в редкой категории niche. Функция объявлена VOLATILE намеренно, без этого планировщик вправе вычислить значение подзапроса один раз на весь запрос и подставить его во все строки, тогда все 5000 получили бы один и тот же вектор. Проверка count(DISTINCT embedding) отлавливает эту ошибку.
-- pgvector 0.8.6 (Homebrew, бутылка arm64), PostgreSQL 18.4, прогнано на стенде 2026-08-30
-- Шаг 1: расширение, таблица с векторной колонкой, тестовые данные.
--
-- Расширение регистрируется один раз на базу данных. База pgvector_demo создаётся
-- отдельно (см. RUNBOOK) командой createdb, потому что CREATE DATABASE в PostgreSQL
-- не принимает IF NOT EXISTS - этот файл уже подключается к готовой базе.
CREATE EXTENSION IF NOT EXISTS vector;

-- Вспомогательная функция для демо-данных. Собирает вектор нужной размерности из
-- случайных чисел в диапазоне [-1, 1]. VOLATILE обязателен: без него планировщик
-- Postgres вправе вычислить не-коррелированное значение один раз на весь запрос
-- и подставить его во все строки - реальные грабли, пойманные при подготовке
-- этого демо (см. RUNBOOK, раздел «если не так»).
CREATE OR REPLACE FUNCTION random_vector(dim int) RETURNS vector AS $$
DECLARE
    arr real[] := '{}';
BEGIN
    FOR i IN 1..dim LOOP
        arr := arr || (random() * 2 - 1)::real;
    END LOOP;
    RETURN arr::vector;
END;
$$ LANGUAGE plpgsql VOLATILE;

-- Таблица документов: обычная бизнес-колонка category рядом с vector-колонкой -
-- в этом и состоит архитектурная идея pgvector, вектор живёт в той же строке,
-- что и остальные данные, без выноса в отдельное хранилище.
DROP TABLE IF EXISTS documents;
CREATE TABLE documents (
    id bigserial PRIMARY KEY,
    category text NOT NULL,
    embedding vector(128) NOT NULL
);

-- 5000 строк, из них 5% (250 строк) в редкой категории 'niche'. Размерность 128
-- и объём выбраны так, чтобы дальше на шаге с фильтром WHERE было видно эффект
-- overfiltering - с более крупным индексом реального RAG-корпуса тот же эффект
-- проявляется на любой достаточно избирательной категории.
INSERT INTO documents (category, embedding)
SELECT
    CASE WHEN i % 20 = 0 THEN 'niche' ELSE 'popular' END,
    random_vector(128)
FROM generate_series(1, 5000) AS i;

-- Проверка: строки разные (без этой проверки описанный выше баг с
-- не-коррелированным подзапросом было бы не видно на глаз).
SELECT category, count(*) FROM documents GROUP BY category;
SELECT count(DISTINCT embedding) AS distinct_vectors FROM documents;
Реальный вывод подтверждает и разбивку по категориям, и то, что векторы у строк разные.
CREATE EXTENSION
CREATE FUNCTION
psql:setup.sql:28: NOTICE:  table "documents" does not exist, skipping
DROP TABLE
CREATE TABLE
INSERT 0 5000
 category | count
----------+-------
 niche    |   250
 popular  |  4750
(2 rows)

 distinct_vectors
------------------
             5000
(1 row)
Дальше на таблице строится HNSW-индекс по косинусному расстоянию, с параметрами по умолчанию m=16 и ef_construction=64.
-- pgvector 0.8.6, PostgreSQL 18.4, прогнано на стенде 2026-08-30
-- Шаг 2: построение индекса HNSW для операции cosine distance.
--
-- vector_cosine_ops - класс операторов под оператор расстояния <=> (косинусное
-- расстояние). Параметры m и ef_construction явно повторяют значения по умолчанию
-- документации pgvector (m=16, ef_construction=64): в отличие от IVFFlat, HNSW не
-- требует отдельной фазы обучения и строится сразу на заполненной таблице.
CREATE INDEX ON documents USING hnsw (embedding vector_cosine_ops)
    WITH (m = 16, ef_construction = 64);

-- Проверка, что индекс создан и планировщик о нём знает.
\d documents
CREATE INDEX
                                Table "public.documents"
  Column   |    Type     | Collation | Nullable |                Default
-----------+-------------+-----------+----------+---------------------------------------
 id        | bigint      |           | not null | nextval('documents_id_seq'::regclass)
 category  | text        |           | not null |
 embedding | vector(128) |           | not null |
Indexes:
    "documents_pkey" PRIMARY KEY, btree (id)
    "documents_embedding_idx" hnsw (embedding vector_cosine_ops) WITH (m='16', ef_construction='64')
Обычный ANN-запрос без фильтра, оператор <=>, вектор запроса из того же генератора, что и данные демо.
-- pgvector 0.8.6, PostgreSQL 18.4, прогнано на стенде 2026-08-30
-- Шаг 3: обычный ANN-запрос без фильтра, оператор косинусного расстояния <=>.
--
-- Вектор запроса берётся тем же генератором, что и данные в demo, - это
-- "запрос", для которого ищем ближайшие соседи. В реальном RAG-сценарии на этом
-- месте стоял бы эмбеддинг вопроса пользователя.
CREATE TEMP TABLE q_anchor AS SELECT random_vector(128) AS v;

-- hnsw.ef_search управляет шириной поиска по графу на этапе запроса (по
-- умолчанию 40). Явно не меняем - демонстрируем поведение по умолчанию.
EXPLAIN SELECT id, category
FROM documents
ORDER BY embedding <=> (SELECT v FROM q_anchor)
LIMIT 5;

SELECT id, category, round((embedding <=> (SELECT v FROM q_anchor))::numeric, 4) AS distance
FROM documents
ORDER BY embedding <=> (SELECT v FROM q_anchor)
LIMIT 5;
SELECT 1
                                               QUERY PLAN
--------------------------------------------------------------------------------------------------------
 Limit  (cost=234.37..237.72 rows=5 width=48)
   InitPlan 1
     ->  Seq Scan on q_anchor  (cost=0.00..23.60 rows=1360 width=32)
   ->  Index Scan using documents_embedding_idx on documents  (cost=210.77..3564.00 rows=5000 width=48)
         Order By: (embedding <=> (InitPlan 1).col1)
(5 rows)

  id  | category | distance
------+----------+----------
  585 | popular  |   0.6904
  599 | popular  |   0.6932
 1670 | popular  |   0.7095
 2768 | popular  |   0.7210
 3525 | popular  |   0.7226
(5 rows)
План показывает Index Scan using documents_embedding_idx без принуждения — планировщик сам выбирает индекс без фильтра. Дальше тот же вектор запроса используется в гибридном запросе с фильтром по категории niche, с демонстрацией overfiltering.
-- pgvector 0.8.6, PostgreSQL 18.4, прогнано на стенде 2026-08-30
-- Шаг 4: гибридный запрос - ANN-поиск плюс фильтр WHERE по обычной колонке,
-- и демонстрация overfiltering (с версии pgvector 0.8.0).
--
-- Overfiltering: приближённый индекс сканирует граф по близости вектора, а
-- WHERE-фильтр применяется уже ПОСЛЕ того, как кандидаты найдены. Если
-- искомая категория редкая, среди найденных кандидатов её может не хватить
-- до LIMIT - запрос вернёт меньше строк, чем просили, хотя подходящие строки
-- в таблице есть.
CREATE TEMP TABLE q_anchor AS SELECT random_vector(128) AS v;

-- На таблице в 5000 строк планировщик Postgres по стоимости сам выбирает
-- Seq Scan для запроса с фильтром по редкой категории (собственная оценка
-- планировщика для этого узла плана - 25 строк, при реальных 250 строках
-- категории niche; такую оценку дешевле отсортировать перебором, чем идти
-- в HNSW-индекс) - тогда поиск точный и overfiltering не проявляется в
-- принципе. enable_seqscan=off здесь
-- используется только для демонстрации: он форсирует именно ANN-путь через
-- индекс. На таблице промышленного размера (миллионы строк) планировщик
-- выбирает индекс сам, без этой команды.
SET enable_seqscan = off;

SET hnsw.iterative_scan = off;
EXPLAIN SELECT id FROM documents
    WHERE category = 'niche'
    ORDER BY embedding <=> (SELECT v FROM q_anchor)
    LIMIT 20;

SELECT 'iterative_scan = off' AS mode, count(*) AS rows_returned
FROM (
    SELECT id FROM documents
    WHERE category = 'niche'
    ORDER BY embedding <=> (SELECT v FROM q_anchor)
    LIMIT 20
) t;

-- relaxed_order снимает overfiltering: движок продолжает расширять скан графа,
-- пока не наберёт LIMIT строк или не упрётся в hnsw.max_scan_tuples (20000 по
-- умолчанию), ценой точного порядка результата по расстоянию.
SET hnsw.iterative_scan = relaxed_order;

SELECT 'iterative_scan = relaxed_order' AS mode, count(*) AS rows_returned
FROM (
    SELECT id FROM documents
    WHERE category = 'niche'
    ORDER BY embedding <=> (SELECT v FROM q_anchor)
    LIMIT 20
) t;

RESET enable_seqscan;
RESET hnsw.iterative_scan;
SELECT 1
SET
SET
                                              QUERY PLAN
------------------------------------------------------------------------------------------------------
 Limit  (cost=234.37..2917.00 rows=20 width=16)
   InitPlan 1
     ->  Seq Scan on q_anchor  (cost=0.00..23.60 rows=1360 width=32)
           Disabled: true
   ->  Index Scan using documents_embedding_idx on documents  (cost=210.77..3564.06 rows=25 width=16)
         Order By: (embedding <=> (InitPlan 1).col1)
         Filter: (category = 'niche'::text)
(7 rows)

         mode         | rows_returned
----------------------+---------------
 iterative_scan = off |             3
(1 row)

SET
              mode              | rows_returned
--------------------------------+---------------
 iterative_scan = relaxed_order |            20
(1 row)

RESET
RESET
План показывает отметку об отключении у Seq Scan — след принудительного enable_seqscan = off, без него планировщик выбрал бы перебор. Виден и эффект overfiltering. При выключенных итеративных сканах из 20 запрошенных строк вернулось только 3, а с hnsw.iterative_scan = relaxed_order вернулись все 20.
Заключение
pgvector переносит векторный поиск внутрь уже знакомой реляционной СУБД, добавляя типы данных для векторов, индексы HNSW и IVFFlat и операторы расстояния, работающие через стандартный SQL и планировщик PostgreSQL. Это оправданный выбор, когда эмбеддинги нужно хранить рядом с остальными данными приложения, а отдельный сервис под векторный поиск заводить не хочется. Итеративные сканы из версии 0.8.0 закрывают слабое место ANN-индексов при работе с SQL-фильтрами, а для нагрузок, перерастающих одну машину PostgreSQL, остаются специализированные решения вроде Milvus или Qdrant.
Референсные ссылки
- pgvector — официальный репозиторий на GitHub — README с описанием типов данных, индексов, операторов расстояния и лимитов.
- pgvector CHANGELOG.md — история версий, источник номера актуальной версии и даты релиза.
- pgvector 0.8.0 Released — PostgreSQL News — анонс версии с итеративными сканами индекса.
- «ИИ и векторные базы данных: как это работает?» — общий обзор архитектуры векторного поиска.
- «Не только векторные БД: графовый RAG для LLM и агентского ИИ» — альтернативная архитектура RAG на графовой базе.