 2
Содержание
Ollama это инструмент для локального запуска и обслуживания больших языковых моделей (large language model, LLM) через связку CLI-клиента и REST API сервера, который поднимается на обычном ноутбуке или на собственном сервере без похода в облако. Разработчик скачивает готовую квантованную (quantized) модель одной командой, обращается к ней через локальный HTTP-эндпоинт и получает поведение, похожее на облачный API, но с весами на своём диске. Разбираемся, как устроена эта связка изнутри, что происходит с запросом от момента вызова до потокового ответа и где Ollama уместна, а где нет.
Что такое Ollama
По устройству Ollama это пара «клиент плюс сервер». Команда ollama serve поднимает локальный процесс, который слушает REST API на порту 11434 и принимает запросы от CLI, от python-клиента или от любого HTTP-клиента вроде curl. Проверить, что сервер жив, можно одним запросом.
# проверка живости локального сервера Ollama
curl -s http://localhost:11434/api/tags
Ответ приходит в JSON со списком уже скачанных моделей. Официальная документация проекта (docs.ollama.com) описывает раздельными разделами CLI, REST API с эндпоинтами chat, generate, embeddings и models management, а также Modelfile для кастомизации модели поверх готовых весов. Такое разделение подсказывает, что CLI и API это два независимых входа в один и тот же сервер, а не два разных продукта.
Отдельная особенность Ollama против облачных провайдеров это формат хранения моделей. По официальной документации по импорту моделей, веса на диске лежат в формате GGUF, уже квантованном контейнере весов, токенизатора и метаданных модели, и сервер не переобучает и не дообучает их, а только загружает в память и прогоняет через них запрос. Проект развивается очень активно. На момент подготовки статьи актуальный релиз v0.33.2 вышел 27 августа 2026 года, а до него релизы выходили почти ежедневно, поэтому конкретный номер версии в статье быстро устареет и приводится только для ориентира.
Архитектура и ключевые особенности Ollama
Схема ниже собирает компоненты, с которыми реально работает разработчик, а именно клиентский слой (CLI и REST API клиенты вроде python-библиотеки), сервер Ollama, движок инференса (inference engine) внутри него и GGUF-модели на диске, которые сервер подгружает в память по запросу.
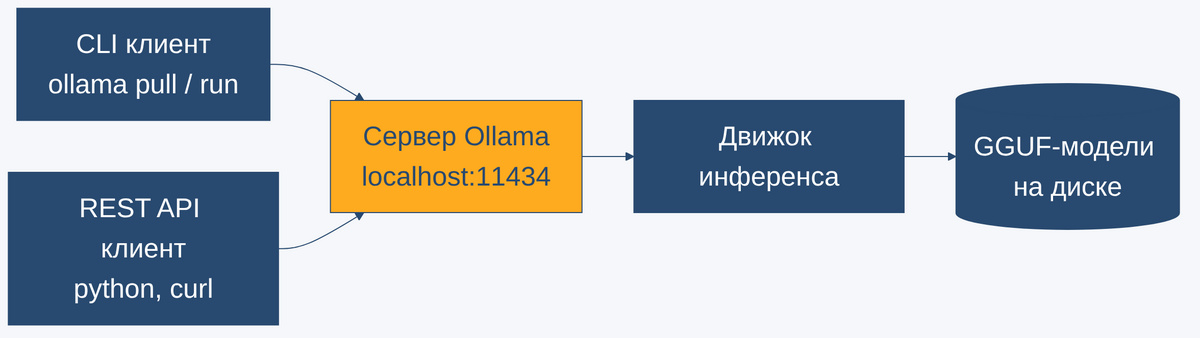
Python-клиент, пакет ollama, не содержит собственной логики инференса. Он собирает HTTP-запрос к тем же эндпоинтам, что доступны через curl, и разбирает JSON-ответ в удобные объекты. Это видно по коду демо в разделе «Практика». Вызов ollama.chat() внутри делает POST на /api/chat, а ollama.show() и ollama.list() дергают эндпоинты информации о моделях. Ключевая особенность такого устройства в том, что любой язык программирования с HTTP-клиентом может работать с Ollama напрямую, без официальной библиотеки.
Второй компонент, важный для практики, это Modelfile, механизм кастомизации модели поверх уже скачанных весов. Он не меняет параметры модели и не запускает дообучение, а навешивает system-промпт, параметры генерации вроде температуры и шаблон общения. Питон-клиент открывает тот же механизм через вызов ollama.create(), что подробно разобрано в разделе про квантование ниже.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Как Ollama запускает и обслуживает модели
Жизненный цикл одного запроса к /api/chat выглядит так же для CLI, для curl и для python-клиента, потому что все они бьют в один и тот же эндпоинт. Схема ниже показывает эту последовательность от вызова API до потокового ответа.
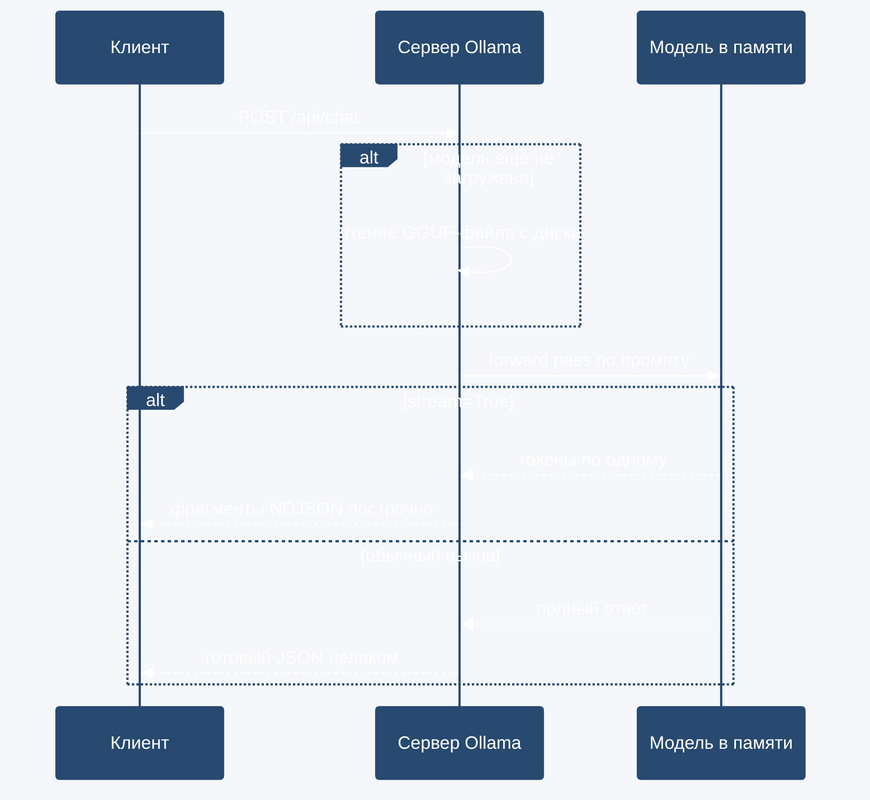
Сначала сервер проверяет, загружена ли нужная модель в память. Если нет, он читает GGUF-файл с диска и держит модель в памяти до следующего таймаута простоя, поэтому загрузка весов с диска всегда медленнее ответа от уже прогретой модели. На стенде qwen2.5:7b была прогрета ещё с прошлых демо, и первый вызов chat в скрипте занял 0.66 секунды, то есть это время самого инференса без загрузки весов с диска.
Дальше запрос обрабатывается в одном из двух режимов. Обычный вызов возвращает готовый ответ целиком одним JSON-объектом, а флаг stream=True переключает тот же самый эндпоинт на потоковую передачу NDJSON, где каждая строка ответа это один сгенерированный фрагмент токенов. В прогоне на стенде потоковый ответ на вопрос про REST API пришёл за 49 фрагментов за 3.97 секунды, и текст собирается на клиенте по мере поступления кусков, а не ждёт полной генерации.
Третий режим, вызов инструмента (tool calling), устроен иначе, чем можно ожидать. Модель не выполняет функцию сама, она возвращает структурированный tool_calls с именем функции и аргументами, а вызов реального кода и подстановка результата обратно в диалог остаются на стороне клиента. В демо модель на запрос «Какая погода в Дубае?» вернула структурированный вызов get_weather с аргументом city «Дубай», клиентский код подставил заглушку с результатом «+34°C, ясно» отдельным сообщением с ролью tool, и только вторым обращением к серверу пришёл связный текстовый ответ на языке пользователя. Без этого второго вызова диалог остаётся на уровне сырого JSON с аргументами функции.
Квантование в Ollama как компромисс размера, скорости и качества
Формат GGUF, в котором Ollama хранит модели, поддерживает несколько степеней квантования одного и того же набора весов, и выбор степени напрямую определяет, сколько модель займёт места на диске и в памяти. Прогон на стенде сравнил три тега одной и той же модели Qwen2.5 0.5B-instruct с одинаковым числом параметров, 494.03 миллиона, но разной степенью сжатия.
| Тег модели | Quantization level | Размер на диске |
|---|---|---|
| qwen2.5:0.5b-instruct-q4_0 | Q4_0 | 336 МБ |
| qwen2.5:0.5b-instruct-q8_0 | Q8_0 | 506 МБ |
| qwen2.5:0.5b-instruct-fp16 | F16 | 948 МБ |
Разница между крайними точками почти трёхкратная при одинаковом числе параметров. Q4_0 хранит веса 4-битными числами и даёт наименьший размер ценой точности, F16 хранит их в исходной 16-битной точности и занимает почти втрое больше места, а Q8_0 лежит между ними как промежуточный вариант. Метаданные квантования, поле quantization_level, доступны через ollama.show() без похода в сеть, они лежат прямо в манифесте модели, а вот размер файла на диске это поле отдаёт только ollama.list(), что видно в коде демо ниже.
Modelfile-механизм из предыдущего раздела работает поверх любого из этих тегов, потому что он не трогает сами веса. В демо создание кастомной модели wiki-ollama-demo с системным промптом поверх тега q4_0 не требует повторной загрузки полного набора весов с диска, потому что операция навешивает только промпт и параметры генерации, а не копирует и не пересчитывает веса заново.
Сценарии использования и когда Ollama не подходит
Ollama закрывает три частых сценария, а именно локальную разработку и отладку промптов без счёта за токены облачного провайдера, прототипирование агентов с вызовом инструментов до переноса на прод-стек и работу с приватными данными, которые нельзя отправлять во внешний API. Тема вызова инструментов и агентных сценариев подробнее разобрана в курсе «ИИ-агенты для оптимизации бизнес-процессов», который прямо упоминает Ollama в своей программе.
Честное ограничение видно на цифрах из собственного прогона. Небольшая модель размером 0.5 миллиарда параметров игнорирует инструкцию про язык ответа. В демо-запуске Modelfile она ответила на вопрос про столицу Франции иероглифами вместо ожидаемого текста на русском, хотя системный промпт требовал отвечать одним словом без пояснений. Модель qwen2.5:7b размером побольше в одном из вызовов соскользнула с русского на английский прямо на стыке слова, что видно в реальном выводе в разделе «Практика». Это не баг демо-скрипта, а типичное поведение локальных моделей такого масштаба, и статья фиксирует его как есть, а не сглаживает. С учётом этого поведения границы применимости Ollama выглядят так.
- Стоит применять. Локальная разработка, тестирование промптов и прототип агента с tool calling до переноса в прод-инфраструктуру.
- Стоит применять. Работа с чувствительными данными, которые по требованиям безопасности не должны покидать контур компании.
- Не подходит или избыточна. Production-сервис с множеством одновременных пользователей и требованием к суммарной пропускной способности GPU. Задачу пакетного обслуживания параллельных запросов решают специализированные inference-движки, а не однопоточный по своей сути локальный сервер.
- Не подходит без оговорок. Сценарии, где нужна гарантированно предсказуемая формулировка ответа малой моделью. Квантование и малый размер модели снижают устойчивость к инструкциям про формат и язык ответа, что видно на примерах выше.
Граница между «стоит» и «не стоит» проходит по числу параллельных пользователей и по тому, насколько критична предсказуемая формулировка ответа. Более широкий разбор эксплуатации моделей в проде, включая переход от локального прототипа к production-обслуживанию, дан в материале о том, как LLMOps расширяет практики MLOps.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Практика
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Первый файл, chat_tools.py, показывает три режима одного и того же эндпоинта /api/chat, а именно обычный вызов, потоковую генерацию и вызов инструмента с заглушкой функции получения погоды.
# ollama (python client) 0.6.2, сервер ollama 0.32.13, прогнано на стенде 2026-08-30
"""
Жизненный цикл запроса к Ollama через REST API (обёрнутый python-клиентом):
обычный вызов chat, потоковая генерация токен за токеном, вызов инструмента (tool calling).
Модель qwen2.5:7b уже загружена на стенде.
"""
import time

import ollama

MODEL = "qwen2.5:7b"


def demo_chat():
    # Один запрос-ответ: клиент шлёт POST /api/chat, сервер грузит модель в память
    # (если ещё не загружена) и возвращает готовый ответ целиком.
    t0 = time.time()
    response = ollama.chat(
        model=MODEL,
        messages=[{"role": "user", "content": "Сколько будет 17 умножить на 6? Ответь только числом."}],
    )
    elapsed = time.time() - t0
    print(f"[chat] {elapsed:.2f} с -> {response['message']['content'].strip()}")


def demo_stream():
    # stream=True переключает тот же эндпоинт на потоковую передачу: сервер отдаёт
    # NDJSON построчно, каждая строка - один сгенерированный фрагмент токенов.
    print("[stream] ", end="", flush=True)
    t0 = time.time()
    chunk_count = 0
    for chunk in ollama.chat(
        model=MODEL,
        messages=[{"role": "user", "content": "Объясни в одном предложении, что такое REST API."}],
        stream=True,
    ):
        print(chunk["message"]["content"], end="", flush=True)
        chunk_count += 1
    elapsed = time.time() - t0
    print(f"\n[stream] {chunk_count} фрагментов за {elapsed:.2f} с")


def get_weather(city: str) -> str:
    # Заглушка вместо реального похода в погодный API - интересен сам механизм
    # вызова инструмента, а не источник данных.
    fake_data = {"Москва": "-3°C, снег", "Дубай": "+34°C, ясно"}
    return fake_data.get(city, "нет данных")


def demo_tool_calling():
    # Модель не вызывает функцию сама - она возвращает structured tool_calls,
    # а выполнение и подстановку результата обратно в диалог делает клиентский код.
    tools = [
        {
            "type": "function",
            "function": {
                "name": "get_weather",
                "description": "Текущая погода в городе",
                "parameters": {
                    "type": "object",
                    "properties": {"city": {"type": "string", "description": "Название города"}},
                    "required": ["city"],
                },
            },
        }
    ]
    messages = [{"role": "user", "content": "Какая погода в Дубае?"}]
    response = ollama.chat(model=MODEL, messages=messages, tools=tools)
    tool_calls = response["message"].get("tool_calls") or []
    if not tool_calls:
        print("[tools] модель не запросила вызов инструмента:", response["message"]["content"])
        return

    call = tool_calls[0]
    args = call["function"]["arguments"]
    result = get_weather(args["city"])
    print(f"[tools] модель запросила get_weather({args}) -> {result}")

    # Результат инструмента возвращается модели отдельным сообщением с role="tool",
    # только после этого второго вызова получается связный ответ на языке пользователя.
    messages.append(response["message"])
    messages.append({"role": "tool", "content": result})
    final = ollama.chat(model=MODEL, messages=messages)
    print(f"[tools] финальный ответ -> {final['message']['content'].strip()}")


if __name__ == "__main__":
    demo_chat()
    demo_stream()
    demo_tool_calling()
Реальный вывод этого файла на стенде показывает всю цепочку целиком, включая место, где финальный ответ на последнем слове соскальзывает в английский текст без переключения языка.
[chat] 0.66 с -> 102
[stream] REST API - это методика разработки приложений, основанная на принципах выделения
различных функций в отдельные ресурсы и использование HTTP-запросов для их взаимодействия.
[stream] 49 фрагментов за 3.97 с
[tools] модель запросила get_weather({'city': 'Дубай'}) -> +34°C, ясно
[tools] финальный ответ -> В Дубае сейчас погода ясная с температурой +34°C. Будьте осторожны на улице и увлажняйте организмadequate hydration is important in such weather conditions.
Смешение языков посреди слова «организм/adequate» это не опечатка при вставке в статью, а дословный вывод модели qwen2.5:7b на этом конкретном прогоне.
Второй файл, modelfile_quantization.py, создаёт кастомную модель через ollama.create(), аналог Modelfile, поверх готового квантованного тега, а затем читает метаданные квантования у трёх тегов одной модели с разной степенью сжатия.
# ollama (python client) 0.6.2, сервер ollama 0.32.13, прогнано на стенде 2026-08-30
"""
Механизм Modelfile (кастомизация модели поверх готового GGUF-веса) и то, как Ollama
хранит и отдаёт метаданные квантования. Теги qwen2.5:0.5b-instruct-{q4_0,q8_0,fp16}
уже скачаны на стенде.
"""
import ollama

CUSTOM_MODEL = "wiki-ollama-demo"
BASE_MODEL = "qwen2.5:0.5b-instruct-q4_0"
QUANT_TAGS = [
    "qwen2.5:0.5b-instruct-q4_0",
    "qwen2.5:0.5b-instruct-q8_0",
    "qwen2.5:0.5b-instruct-fp16",
]


def demo_modelfile():
    # Modelfile не переобучает и не меняет веса - он навешивает system-промпт и
    # параметры генерации поверх уже скачанного GGUF-файла, поэтому create() занимает
    # секунды, а не время полной загрузки модели.
    for _ in ollama.create(
        model=CUSTOM_MODEL,
        from_=BASE_MODEL,
        system="Отвечай всегда одним словом, без пояснений.",
        parameters={"temperature": 0},
        stream=True,
    ):
        pass  # прогресс создания не нужен статье, важен факт готовности модели

    response = ollama.chat(
        model=CUSTOM_MODEL,
        messages=[{"role": "user", "content": "Столица Франции?"}],
    )
    print(f"[modelfile] кастомная модель '{CUSTOM_MODEL}' ответила: {response['message']['content'].strip()}")

    ollama.delete(CUSTOM_MODEL)
    print(f"[modelfile] '{CUSTOM_MODEL}' удалена, базовый тег {BASE_MODEL} не тронут")


def demo_quantization_metadata():
    # Один и тот же набор весов Qwen2.5 0.5B-instruct, три степени квантования GGUF.
    # ollama show отдаёт эти метаданные без похода в сеть - они лежат в манифесте модели.
    print("[quant] тег -> quantization_level | parameter_size | размер на диске")
    for tag in QUANT_TAGS:
        info = ollama.show(tag)
        details = info.details
        size_mb = _model_size_mb(tag)
        print(f"  {tag:<32} {details.quantization_level:<8} {details.parameter_size: str:
    # ollama.show() не отдаёт размер файла на диске - это поле есть только в ответе
    # /api/tags (то есть в ollama.list()), поэтому размер берётся оттуда отдельно.
    for m in ollama.list().models:
        if m.model == tag:
            return f"{m.size / 1024 / 1024:.0f}"
    return "?"


if __name__ == "__main__":
    demo_modelfile()
    demo_quantization_metadata()
Вывод этого файла подтверждает, что кастомизация через Modelfile не трогает базовый тег и что три степени квантования дают заметно разные размеры на диске при одинаковом числе параметров.
[modelfile] кастомная модель 'wiki-ollama-demo' ответила: 巴黎
[modelfile] 'wiki-ollama-demo' удалена, базовый тег qwen2.5:0.5b-instruct-q4_0 не тронут
[quant] тег -> quantization_level | parameter_size | размер на диске
  qwen2.5:0.5b-instruct-q4_0       Q4_0     494.03M    336 МБ
  qwen2.5:0.5b-instruct-q8_0       Q8_0     494.03M    506 МБ
  qwen2.5:0.5b-instruct-fp16       F16      494.03M    948 МБ
Ответ «巴黎» вместо ожидаемого «Париж» на прямой вопрос про столицу Франции при системном промпте «отвечай одним словом» это тот же эффект малой модели, что описан в разделе про сценарии применения выше, только зафиксированный на реальном коде, а не пересказанный.
Заключение
Ollama сводит запуск локальной LLM к паре команд, потому что берёт на себя загрузку GGUF-весов в память, REST API поверх них и Modelfile для лёгкой кастомизации без переобучения. Прогон на стенде показал обе стороны этого удобства. С одной стороны, один и тот же эндпоинт /api/chat одинаково легко отдаёт обычный ответ, поток и структурированный вызов инструмента, а квантование даёт предсказуемый компромисс между размером на диске и точностью модели. С другой стороны, локальные модели такого масштаба, особенно младшие теги вроде 0.5B, ведут себя менее предсказуемо, чем крупные облачные модели, и это стоит закладывать в план перед тем, как строить на них прод-сценарий, а не выяснять постфактум.
Референсные ссылки
- docs.ollama.com/llms.txt, карта официальной документации Ollama с разделами CLI, API, Modelfile, hardware support и context length.
- docs.ollama.com/import, официальное описание формата GGUF и импорта моделей в Ollama.
- github.com/ollama/ollama/releases, официальные release notes проекта, номер актуальной версии и даты выпусков.
- docs.ollama.com, корень официальной документации Ollama.