 19
Содержание
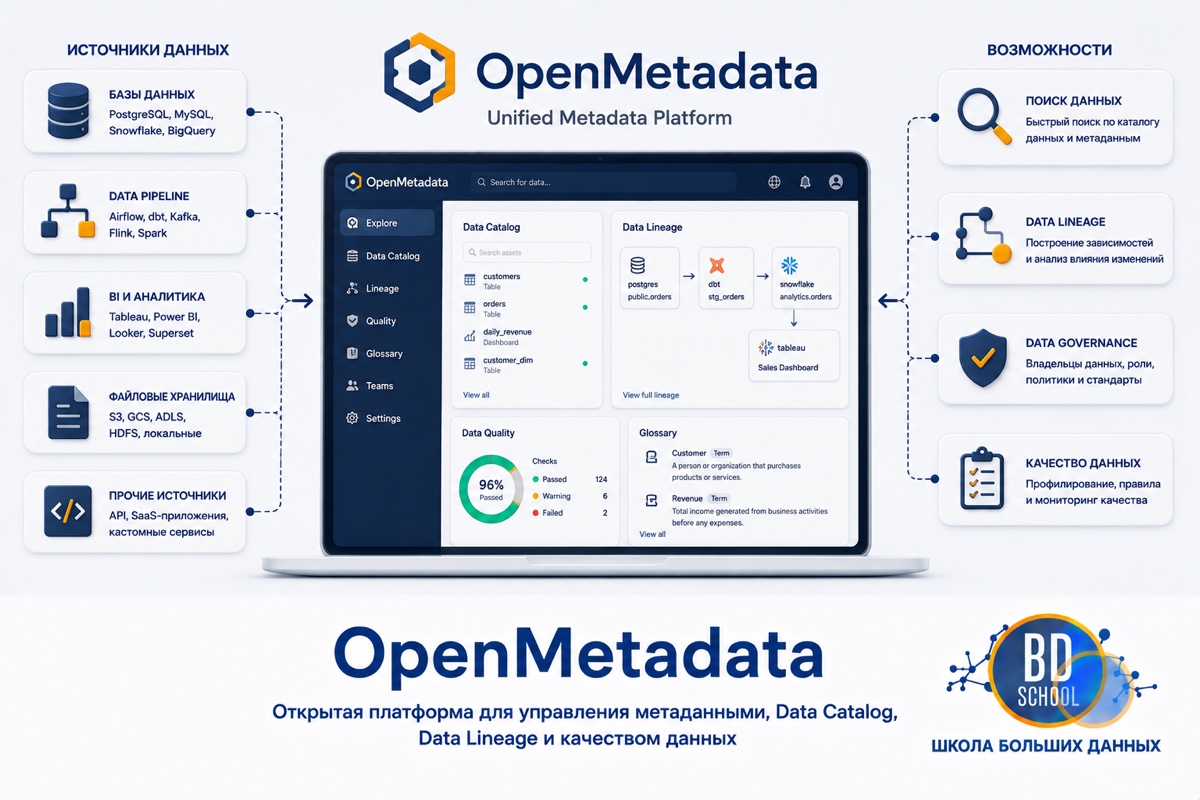
OpenMetadata это открытая платформа управления метаданными, которая объединяет каталог данных, governance и observability в одной системе и отдаёт проверенный контекст о данных не только людям, но и AI-агентам. В официальном README проекта на момент версии 2.0.0 она описана как «the open platform for trusted data context and business semantics for humans, AI assistants, and agents». Ниже разбираем архитектуру, механизм работы и то, чем версия 2.0 отличается от обычного каталога данных.
Что такое OpenMetadata
Классический каталог данных решает узкую задачу: он говорит, где лежит таблица, кто её владелец и какие колонки в ней есть. OpenMetadata начинала как раз с этой роли, но постепенно расширилась до полноценной платформы governance, наблюдаемости качества данных и, начиная с версии 2.0, слоя контекста для AI-агентов. Актуальный релиз, 2.0.0, вышел 24 августа 2026 года, проект живёт на ежемесячном цикле выпусков с шагом четыре-пять недель.
Об OpenMetadata уже писали в контексте более широкой темы управления метаданными на нашем блоге, в статье Metadata Management. Данные о данных как ключ к их ценности, а обзор открытых каталогов данных, включая OpenMetadata, есть в материале Data Governance. Как построить систему руководства и контроля данными, которая работает. Здесь мы разбираем платформу отдельно и подробно, с реальным прогоном на стенде.
Архитектура и ключевые компоненты
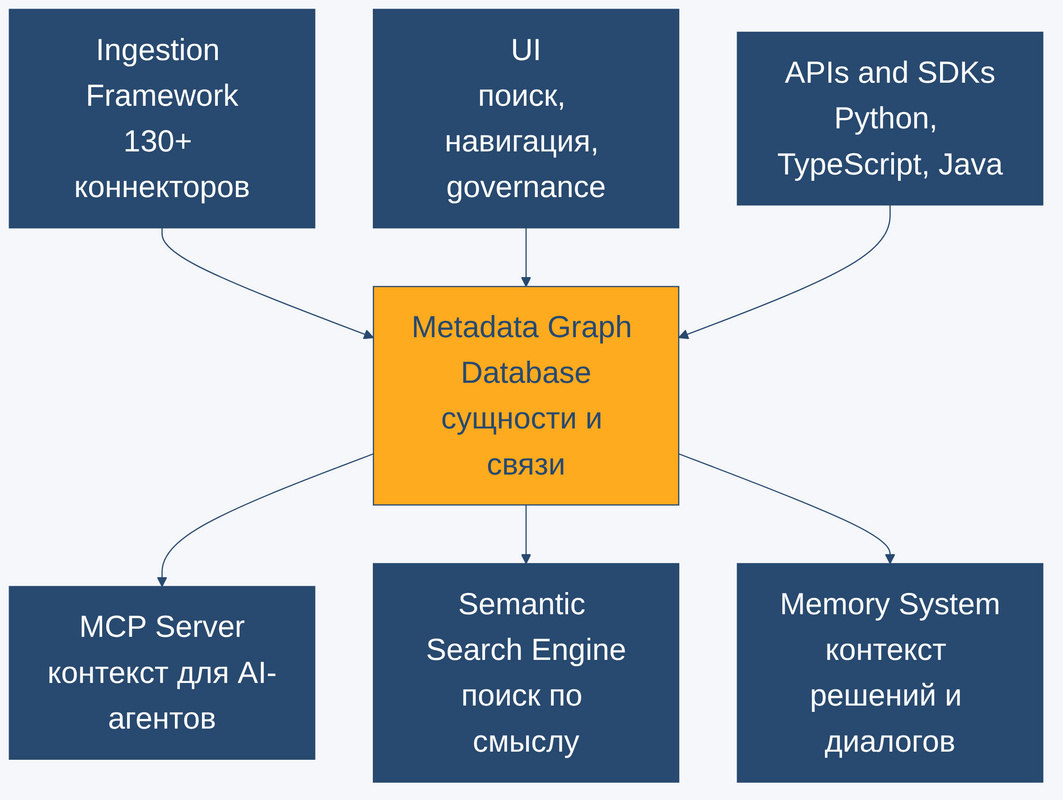
По описанию из официального README проекта на GitHub, платформа собрана из семи компонентов, и каждый закрывает свою часть работы с метаданными.
- Metadata Graph Database. Хранит сущности вроде таблиц, колонок, дашбордов и пайплайнов вместе со связями между ними, это ядро, вокруг которого построено всё остальное.
- Ingestion Framework. Забирает метаданные через 130+ готовых коннекторов к хранилищам данных, BI-инструментам, оркестраторам пайплайнов и платформам качества данных.
- UI. Поиск, навигация по каталогу и governance-функции для конечного пользователя.
- APIs & SDKs. Программный доступ к тем же данным на Python, TypeScript и Java, тот же путь используют и коннекторы ingestion framework.
- MCP Server. Отдаёт метаданные по Model Context Protocol (MCP) для AI-ассистентов и агентов, в версии 2.0 включён по умолчанию.
- Semantic Search Engine. Ищет активы по смыслу запроса, а не только по точному совпадению ключевых слов.
- Memory System. Сохраняет контекст разговоров, принятых решений и неписаных знаний организации как переиспользуемые сущности графа.
Вместе эти семь компонентов закрывают полный путь метаданных, от сбора через Ingestion Framework до отдачи готового контекста людям через UI и AI-агентам через MCP Server.
Оркестрация ingestion-пайплайнов исторически идёт через Apache Airflow, начиная с версии 1.12 появился альтернативный Kubernetes Orchestrator, а в release notes 2.0 путь через Airflow уже объявлен deprecated начиная с версии 2.1. Детальной схемы, какая СУБД и какой поисковый движок стоят за Metadata Graph Database и Semantic Search Engine в конкретной инсталляции, официальное README не даёт, это решает конфигурация деплоя.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы
Жизненный цикл метаданных в OpenMetadata описан в README как конвейер из шести стадий, и каждая следующая стадия использует результат предыдущей.
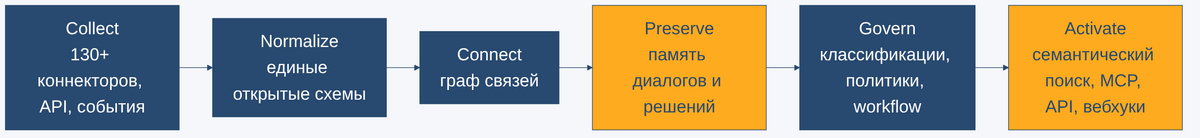
Collect собирает метаданные через коннекторы, API, события и SDK. Normalize приводит их к единым открытым схемам. Connect строит граф связей между таблицами, колонками, владельцами, политиками и лайнеджем (data lineage). Preserve сохраняет контекст разговоров как переиспользуемые сущности памяти, то есть именно эта стадия отвечает за Memory System. Govern управляет доступом через классификации, политики и workflow. Activate раздаёт результат наружу через семантический поиск, MCP, API и вебхуки, замыкая цикл на потребителя, будь то человек или агент.
Отдельно release notes 2.0 меняют механику профилирования данных. Профайлер по умолчанию переключён с полного сканирования всех строк таблицы на Dynamic Sampling, что снижает стоимость и время выполнения на больших таблицах. Побочный эффект в том, что метрики распределения кардинальности больше не собираются автоматически на каждый запуск, для классификации, тегов и кастомных правил их нужно включать явно в конфигурации профайлера.
OpenMetadata 2.0 и context layer для AI-агентов
Главное отличие 2.0 от предыдущих версий не в списке коннекторов, а в том, что платформа явно поворачивается к AI-агентам как к отдельному классу потребителей метаданных, а не только к людям в UI.
Механизм проверен реальным прогоном на стенде. MCP Server включён из коробки как внутреннее приложение McpApplication, эндпоинт POST /mcp отвечает сразу после логина обычным JWT-токеном, без отдельной активации через UI. По факту прогона сервер называет себя openmetadata-mcp-stateless версии 1.1.0 и поддерживает протокол MCP 2025-11-25. На вызов tools/list он вернул 24 инструмента, среди них search_metadata, semantic_search, get_asset_context, get_entity_lineage и root_cause_analysis. Ключевая разница с классическим REST API видна на инструменте get_asset_context: он отдаёт не сырой JSON индекса, а готовый markdown-документ со схемой таблицы, типами колонок и ограничениями, то есть контекст, который агент может подставить в промпт без разбора вложенной структуры.
Второй компонент того же поворота это Memory System, стадия Preserve конвейера, она хранит решения и контекст диалогов как сущности графа, к которым можно вернуться позже. Вместе MCP Server и Memory System и составляют смысл того, что в 2.0 у платформы появляется собственный Context Center вместо прежнего Knowledge Center, и ссылки старого вида /knowledge-center/… в 2.0 больше не работают, это заявленный breaking change.
Полный список технических изменений при переходе на 2.0 задокументирован в официальных release notes, и часть из них ломает существующие интеграции.
- Python 3.12 обязателен для ingestion. Прежний минимум был 3.10, старые окружения нужно обновлять перед апгрейдом.
- Great Expectations только версии ~=1.3. Поддержка веток 0.x убрана полностью.
- Databricks поменял конфигурацию аутентификации. Поле token заменено на структурированный объект authType.
- Semantic search переехал в новый блок конфигурации. Настройки эмбеддингов теперь живут в llmConfiguration вместо elasticsearch.naturalLanguageSearch, переменные окружения для credentials тоже переименованы.
Каждый пункт требует ручной правки конфигурации при апгрейде.
Сравнение с альтернативами
OpenMetadata не единственный открытый каталог данных, и выбор между ним и соседями обычно сводится к тому, какую роль платформа должна играть, каталог, событийный граф или инструмент governance для регулируемой организации.
| Критерий | OpenMetadata | DataHub | Amundsen | Collibra |
|---|---|---|---|---|
| Модель распространения | open source, self-hosted | open source, self-hosted | open source, self-hosted | коммерческая платформа, SaaS или on-prem |
| Происхождение | сообщество вокруг Collate — коммерческой компании, стоящей за проектом | Lyft | компания Collibra | |
| Приём метаданных | push и pull, 130+ коннекторов | преимущественно событийный push через Kafka | pull, периодические scrape-джобы по источникам | коннекторы вендора, настройка через UI |
| Слой для AI-агентов | MCP Server и Memory System из коробки в 2.0 | MCP Server отдельным open source пакетом, аналога Memory System нет | нет выделенного MCP-слоя | не входит в стандартную поставку |
| Основной фокус | каталог, governance, observability и AI-контекст вместе | каталог и лайнедж на событийной модели | поиск и discovery по каталогу, governance слабее | governance и compliance для крупных регулируемых организаций |
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Сценарии использования
Из README видно, что платформу применяют шире, чем просто как справочник по таблицам.
- AI-driven discovery. Обоснование ответов доверенных AI-ассистентов через контекст каталога, это и есть сценарий, под который в 2.0 добавили MCP Server.
- Impact-анализ. Оценка, кто пострадает при изменении схемы таблицы или колонки, до того как изменение попало в прод.
- Автоматизация governance. Классификации, политики и workflow контроля качества данных без ручной проверки каждой таблицы.
- Память организации. Накопление tribal knowledge и решений команды как переиспользуемых сущностей вместо разрозненных заметок в чатах.
- Контроль контрактов данных. Проверка, что источник продолжает отдавать данные в согласованной схеме, а не ломает потребителей молча.
У этих пяти сценариев общий знаменатель — платформа выступает единым источником проверенного контекста, на который опираются и человек, и AI-агент, а не просто хранит метаданные для отчётности.
Официальной формулировки «когда OpenMetadata не подходит» в README и release notes нет, но по составу компонентов видна практическая граница. Если организация обслуживает десяток таблиц и трёх аналитиков, разворачивать сервер, Elasticsearch и отдельную metadata-store СУБД ради governance избыточно, документация в виде README репозитория или простого вики-раздела решит ту же задачу дешевле. Платформа окупается там, где источников десятки, а вопрос «откуда эти данные и кто их трогал» задаётся регулярно и требует не только человеческого, но и AI-агентского ответа, здесь разбор архитектур управления данными на курсе «Архитектура Данных» даёт системную базу для такого выбора.
Практика с коннектором, REST API и MCP на реальных данных
По традиции весь код, используемый в статье, выкладываем на наш GitHub репозиторий.
Демо поднимает OpenMetadata 2.0.0 через docker-compose стенд на официальных образах docker.getcollate.io/openmetadata (тег 2.0.0), сканирует локальную PostgreSQL-базу ingestion-фреймворком и потом читает те же метаданные двумя способами, обычным REST API каталога и MCP Server. Первый скрипт логинится под admin, получает JWT и запускает workflow сканирования. Готовый compose-файл релиза 2.0.0 рассчитан на max_connections=20 у своего Postgres, а миграциям OpenMetadata этого не хватает — два пула HikariCP падают с «remaining connection slots are reserved for non-replication superuser connections». Рабочий стенд поднимается только после правки command у сервиса postgresql на -c max_connections=200.
# openmetadata-ingestion 2.0.0.0, стенд docker-compose (server+ingestion+elasticsearch) 2.0.0,
# прогнано на стенде 2026-08-27. Источник: PostgreSQL 18.4 (Homebrew), демо-база semantic_layer_demo.
"""
Реальное сканирование локальной PostgreSQL-базы конвейером ingestion framework OpenMetadata
и запись результата через sink metadata-rest в поднятый docker-compose стенд (localhost:8585).

Логин делается каждый прогон: OpenMetadata не хранит долгоживущий пароль в файле, JWT
получаем через /api/v1/users/login и используем как securityConfig.jwtToken воркфлоу.
"""
import sys

import requests
from metadata.workflow.metadata import MetadataWorkflow

OPENMETADATA_HOST = "http://localhost:8585/api"
ADMIN_EMAIL = "admin@open-metadata.org"
ADMIN_PASSWORD_B64 = "YWRtaW4="  # "admin" в base64 - так его ждёт /users/login

# Локальный Postgres на этой машине, доверительная аутентификация: пароль не проверяется,
# но пустую строку OpenMetadata-коннектор не принимает, поэтому кладём непустую заглушку.
SOURCE_DB = {
    "type": "postgres",
    "serviceName": "wiki_semantic_layer_demo",
    "serviceConnection": {
        "config": {
            "type": "Postgres",
            "username": "techfriends",
            "authType": {"password": "not-checked-trust-auth"},
            "hostPort": "localhost:5432",
            "database": "semantic_layer_demo",
        }
    },
    # schemaFilterPattern фильтрует схемы для ингеста, но живёт не в serviceConnection (это
    # поле там тоже есть, но реально не используется), а в sourceConfig.config - без него
    # коннектор по умолчанию заодно сканирует служебную information_schema (70+ системных
    # представлений вроде triggers, routines) и заливает их в каталог наравне с бизнес-таблицами.
    "sourceConfig": {
        "config": {
            "type": "DatabaseMetadata",
            "schemaFilterPattern": {"excludes": ["^information_schema$"]},
        }
    },
}


def get_jwt_token() -> str:
    resp = requests.post(
        f"{OPENMETADATA_HOST}/v1/users/login",
        json={"email": ADMIN_EMAIL, "password": ADMIN_PASSWORD_B64},
        timeout=15,
    )
    resp.raise_for_status()
    return resp.json()["accessToken"]


def build_config(jwt_token: str) -> dict:
    return {
        "source": SOURCE_DB,
        "sink": {"type": "metadata-rest", "config": {}},
        "workflowConfig": {
            "loggerLevel": "INFO",
            "openMetadataServerConfig": {
                "hostPort": OPENMETADATA_HOST,
                "authProvider": "openmetadata",
                "securityConfig": {"jwtToken": jwt_token},
            },
        },
    }


def main() -> int:
    token = get_jwt_token()
    print(f"JWT получен, длина {len(token)} символов")

    workflow_config = build_config(token)
    workflow = MetadataWorkflow.create(workflow_config)
    workflow.execute()
    workflow.print_status()
    workflow.stop()

    # raise_from_status падает исключением при любом сбое шага - так прогон честно
    # завершается ненулевым кодом, а не тихо проглатывает ошибку источника.
    workflow.raise_from_status()
    print("Ingestion metadata workflow завершён успешно")
    return 0


if __name__ == "__main__":
    sys.exit(main())
Реальный вывод прогона против таблицы orders показывает чистое сканирование без ошибок, кроме ожидаемого предупреждения про отсутствующее расширение pg_stat_statements, оно не мешает основному workflow.
# ключевые строки run_output.txt, ingest_postgres_metadata.py, стенд OpenMetadata 2.0.0, прогон 2026-08-27
Test connection for 'Postgres': Successful
Workflow Postgres Summary:
Processed records: 8
Filtered: 1
Errors: 0
Success %: 100.0
Workflow Success %: 100.0
Workflow finished in time: 1s 013.292ms
JWT получен, длина 718 символов
Ingestion metadata workflow завершён успешно
Filtered: 1 это отфильтрованная схема information_schema, ровно то, что должен был исключить schemaFilterPattern из sourceConfig. Полный selfcheck (стенд уже поднят, оба демо-файла подряд, логин, ingest, REST и четыре вызова MCP) занимает около 8 секунд, сам вызов initialize у MCP Server отвечает за доли секунды.
Второй скрипт читает те же метаданные о таблице orders двумя способами и печатает разницу между сырым индексом и готовым контекстом.
# openmetadata-ingestion 2.0.0.0, стенд OpenMetadata server 2.0.0, MCP-эндпоинт (JSON-RPC,
# stateless, версия протокола 2025-11-25 по ответу initialize), прогнано на стенде 2026-08-27.
"""
Показывает разницу между двумя способами читать те же метаданные, полученные скриптом
ingest_postgres_metadata.py: классический REST API каталога и MCP Server, который в 2.0
идёт включённым по умолчанию как внутреннее приложение McpApplication (без действий в UI).

REST отдаёт сырой документ индекса. MCP-инструмент get_asset_context отдаёт уже собранный
markdown с ключами и ограничениями - то, что AI-агент может подставить в промпт без разбора
JSON. Это и есть разница между «каталог» и «context layer» из фокуса статьи.
"""
import json
import sys

import requests

OPENMETADATA_HOST = "http://localhost:8585"
ADMIN_EMAIL = "admin@open-metadata.org"
ADMIN_PASSWORD_B64 = "YWRtaW4="
TABLE_FQN = "wiki_semantic_layer_demo.semantic_layer_demo.public.orders"


def get_jwt_token() -> str:
    resp = requests.post(
        f"{OPENMETADATA_HOST}/api/v1/users/login",
        json={"email": ADMIN_EMAIL, "password": ADMIN_PASSWORD_B64},
        timeout=15,
    )
    resp.raise_for_status()
    return resp.json()["accessToken"]


def rest_search(token: str, query: str) -> dict:
    resp = requests.get(
        f"{OPENMETADATA_HOST}/api/v1/search/query",
        params={"q": query, "index": "table_search_index"},
        headers={"Authorization": f"Bearer {token}"},
        timeout=15,
    )
    resp.raise_for_status()
    return resp.json()


def mcp_call(token: str, request_id: int, method: str, params: dict) -> dict:
    resp = requests.post(
        f"{OPENMETADATA_HOST}/mcp",
        headers={
            "Authorization": f"Bearer {token}",
            "Content-Type": "application/json",
            "Accept": "application/json, text/event-stream",
        },
        json={"jsonrpc": "2.0", "id": request_id, "method": method, "params": params},
        timeout=15,
    )
    resp.raise_for_status()
    return resp.json()


def main() -> int:
    token = get_jwt_token()

    print("=== 1. Классический REST API каталога: search/query ===")
    hits = rest_search(token, "orders")["hits"]["hits"]
    print(f"Найдено документов: {len(hits)}")
    top = hits[0]["_source"]
    print(f"Верхний результат: {top['fullyQualifiedName']}, колонок: {len(top['columns'])}")
    print("Дальше это сырой JSON индекса - агенту пришлось бы самому доставать ключи,")
    print("primary key и типы колонок из вложенной структуры.\n")

    print("=== 2. MCP Server: initialize ===")
    init = mcp_call(
        token, 1, "initialize",
        {"protocolVersion": "2025-11-25", "capabilities": {}, "clientInfo": {"name": "wiki-demo", "version": "1.0"}},
    )
    server_info = init["result"]["serverInfo"]
    print(f"Сервер: {server_info['name']} {server_info['version']}, "
          f"протокол {init['result']['protocolVersion']}\n")

    print("=== 3. MCP Server: tools/list ===")
    tools = mcp_call(token, 2, "tools/list", {})["result"]["tools"]
    print(f"Инструментов доступно: {len(tools)}")
    print(", ".join(t["name"] for t in tools) + "\n")

    print("=== 4. MCP Server: tools/call search_metadata (найти таблицу по имени) ===")
    search_result = mcp_call(
        token, 3, "tools/call",
        {"name": "search_metadata", "arguments": {"query": "orders", "entityType": "table"}},
    )
    search_payload = json.loads(search_result["result"]["content"][0]["text"])
    print(f"Найдено таблиц: {search_payload['totalFound']}, "
          f"первая: {search_payload['results'][0]['fullyQualifiedName']}\n")

    print("=== 5. MCP Server: tools/call get_asset_context (готовый контекст для промпта) ===")
    context_result = mcp_call(
        token, 4, "tools/call",
        {"name": "get_asset_context", "arguments": {"entityType": "table", "fqn": TABLE_FQN, "format": "markdown"}},
    )
    context_payload = json.loads(context_result["result"]["content"][0]["text"])
    print(context_payload["content"])

    return 0


if __name__ == "__main__":
    sys.exit(main())
Вывод показывает контраст, ради которого затевалось демо. REST API каталога вернул сырой документ индекса с найденной таблицей orders на 6 колонок, дальше из него ещё нужно было бы доставать типы и ключи руками. MCP Server через get_asset_context вместо этого отдал готовый markdown.
# ключевые строки run_output.txt, query_context_layer_mcp.py, MCP Server openmetadata-mcp-stateless 1.1.0, протокол 2025-11-25, прогон 2026-08-27
=== 3. MCP Server: tools/list ===
Инструментов доступно: 24

=== 5. MCP Server: tools/call get_asset_context (готовый контекст для промпта) ===
# Schema

| Column | Type | Constraint | Description |
|--------|------|------------|-------------|
| order_id | integer | PRIMARY_KEY |  |
| customer_id | integer | NOT_NULL |  |
| order_date | date | NOT_NULL |  |
| region | text | NOT_NULL |  |
| status | text | NOT_NULL |  |
| amount | numeric(10,2) | NOT_NULL |  |

**Primary key:** order_id
Такой markdown агент подставляет в промпт напрямую, без парсинга JSON и без риска перепутать вложенный ключ. Это и есть на практике то, что в README называется «trusted data context» вместо обычного каталога.
Заключение
OpenMetadata это открытая платформа, у которой ядро осталось прежним, граф метаданных, 130+ коннекторов и конвейер из шести стадий от сбора до активации. Версия 2.0 добавляет к этому ядру MCP Server и Memory System, и на реальном прогоне видно, что это не маркетинговая надпись, а рабочий эндпоинт, который отдаёт агенту готовый контекст вместо сырого JSON. Плата за переход стандартная для крупного релиза, минимальная версия Python поднята, часть конфигураций переехала, старые ссылки на Knowledge Center сломаны. Для команды, которая уже держит каталог данных и подключает к нему AI-агентов, это готовый context layer из коробки, а не то, что нужно собирать самим поверх обычного REST API.