 55
Содержание
- Что такое PeerDB
- Архитектура и ключевые компоненты
- Nexus Query Layer
- Flow (API + Workers) и Temporal
- Catalog, источники и назначения
- Принцип работы от mirror к потоковой репликации
- От независимого проекта к движку ClickPipes
- Дубли и качество данных при CDC в ClickHouse
- Сценарии использования и границы применимости
- Практика
- Заключение
- Референсные ссылки
PeerDB это инструмент для потоковой репликации данных методом фиксации изменений (Change Data Capture, CDC) из PostgreSQL в аналитические хранилища, очереди и объектные хранилища. Проект вышел как самостоятельный open-source ETL/CDC-движок с лицензией AGPL-3.0, последний релиз открытого репозитория v0.37.5 датирован 26 августа 2024 года. В июле того же года PeerDB купила компания ClickHouse, и сегодня тот же движок работает под капотом коннектора Postgres CDC в ClickPipes для ClickHouse Cloud. Ниже разбираем архитектуру инструмента, механизм переноса данных и то, что смена владельца поменяла для тех, кто реплицирует данные из Postgres в ClickHouse.
Что такое PeerDB
PeerDB решает узкую задачу. Данные меняются в оперативной базе постоянно, а аналитическое хранилище должно видеть эти изменения с минимальной задержкой, без полного перезалива таблиц по расписанию. Инструмент читает поток изменений из PostgreSQL и доставляет его в целевую систему, беря на себя начальный снапшот, батчинг и повтор при сбоях.
Развернуть PeerDB можно двумя способами. Self-hosted вариант поднимается docker-compose стеком из официального репозитория и требует своих ресурсов. Управляемый PeerDB Cloud снимает эксплуатацию с пользователя за отдельную плату. По заявлению самой документации проект эффективен на датасетах от десятков гигабайт до нескольких терабайт и даёт ускорение в 2-16 раз по сравнению с другими инструментами переноса данных из Postgres.
Список поддерживаемых систем в источниках расходится. Страница архитектуры называет источниками Postgres и MySQL, а назначениями BigQuery и Snowflake. Описание репозитория на GitHub дополнительно упоминает поддержку ClickHouse и MongoDB. Расхождение похоже на разницу между базовым и полным списком коннекторов, а не на ошибку, но однозначного подтверждения в документации на момент подготовки статьи нет.
Архитектура и ключевые компоненты
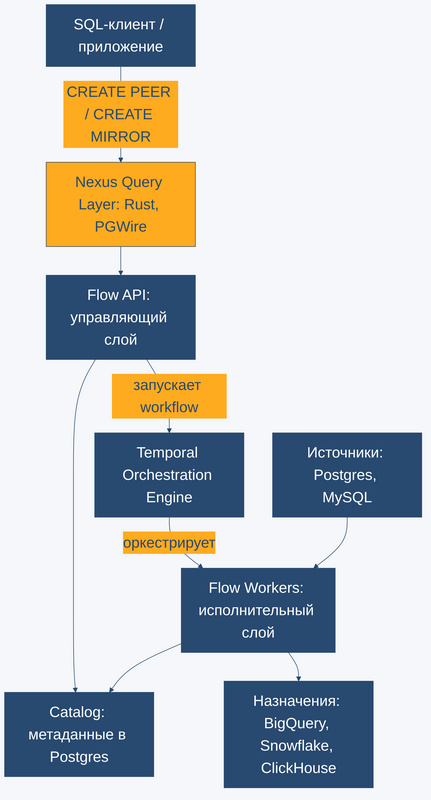
Инструмент собран из пяти частей, каждая отвечает за свой слой задачи. Подробное описание компонентов даёт официальная страница архитектуры PeerDB.
Nexus Query Layer
Nexus написан на Rust и говорит по протоколу PGWire, поэтому с ним можно работать любым Postgres-клиентом. Через него настраивается вся репликация обычными SQL-командами вроде CREATE PEER и CREATE MIRROR, а сам Nexus дальше маршрутизирует запросы к источникам и назначениям. Слой горизонтально масштабируется, если нужна дополнительная пропускная способность.
Flow (API + Workers) и Temporal
Flow, написанный на Go, отвечает за фактическое перемещение данных и делится на два слоя. Flow API это управляющий слой, который принимает команды от Nexus и превращает их в workflow. Flow Workers это исполнительный слой, который делает основную работу, снимает снапшот и читает поток изменений, и тоже масштабируется горизонтально при росте нагрузки.
Оркестрацией workflow занимается внешний сервис Temporal Orchestration Engine. Он координирует шаги переноса данных, переживает падение отдельного воркера и знает, на каком шаге остановился каждый mirror, поэтому именно к нему обращается PeerDB при остановке или перезапуске репликации.
Catalog, источники и назначения
Служебные метаданные, а именно список peer’ов, mirror’ов и их состояние, хранятся в отдельной базе Postgres, которая называется Catalog. Через неё Flow API и Flow Workers синхронизируют своё представление о том, какие репликации сейчас активны. Источниками данных выступают Postgres и MySQL, назначениями по официальному описанию архитектуры служат BigQuery и Snowflake, а по данным репозитория GitHub список назначений шире и включает ClickHouse.
Построение DWH на ClickHouse
Код курса
CLICH
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы от mirror к потоковой репликации
Официальная документация подробно описывает компоненты, но не даёт пошагового разбора пути данных. Механизм ниже восстановлен по коду настройки и по поведению реального прогона на собственном стенде, а не пересказан из документации.
Репликация настраивается через SQL-команды в Nexus. Сначала создаются два peer’а, один для источника Postgres, второй для назначения, у каждого свой набор параметров подключения. Дальше создаётся mirror, который связывает конкретные таблицы источника и назначения и включает потоковый режим.
-- Nexus SQL, PGWire-интерфейс peerdb-server v0.37.5, порт 9900, прогнано на стенде 2026-09-03.
-- Подключение: postgresql://postgres:peerdb@localhost:9900/postgres
--
-- Это не обычный Postgres: Nexus сам парсит расширения CREATE PEER / CREATE MIRROR и
-- транслирует их в вызовы Flow API, который заводит workflow в Temporal.

-- Источник — база "source" внутри того же catalog-Postgres (см. source_schema.sql)
CREATE PEER pg_source FROM POSTGRES WITH (
    host = 'catalog',
    port = '5432',
    user = 'postgres',
    password = 'postgres',
    database = 'source'
);

-- Назначение — отдельный ClickHouse из clickhouse_target_compose.yml
CREATE PEER ch_target FROM CLICKHOUSE WITH (
    host = 'clickhouse-target',
    port = '9000',
    user = 'peerdb',
    password = 'peerdb_demo_pass',
    database = 'peerdb_target',
    disable_tls = 'true'
);

-- do_initial_copy=true снимает полный снапшот таблицы orders, дальше mirror сам
-- переключается на потоковое CDC через слот логической репликации Postgres (плагин pgoutput)
CREATE MIRROR orders_cdc FROM pg_source TO ch_target
WITH TABLE MAPPING (public.orders:peerdb_target.orders_cdc)
WITH (
    do_initial_copy = true
);
Параметр do_initial_copy определяет, снимает ли PeerDB полный снапшот таблицы перед стартом. После снапшота mirror переключается на потоковый режим и читает изменения через слот логической репликации Postgres на плагине pgoutput, тот же механизм, что использует штатная логическая репликация СУБД. Flow Workers превращают поток изменений в батчи и выгружают их через промежуточный стейджинг в назначение.
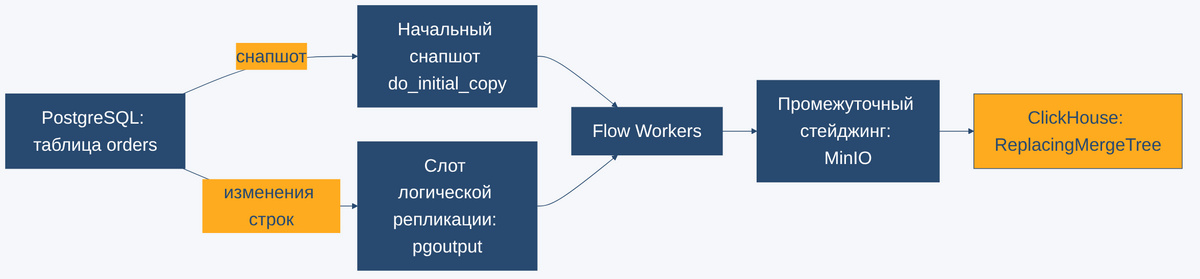
Синтаксис mirror’а важно не перепутать с QRep. Команда CREATE MIRROR … FOR $$SELECT …$$ запускает batch-репликацию по произвольному запросу, а не потоковый CDC. Для CDC конкретной таблицы нужен именно синтаксис WITH TABLE MAPPING, как в примере выше.
От независимого проекта к движку ClickPipes
Летом 2024 года PeerDB был самостоятельным стартапом с open-source репозиторием и управляемым облаком. В июле 2024 года компания ClickHouse приобрела PeerDB, и в течение примерно четырёх месяцев его технология была полностью интегрирована в ClickHouse Cloud как движок, лежащий в основе коннектора Postgres CDC.
Дальше коннектор прошёл обычный путь продукта внутри ClickHouse Cloud. Приватное превью открылось в январе 2025 года, публичная бета в марте 2025 года, а статус GA (общедоступен) коннектор получил в мае 2025 года. С этого момента реплицировать данные из Postgres в ClickHouse Cloud через PeerDB можно, не поднимая собственный стек вообще, платформа делает это за пользователя.
Практический разбор архитектуры и запуска PeerDB для этого сценария на русском языке есть в материале CDC ETL из PostgreSQL в ClickHouse с PeerDB в блоге Школы.
Термин «PeerDB» после поглощения стал двузначным. Сайт docs.peerdb.io продолжает описывать проект как самостоятельный инструмент с несколькими источниками и назначениями, а документация ClickHouse говорит о PeerDB преимущественно как о технологии внутри ClickPipes. Открытый репозиторий при этом не заброшен формально, но новых релизов после v0.37.5 от 26 августа 2024 года на момент подготовки статьи не выходило, что подтверждает тег stable-v0.37.5 в актуальных официальных образах self-hosted стека.
Дубли и качество данных при CDC в ClickHouse
Целевая таблица в ClickHouse строится на движке ReplacingMergeTree, который не умеет обновлять или удалять строку на месте. Вместо этого каждое изменение источника, будь то UPDATE или DELETE, PeerDB записывает как новую версию строки, а удаление помечает служебным полем _peerdb_is_deleted. Старая версия строки при этом остаётся в таблице до фонового слияния кусков данных.
Из-за этого наивный запрос без учёта версий видит и старую, и новую версию изменённой строки, а мягко удалённую строку продолжает считать живой, пока фоновый merge не отработал. Итог таков, что count() без дополнительных условий регулярно завышает число активных записей, причём непредсказуемо, потому что момент слияния кусков не фиксирован по расписанию.
Правильных способов посчитать текущее состояние два. Модификатор FINAL схлопывает версии строк прямо на чтении и вместе с фильтром по _peerdb_is_deleted даёт верный результат, но дороже по ресурсам на больших таблицах. Функция argMax по полю _peerdb_version даёт тот же корректный результат без FINAL и по механике ClickHouse обходится дешевле, потому что не требует полного слияния версий на каждый запрос; на самом стенде время выполнения обоих вариантов отдельно не замерялось. Подробный разбор этой проблемы и вариантов её решения есть в статье Дедупликация при CDC из PostgreSQL в ClickHouse в блоге Школы.
Сценарии использования и границы применимости
PeerDB подходит там, где нужен постоянный поток изменений из Postgres в аналитическое хранилище, а не разовый перенос данных. Типичный случай это перевод отчётности и BI на ClickHouse без остановки продуктовой базы, а также перенос больших исторических датасетов из десятков гигабайт до нескольких терабайт, где заявлено ускорение в 2-16 раз по сравнению с другими инструментами. Self-hosted вариант бесплатен и подходит, когда команда готова эксплуатировать Nexus, Flow и Temporal сама, а PeerDB Cloud снимает эту нагрузку за отдельную плату.
В ходе подготовки статьи не удалось найти единый раздел документации с лимитами по типам данных, максимальному размеру батча или числу одновременных mirror’ов, поэтому такие ограничения приходится выяснять экспериментально на своём стенде, а не брать из одной таблицы. Явного официального списка «для чего PeerDB не подходит» тоже не встретилось. Разумной осторожностью будет не рассчитывать на PeerDB там, где нужна не потоковая репликация, а сложная трансформация данных на лету, для этого он не проектировался, инструмент переносит и преобразует минимально, основная логика ETL остаётся на стороне назначения.
Практике самого ClickHouse как целевой системы для такого пайплайна посвящён курс ClickHouse для инженеров данных, а CDC как элемент интеграционной архитектуры предприятия разбирается на курсе по архитектуре данных ниже.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика
По традиции весь код, используемый в статье, выкладываем на наш GitHub репозиторий
Стенд собран из self-hosted PeerDB v0.37.5 (Nexus, Flow API и Worker, Temporal, catalog-Postgres, MinIO) и отдельного ClickHouse 26.3 в той же docker-сети. Источник это таблица orders из 20 строк, файл source_schema.sql в репозитории. После настройки mirror’а по коду из предыдущего раздела запускается демонстрационный скрипт, который меняет данные в источнике и показывает механику дублей на живом стенде.
#!/usr/bin/env bash
# bash + psql (клиент PostgreSQL 16) + curl, PeerDB v0.37.5, ClickHouse 26.3, прогнано на стенде 2026-09-03.
# Требует запущенных source_schema.sql и peerdb_mirror.sql (см. RUNBOOK.md).
#
# Показывает механизм: PeerDB льёт CDC в ClickHouse через ReplacingMergeTree, где UPDATE и DELETE
# не перезаписывают строку на месте, а добавляют новую версию (DELETE — с флагом _peerdb_is_deleted).
# Пока фоновый merge не прошёл, наивный SELECT видит дубли и удалённые строки как живые.
set -euo pipefail

SRC="postgresql://postgres:postgres@localhost:9901/source"
CH_TABLE='peerdb_target.`peerdb_target.orders_cdc`'
ch() { curl -s -u peerdb:peerdb_demo_pass 'http://localhost:8124/' --data-binary "$1"; }

echo "=== 1. Ждём начальный снапшот (20 строк) ==="
t0=$(date +%s.%N)
for _ in $(seq 1 60); do
    n=$(ch "SELECT count() FROM $CH_TABLE" || echo 0)
    [ "$n" = "20" ] && break
    sleep 0.5
done
t1=$(date +%s.%N)
echo "снапшот виден в ClickHouse через $(echo "$t1 - $t0" | bc)s, строк: $n"

echo
echo "=== 2. Меняем данные в источнике: 2 UPDATE, 1 DELETE, 1 INSERT ==="
t2=$(date +%s.%N)
psql "$SRC" -q -c "
UPDATE orders SET status='shipped', updated_at=now() WHERE id=1;
UPDATE orders SET amount=999.99, updated_at=now() WHERE id=2;
DELETE FROM orders WHERE id=3;
INSERT INTO orders (customer, amount, status) VALUES ('customer_21', 42.42, 'new');
"

echo
echo "=== 3. Ждём, пока CDC-батч долетит до ClickHouse (raw count меняется с 20) ==="
for _ in $(seq 1 60); do
    n=$(ch "SELECT count() FROM $CH_TABLE" || echo 20)
    [ "$n" != "20" ] && break
    sleep 0.5
done
t3=$(date +%s.%N)
echo "изменения видны в ClickHouse через $(echo "$t3 - $t2" | bc)s от коммита в источнике, raw-строк: $n"

echo
echo "=== 4. Наивный SELECT без FINAL: видны обе версии изменённых строк и \"живая\" удалённая ==="
ch "SELECT id, customer, amount, status, _peerdb_is_deleted, _peerdb_version FROM $CH_TABLE WHERE id IN (1,2,3) ORDER BY id, _peerdb_version FORMAT PrettyCompact"

echo
echo "=== 5. Три способа посчитать текущее число активных заказов ==="
echo "-- naive count(), до фонового merge завышает результат:"
ch "SELECT count() FROM $CH_TABLE"
echo
echo "-- FINAL + фильтр по _peerdb_is_deleted, схлопывает версии на чтении:"
ch "SELECT count() FROM $CH_TABLE FINAL WHERE _peerdb_is_deleted = 0"
echo
echo "-- argMax по _peerdb_version, не требует FINAL и дешевле на больших таблицах:"
ch "SELECT count() FROM (
        SELECT id, argMax(_peerdb_is_deleted, _peerdb_version) AS is_deleted
        FROM $CH_TABLE
        GROUP BY id
    ) WHERE is_deleted = 0"
echo

echo "=== КОНЕЦ ==="
Реальный вывод прогона на стенде выглядит следующим образом.
=== 1. Ждём начальный снапшот (20 строк) ===
снапшот виден в ClickHouse через 1.562065554s, строк: 20

=== 2. Меняем данные в источнике: 2 UPDATE, 1 DELETE, 1 INSERT ===

=== 3. Ждём, пока CDC-батч долетит до ClickHouse (raw count меняется с 20) ===
изменения видны в ClickHouse через 11.355414431s от коммита в источнике, raw-строк: 24

=== 4. Наивный SELECT без FINAL: видны обе версии изменённых строк и "живая" удалённая ===
   ┌─id─┬─customer───┬─amount─┬─status──┬─_peerdb_is_deleted─┬─────_peerdb_version─┐
1. │  1 │ customer_1 │    1.5 │ new     │                  0 │                   0 │
2. │  1 │ customer_1 │    1.5 │ shipped │                  0 │ 1788460692688571371 │
3. │  2 │ customer_2 │      3 │ new     │                  0 │                   0 │
4. │  2 │ customer_2 │ 999.99 │ new     │                  0 │ 1788460692688579845 │
5. │  3 │ customer_3 │    4.5 │ new     │                  0 │                   0 │
6. │  3 │            │      0 │         │                  1 │ 1788460692688585190 │
   └────┴────────────┴────────┴─────────┴────────────────────┴─────────────────────┘

=== 5. Три способа посчитать текущее число активных заказов ===
-- naive count(), до фонового merge завышает результат:
24

-- FINAL + фильтр по _peerdb_is_deleted, схлопывает версии на чтении:
20

-- argMax по _peerdb_version, не требует FINAL и дешевле на больших таблицах:
20

=== КОНЕЦ ===
Начальный снапшот 20 строк из Postgres долетел до ClickHouse чуть больше чем за полторы секунды. Батч из четырёх изменений, а именно два UPDATE, один DELETE и один INSERT, оказался в ClickHouse примерно через 11 секунд от коммита в источнике, это цикл синхронизации CDC-батча PeerDB на этом стенде, а не задержка сети; документированного значения интервала по умолчанию найти не удалось. Итог по шагу 5 наглядно показывает саму проблему раздела выше, наивный count() насчитал 24 записи вместо реальных 20 активных заказов, а оба корректных способа, FINAL и argMax, независимо сошлись в одном числе.
Заключение
PeerDB закрывает задачу потоковой репликации данных из Postgres через понятный SQL-интерфейс Nexus, надёжную оркестрацию workflow на Temporal и горизонтально масштабируемые Flow Workers. После покупки компанией ClickHouse тот же движок стал частью управляемого коннектора ClickPipes, поэтому сегодня инструмент существует одновременно в двух ролях, как самостоятельный self-hosted проект и как встроенная технология ClickHouse Cloud. Для тех, кто реплицирует данные в ClickHouse своими силами, главный практический урок в том, что ReplacingMergeTree требует FINAL или argMax вместо наивных агрегатов, иначе цифры на дашборде разойдутся с реальным состоянием источника.
Референсные ссылки
- PeerDB Architecture, официальное описание Nexus, Flow, Temporal и Catalog
- PeerDB Releases на GitHub, версия, дата релиза и лицензия открытого репозитория
- ClickHouse acquires PeerDB, официальное объявление о поглощении, июль 2024 года
- Postgres CDC connector в ClickPipes достиг GA, статус коннектора на базе PeerDB, май 2025 года
- CDC ETL из PostgreSQL в ClickHouse с PeerDB, практический разбор архитектуры на русском языке