 5
Содержание
- Что такое OLAP и какую задачу он закрывает
- Архитектура OLAP от OLTP-источника до аналитической витрины
- Куб, измерения и меры
- Star и snowflake схемы, семантический слой
- Принцип работы OLAP, операции над кубом и schema-on-write
- Slice, dice, drill-down, roll-up, pivot
- Почему куб не обновляется точечно
- ROLAP, MOLAP и HOLAP, три способа хранить куб
- От кубов к колоночным СУБД, как изменился OLAP
- Когда применять OLAP, а когда OLTP или HTAP
- Практика, звёздная схема и CUBE/ROLLUP на PostgreSQL и DuckDB
- Заключение
- Референсные ссылки
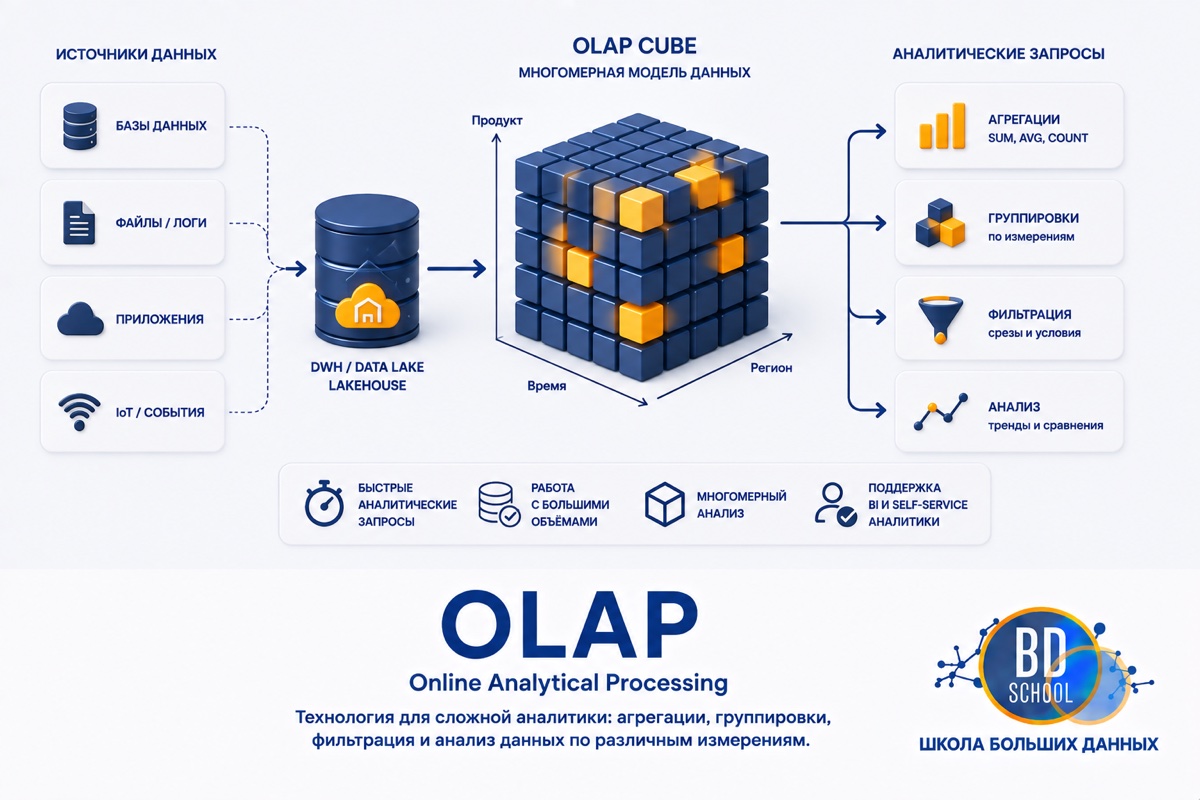
OLAP (Online Analytical Processing, оперативная аналитическая обработка) это парадигма организации и запроса данных, заточенная под быстрые агрегатные вопросы поверх больших объёмов бизнес-данных, а не под запись отдельных транзакций. Пока OLTP-система (Online Transaction Processing) фиксирует каждую продажу отдельной короткой транзакцией, OLAP отвечает на вопрос вроде «какая выручка по категории и региону за прошлый квартал» одним запросом, который агрегирует миллионы строк за секунды. Важно сразу развести понятия. OLAP это не продукт и не конкретная СУБД, а класс задач и связанных с ним архитектурных решений, от классических многомерных кубов Microsoft Analysis Services до современных колоночных движков вроде ClickHouse, Druid и StarRocks.
Что такое OLAP и какую задачу он закрывает
Данные, которые видит OLAP, почти всегда копия, а не источник. OLTP-система остаётся системой записи, оптимизированной под короткие транзакции с блокировками и строгой нормализацией, а аналитический слой читает те же события, но уже переложенные в форму, удобную для агрегации. Документация Microsoft описывает типичную нагрузку такой модели как read-heavy, без транзакций и блокировок, а типичный масштаб растягивается от сотен гигабайт до нескольких петабайт.
Эталонной реализацией долгое время считался SQL Server Analysis Services (SSAS), актуальный релиз которого документирован для линейки продуктов 2016-2025 годов. OLAP как класс задач шире одного продукта, дальше в статье речь пойдёт о принципе, а не о конкретном движке.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Архитектура OLAP от OLTP-источника до аналитической витрины
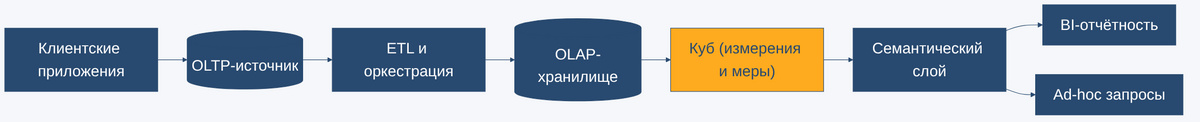
По схеме, которую приводит документация Microsoft, классический конвейер OLAP выглядит одинаково независимо от вендора. Клиентские приложения пишут в OLTP-источник, слой оркестрации (SQL Server Integration Services, Azure Data Factory) переносит данные дальше, они оседают в OLAP-системе, а поверх неё уже работает отчётность и BI (Business Intelligence). OLAP-хранилище почти всегда содержит копию данных, а не читает транзакционную базу напрямую, и это архитектурное решение, а не временное ограничение.
Куб, измерения и меры
Ядро классического OLAP это куб (cube), многомерная структура, которую составляют измерения (dimensions) и меры (measures). Измерение это ось, по которой смотрят на данные, например время, товар или регион. Мера это число, которое агрегируют, например выручка. Куб на практике не хранится буквально как N-мерный массив, это логическая модель, а физически данные лежат либо в реляционных таблицах, либо в специализированном многомерном формате, способ хранения разбирается отдельно в разделе про ROLAP, MOLAP и HOLAP ниже.
Star и snowflake схемы, семантический слой
Под кубом почти всегда лежит звёздная схема (star schema), одна факт-таблица с мерами в центре и несколько таблиц измерений вокруг, каждая связана с фактом внешним ключом напрямую. Снежинка (snowflake schema) это тот же принцип, но измерения дополнительно нормализованы в собственные подтаблицы, что экономит место, но добавляет лишние join’ы. Документация Microsoft описывает поверх такой схемы ещё один слой, семантическую модель, которая переименовывает технические колонки в понятные бизнесу термины и задаёт готовые агрегации, чтобы аналитик строил отчёт без знания SQL и без ручных join’ов.
Принцип работы OLAP, операции над кубом и schema-on-write
OLAP работает по модели schema-on-write, то есть структура куба задана заранее, и данные при загрузке уже приводятся под неё, в отличие от подходов, где схема применяется только при чтении. Пользователь взаимодействует с готовым кубом через набор стандартных операций, а не пишет SQL-джойны каждый раз заново.
Slice, dice, drill-down, roll-up, pivot
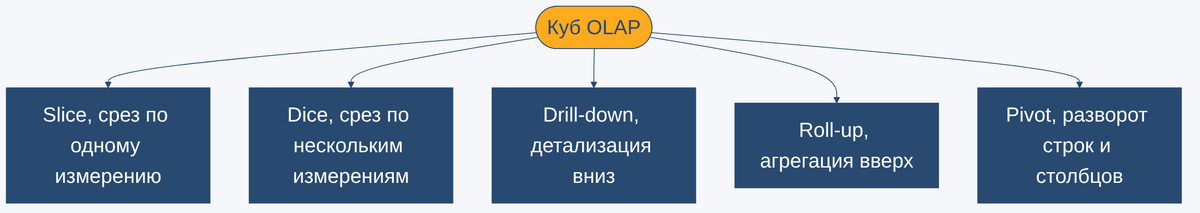
Slice это срез куба по одному значению измерения, например «показать все продажи только за 2025 год». Dice сужает куб сразу по нескольким измерениям, вырезая меньший подкуб, скажем «категория Electronics, четвёртый квартал, регион North». Roll-up агрегирует данные вверх по иерархии измерения, от дня к месяцу и дальше к году, а drill-down это обратная операция, спуск к более детальному уровню. Pivot разворачивает куб, меняя местами строки и столбцы, как в сводной таблице, чтобы посмотреть те же данные под другим углом. В практическом разделе ниже slice, dice, roll-up и pivot показаны отдельными SQL-запросами к звёздной схеме, а drill-down виден в тех же строках, что и roll-up, просто с обратным прочтением, от общего итога к разрезу по кварталу.
Почему куб не обновляется точечно
У классического куба нет операции точечного UPDATE в привычном смысле. Любое изменение данных в источнике требует пересчёта куба целиком или его затронутой части, а не правки одной ячейки, поэтому OLAP не годится для сценария, где нужна мгновенная реакция на каждое отдельное изменение. Именно это ограничение подтолкнуло индустрию искать способы удешевить куб, вплоть до отказа от самого материализованного куба, о чём дальше в разделе про колоночные СУБД.
ROLAP, MOLAP и HOLAP, три способа хранить куб
Куб логический, а хранить его данные можно тремя способами, и выбор определяет компромисс между скоростью запроса, объёмом хранения и свежестью данных. Названия ROLAP, MOLAP и HOLAP стандартны для отрасли и встречаются в документации SSAS по многомерным моделям.
| Режим | Где хранятся данные | Сильная сторона | Слабая сторона |
|---|---|---|---|
| ROLAP (Relational OLAP) | реляционные таблицы, куб считается join’ом на каждый запрос | не требует отдельного хранения, данные всегда свежие | запрос медленнее, потому что агрегация считается на лету |
| MOLAP (Multidimensional OLAP) | предрасчитанный многомерный массив агрегатов | самый быстрый ответ, все агрегаты уже посчитаны заранее | требует пересчёта при изменении данных и занимает больше места |
| HOLAP (Hybrid OLAP) | детальные данные в реляционном хранилище, агрегаты в многомерном | компромисс между скоростью и объёмом хранения | сложнее настроить и поддерживать, чем чистый ROLAP или MOLAP |
Выбор режима это настройка конкретного OLAP-движка, а не решение навсегда. Демо этой статьи использует ROLAP в чистом виде, потому что PostgreSQL агрегирует звёздную схему прямым join’ом без предрасчитанных кубов.
Построение DWH на ClickHouse
Код курса
CLICH
Ближайшая дата курса
12 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
От кубов к колоночным СУБД, как изменился OLAP
Классический куб на MOLAP хорошо работал, пока объёмы данных помещались в память одного сервера. Рост объёмов и вычислительных мощностей подтолкнул индустрию к массово-параллельным архитектурам (MPP, massively parallel processing), где запрос параллелится по множеству узлов, а данные хранятся не кубом, а колоночно. Документация Microsoft прямо фиксирует этот сдвиг, сравнивая классическую архитектуру на Analysis Services с современной архитектурой на Microsoft Fabric, объединённой аналитической платформе Microsoft поверх облачного хранилища OneLake, и явно отмечает, что только вторая поддерживает аналитику, близкую к реальному времени.
Колоночные аналитические СУБД, такие как ClickHouse, Apache Druid и StarRocks, решают ту же задачу OLAP другим путём. Вместо материализованного куба с предрасчитанными агрегатами они хранят факт-таблицу колоночно и агрегируют на лету, но делают это на порядок быстрее строкового хранения, потому что читают с диска только нужные колонки и хорошо сжимают однородные данные. По сути это ROLAP, доведённый до предела эффективности запроса. Спроектировать такое HTAP-хранилище (Hybrid Transactional/Analytical Processing, гибридная транзакционно-аналитическая обработка) на практике учит курс «Проектирование Online-хранилищ данных на StarRocks».
Разделение OLAP и OLTP при этом никуда не делось. Появление HTAP породило ожидание, что аналитика и транзакции сольются в один движок. По наблюдениям отраслевых обзоров последних лет (не официальной документации вендоров, поэтому воспринимать это стоит как контекст, а не как задокументированный факт), на практике чаще побеждает композиционная архитектура, где OLTP и OLAP остаются раздельными системами, а между ними идёт пайплайн CDC (Change Data Capture, отслеживание изменений в источнике) с задержкой в секунды вместо часов. Подробный разбор конфликта нагрузок и того, что реально решает гибридная обработка, в статье Что такое HTAP: гибридная транзакционно-аналитическая обработка.
Когда применять OLAP, а когда OLTP или HTAP
OLAP подходит, когда нужно быстро выполнять сложную аналитику и произвольные ad hoc запросы, не задевая транзакционную систему, и когда бизнес-пользователям нужен предсказуемый набор агрегатов без знания SQL. Он же плохо подходит там, где нужна реакция на каждое отдельное изменение, потому что данные обновляются с задержкой, которую определяет расписание ETL (Extract, Transform, Load), а не события в реальном времени.
OLTP остаётся системой записи и мелких точечных операций, поэтому сравнивать OLAP с OLTP по скорости бессмысленно, у них разные профили нагрузки. HTAP пытается закрыть разрыв между ними в одной системе, но, как разобрано выше, чаще на практике реализуется как две системы, связанные быстрым CDC-пайплайном. Выбор между OLAP-хранилищем и HTAP-системой определяется тем, насколько критична задержка между записью и появлением данных в отчёте. Секунды оправдывают HTAP, часы вполне устраивает классический OLAP-конвейер.
Практика, звёздная схема и CUBE/ROLLUP на PostgreSQL и DuckDB
Демо ниже собрано на PostgreSQL 18.4 и DuckDB 1.5.5, без новых установок. Звёздная схема состоит из факт-таблицы продаж на 1 000 000 строк и трёх измерений (дата, товар, магазин), сгенерированных прямо в PostgreSQL через generate_series и random() с фиксированным seed.
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Скрипт db_setup.py пересоздаёт звёздную схему целиком.
-- PostgreSQL 18.4 (Homebrew), прогнано на стенде 2026-08-31
CREATE TABLE dim_date (
    date_id     serial PRIMARY KEY,
    full_date   date NOT NULL,
    year        int NOT NULL,
    quarter     int NOT NULL,
    month       int NOT NULL,
    month_name  text NOT NULL,
    day_of_week text NOT NULL
);

CREATE TABLE dim_product (
    product_id   serial PRIMARY KEY,
    product_name text NOT NULL,
    category     text NOT NULL,
    subcategory  text NOT NULL
);

CREATE TABLE dim_store (
    store_id   serial PRIMARY KEY,
    store_name text NOT NULL,
    region     text NOT NULL,
    country    text NOT NULL
);

CREATE TABLE fact_sales (
    sale_id    bigserial PRIMARY KEY,
    date_id    int NOT NULL REFERENCES dim_date(date_id),
    product_id int NOT NULL REFERENCES dim_product(product_id),
    store_id   int NOT NULL REFERENCES dim_store(store_id),
    quantity   int NOT NULL,
    revenue    numeric(10, 2) NOT NULL
);
Сами строки факт-таблицы генерирует не Python построчно, а один SQL-запрос прямо в PostgreSQL, с фиксированным seed для воспроизводимости.
-- PostgreSQL 18.4 (Homebrew), прогнано на стенде 2026-08-31
SELECT setseed(0.42);

INSERT INTO fact_sales (date_id, product_id, store_id, quantity, revenue)
SELECT
    1 + (random() * 729)::int,
    1 + (random() * 59)::int,
    1 + (random() * 24)::int,
    1 + (random() * 9)::int,
    round((10 + random() * 490)::numeric, 2)
FROM generate_series(1, 1000000);
# вывод db_setup.py, PostgreSQL 18.4 (Homebrew), прогон на стенде 2026-08-31
fact_sales: 1 000 000 строк за 10.93 с
dim_date=731, dim_product=60, dim_store=25, fact_sales=1000000
Операции над кубом идут прямым SQL к звёздной схеме, скрипт cube_operations.py собирает slice, dice, roll-up, CUBE и pivot подряд. Roll-up ниже строит иерархию год к кварталу к общему итогу, а функция GROUPING() отличает строку итога от обычной группы, где значение измерения реально равно NULL.
-- PostgreSQL 18.4 (Homebrew), прогнано на стенде 2026-08-31
SELECT
    d.year,
    d.quarter,
    sum(f.revenue) AS revenue,
    grouping(d.year, d.quarter) AS grouping_level
FROM fact_sales f
JOIN dim_date d ON d.date_id = f.date_id
JOIN dim_product p ON p.product_id = f.product_id
JOIN dim_store s ON s.store_id = f.store_id
GROUP BY ROLLUP (d.year, d.quarter)
ORDER BY d.year NULLS LAST, d.quarter NULLS LAST;
# вывод cube_operations.py, фрагмент ROLL-UP, прогон на стенде 2026-08-31
year | quarter | revenue | grouping_level
2024 | 1 | 31867905.29 | 0
2024 | 2 | 31783300.20 | 0
2024 | None | 127923299.32 | 1
2025 | 4 | 31643572.75 | 0
2025 | None | 126997602.85 | 1
None | None | 254920902.17 | 3
CUBE считает уже не одну иерархию, а все сочетания сразу. Запрос ниже строит куб по категории и региону, включая частичные итоги по каждому измерению отдельно и общий итог, одним обращением к базе вместо отдельного запроса на каждый разрез.
-- PostgreSQL 18.4 (Homebrew), прогнано на стенде 2026-08-31
SELECT
    p.category,
    s.region,
    sum(f.revenue) AS revenue,
    grouping(p.category, s.region) AS grouping_level
FROM fact_sales f
JOIN dim_date d ON d.date_id = f.date_id
JOIN dim_product p ON p.product_id = f.product_id
JOIN dim_store s ON s.store_id = f.store_id
GROUP BY CUBE (p.category, s.region)
ORDER BY grouping_level, p.category NULLS LAST, s.region NULLS LAST;
# вывод cube_operations.py, фрагмент CUBE, прогон на стенде 2026-08-31
category | region | revenue | grouping_level
Books | Central | 8090778.53 | 0
Books | None | 43216397.58 | 1
None | Central | 47699310.75 | 2
None | None | 254920902.17 | 3
Последний скрипт, columnar_compare.py, берёт ту же звёздную схему и сравнивает одну и ту же агрегацию на строковом движке PostgreSQL и на колоночном движке DuckDB. Первая версия скрипта в процессе отладки дала контринтуитивный результат, DuckDB оказался медленнее Postgres, и это тоже честная часть демо. Причина в том, что снимок данных лёг в DuckDB как представление поверх pandas DataFrame, а не как физическая таблица, и движок пересканировал Python-объект на каждый запрос вместо чтения из собственного колоночного формата. В финальную версию в репозитории этот вариант не вошёл, но разница между двумя строками ниже стоит показать целиком.
# psycopg 3.3.4, duckdb 1.5.5, прогон на стенде 2026-08-31 (черновой вариант, в репозиторий не попал)
duck.register("snapshot", snapshot_df)
# psycopg 3.3.4, duckdb 1.5.5, columnar_compare.py, прогнано на стенде 2026-08-31 (финальная версия)
duck.execute("CREATE TABLE snapshot AS SELECT * FROM snapshot_df")
# вывод columnar_compare.py, PostgreSQL 18.4 и DuckDB 1.5.5, прогон на стенде 2026-08-31
строк в снимке: 1000000
агрегация в PostgreSQL (join звёздной схемы, тёплый кэш): 0.140 с
агрегация в DuckDB (колоночная, тёплый кэш): 0.007 с
ускорение: 21.3x
Часть ускорения даёт колоночное хранение, часть даёт то, что DuckDB агрегирует уже денормализованный снимок в памяти без join’а на каждый запрос, а PostgreSQL считает join звёздной схемы заново. Оба фактора и есть то направление, в котором колоночные СУБД обходят классический куб.
Заключение
OLAP решает одну конкретную задачу, быструю агрегацию по большим объёмам данных без риска для транзакционной системы. Классический механизм строится на кубе, измерениях и мерах поверх звёздной или снежинка схемы, а способ хранения куба (ROLAP, MOLAP или HOLAP) определяет компромисс между скоростью, объёмом и свежестью данных. Индустрия постепенно смещается от предрасчитанных кубов к колоночным движкам вроде ClickHouse, Druid и StarRocks, которые дают тот же результат агрегацией на лету, но на порядок быстрее строкового хранения. Разделение OLAP и OLTP при этом остаётся архитектурной нормой, а не проблемой, которую нужно устранить любой ценой.