
 24
Содержание
- Какую задачу закрывает открытый табличный формат
- Архитектура и ключевые компоненты
- Как открытый табличный формат фиксирует изменения под капотом
- Сравнение Apache Iceberg, Delta Lake и Apache Hudi
- Ограничения и архитектурные компромиссы
- Когда использовать открытый табличный формат и когда он избыточен
- Практика создания таблицы в открытом табличном формате
- Заключение
- Референсные ссылки
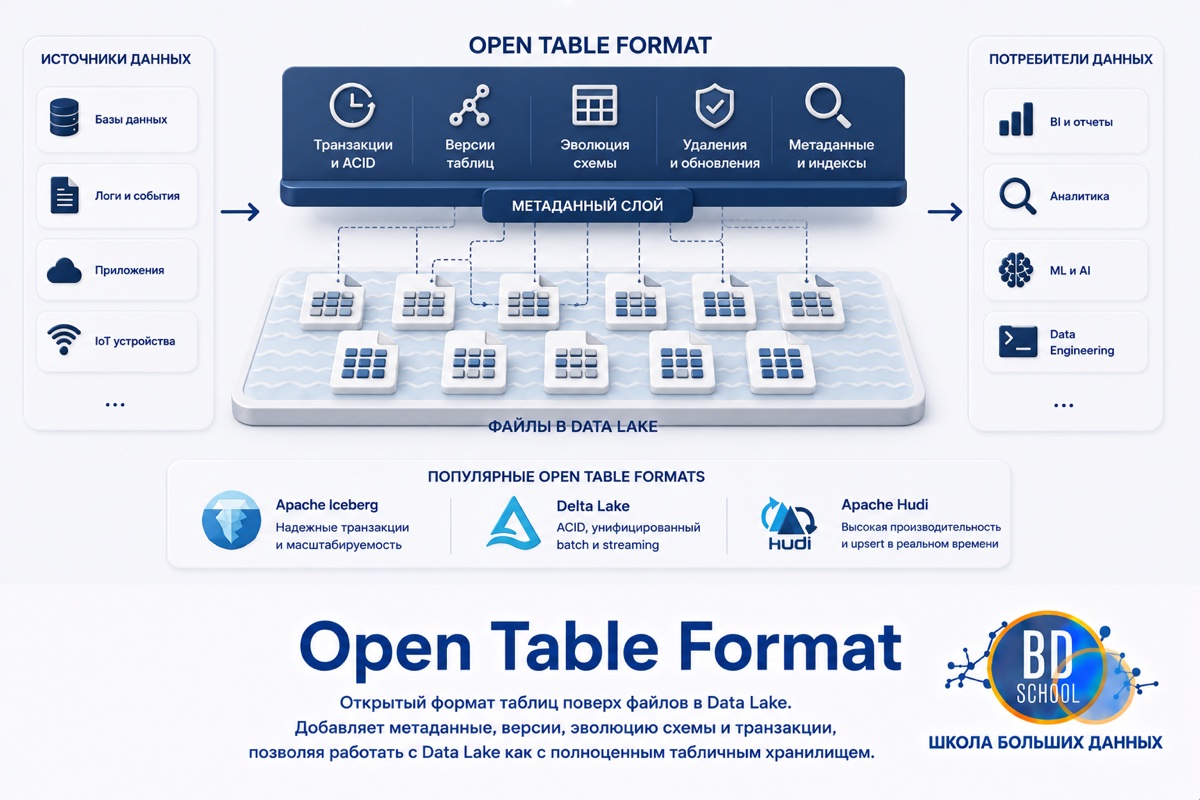
Open Table Format (Открытый табличный формат) представляет собой открыто управляемую спецификацию, которая добавляет ACID-транзакции, эволюцию схемы (schema evolution) и time travel поверх обычных файлов Parquet или ORC в облачном хранилище. Термин описывает архитектурный слой, а не единственный продукт. К категории относятся Apache Iceberg, Delta Lake, Apache Hudi и более новый Apache Paimon, и каждый из них решает одну и ту же задачу своим набором метаданных.
Какую задачу закрывает открытый табличный формат
До появления открытых табличных форматов виртуализацию файлов в озере данных под видом таблиц закрывал Hive Metastore. Он справлялся с каталогизацией схем и расположением партиций, но исторически не давал ACID-гарантий при параллельной записи, поэтому конкурентная запись и частые построчные изменения требовали ручной дисциплины на уровне пайплайна. Открытый табличный формат решает именно это, добавляя журнал коммитов и снапшоты (snapshots) поверх тех же файлов, без миграции данных в проприетарное хранилище.
Понятие складывалось постепенно, и каждая реализация добавляла свой акцент.
- 2016, Apache Hudi. Первая продакшен-реализация в Uber, сфокусированная на upsert-нагрузках и потоковой загрузке.
- 2018, Apache Iceberg. Спецификация, независимая от вычислительного движка, разработана в Netflix.
- 2019, Delta Lake. Транзакционный журнал в формате JSON, продвигаемый Databricks.
- 2024, Apache Paimon. LSM-подход (log-structured merge-tree), оптимизированный под потоковую запись вместе с Apache Flink.
К 2026 году форматы заметно сблизились по возможностям. Согласно блогу проекта Apache Hudi, «the formats have converged substantially on core capabilities», а именно на ACID-коммитах, эволюции схемы, time travel и отсечении файлов по статистике.
Архитектура и ключевые компоненты
Несмотря на разную реализацию, у трёх основных форматов один набор архитектурных слоёв.
- Журнал метаданных (metadata log). Упорядоченная запись каждого коммита, а именно добавленных и удалённых файлов, изменений схемы.
- Снапшоты. Версии таблицы целиком, на которых строятся time travel и откат к предыдущему состоянию.
- Статистика по файлам (file statistics). Минимумы, максимумы и счётчики null для каждого файла, чтобы движок пропускал заведомо ненужные файлы при чтении.
- Отслеживание схемы (schema tracking). Возможность добавлять и переименовывать колонки без переписывания уже записанных файлов данных.
- Изоляция снапшотов (snapshot isolation). Читатели видят согласованную версию таблицы, даже пока идёт параллельная запись.
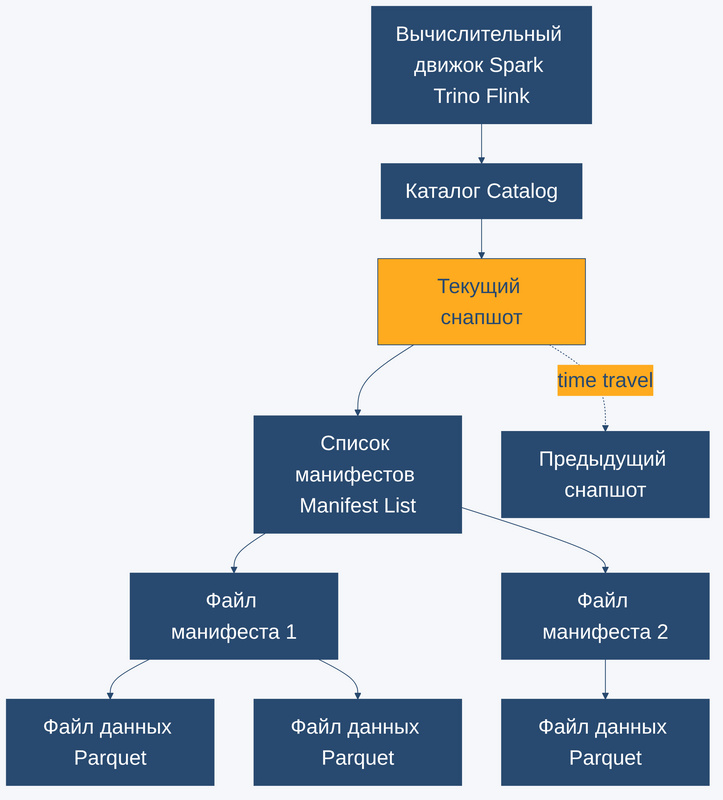
Отдельным архитектурным слоем выступает каталог (catalog), который по спецификации Apache Iceberg отвечает за расположение таблицы. Сам коммит новой версии таблицы описан в спецификации как атомарная замена (atomic swap) файла метаданных, а не как правка существующего файла. Более детальный протокол участия каталога именно в этой замене документация не раскрывает, поэтому статья на нём не настаивает.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Как открытый табличный формат фиксирует изменения под капотом
Каждый коммит создаёт новый согласованный снимок таблицы, а не переписывает существующие данные. Дальше реализации расходятся в том, как именно устроена цепочка метаданных.
- Apache Hudi. Ведёт timeline действий вместе с отдельной metadata table.
- Apache Iceberg. Строит цепочку снапшотов (chain of snapshots), где каждый снапшот (snapshot) фиксирует состояние таблицы целиком и ссылается на свой список манифестов (manifest list), а тот перечисляет файлы манифестов (manifest), каждый из которых описывает подмножество файлов данных этого снапшота. Формулировки терминов взяты из официальной спецификации Apache Iceberg.
- Delta Lake. Ведёт транзакционный лог в JSON и периодически сохраняет его состояние в Parquet-чекпоинты, чтобы не читать весь лог с начала.
Сам коммит атомарен на уровне хранилища, поэтому два одновременных писателя не могут повредить состояние таблицы. Проигравший коммит просто переигрывается поверх нового снапшота.
Эволюция схемы устроена так же аккуратно. Apache Iceberg присваивает каждой колонке отдельный числовой ID независимо от её имени и позиции. Когда в таблицу добавляют новую колонку, ей выдаётся новый ID, и уже записанные ранее файлы Parquet просто не содержат данных с этим ID, поэтому старые данные никогда случайно не попадают под новую колонку. Переименование колонки меняет только имя в метаданных, физические файлы данных остаются нетронутыми.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Сравнение Apache Iceberg, Delta Lake и Apache Hudi
Три формата решают одну задачу, но исходили из разных нагрузок, и это до сих пор видно в их сильных сторонах.
| Формат | Драйвер разработки | Движки | Транзакционность | Streaming vs batch |
|---|---|---|---|---|
| Apache Iceberg | Netflix, 2018 | мультидвижковый, Spark, Trino и Flink работают с одной таблицей | цепочка снапшотов (chain of snapshots) | сильнее в batch и мультидвижковом BI, поддерживает оба режима |
| Delta Lake | Databricks, 2019 | преимущественно Spark, полный набор возможностей на Databricks | транзакционный лог в JSON с Parquet-чекпоинтами | batch и Spark Structured Streaming |
| Apache Hudi | Uber, 2016 | Spark и Flink с акцентом на запись | timeline вместе с отдельной metadata table | сфокусирован на потоковый ingestion и upsert |
По данным блога Databricks (источник вендорский, а не нейтральный), Apache Iceberg закрепился как формат, который поддерживают все крупные облачные провайдеры, а Delta Lake отвечает на это слоем совместимости UniForm, публикующим метаданные Delta одновременно в формате Iceberg. В эту же сторону идёт кросс-форматный проект Apache XTable. К этим формулировкам стоит относиться как к позиции конкурирующих вендоров, а не как к нейтральному факту спецификации.
Ограничения и архитектурные компромиссы
У каждого формата есть цена за его сильную сторону, и об этом прямо пишет сам проект Apache Hudi в сравнении с конкурентами.
- Apache Hudi. Требует собственного встроенного storage engine для upsert-логики, что усложняет интеграцию с движками, у которых уже есть своя логика записи.
- Apache Iceberg. Сознательно не берёт на себя обслуживание таблицы, а именно compaction и очистку старых снапшотов. Эту работу должен запускать вычислительный движок или отдельный сервис.
- Delta Lake. Раскрывает весь набор возможностей прежде всего на платформе Databricks, вне неё часть функциональности менее зрелая.
- Apache Paimon. Использует LSM-подход, который откладывает слияние данных на момент чтения, поэтому без регулярного compaction чтение постепенно замедляется.
Общий вывод источника прямой, а именно что скорость записи и скорость чтения остаются разными задачами с разными компромиссами, и ни один формат не решает обе одновременно без настройки под конкретную нагрузку.
Числовых пределов вроде максимального размера таблицы или предельного числа снапшотов в открытых источниках, доступных в рамках этой разведки, найти не удалось. Снапшоты и манифесты сами по себе такие же файлы в объектном хранилище, поэтому на практике предел определяется не форматом, а тем, сколько метаданных готов сканировать конкретный вычислительный движок при планировании запроса. По этой же логике на растущих таблицах рано или поздно нужна регулярная чистка старых снапшотов, иначе список манифестов растёт вместе с историей изменений.
Когда использовать открытый табличный формат и когда он избыточен
Выбор конкретной реализации диктует нагрузка, а не мода.
- Apache Hudi. Подходит для высокообъёмного мутируемого ingestion с частыми upsert-операциями и потоковых источников.
- Apache Iceberg. Подходит, когда одну и ту же таблицу читают разные движки, например Trino для BI-запросов и Spark для batch-обработки.
- Delta Lake. Подходит для команд, уже построивших пайплайны на Apache Spark, особенно в экосистеме Databricks.
- Apache Paimon. Подходит для потоковой записи совместно с Apache Flink.
Формат избыточен там, где нет параллельной записи и нет нескольких вычислительных движков сразу. Классическая таблица в реляционной базе или простой Parquet-каталог с одним писателем не выигрывают от журнала метаданных и каталога, а только платят за них лишним слоем инфраструктуры. Если нужно системно сравнивать такие архитектурные паттерны хранения данных, а не выбирать интуитивно, этому посвящён курс Практическая архитектура данных.
Практика создания таблицы в открытом табличном формате
Ниже пример на Apache Iceberg через Spark SQL, официальный синтаксис из документации Apache Iceberg по DDL-командам Spark. Статья написана в концептуальном режиме, поэтому код показывает синтаксис из первоисточника, а не результат отдельного прогона на стенде.
-- Apache Iceberg 1.11.0, синтаксис Spark SQL DDL, iceberg.apache.org/docs/latest/spark-ddl/
CREATE TABLE prod.db.sample (
    id bigint,
    data string,
    category string,
    ts timestamp)
USING iceberg
PARTITIONED BY (bucket(16, id), days(ts), category);
Выражения bucket(16, id) и days(ts) это скрытое партиционирование Iceberg. Каталог сам вычисляет значение партиции из исходных колонок и хранит это в метаданных, поэтому запрос с фильтром по id или ts не обязан знать формулу партиционирования, в отличие от Hive-style партиций, где колонку партиции нужно указывать явно.
Отдельный вариант решения той же задачи предлагает более новый формат LakeSoul, ему посвящена статья про LakeSoul как альтернативу Iceberg, Hudi и Delta Lake, где разбирается хранение потоковых и пакетных таблиц в одном формате.
Заключение
Открытый табличный формат не заменяет ни одну существующую систему хранения, а добавляет поверх файлов Parquet или ORC журнал метаданных и транзакционный протокол, которых раньше не хватало озеру данных. Apache Iceberg, Delta Lake, Apache Hudi и Apache Paimon решают эту задачу по-своему, и выбор между ними определяется тем, сколько вычислительных движков читает таблицу одновременно и насколько часто в неё пишут построчные изменения.