
GroeneAI - автономный агент на базе ИИ, который с марта 2026 года внёс в ClickHouse более трёх тысяч merged pull requests. Он сам выбирает задачи из результатов CI и fuzzing-отчётов, воспроизводит сбои, пишет исправления, запускает тесты и ведёт pull request до слияния. Такой под
Debezium 3.7 получил коннектор-источник для Milvus. Он превращает векторную базу в обычный поставщик событий изменений, которые можно отправлять в Kafka и дальше в любые sink-коннекторы. Это решает задачу синхронизации вставок и удалений без двойной записи из приложения и без пак
Инженер с двадцатилетним опытом перешёл от Excel и тяжёлых кластеров к DuckDB с DuckLake. DuckDB представляет собой встраиваемую аналитическую базу данных, которая выполняет запросы прямо над файлами без отдельного сервера. Новый инструмент решает задачу быстрого анализа файлов и
Компания перешла с Oracle на StarRocks, Airflow и dbt, чтобы 25 аналитиков могли сами собирать витрины через Git, а три инженера данных обслуживали всю платформу. Запросы, которые раньше работали десятки минут, теперь укладываются в 14 секунд в 99 процентах случаев. Главное измен
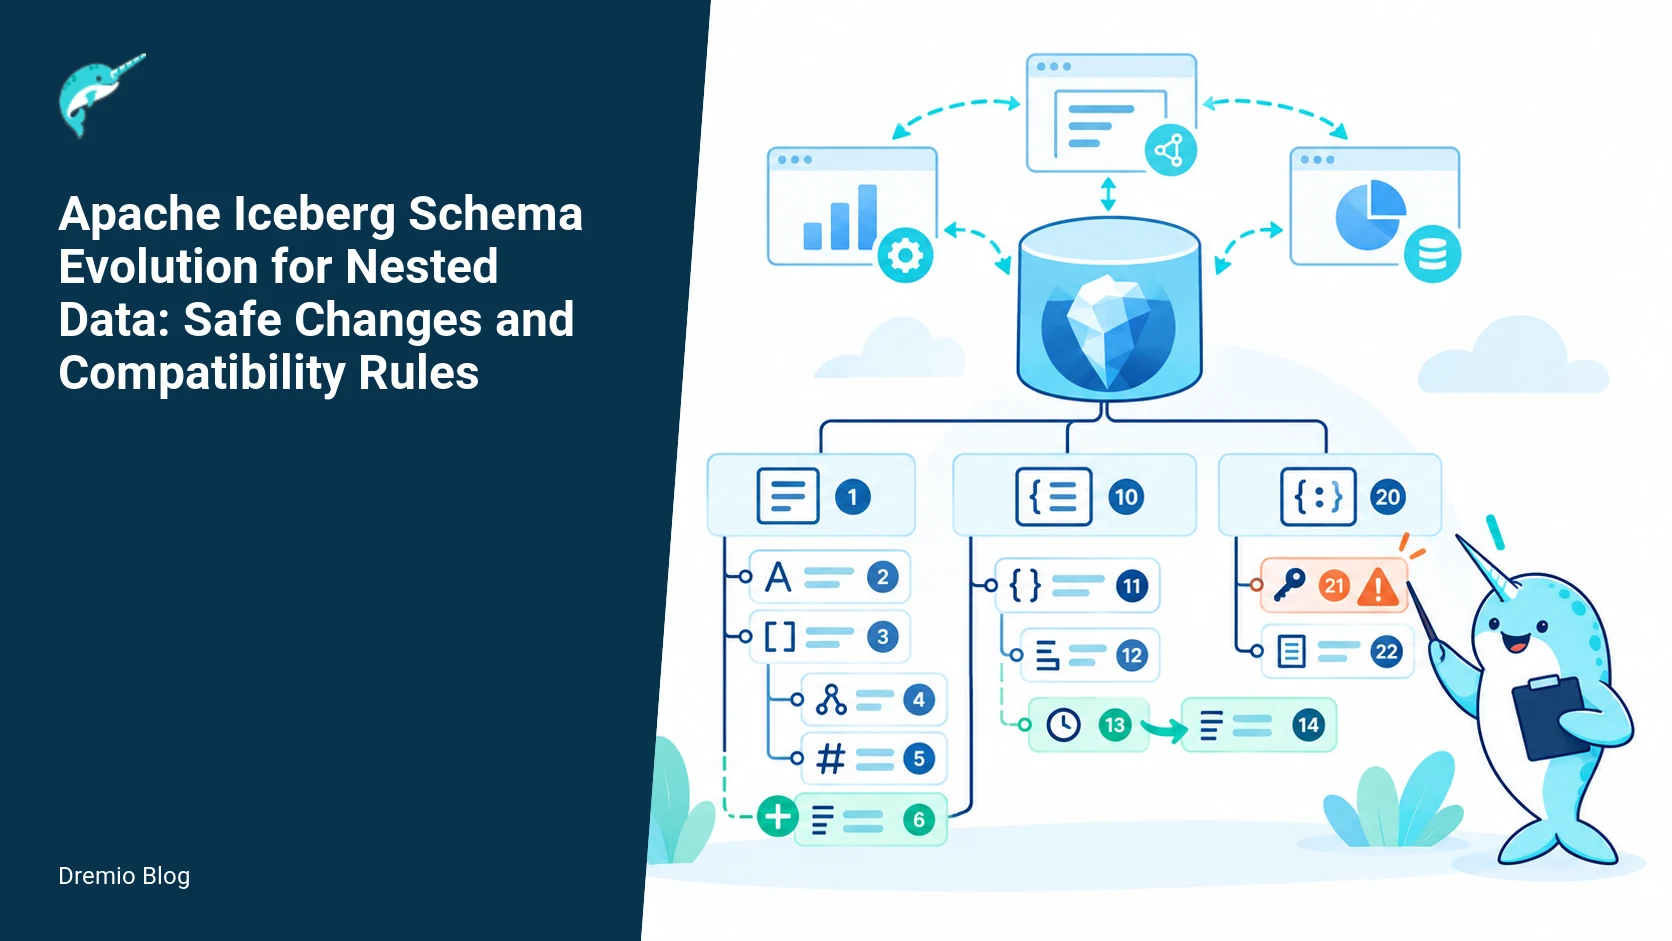
Dremio опубликовала разбор правил эволюции схем для вложенных структур Apache Iceberg. Материал показывает, как менять вложенные struct, list и map так, чтобы таблицы оставались читаемыми в Spark, Trino и других движках. Главный акцент сделан на field ID, правилах nullability и t
Релиз Flink CDC 3.7.0 вводит pluggable API для AI-моделей и OpenAI-совместимый клиент прямо в YAML-пайплайны. Это позволяет выполнять генерацию текста, эмбеддинги и анализ изображений без отдельного сервиса. Инженерам стоит оценить обновление, если текущие потоки требуют обогащен
Ozon построил собственный механизм перемещения бакетов между зонами S3-хранилища объёмом 130 ПБ. Система переносит данные, не прерывая чтение и запись, и не требует действий от пользователей. Решение появилось из-за неравномерной загрузки зон и ограничений Ceph-кластеров. Для ком
Debezium Management Platform раньше показывала метрики пайплайнов только на дашборде. Теперь она сама отслеживает пороги и уведомляет о нарушениях. Это снимает необходимость постоянно смотреть в интерфейс и позволяет реагировать на проблемы быстрее. Пайплайны здесь - это настроен
Платформы управления AI-агентами обещают контроль, но часто оставляют компании внутри своего контура. Главная задача - получить переносимый слой политик и доказательств, который работает с любыми фреймворками, облаками и моделями. Без этого governance превращается в инструмент уд
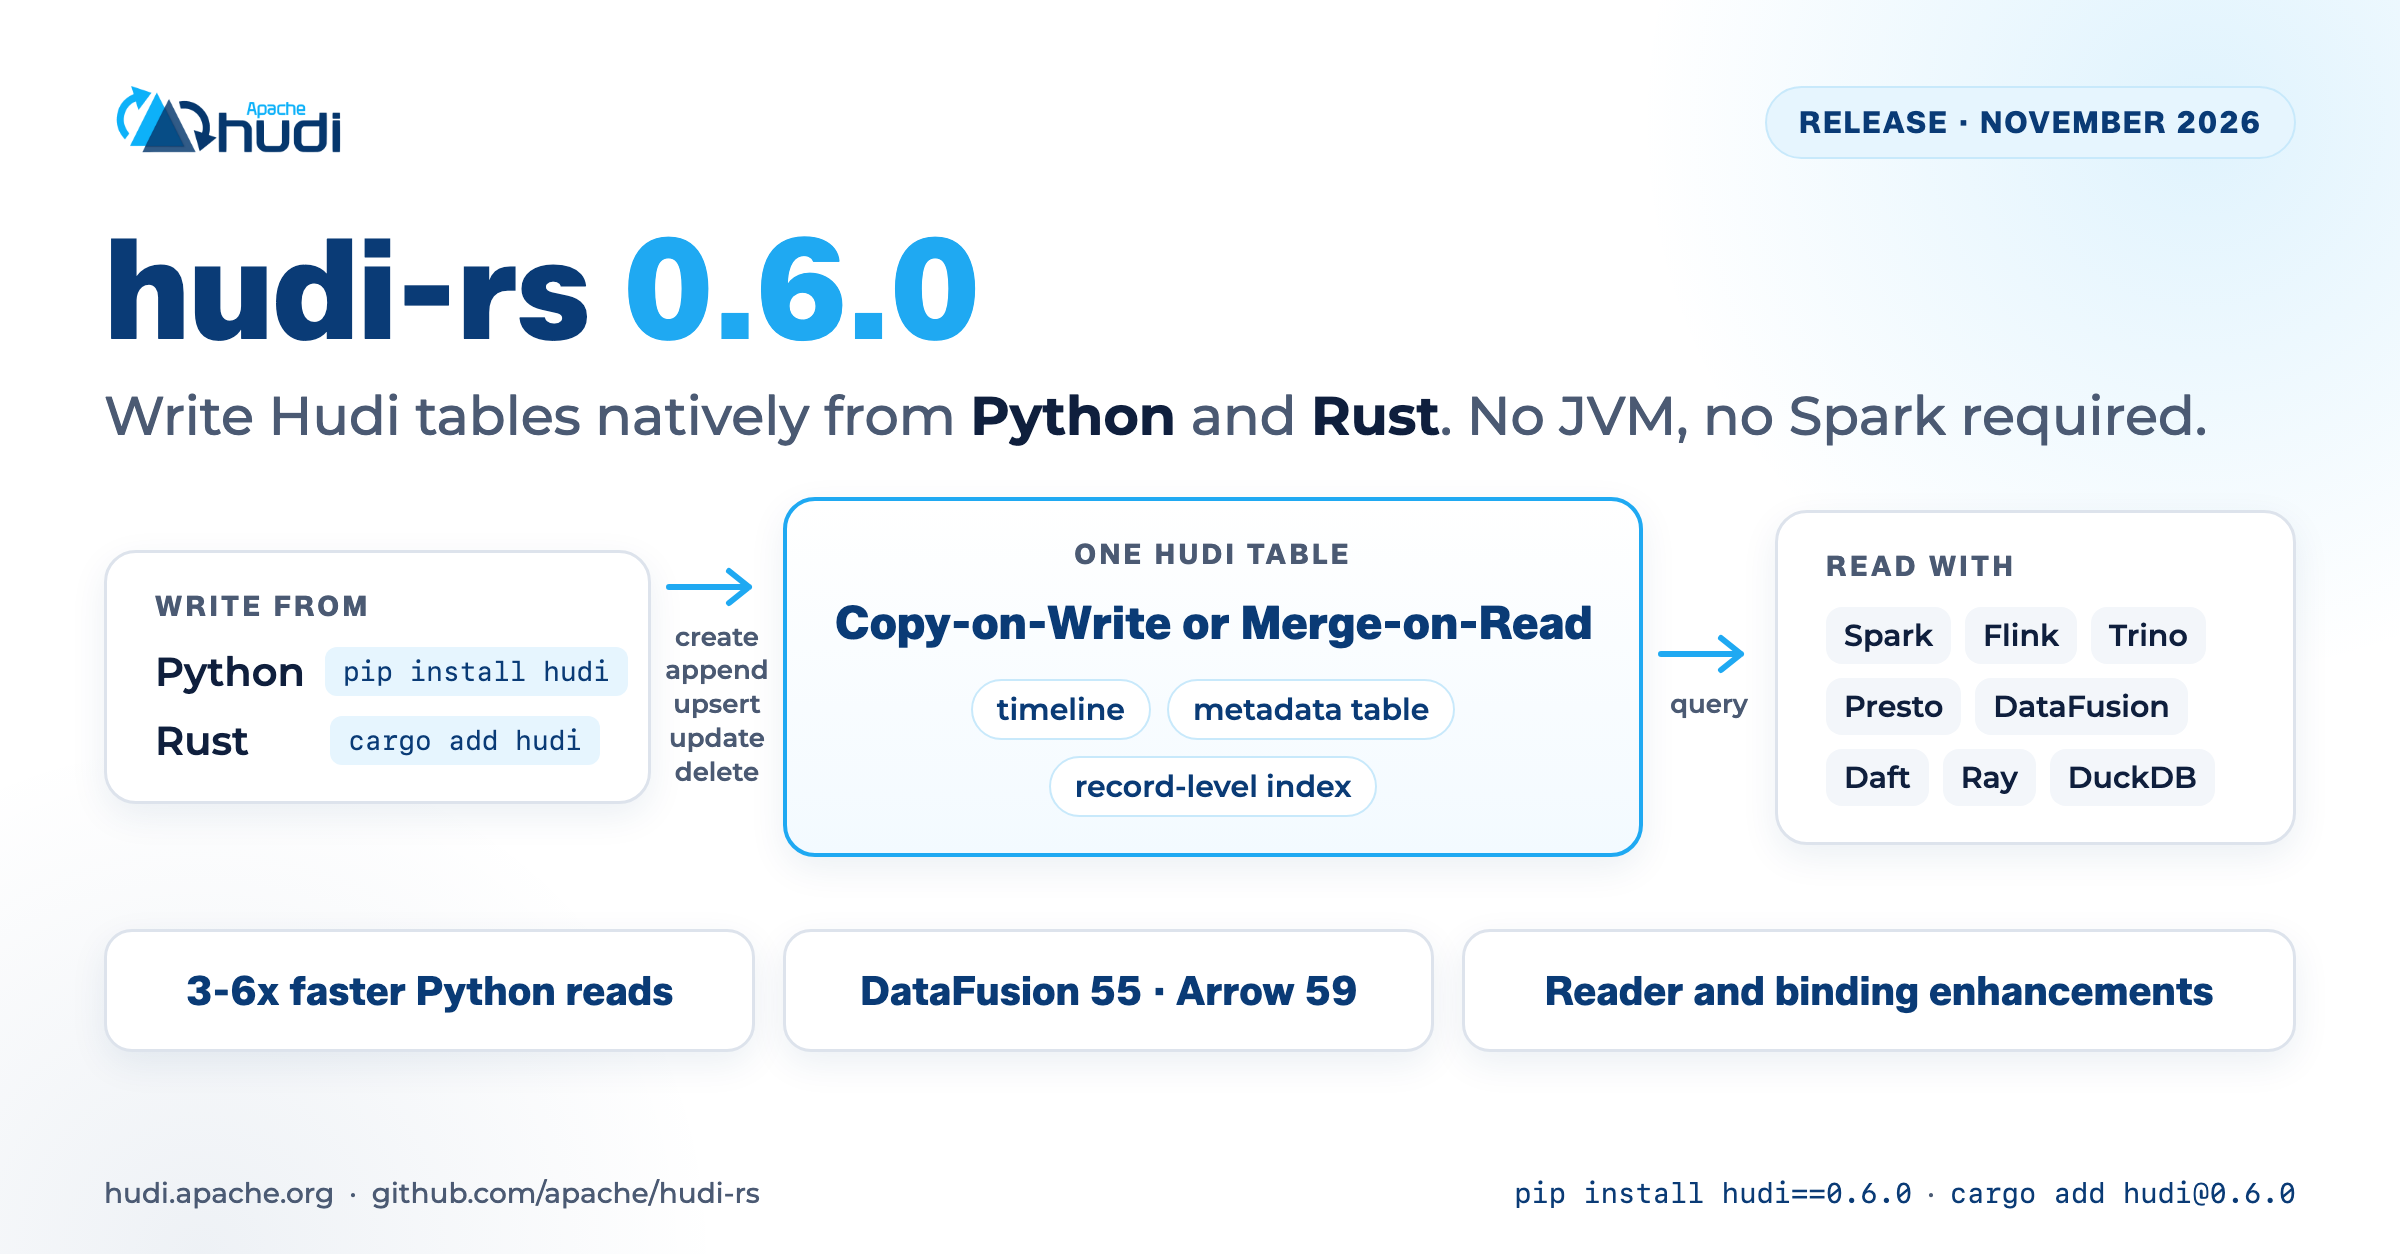
Релиз hudi-rs 0.6.0 приносит нативную поддержку записи в таблицы Hudi прямо из Rust и Python без JVM. Инженеры теперь могут создавать, дополнять, обновлять и удалять строки из обычных скриптов и сервисов, а результат остается полноценной таблицей Hudi, которую читают Spark, Flink
DuckDB встроили в инструменты для квантов, чтобы небольшие команды могли вести быстрый локальный анализ без серверов и лицензий kdb+. Инженер Ryan Hamilton, ранее строивший платформы для банков и хедж-фондов, применил движок в QStudio и Pulse, а теперь развивает на его основе Pea
Josh Wills, создатель dbt-duckdb и бывший глава data engineering в Slack, объясняет, почему модели сами по себе мало значат, а агенты всё ещё генерируют дорогие и неопрятные пайплайны. Главный тезис интервью - data engineering остаётся задачей инвалидации кэша даже при триллионах
Эксперимент показал, как превратить MPP-движок Greenplum в набор расширений поверх PostgreSQL 19. Цель - получить распределённую аналитику на актуальной версии ядра без многомесячных слияний форка. Это важно для команд, которым нужны последние возможности SQL, свежие расширения и
MinIO потерял статус стандартного решения для on-premise lakehouse. Комьюнити-редакция ушла в архив, а Iceberg-таблицы требуют точного набора операций с объектами. Командам нужно оценить альтернативы по реальным паттернам чтения и записи, а не по общей фразе «S3-совместимость».
Apache Arrow 26.0.0 вышел после трёх месяцев работы и принёс 337 исправлений. Главные изменения коснулись производительности разбора JSON, гибкости чтения Parquet и разделения библиотек в C++. Инженерам стоит оценить обновление, если они активно используют Parquet-файлы или строя
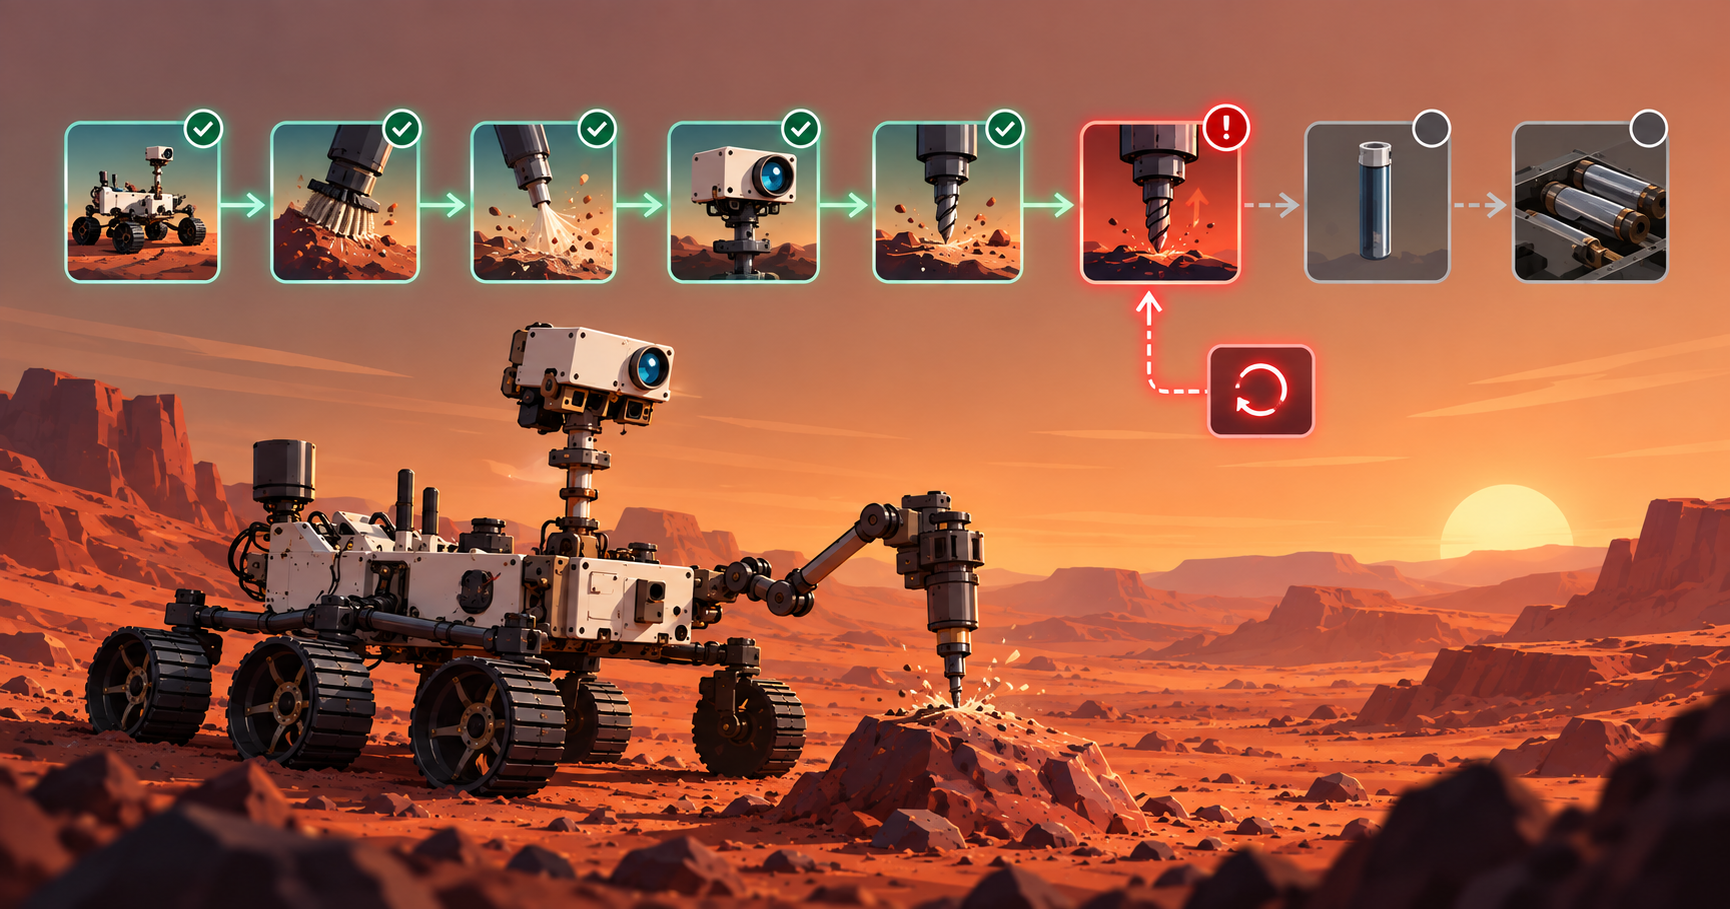
Airflow 3.3 переносит границу устойчивости внутрь задачи. Теперь при падении воркера retry не начинает работу заново, а подхватывает уже выполненную часть. Это касается как внешних систем вроде Spark и Databricks, так и агентских вызовов моделей. Инженеры избавляются от ручных ко
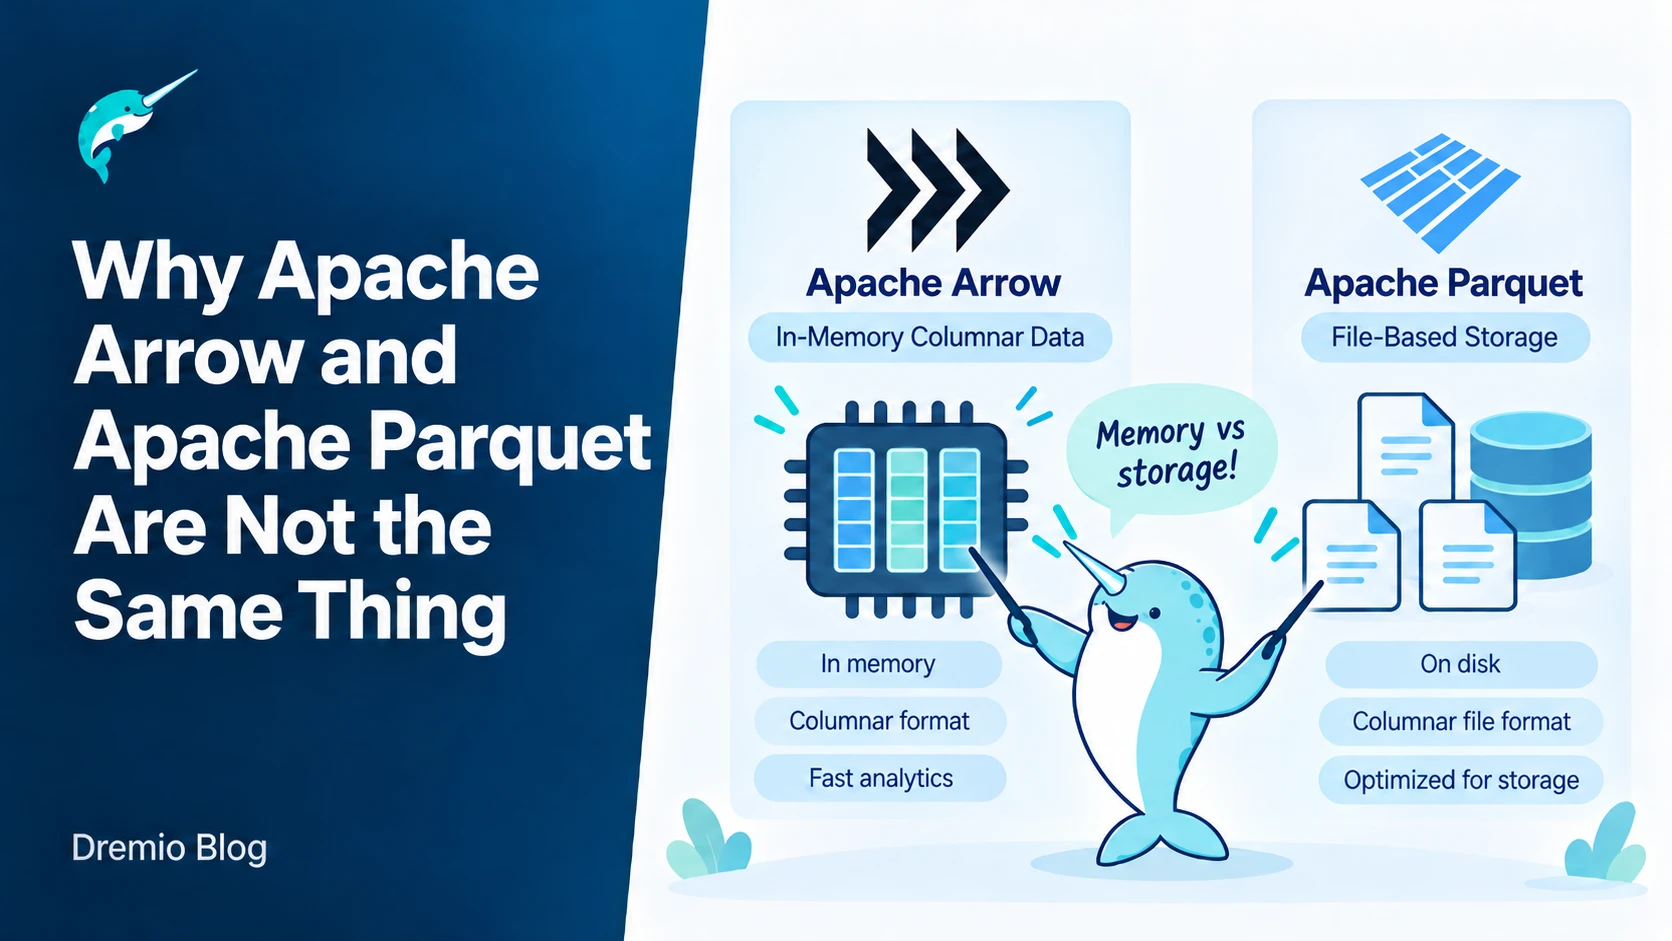
Dremio напомнила, что Parquet отвечает за хранение колонок на диске, а Arrow - за представление тех же колонок в оперативной памяти. Parquet - это колоночный формат для файлов, который сжимает данные и хранит статистику, чтобы сократить объём и ускорить выборку. Arrow - это колон
Delta Lake предлагает отказаться от Hive-стильного сегментирования в облачных хранилищах и перейти к кластеризации данных. Hive-стильное сегментирование подразумевает создание отдельных папок для значений ключевых колонок, например по дате или региону, что приводит к большому чис
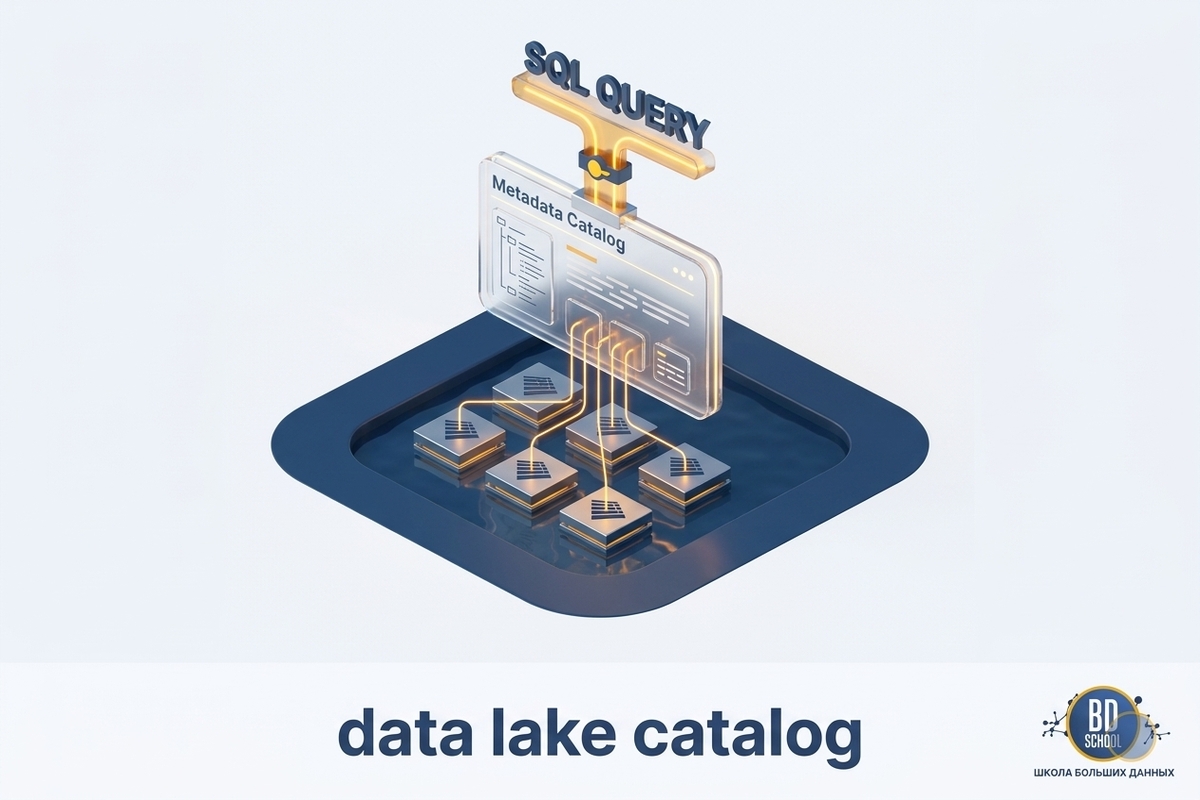
7 октября 2026 года команда DuckDB показала, как собрать каталог озера данных (data lake catalog) из файла DuckDB, в котором нет ни одной строки данных. В файле лежат только представления (view) над Parquet в объектном хранилище (object storage), а коллеги подключают его по ссылке и сразу пишут SQL. Приём...
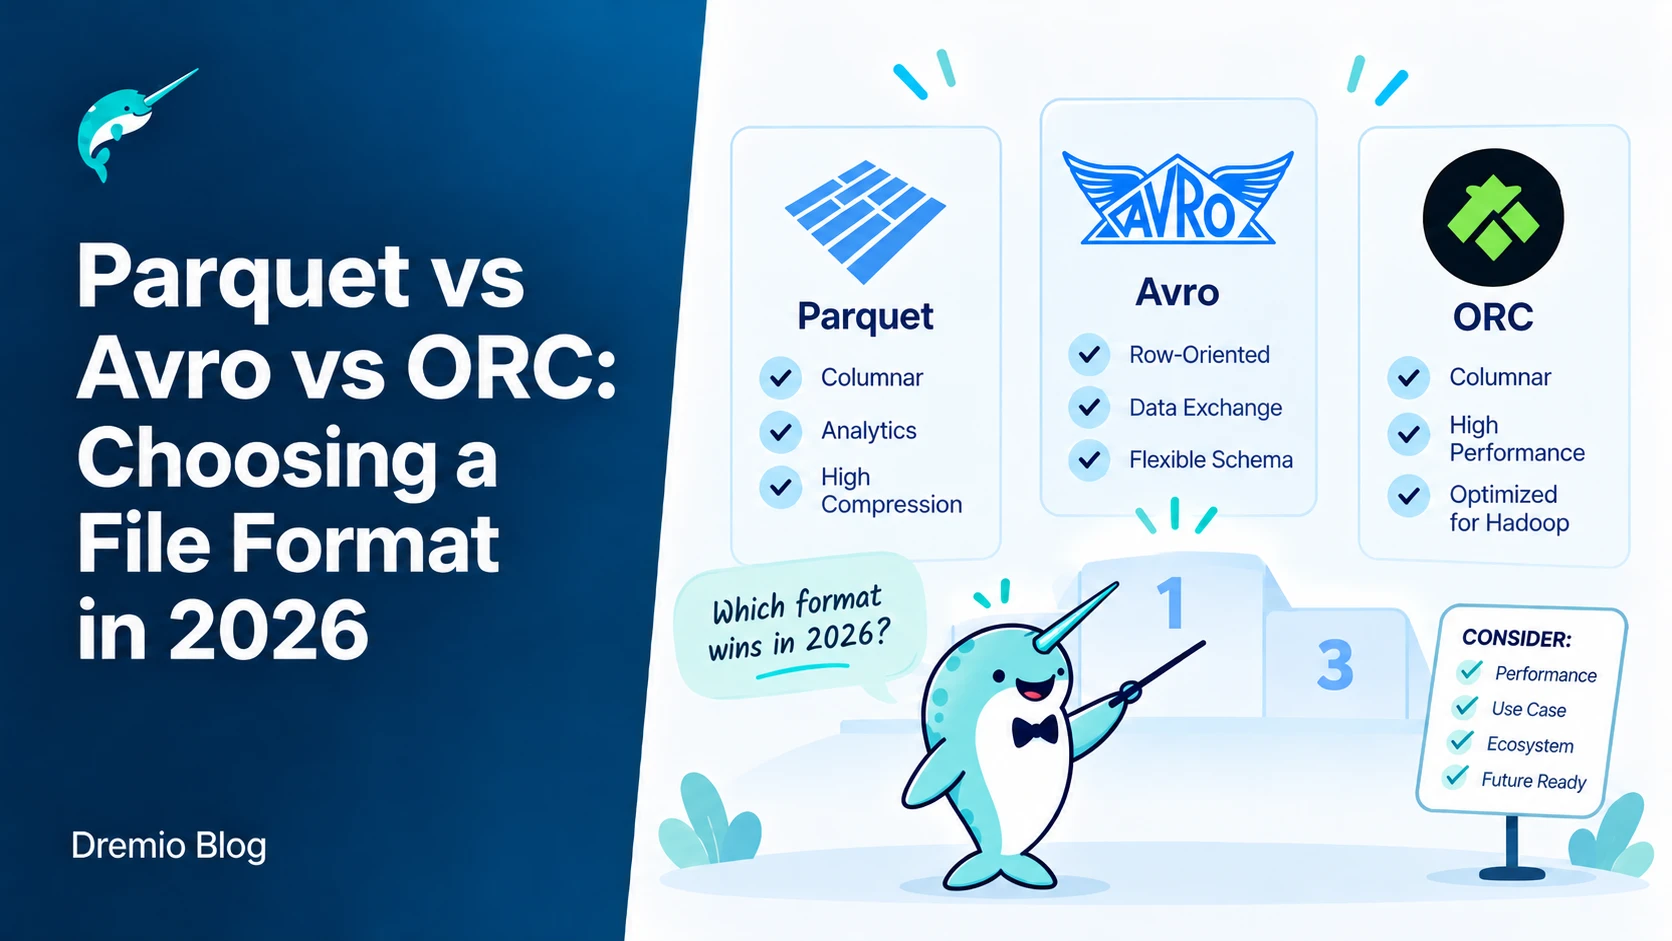
Сравнение Parquet, Avro и ORC помогает инженерам DWH подобрать формат под конкретные нагрузки чтения и записи. Parquet и ORC оптимизированы для аналитических запросов за счёт колоночной организации, Avro лучше справляется с частыми изменениями схемы при потоковой записи. Apache I