 2
Содержание
Josh Wills, создатель dbt-duckdb и бывший глава data engineering в Slack, объясняет, почему модели сами по себе мало значат, а агенты всё ещё генерируют дорогие и неопрятные пайплайны. Главный тезис интервью — data engineering остаётся задачей инвалидации кэша даже при триллионах токенов и распределённых кластерах. Разговор затрагивает абстракции дисков в Kubernetes, работу с метаданными Parquet и то, как агенты помогают, но не отменяют инженерный опыт. Инвалидация кэша здесь означает своевременное обновление или удаление устаревших данных, чтобы избежать ошибок в отчётах и перерасхода ресурсов. Для команды это ключевой фактор при выборе инструментов: если не учитывать эту задачу, даже современные кластеры могут привести к нестабильным результатам и росту затрат.
Абстракции дисков для Spark на Kubernetes
При обработке наборов в десятки терабайт и мультимодальных данных Josh перешёл с DuckDB на Spark и Ray. Основная проблема — Kubernetes не скрывает физическое расположение дисков, поэтому shuffle и локальное хранение приходится настраивать вручную. Shuffle — это процесс перераспределения данных между узлами для операций вроде соединений и группировок, и его неэффективная реализация напрямую влияет на скорость и стоимость обработки. Apache Celeborn решает это через push-based shuffle: mapper-узлы сразу пишут в shuffle-сервис, не завися от локальных дисков конкретного облака или bare-metal. Это позволяет разделить storage и compute без привязки к EBS или аналогам. EBS — это управляемое блочное хранилище в облаке, которое упрощает работу, но увеличивает расходы и создаёт зависимость от провайдера. В российских контурах, где часто используют собственные серверы без managed-дисков, такой подход снижает риск переполнения и упрощает миграцию между провайдерами. При принятии решения важно взвесить: выигрыш в гибкости и переносимости оправдывает ли необходимость отдельной поддержки сервиса. Ограничение — нужно поддерживать отдельный shuffle-сервис и следить за его отказоустойчивостью, иначе выигрыш исчезает. Без этого пайплайн может стать дороже и сложнее в эксплуатации, чем традиционные облачные решения.
DuckDB для метаданных вместо полноценных пайплайнов
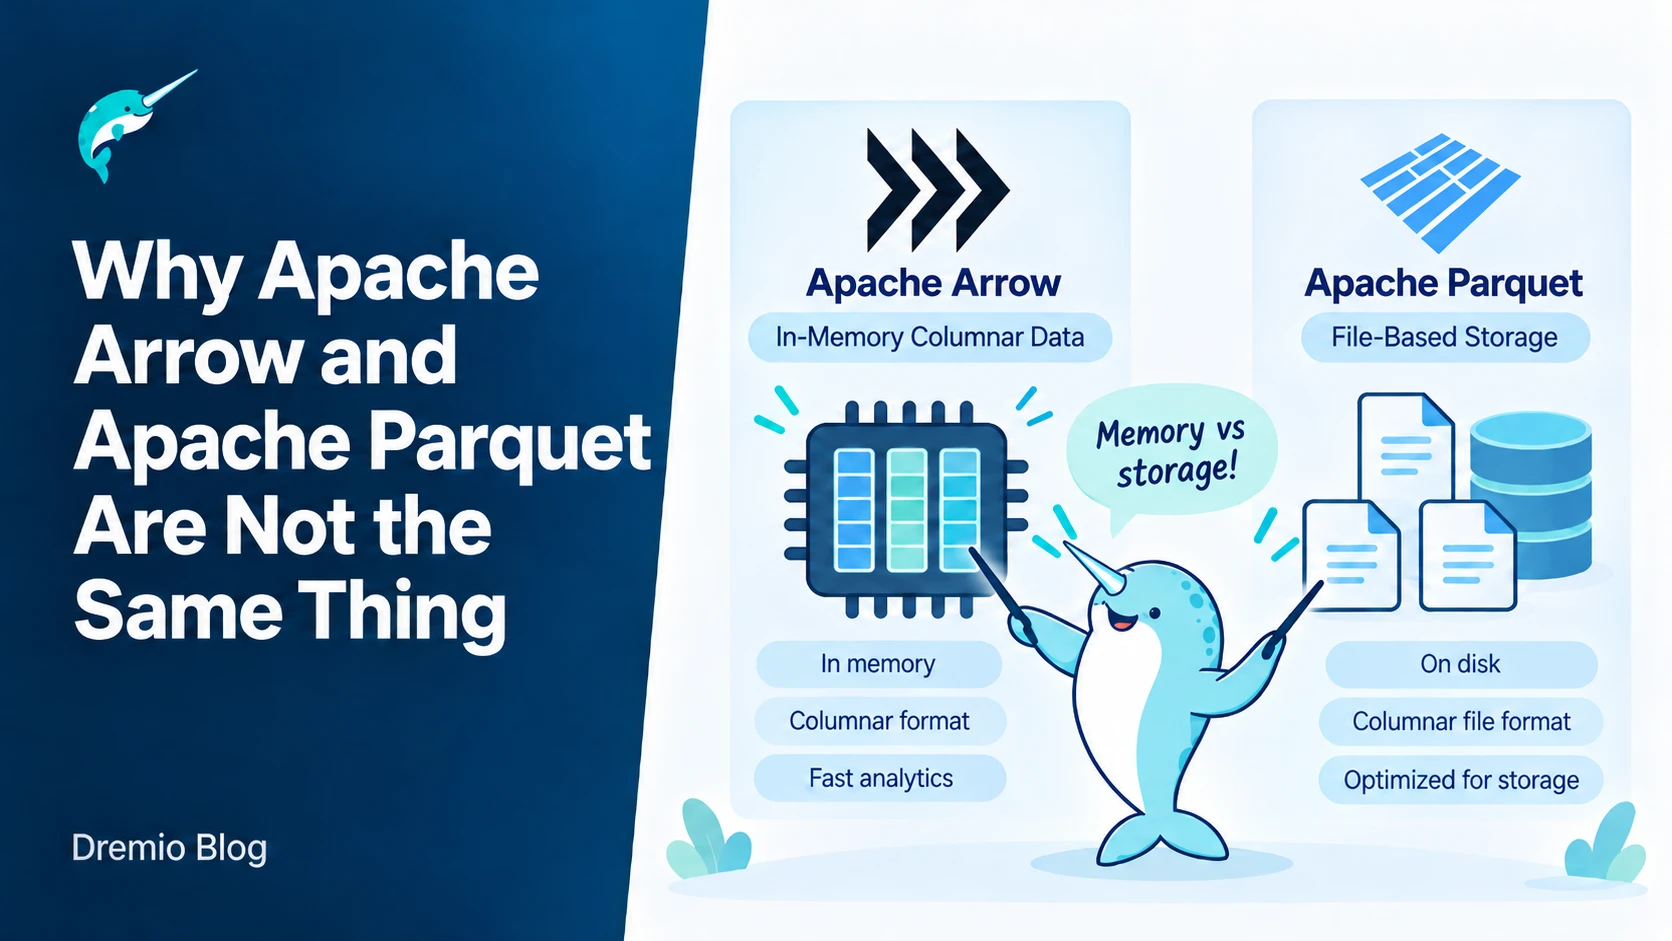
На текущей работе DuckDB применяют не для тяжёлых трансформаций, а для чтения метаданных Parquet, которые весят около 100 ГБ. Parquet — это колоночный формат хранения данных, оптимизированный для аналитических запросов и сжатия, поэтому он удобен для хранения сведений о запусках, датах последнего использования датасетов и стоимости хранения в S3. S3 здесь выступает как объектное хранилище, где файлы лежат долго и дёшево, но доступ к ним требует контроля. Агенты запускают запросы прямо на EC2-инстансах рядом с данными, чтобы избежать лишнего трафика. EC2 — это виртуальные серверы, которые позволяют запускать вычисления близко к данным и снижать задержки. В dbt v2 DuckDB теперь встроен в Fusion engine, что упрощает локальную разработку, но для trillion-token пайплайнов этого недостаточно. В российских командах, где бюджеты на облако ограничены, такой подход позволяет анализировать метаданные без постоянного переноса данных и без подписки на дорогие warehouse. При выборе решения стоит оценить: если метаданные растут, хватит ли локальных запросов или потребуется масштабирование, которое увеличит затраты и сложность.
Агенты и эволюция инженерной роли
Модели сейчас воспринимаются как выбор телефона: возможности похожи, а привычки разные. Агенты берут на себя рутинные миграции и тесты, однако сложные пайплайны всё равно требуют «gut feeling» — интуитивного понимания, где возникнет bottleneck. Bottleneck — это узкое место, замедляющее всю систему, и его поиск требует знания архитектуры. Josh сравнивает современного инженера с пилотом, который вмешивается только при отказе автоматики. В российских проектах, где legacy-системы и нехватка специалистов по bare-metal Kubernetes сохраняются, агенты ускоряют типовые задачи, но не заменяют знание shuffle и партиционирования. Партиционирование — это разделение данных по ключам для ускорения доступа и снижения объёма обработки. Главный риск — потеря экспертизы, если все решения отдавать агентам без проверки. При оценке стоит подумать, готова ли команда сохранять компетенции или рискует получить неуправляемые системы при сбоях.
Что остаётся после автоматизации
По мнению Josh, data engineering не исчезнет, потому что всегда нужно решать, какие данные считать устаревшими и когда инвалидировать кэш. Даже при полной автоматизации тестов и миграций остаётся задача выбора данных для обучения и контроля стоимости хранения. В российских условиях это особенно актуально из-за санкционных ограничений на managed-сервисы: приходится комбинировать Spark, Celeborn и локальные DuckDB-запросы к метаданным. Инженеры, которые понимают эти слои, продолжают быть востребованными, а те, кто рассчитывает только на агентов, рискуют получить дорогие и нестабильные пайплайны. При принятии решения важно проверить, есть ли в команде специалисты, способные контролировать все уровни, иначе автоматизация может привести к скрытым расходам и потере контроля.
Источник
Это краткий разбор материала MotherDuck. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Data engineering как проблема кэш-инвалидации.
Курс по теме — Каталог курсов Школы Больших Данных