 1
Содержание
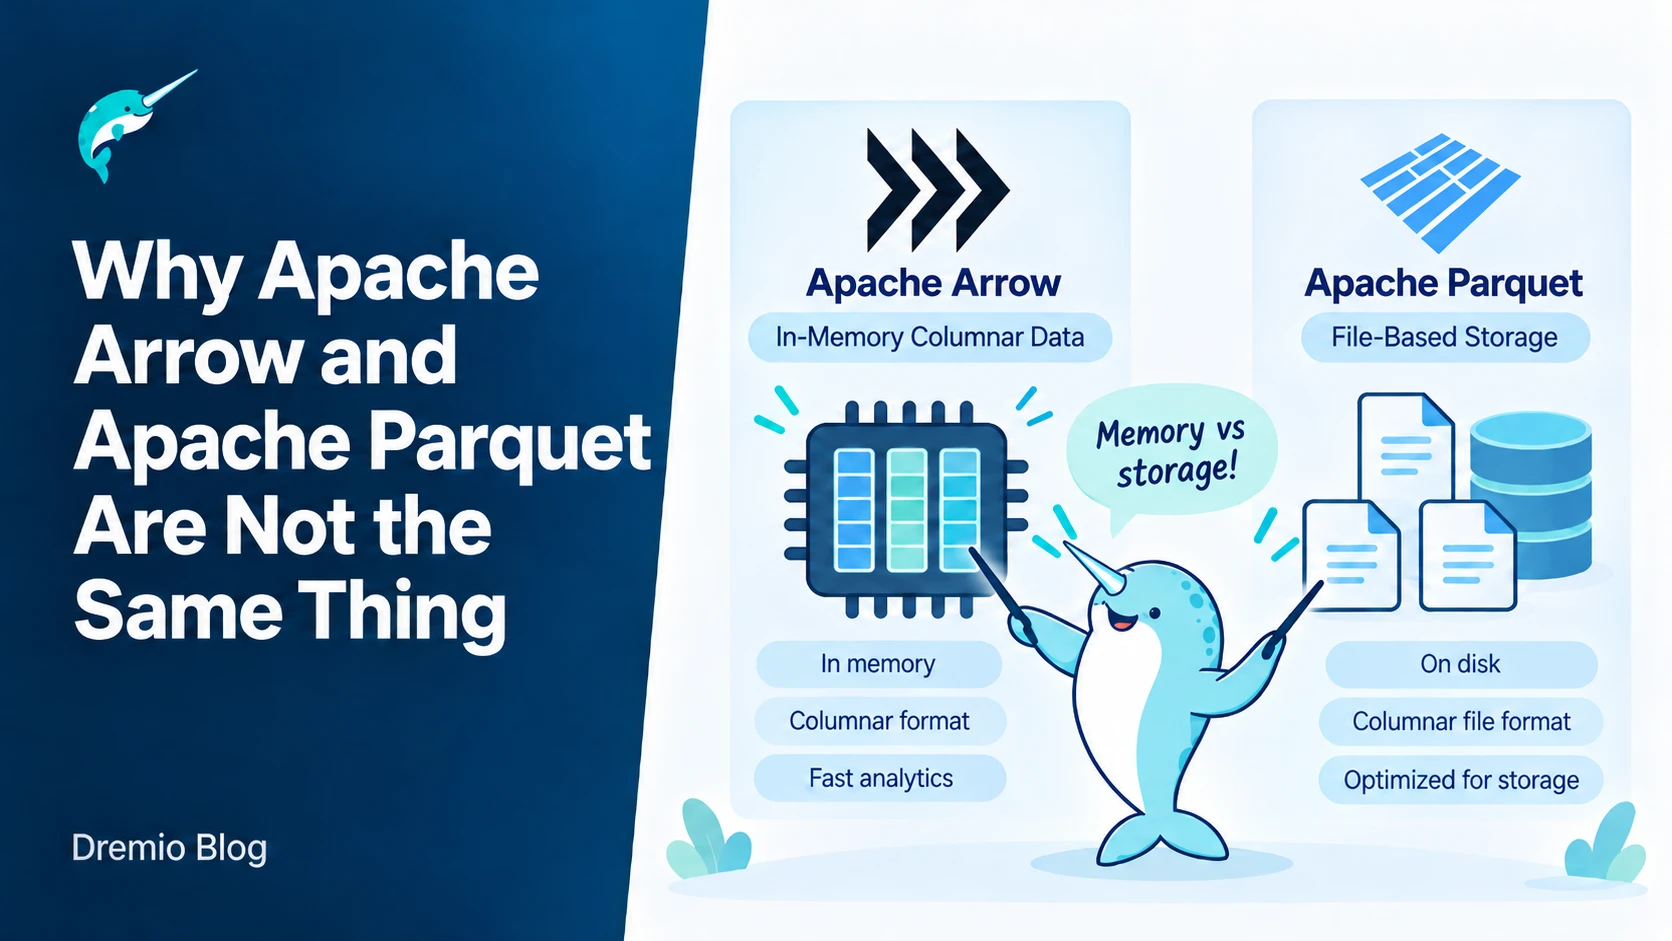
Dremio напомнила, что Parquet отвечает за хранение колонок на диске, а Arrow — за представление тех же колонок в оперативной памяти. Parquet — это колоночный формат для файлов, который сжимает данные и хранит статистику, чтобы сократить объём и ускорить выборку. Arrow — это колоночный формат для оперативной памяти, где колонки лежат в непрерывных буферах и доступны без лишних копий. Различие определяет скорость доступа, формат сериализации и затраты на преобразования. Для инженеров, которые строят пайплайны на Spark, Iceberg и S3, это означает, что выбор формата влияет не только на размер файлов, но и на latency запросов и потребление CPU. При принятии решения важно понимать, что Parquet снижает затраты на хранение и сеть, а Arrow сокращает время обработки внутри кластера, но требует дополнительной памяти и конвертации.
Как форматы ведут себя в разных слоях
Parquet оптимизирован под последовательную запись и чтение с диска: он использует сжатие страниц, словари и статистику, чтобы уменьшить объём и ускорить фильтрацию без загрузки всего файла. Сжатие страниц уменьшает размер данных на диске, словари заменяют повторяющиеся значения на индексы, а статистика позволяет пропускать ненужные блоки при чтении. Arrow, напротив, хранит данные в непрерывных буферах в памяти, где колонки лежат рядом и доступны без копирования. Поэтому Arrow даёт нулевые затраты на десериализацию при передаче между процессами и библиотеками, но не предназначен для долгосрочного хранения. При выборе формата для пайплайна стоит учитывать, что Parquet выгоден при редких обращениях к данным, а Arrow — когда нужно быстро обрабатывать одни и те же данные несколько раз внутри одного процесса.
Когда данные переходят из Parquet в Arrow, происходит материализация: декодируются страницы, распаковываются словари и строятся буферы. Материализация требует CPU и памяти, но после неё доступ к колонкам становится прямым. Обратный путь — из Arrow в Parquet — требует выбора стратегии кодирования и сжатия, что добавляет CPU. В запросах Spark это проявляется как stage с expensive shuffle, если промежуточные результаты держат в Arrow, а финальные пишут в Parquet. Для решения о формате важно оценить частоту таких переходов: если они происходят на каждом запросе, общие затраты CPU растут и latency увеличивается.
Ограничения при совместном использовании
Arrow не хранит метаданные уровня файла, такие как row-group statistics или bloom-фильтры, поэтому для predicate pushdown всё равно нужен Parquet. Row-group statistics — это агрегаты по блокам строк внутри файла, а bloom-фильтры помогают быстро проверить, есть ли нужные значения. Predicate pushdown — это механизм, при котором фильтры применяются ещё на уровне чтения файла, до загрузки данных в память. Parquet, в свою очередь, не даёт zero-copy доступа к колонкам в памяти, из-за чего аналитические движки вынуждены конвертировать данные при каждом запросе. Zero-copy означает, что данные можно использовать без создания копий. В связке с Iceberg это означает, что планировщик может пропускать файлы по статистике Parquet, но исполнитель всё равно тратит ресурсы на конвертацию в Arrow. Iceberg хранит метаданные таблиц и помогает управлять версиями, но не меняет базовые ограничения форматов.
Дополнительное ограничение — размер. Arrow требует, чтобы весь батч помещался в память, тогда как Parquet позволяет читать отдельные row groups. Row group — это независимый блок данных внутри Parquet-файла, который можно читать отдельно. При работе с S3 это приводит к тому, что большие файлы Parquet выгоднее, а Arrow лучше использовать для промежуточных результатов внутри одного executor’а. При принятии решения о формате важно учитывать объём данных и доступную память: если батчи Arrow превышают лимиты, система начнёт сбрасывать данные на диск или завершать задачи с ошибками.
Что переносимо на российские контуры
В инфраструктуре без доступа к managed-облакам разница становится критичнее: локальные кластеры Spark чаще ограничены по памяти и сети, поэтому лишние конвертации между форматами сразу съедают бюджет CPU. Инженеры могут оставить Parquet как основной формат на S3-совместимом хранилище, а Arrow применять только внутри Arrow Flight или в процессах, где данные уже загружены. Arrow Flight — это протокол для быстрой передачи данных между системами без лишних копий. Это снижает количество материализаций и позволяет Iceberg-таблицам сохранять статистику без изменения схемы. При ограниченном бюджете CPU и памяти такой подход помогает избежать простоев и перерасхода ресурсов.
При миграции существующих пайплайнов стоит измерить долю времени, которую занимает преобразование Parquet → Arrow. Если она превышает 20-25 % от общего времени запроса, имеет смысл увеличить размер батчей Arrow или перейти на форматы, которые ближе к Arrow на диске, например, Lance. В российских командах такой замер обычно даёт более точную картину, чем слепое копирование рекомендаций облачных вендоров. Измерение помогает принять обоснованное решение: если конвертация занимает значительную долю времени, стоит пересмотреть архитектуру и сократить количество переходов между форматами.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Arrow и Parquet — разница в памяти и на диске.
Курс по теме — Каталог курсов Школы Больших Данных