10
Содержание
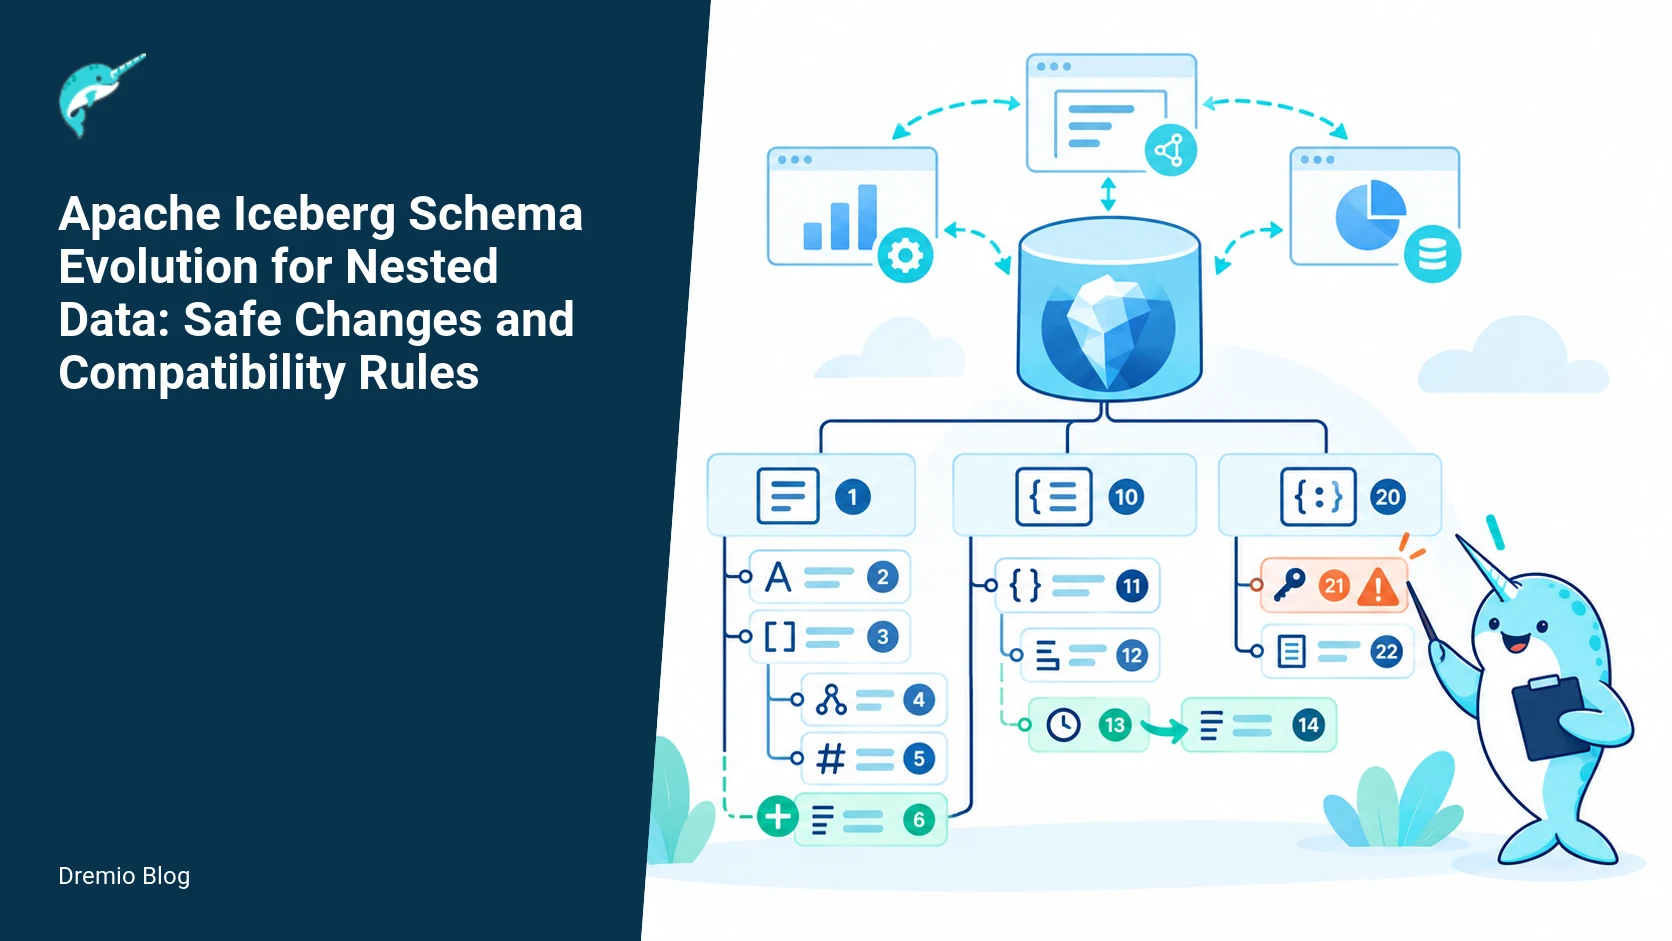
Dremio опубликовала разбор правил эволюции схем для вложенных структур Apache Iceberg. Материал показывает, как менять вложенные struct, list и map так, чтобы таблицы оставались читаемыми в Spark, Trino и других движках. Главный акцент сделан на field ID, правилах nullability и type promotion, а также на проверках совместимости между системами. Эти правила помогают командам понять, стоит ли вносить изменения в схему или лучше оставить её без правок, чтобы избежать простоев и ошибок чтения.
Проблема с вложенными типами
Вложенные структуры в Iceberg хранятся с жёсткой привязкой field ID, поэтому любое изменение требует точного соблюдения правил. Field ID — это уникальный идентификатор поля, который сохраняется независимо от имени и позволяет движкам правильно интерпретировать данные даже после переименований или добавлений. Без этого последующие чтения через Spark или Trino могут вернуть ошибку или неверные данные. Основная сложность возникает при добавлении полей внутрь map или list, где нужно сохранить старые ID и не нарушить nullability. Nullability определяет, может ли поле принимать пустые значения; нарушение этого правила часто приводит к расхождениям в результатах запросов.
Разработчики часто сталкиваются с ситуацией, когда простое добавление вложенного поля ломает downstream-запросы. Причина в том, что движки по-разному обрабатывают отсутствующие значения и продвижение типов. Type promotion — это изменение типа данных поля на более широкий без потери информации. Статья приводит примеры, где type promotion с int к long работает, а с float к double уже требует дополнительных проверок. Перед тем как решать, брать ли изменения в production, важно оценить, насколько критична совместимость с историческими данными и есть ли возможность протестировать запросы на всех используемых движках.
Правила nullability и продвижения типов
Iceberg разрешает делать поле nullable, но обратная операция запрещена. Это значит, что если поле уже допускает пустые значения, его нельзя сделать обязательным без риска нарушения существующих записей. При этом type promotion ограничен списком: int → long, float → double, а также некоторые преобразования строковых типов. Новые правила явно описывают, какие изменения можно применять к вложенным элементам struct без риска потери данных. Struct — это вложенная структура полей, list — упорядоченный список элементов, а map — словарь ключ-значение. Понимание этих ограничений помогает принять решение: если проект использует сложные вложенные типы, то эволюция схемы требует тщательной проверки, иначе лучше отказаться от изменений.
Defaults теперь можно задавать только для новых полей, и они не распространяются на уже существующие записи. Это важно при работе с историческими партициями, где старые данные не содержат новых полей. Нарушение этого правила приводит к тому, что Trino и Spark возвращают разные результаты для одних и тех же запросов. При оценке целесообразности изменений стоит учитывать объём исторических данных и частоту обращений к ним: если расхождения недопустимы, то внедрение правил эволюции может оказаться неоправданным.
Проверки совместимости между движками
Авторы провели тесты на Spark 3.4 и Trino 414, показав, где правила работают одинаково, а где расходятся. Основные расхождения касаются обработки null внутри list и map. В одном движке такие значения игнорируются, в другом вызывают ошибку при чтении. Такие различия напрямую влияют на решение о применении изменений: если система одновременно использует несколько движков, то без предварительной проверки совместимости риск ошибок остаётся высоким.
Для безопасной эволюции рекомендуется сначала применить изменение в тестовом каталоге, затем проверить запросы на всех используемых движках. Только после этого переносить схему в production. Такой подход снижает риск несовместимости при одновременной работе Spark и Trino на одних таблицах. Командам стоит взвесить затраты на тестирование: если время и ресурсы ограничены, а таблицы используются в критичных процессах, то безопаснее сохранить текущую схему без вложенных изменений.
Особенности внедрения в изолированных средах
В российских контурах, где нет прямого доступа к облачным каталогам, правила особенно полезны при самостоятельном развёртывании Iceberg на Hadoop или S3-совместимом хранилище. Команды могут использовать field ID и описанные ограничения для планирования миграций без риска потерять совместимость между разными версиями Spark и Trino, развёрнутыми локально. В изолированной инфраструктуре возможность быстрого отката ограничена, поэтому решение о внесении изменений должно опираться на собственные тесты совместимости.
При этом важно учитывать, что тесты совместимости в статье выполнены на западных сборках, поэтому перед применением стоит повторить их на своих версиях движков. Это позволяет заранее выявить расхождения в обработке вложенных null и type promotion, которые могут проявиться именно в изолированной инфраструктуре без возможности быстрого отката через внешний каталог. Если инфраструктура не позволяет проводить полные тесты на всех комбинациях движков, то внедрение эволюции вложенных схем лучше отложить.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Эволюция вложенных схем в Iceberg без рисков.
Курс по теме — Каталог курсов Школы Больших Данных