 2
Содержание
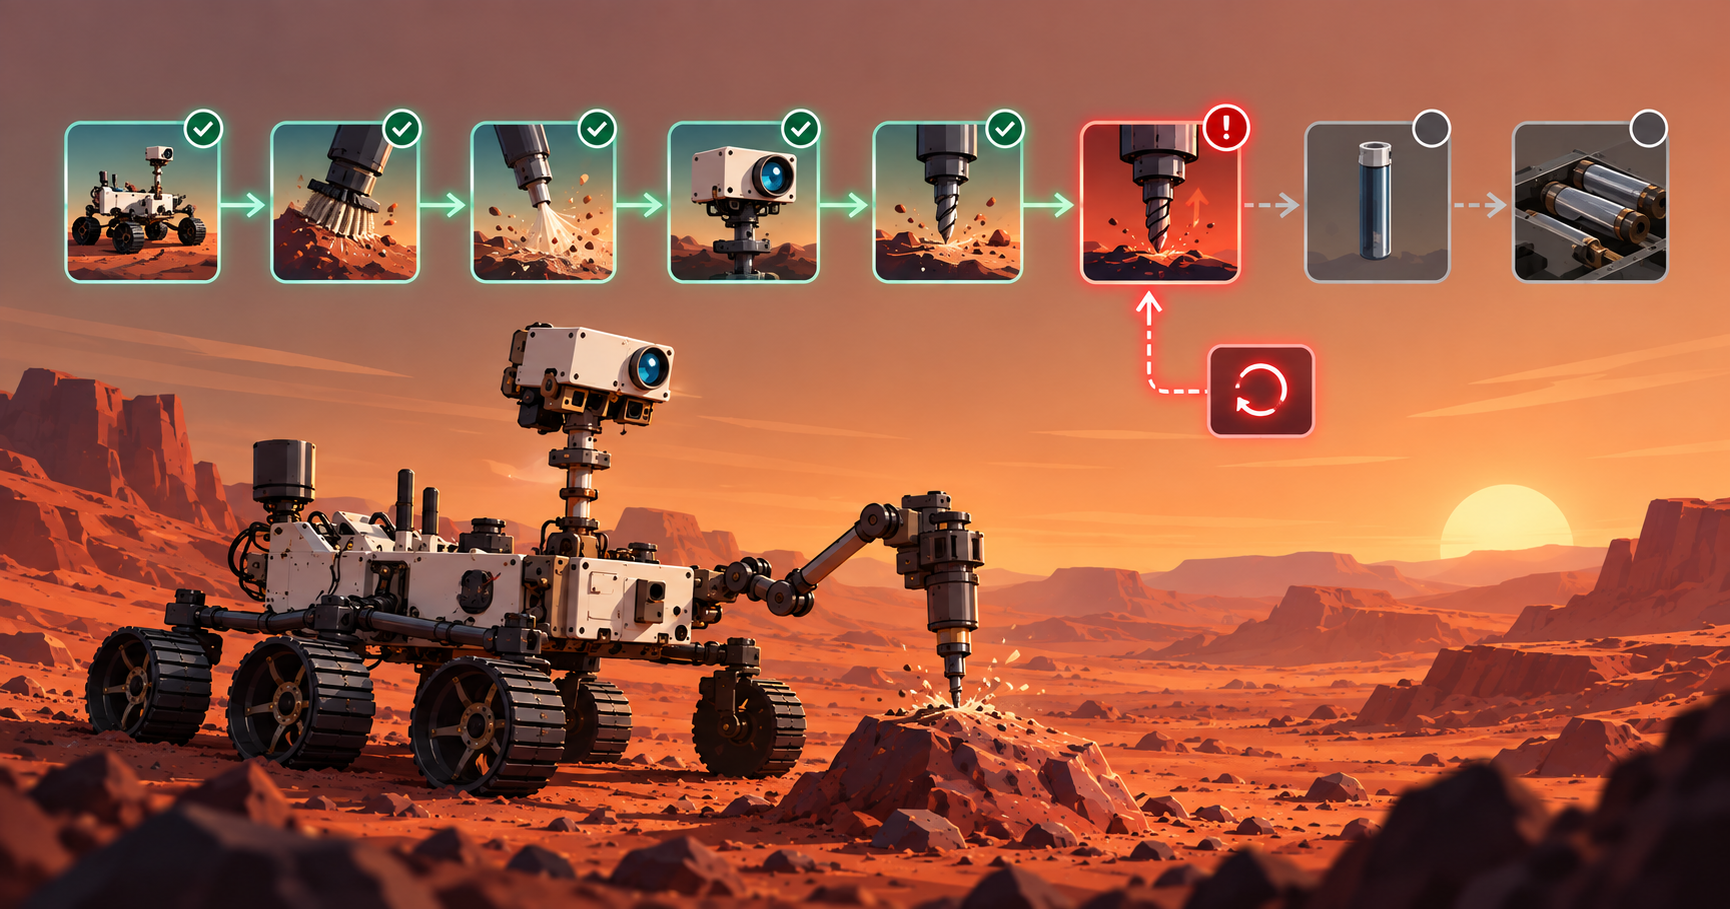
Airflow 3.3 переносит границу устойчивости внутрь задачи. Теперь при падении воркера retry не начинает работу заново, а подхватывает уже выполненную часть. Это касается как внешних систем вроде Spark и Databricks, так и агентских вызовов моделей. Инженеры избавляются от ручных костылей в виде таблиц оффсетов и отдельных задач submit-wait.
Apache Airflow — это платформа для оркестрации рабочих процессов, которая управляет последовательностью задач в конвейерах данных. В версии 3.3 появилось встроенное возобновление, которое раньше требовало отдельной реализации. Для команд это означает меньше ручного кода и меньший риск ошибок при сбоях. При принятии решения об обновлении важно оценить, насколько часто в ваших DAG встречаются долгие внешние задачи и насколько критична стоимость их повторного запуска.
Как выглядит проблема без внутренней устойчивости
В типичном контуре внешние джобы стоят дорого и не идемпотентны. Spark-задача на два часа, запущенная повторно, пишет в ту же таблицу и тратит двойной бюджет. Агент, сделавший 19 вызовов моделей, при сбое на 20-м шаге повторяет все запросы и снова платит за токены.
Раньше Airflow гарантировал возобновление только между задачами. Внутри одной долгой задачи состояние терялось. Команды вынуждены были сами сохранять курсор в Variables, XCom или отдельной таблице. Такие решения работали, но требовали поддержки и не масштабировались на десятки DAG.
Для оценки необходимости обновления стоит посчитать, сколько времени и денег уходит на повторные запуски. Если внешние системы оплачиваются по факту использования ресурсов или по числу вызовов, ручное сохранение состояния становится дорогим. Кроме того, поддержка самописных таблиц оффсетов добавляет технический долг: нужно следить за очисткой данных, обрабатывать ошибки записи и обеспечивать согласованность с экземплярами задач Airflow.
Три уровня реализации в Apache Airflow 3.3
Первый уровень включен по умолчанию для популярных операторов. SparkSubmitOperator, DatabricksSubmitRunOperator, BigQueryInsertJobOperator, KubernetesPodOperator и SnowflakeSqlApiOperator теперь записывают идентификатор внешней задачи перед ожиданием. При рестарте воркера retry подключается к уже запущенному процессу вместо создания нового.
Второй уровень предназначен для AI-агентов. Флаг durable=True кэширует каждый ответ модели и результат инструмента. При повторном запуске агент пропускает завершенные шаги и не тратит токены повторно. Это опциональная настройка, которую включают только там, где стоимость вызовов заметна.
Третий уровень дает доступ к хранилищу состояния внутри пользовательского кода. Через task_state_store можно читать и писать произвольные значения, привязанные к экземпляру задачи. Это заменяет самописные таблицы оффсетов для собственных ETL-скриптов и fine-tuning пайплайнов.
При решении о переходе важно понять, какие из ваших операторов попадают под первый уровень, а какие потребуют явного использования task_state_store. Если большинство долгих задач уже используют перечисленные операторы, выгода от обновления выше. Для кастомных решений второй и третий уровни позволяют избежать дублирования кода, но требуют тестирования на совместимость с существующими DAG.
Как это ложится на российские контуры
В инфраструктуре без стабильного доступа к облачным очередям и при частых перезапусках виртуальных машин внутренняя устойчивость снижает количество ручных доработок. Команды, использующие Airflow с Yandex DataProc, SberCloud Data Proc или собственными кластерами Kubernetes, получают возобновление внешних Spark- и Kubernetes-задач без изменения кода.
Для ML-нагрузок, где fine-tuning на десятки эпох стоит заметных ресурсов, возможность продолжить с последней записанной эпохи уменьшает потери при сбоях GPU-узлов. В агентских сценариях, построенных на локальных или частных LLM, durable-флаг помогает контролировать расходы на inference, когда модель вызывается через REST или через vLLM.
Российские компании часто работают в условиях ограниченной пропускной способности сети и плановых перезагрузок оборудования. В таких условиях возобновление внутри задачи снижает вероятность, что сбой одной виртуальной машины приведет к потере нескольких часов работы. При оценке обновления стоит проанализировать статистику сбоев воркеров за последние месяцы и рассчитать, какую долю от общего времени выполнения занимают задачи, которые теперь смогут продолжаться автоматически.
Когда стоит обновляться
Обновление имеет смысл, если в DAG уже есть длинные внешние джобы или агентские цепочки с высокой стоимостью повтора. В остальных случаях Airflow 2.x с ручными оффсетами пока справляется. Перед миграцией стоит проверить, что используемые операторы вошли в список поддерживаемых, и оценить объем изменений в CI/CD при переходе на 3.3.
Дополнительно рекомендуется оценить влияние на мониторинг и алерты: при возобновлении задач метрики могут измениться, и нужно убедиться, что существующие дашборды продолжают отражать реальную картину. Если в компании строгие требования к воспроизводимости запусков, следует проверить, как durable-режим влияет на логирование и аудит изменений состояния.
Источник
Это краткий разбор материала Astronomer. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Airflow 3.3 добавил возобновление задач после сбоев.
Курс по теме — Каталог курсов Школы Больших Данных