 1
Содержание
- Что предложили в DuckDB и где предел приёма
- Файл с представлениями как каталог
- Представление вместо таблицы
- Подключение READ_ONLY по https и s3
- Что ломается при изменениях
- DuckLake, метаданные в SQL-базе
- Каталожная база и снапшоты
- Конкурентная запись
- Iceberg с REST-каталогом
- Четыре варианта в сравнении
- Практика, один набор данных и три каталога
- Стенд
- Каталог из представлений
- Те же данные в DuckLake
- Те же данные в Iceberg
- Рост метаданных после 50 дозаписей
- Ограничения и подводные камни
- Что выбрать
- Заключение
- Референсные ссылки
7 октября 2026 года команда DuckDB показала, как собрать каталог озера данных (data lake catalog) из файла DuckDB, в котором нет ни одной строки данных. В файле лежат только представления (view) над Parquet в объектном хранилище (object storage), а коллеги подключают его по ссылке и сразу пишут SQL. Приём подкупает тем, что ему не нужны сервер, метастор и отдельная команда поддержки. Остаётся вопрос, где он перестаёт работать и когда команде пора переходить на DuckLake или Iceberg с REST-каталогом. Мы положили одни и те же события в S3 и описали их тремя каталогами на DuckDB 2.0.0. Затем добавили новую партицию и новую колонку, удалили часть строк, записали из двух процессов и сделали 50 мелких дозаписей. В статье разбираем устройство каждого каталога, сравниваем четыре варианта в таблице и показываем, что именно сломалось на стенде.
Что предложили в DuckDB и где предел приёма
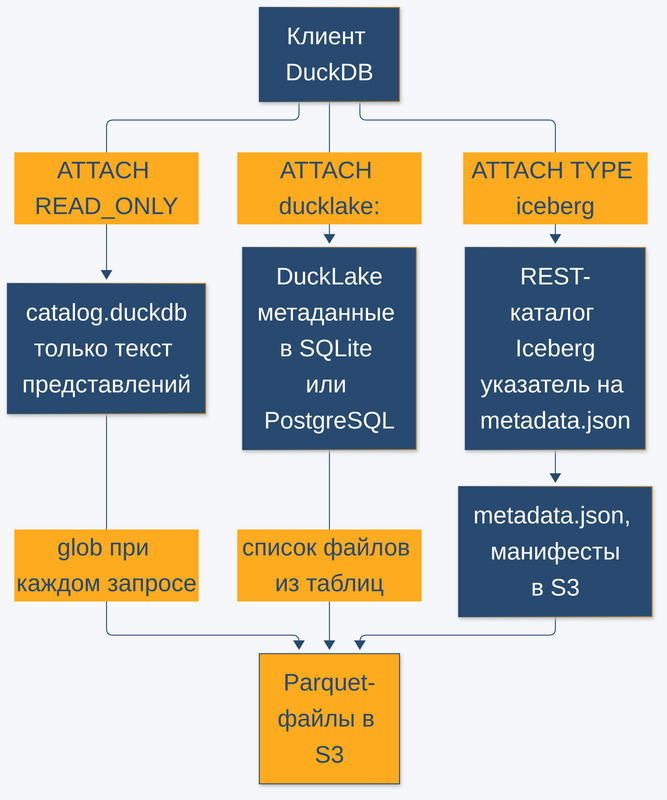
В посте «A DuckDB Database with No Data in It» команда DuckDB описывает файл .duckdb, где хранятся только определения представлений. Сами данные остаются в Parquet на S3 или HTTPS, а файл весит несколько сотен килобайт при любом объёме озера. Автор выкладывает файл рядом с данными, потребитель подключает его командой ATTACH с флагом READ_ONLY и обращается к представлениям как к таблицам. В адресе поста есть слова view-only mode, но отдельного режима движка нет. Это приём на обычных возможностях DuckDB.
Короткий пересказ мы уже публиковали в новости о каталоге данных на DuckDB. Пост честно перечисляет ограничения приёма. Потребителю нужен доступ и к файлу, и ко всем источникам, файл по сети только читается, а скорость зависит от сети и раскладки файлов. Что будет при изменении схемы, при одновременной записи и при тысячах мелких файлов, в посте не сказано. Эти вопросы и отличают общий список запросов от каталога, поэтому дальше мы смотрим на три уровня каталога над одними и теми же файлами.
Файл с представлениями как каталог
Самый простой каталог озера это вообще никакого каталога. Файлы раскладываются по Hive-разбиению (Hive partitioning) вида dt=2026-10-01, а каждый аналитик пишет в запросе свой glob по путям. Через месяц у трёх аналитиков три разных пути, два набора фильтров и разное понимание того, какие колонки считать выручкой. Файл с представлениями решает именно эту проблему: он даёт озеру общие имена.
Представление вместо таблицы
Представление в DuckDB хранит текст запроса, а не результат. На стенде представление events после создания сохранилось как одна строка SQL с вызовом read_parquet по маске s3://lake/raw/events/*/*.parquet и флагом hive_partitioning. Список файлов в каталог не попадает, DuckDB раскрывает маску при каждом запросе. Поэтому новая партиция, положенная в бакет, становится видна сразу и без пересборки каталога. Поверх events лежит второе представление daily с агрегатами по дням, и потребитель видит уже готовую бизнес-сущность, а не пути к файлам.
Ключи к S3 в файл каталога не попадают. Секрет (secret) создаётся командой CREATE SECRET в сессии автора и живёт только в ней. Читателю нужен собственный секрет с правами на чтение и файла каталога, и данных под ним. Для одного бакета это удобно, а для озера, где разные команды владеют разными префиксами, права придётся раздавать на всё, что упомянуто в представлениях.
Подключение READ_ONLY по https и s3
Файл каталога выкладывается в тот же бакет или на любой HTTPS-адрес. Подключение по сети возможно только на чтение, поэтому любая правка каталога означает правку локальной копии и перезаливку файла. На стенде ATTACH по s3 занимал 0.01 с. Это не скорость сети. Похоже, подключение ленивое и файл читается при первом запросе, отдельно этот момент мы не замеряли. Сам запрос к daily по десяти дням и двум миллионам строк выполнялся за 0.10 с на сервере с 4 vCPU.
Что ломается при изменениях
Новые файлы маска подхватывает сама, и это сильная сторона приёма. Слабая сторона в схеме. Функция read_parquet без параметра union_by_name берёт схему из первого файла по маске. Если в новых файлах появилась колонка, представление её не покажет и никак об этом не сообщит. Ошибку читатель увидит только при прямом обращении к новой колонке. Транзакций, снапшотов и истории изменений у такого каталога тоже нет. Если писатель перезаписал файл партиции, предыдущая версия данных пропала, и представление об этом не узнает.
DuckLake, метаданные в SQL-базе
DuckLake это формат таблиц для озера данных от создателей DuckDB. Данные лежат в Parquet, а все метаданные (схемы, списки файлов, снапшоты, статистика колонок) хранятся в обычной SQL-базе. Спецификация 1.0 вышла 13 апреля 2026 года, а расширение ducklake для DuckDB 2.0.0 на стенде уже пишет формат версии 1.1. Подключается DuckLake одной командой ATTACH со строкой вида ducklake:sqlite:путь и параметром DATA_PATH, который указывает, куда класть Parquet.
Каталожная база и снапшоты
Каждая транзакция в DuckLake создаёт снапшот (snapshot), то есть запись в таблице метаданных, а не новый файл в хранилище. По снапшотам работает путешествие во времени (time travel). Запрос с AT (VERSION => N) читает таблицу такой, какой она была после транзакции N. Эволюция схемы (schema evolution) тоже живёт в метаданных. Команда ALTER TABLE … ADD COLUMN не переписывает старые файлы, а для строк из них новая колонка просто возвращает NULL. Удаление пишется отдельным файлом удалений (delete file), а мелкие вставки DuckLake вообще не выносит в Parquet. Такие строки встраиваются прямо в каталожную базу (data inlining), и в SQLite на стенде для них заведены таблицы ducklake_inlined_data.
Выбор каталожной базы определяет, кто может работать с озером. В документации DuckLake по выбору каталожной базы перечислены варианты.
- Файл DuckDB. Один клиент, то есть один процесс или несколько только на чтение.
- SQLite. Несколько локальных клиентов, один писатель в каждый момент времени, конфликты блокировок повторяются автоматически.
- PostgreSQL 12+. Многопользовательская работа с удалёнными клиентами.
Для команды с несколькими машинами реальный вариант один, PostgreSQL. SQLite и файл DuckDB подходят для одного сервера или для ноутбука аналитика.
Конкурентная запись
Файл с представлениями писателей не знает вовсе, писатели кладут файлы в бакет мимо каталога. DuckLake записывает каждую транзакцию в каталожную базу, поэтому одновременная запись упирается в её блокировки. Для SQLite документация обещает одного писателя с повтором при конфликте. На стенде два процесса по 20 вставок в одну таблицу через один файл SQLite завершились без единой ошибки, обе серии записались целиком. Нагрузка была мала, поэтому вывод скромный. Стенд не показывает, случались ли конфликты вообще и сработал ли повтор, и ничего не говорит о пропускной способности под реальной нагрузкой.
Iceberg с REST-каталогом
Apache Iceberg хранит метаданные в самом объектном хранилище. Каталог держит только указатель на текущий файл metadata.json таблицы, а дальше по спецификации Iceberg идёт дерево из снапшотов, списков манифестов (manifest list), манифестов (manifest) и файлов данных. Подробнее о роли таких каталогов мы писали в сравнении Iceberg и Hive в озере данных. Главный плюс Iceberg в переносимости, потому что ту же таблицу читают и пишут Spark, Trino, Flink и другие движки через один REST-каталог.
DuckDB работает с Iceberg через расширение iceberg. По документации записи в Iceberg писать можно только через подключённый каталог, а функция iceberg_scan по пути к таблице умеет только читать. По разбору записи в Iceberg в блоге DuckDB чтение и первая запись появились в DuckDB 1.4.0, UPDATE и DELETE в 1.4.2. На стенде с DuckDB 2.0.0 прошли CREATE TABLE AS, INSERT, ALTER TABLE ADD COLUMN и DELETE. Не прошёл CREATE OR REPLACE, вместо него нужны отдельные DROP и CREATE.
Четыре варианта в сравнении
В таблице сведены четыре способа описать одни и те же Parquet-файлы. Ячейки опираются на документацию из референсов и на замеры стенда из раздела практики.
| Критерий | Parquet и glob без каталога | Файл с представлениями | DuckLake на SQLite | Iceberg и REST-каталог |
|---|---|---|---|---|
| Где метаданные | Нигде, пути в каждом запросе | Текст запросов в файле .duckdb | Таблицы SQL-базы, на стенде 31 таблица в SQLite | metadata.json, списки манифестов и манифесты в S3, указатель в каталоге |
| Что растёт с данными | Число файлов в бакете | Ничего, на стенде файл 268 КБ над 24.9 МБ данных | Строки в каталожной базе и файлы Parquet | Файлы метаданных в S3 на каждый коммит |
| Транзакции и time travel | Нет | Нет | Да, снапшот на транзакцию, AT (VERSION => N) | Да, снапшот на коммит, чтение по id снапшота |
| Новая колонка | Видна при union_by_name в запросе | Молча не видна, схема по первому файлу | ADD COLUMN в метаданных, старые строки NULL | ADD COLUMN через каталог |
| Конкурентная запись | Без координации | Без координации, файл только на чтение | Один писатель SQLite с повтором, на стенде 2 по 20 вставок без ошибок | Через каталог, оптимистичная конкурентность (optimistic concurrency) по спецификации |
| Метаданные после 50 дозаписей | Не ведутся | Не меняются | 0 файлов в S3, SQLite 168 КБ | 151 файл в S3, 1313 КБ |
| Порог входа | Нулевой | Один файл и CREATE SECRET у читателя | Каталожная база, для команды PostgreSQL | Отдельный сервис REST-каталога |
Файл с представлениями выигрывает там, где озеро только читают, а пишет его один конвейер по понятному расписанию. Он даёт общие имена почти бесплатно, но не защищает ни от смены схемы, ни от перезаписи файлов. DuckLake добавляет транзакции, снапшоты и эволюцию схемы, а метаданные держит компактно в SQL-базе вместо россыпи мелких файлов. Цена этого в каталожной базе, которую кто-то должен поднять и сопровождать. Iceberg берут, когда к таблице ходят разные движки, и тогда россыпь метаданных в S3 становится платой за переносимость.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика, один набор данных и три каталога
Сценарий такой. Генерируем десять дней синтетических событий по 200 тысяч строк в S3, собираем каталог из представлений и читаем его из чистого процесса. Потом добавляем день с теми же колонками и день с новой колонкой channel. Те же события загружаем в DuckLake и в Iceberg, повторяем на них новую колонку, удаление и запись, а в конце сравниваем рост метаданных после 50 мелких дозаписей. Весь прогон на сервере с 4 vCPU и 16 ГБ памяти занял одну минуту.
Стенд
Docker Compose поднимает только хранилище и REST-каталог, а DuckDB 2.0.0 работает в виртуальном окружении Python на хосте. SeaweedFS 4.48 играет роль S3, потому что образа minio/minio в Docker Hub больше нет. Одноразовый сервис create_bucket создаёт бакет lake и завершается. Тестовый каталог apache/iceberg-rest-fixture 1.10.1 держит свои данные в SQLite в памяти и годится для демо, но не для продакшна. Его встроенная проверка готовности на холодном старте не успевала за JVM, поэтому в compose.yaml своя проверка с запасом.
# SeaweedFS 4.48 + iceberg-rest-fixture 1.10.1, DuckDB 2.0.0 в venv на хосте, прогнано на стенде 2026-10-22
name: blog-duckdb_lake_catalog

services:
  # S3-совместимое хранилище: Parquet-файлы, файл каталога, данные DuckLake и Iceberg
  seaweedfs:
    image: chrislusf/seaweedfs:4.48
    mem_limit: 1g
    command: server -dir=/data -s3 -s3.port=8333 -s3.config=/etc/seaweedfs/s3.json
    ports:
      - "127.0.0.1:8333:8333"
    volumes:
      - ./seaweedfs/s3.json:/etc/seaweedfs/s3.json:ro
      - s3_data:/data

  # одноразовый шаг: создаёт бакет lake и завершается
  create_bucket:
    image: chrislusf/seaweedfs:4.48
    mem_limit: 256m
    depends_on: [seaweedfs]
    entrypoint: ["sh", "-c", "until echo 's3.bucket.create -name lake' | weed shell -master=seaweedfs:9333 2>&1 | grep -qiE 'created|exist'; do sleep 2; done; echo bucket lake ready"]

  # REST-каталог Iceberg: хранит указатель на текущий metadata.json каждой таблицы
  rest:
    image: apache/iceberg-rest-fixture:1.10.1
    mem_limit: 1g
    depends_on:
      create_bucket: { condition: service_completed_successfully }
    environment:
      AWS_ACCESS_KEY_ID: admin
      AWS_SECRET_ACCESS_KEY: password123
      AWS_REGION: us-east-1
      CATALOG_WAREHOUSE: s3://lake/iceberg/
      CATALOG_IO__IMPL: org.apache.iceberg.aws.s3.S3FileIO
      CATALOG_S3_ENDPOINT: http://seaweedfs:8333
      CATALOG_S3_PATH__STYLE__ACCESS: "true"
    # JVM на холодном старте поднимается дольше встроенной проверки образа
    healthcheck:
      test: ["CMD", "curl", "-sf", "http://localhost:8181/v1/config"]
      interval: 3s
      retries: 40
      start_period: 30s
    ports:
      - "127.0.0.1:8181:8181"

volumes:
  s3_data:
Ключи доступа к локальному S3 лежат в seaweedfs/s3.json.
{
  "identities": [
    {
      "name": "admin",
      "credentials": [{ "accessKey": "admin", "secretKey": "password123" }],
      "actions": ["Admin", "Read", "Write", "List", "Tagging"]
    }
  ]
}
Python-зависимостей три. Пакет boto3 нужен для заливки файла каталога и листинга бакета, а pytz клиент DuckDB требует для значений TIMESTAMPTZ, которые отдаёт DuckLake.
# pip, пакеты прогона DuckDB 2.0.0 на стенде 2026-10-22
boto3==1.43.117
duckdb==2.0.0
pytz==2026.5
# DuckDB 2.0.0, Docker Compose v2, прогнано на стенде 2026-10-22
docker compose up -d --wait
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/python make_data.py 2026-10-01 10
Данные генерирует make_data.py. Каждый день ложится одним файлом в префикс dt=ГГГГ-ММ-ДД, а флаг —with-channel добавляет в новые файлы колонку channel. Функция hash в DuckDB возвращает беззнаковый UBIGINT, которого нет среди типов Iceberg, поэтому user_id приводится к BIGINT.
# duckdb 2.0.0, SeaweedFS 4.48 как S3, прогнано на стенде 2026-10-22
"""Синтетические события в S3 с Hive-разбиением: s3://lake/raw/events/dt=YYYY-MM-DD/.

Запуск: python make_data.py 2026-10-01 10 [--with-channel]
"""
import sys
from datetime import date, timedelta

import duckdb

ROWS_PER_DAY = 200_000
start = date.fromisoformat(sys.argv[1])
days = int(sys.argv[2])
# новая колонка в новых файлах: так выглядит эволюция схемы в сыром озере
with_channel = "--with-channel" in sys.argv

con = duckdb.connect()
con.execute("""
    CREATE SECRET s3 (TYPE s3, KEY_ID 'admin', SECRET 'password123',
        ENDPOINT '127.0.0.1:8333', URL_STYLE 'path', USE_SSL false, REGION 'us-east-1')
""")

for n in range(days):
    day = start + timedelta(days=n)
    channel = ", ['web', 'ios', 'android'][i % 3 + 1] AS channel" if with_channel else ""
    # детерминированные данные: одинаковый результат при каждом прогоне
    con.execute(f"""
        COPY (
            SELECT i AS event_id,
                   (hash(i, '{day}') % 50000)::BIGINT AS user_id,
                   ['DE', 'FR', 'PL', 'NL', 'ES', 'IT', 'SE'][i % 7 + 1] AS country,
                   round((hash(i * 7, '{day}') % 100000) / 100, 2) AS amount
                   {channel}
            FROM range({ROWS_PER_DAY}) t(i)
        ) TO 's3://lake/raw/events/dt={day}/data_0.parquet' (FORMAT parquet)
    """)
    print(f"dt={day}: {ROWS_PER_DAY} строк" + (" + колонка channel" if with_channel else ""))

files, size = con.sql("""
    SELECT count(*), sum(size) FROM read_blob('s3://lake/raw/events/*/*.parquet')
""").fetchall()[0]
print(f"всего в s3://lake/raw/events/: {files} файлов, {size / 1024 / 1024:.1f} МБ")
dt=2026-10-01: 200000 строк
dt=2026-10-02: 200000 строк
dt=2026-10-03: 200000 строк
dt=2026-10-04: 200000 строк
dt=2026-10-05: 200000 строк
dt=2026-10-06: 200000 строк
dt=2026-10-07: 200000 строк
dt=2026-10-08: 200000 строк
dt=2026-10-09: 200000 строк
dt=2026-10-10: 200000 строк
всего в s3://lake/raw/events/: 10 файлов, 24.9 МБ
Каталог из представлений
Скрипт views_catalog.py работает в двух режимах. В режиме build он собирает catalog.duckdb из двух представлений и заливает его в s3://lake/catalog/. В режиме read он ведёт себя как читатель из другого процесса. Сначала пробует подключиться без секрета, затем с секретом, читает daily, смотрит колонки events и пытается записать в каталог.
# duckdb 2.0.0, SeaweedFS 4.48 как S3, прогнано на стенде 2026-10-22
"""Каталог из одних представлений: файл DuckDB без данных, который лежит рядом с озером.

build  собрать catalog.duckdb из представлений и выложить в s3://lake/catalog/
read   подключить каталог READ_ONLY из чистого процесса, как это делает читатель
"""
import sys
import time
from pathlib import Path

import boto3
import duckdb

SECRET = """
    CREATE SECRET s3 (TYPE s3, KEY_ID 'admin', SECRET 'password123',
        ENDPOINT '127.0.0.1:8333', URL_STYLE 'path', USE_SSL false, REGION 'us-east-1')
"""
CATALOG_URL = "s3://lake/catalog/catalog.duckdb"
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:8333", region_name="us-east-1",
                  aws_access_key_id="admin", aws_secret_access_key="password123")


def build() -> None:
    path = Path("work/catalog.duckdb")
    path.parent.mkdir(exist_ok=True)
    path.unlink(missing_ok=True)
    con = duckdb.connect(str(path))
    # секрет в файл каталога не попадает: каждый читатель заводит свой
    con.execute(SECRET)
    # в каталоге хранится только текст запроса; glob подхватит новые партиции сам
    con.execute("""
        CREATE VIEW events AS
        SELECT * FROM read_parquet('s3://lake/raw/events/*/*.parquet', hive_partitioning = true)
    """)
    con.execute("""
        CREATE VIEW daily AS
        SELECT dt, count(*) AS events, round(sum(amount), 2) AS revenue
        FROM events GROUP BY dt ORDER BY dt
    """)
    print("представления:", con.sql("SELECT view_name FROM duckdb_views() WHERE NOT internal").fetchall())
    print("текст events:", con.sql("SELECT sql FROM duckdb_views() WHERE view_name = 'events'").fetchall()[0][0])
    con.close()

    s3.upload_file(str(path), "lake", "catalog/catalog.duckdb")
    data = sum(o["Size"] for o in s3.list_objects_v2(Bucket="lake", Prefix="raw/events/")["Contents"])
    print(f"catalog.duckdb: {path.stat().st_size / 1024:.0f} КБ, данные под ним: {data / 1024 / 1024:.1f} МБ")


def read() -> None:
    con = duckdb.connect()
    # без секрета читатель не доберётся ни до файла каталога, ни до данных
    try:
        con.execute(f"ATTACH '{CATALOG_URL}' AS cat (READ_ONLY)")
    except duckdb.Error as e:
        print("ATTACH без секрета:", type(e).__name__, str(e).splitlines()[0][:160])

    con.execute(SECRET)
    t = time.time()
    con.execute(f"ATTACH '{CATALOG_URL}' AS cat (READ_ONLY)")
    print(f"ATTACH READ_ONLY по s3: {time.time() - t:.2f} с")

    t = time.time()
    rows = con.sql("SELECT * FROM cat.daily").fetchall()
    print(f"cat.daily за {time.time() - t:.2f} с:")
    for dt, events, revenue in rows:
        print(f"  {dt}  {events:>7}  {revenue:>12}")

    print("колонки cat.events:", [c[0] for c in con.sql("DESCRIBE cat.events").fetchall()])
    try:
        print("channel по дням:", con.sql(
            "SELECT dt, count(channel) FROM cat.events GROUP BY dt ORDER BY dt DESC LIMIT 2").fetchall())
    except duckdb.Error as e:
        print("запрос к channel:", type(e).__name__, str(e).splitlines()[0][:200])

    # каталог только для чтения: правится пересборкой и перезаливкой файла
    try:
        con.execute("CREATE TABLE cat.scratch AS SELECT 1")
    except duckdb.Error as e:
        print("запись в каталог:", type(e).__name__, str(e).splitlines()[0][:160])


if __name__ == "__main__":
    {"build": build, "read": read}[sys.argv[1]]()
# DuckDB 2.0.0, прогнано на стенде 2026-10-22
.venv/bin/python views_catalog.py build
.venv/bin/python views_catalog.py read
представления: [('daily',), ('events',)]
текст events: CREATE VIEW events AS SELECT * FROM read_parquet('s3://lake/raw/events/*/*.parquet', (hive_partitioning = true));
catalog.duckdb: 268 КБ, данные под ним: 24.9 МБ
Файл каталога весит 268 КБ, и это размер блочного формата хранения DuckDB, а не объём двух определений. Над 25 МБ данных соотношение выглядит странно, но над терабайтами разница исчезнет, потому что файл не растёт вместе с озером. Чтение из чистого процесса показывает три ограничения подряд.
ATTACH без секрета: HTTPException HTTP Error: HTTP GET error reading 's3://lake/catalog/catalog.duckdb' (HTTP 403 Forbidden)
ATTACH READ_ONLY по s3: 0.01 с
cat.daily за 0.10 с:
  2026-10-01   200000  100086406.67
  2026-10-02   200000   99873961.81
  2026-10-03   200000   99878864.27
  2026-10-04   200000  100090814.19
  2026-10-05   200000   99943227.73
  2026-10-06   200000   99965359.01
  2026-10-07   200000   99856517.55
  2026-10-08   200000   99918047.41
  2026-10-09   200000   99958675.57
  2026-10-10   200000  100072203.55
колонки cat.events: ['event_id', 'user_id', 'country', 'amount', 'dt']
запрос к channel: BinderException Binder Error: Referenced column "channel" not found in FROM clause!
запись в каталог: InvalidInputException Invalid Input Error: Cannot execute statement of type "CREATE" on database "cat" which is attached in read-only mode!
Без секрета S3 отвечает 403 уже на файл каталога. С секретом агрегаты по десяти дням считаются за 0.10 с, а запись в каталог запрещена режимом READ_ONLY. Теперь добавляем два дня, обычный и с новой колонкой.
# DuckDB 2.0.0, прогнано на стенде 2026-10-22
.venv/bin/python make_data.py 2026-10-11 1
.venv/bin/python make_data.py 2026-10-12 1 --with-channel
.venv/bin/python views_catalog.py read
dt=2026-10-11: 200000 строк
всего в s3://lake/raw/events/: 11 файлов, 27.4 МБ
dt=2026-10-12: 200000 строк + колонка channel
всего в s3://lake/raw/events/: 12 файлов, 29.9 МБ
ATTACH без секрета: HTTPException HTTP Error: HTTP GET error reading 's3://lake/catalog/catalog.duckdb' (HTTP 403 Forbidden)
ATTACH READ_ONLY по s3: 0.01 с
cat.daily за 0.10 с:
  2026-10-01   200000  100086406.67
  2026-10-02   200000   99873961.81
  2026-10-03   200000   99878864.27
  2026-10-04   200000  100090814.19
  2026-10-05   200000   99943227.73
  2026-10-06   200000   99965359.01
  2026-10-07   200000   99856517.55
  2026-10-08   200000   99918047.41
  2026-10-09   200000   99958675.57
  2026-10-10   200000  100072203.55
  2026-10-11   200000  100316916.37
  2026-10-12   200000  100117218.21
колонки cat.events: ['event_id', 'user_id', 'country', 'amount', 'dt']
запрос к channel: BinderException Binder Error: Referenced column "channel" not found in FROM clause!
запись в каталог: InvalidInputException Invalid Input Error: Cannot execute statement of type "CREATE" on database "cat" which is attached in read-only mode!
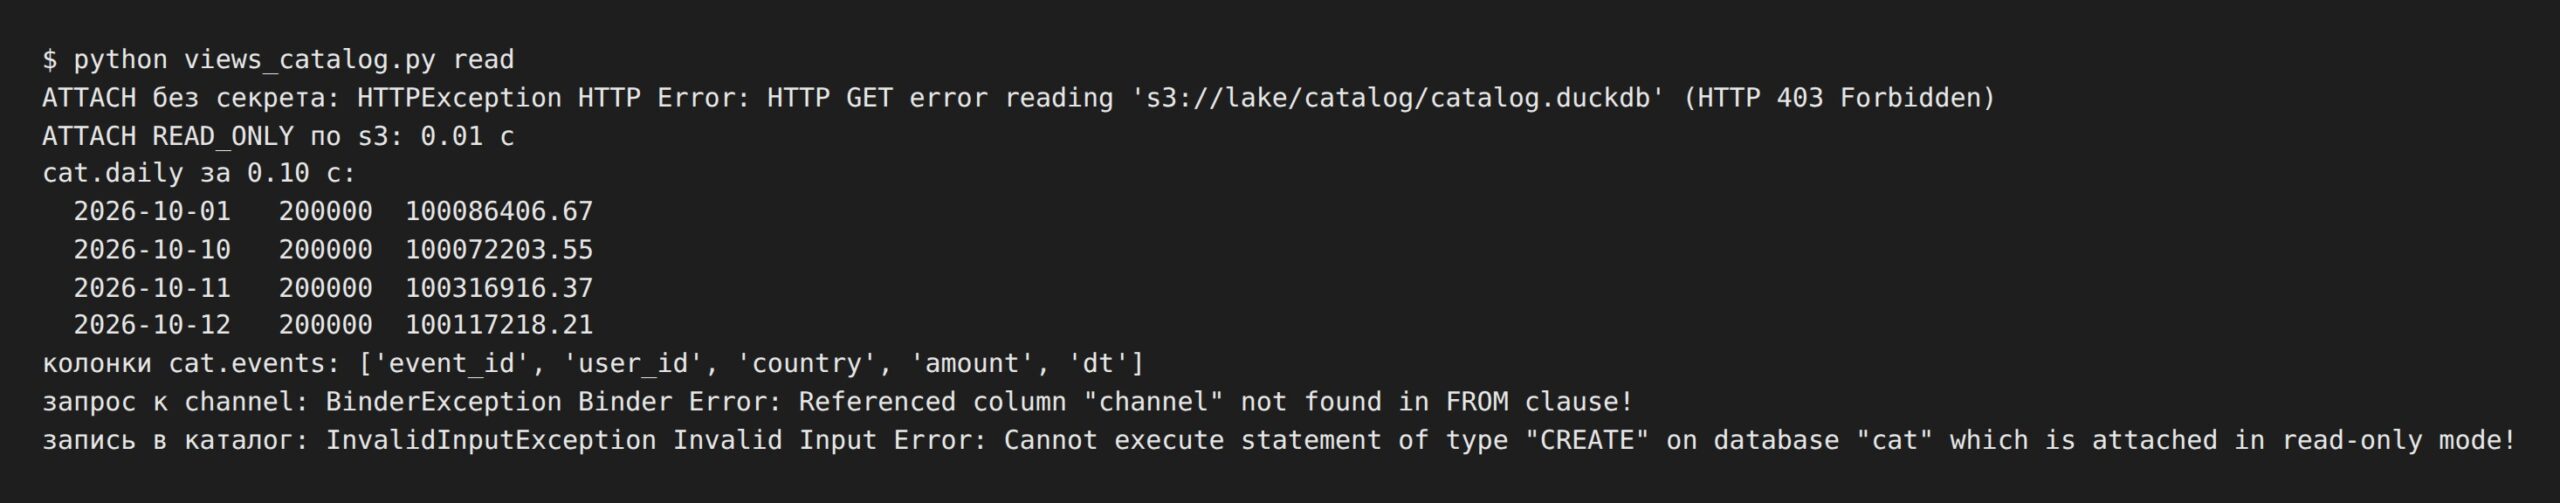
Каталог не пересобирался, а daily уже знает про 11 и 12 октября. Это сильная сторона glob в представлении. Колонки channel в events при этом нет, хотя в файле за 12 октября она заполнена у всех 200 тысяч строк. Ни пересборка, ни ошибка не подскажут читателю, что данные изменились, и это главный риск приёма.
Те же данные в DuckLake
Скрипт ducklake_catalog.py загружает первые десять дней одной транзакцией, дозаписывает 11 октября, добавляет колонку channel, загружает 12 октября и удаляет строки одной страны за первый день. Затем он печатает снапшоты, читает таблицу на трёх версиях и запускает двух писателей в отдельных процессах.
# duckdb 2.0.0 + ducklake (формат 1.1), каталог в SQLite, SeaweedFS 4.48 как S3, прогнано на стенде 2026-10-22
"""Те же события в DuckLake: метаданные в SQLite, данные Parquet в s3://lake/ducklake/.

Запуск: python ducklake_catalog.py
"""
import sqlite3
import subprocess
import sys
from pathlib import Path

import boto3
import duckdb

SECRET = """
    CREATE SECRET s3 (TYPE s3, KEY_ID 'admin', SECRET 'password123',
        ENDPOINT '127.0.0.1:8333', URL_STYLE 'path', USE_SSL false, REGION 'us-east-1')
"""
META = Path("work/lake.sqlite")
ATTACH = f"ATTACH 'ducklake:sqlite:{META}' AS dl (DATA_PATH 's3://lake/ducklake/')"
RAW = "read_parquet('s3://lake/raw/events/dt={day}/*.parquet', hive_partitioning = true, union_by_name = true)"


def connect() -> duckdb.DuckDBPyConnection:
    con = duckdb.connect()
    con.execute(SECRET)
    con.execute(ATTACH)
    return con


def writer(name: str) -> None:
    """Один из двух процессов, которые пишут в одну таблицу одновременно."""
    con = connect()
    ok = failed = 0
    for n in range(20):
        try:
            con.execute(f"INSERT INTO dl.events (event_id, dt, country, amount) VALUES ({n}, DATE '2026-10-13', '{name}', 1)")
            ok += 1
        except duckdb.Error as e:
            failed += 1
            last = str(e).splitlines()[0][:160]
    print(f"  писатель {name}: успешно {ok}, ошибок {failed}" + (f", последняя: {last}" if failed else ""))


def main() -> None:
    # чистый старт: локальная база метаданных и префикс данных в S3
    META.parent.mkdir(exist_ok=True)
    META.unlink(missing_ok=True)
    s3 = boto3.resource("s3", endpoint_url="http://127.0.0.1:8333", region_name="us-east-1",
                        aws_access_key_id="admin", aws_secret_access_key="password123")
    s3.Bucket("lake").objects.filter(Prefix="ducklake/").delete()

    con = connect()
    # первые десять дней одной транзакцией: это снапшот с таблицей
    con.execute("""
        CREATE TABLE dl.events AS
        SELECT event_id, user_id, country, amount, dt
        FROM read_parquet('s3://lake/raw/events/*/*.parquet', hive_partitioning = true, union_by_name = true)
        WHERE dt <= DATE '2026-10-10'
    """)
    con.execute(f"INSERT INTO dl.events SELECT event_id, user_id, country, amount, dt FROM {RAW.format(day='2026-10-11')}")

    # эволюция схемы: колонка добавляется в метаданные, старые файлы не переписываются
    con.execute("ALTER TABLE dl.events ADD COLUMN channel VARCHAR")
    con.execute(f"INSERT INTO dl.events SELECT event_id, user_id, country, amount, dt, channel FROM {RAW.format(day='2026-10-12')}")
    con.execute("DELETE FROM dl.events WHERE dt = DATE '2026-10-01' AND country = 'DE'")

    print("снапшоты:")
    for sid, changes in con.sql("SELECT snapshot_id, changes FROM ducklake_snapshots('dl') ORDER BY 1").fetchall():
        print(f"  {sid}: {changes}")

    print("строк сейчас:", con.sql("SELECT count(*) FROM dl.events").fetchall()[0][0])
    # time travel: та же таблица на момент любого снапшота
    for v in (1, 2, 3):
        print(f"строк AT (VERSION => {v}):", con.sql(f"SELECT count(*) FROM dl.events AT (VERSION => {v})").fetchall()[0][0])
    print("channel по дням:", con.sql(
        "SELECT dt, count(channel) FROM dl.events WHERE dt >= DATE '2026-10-11' GROUP BY dt ORDER BY dt").fetchall())

    files = con.sql("SELECT count(*), sum(data_file_size_bytes), count(delete_file) FROM ducklake_list_files('dl', 'events')").fetchall()[0]
    codec = con.sql("SELECT DISTINCT compression FROM parquet_metadata('s3://lake/ducklake/**/*.parquet')").fetchall()
    print("кодек Parquet по умолчанию:", codec)
    print(f"файлы данных: {files[0]}, {files[1] / 1024 / 1024:.1f} МБ, файлов удалений: {files[2]}")
    con.close()

    # что лежит в каталожной базе: обычные таблицы SQLite
    db = sqlite3.connect(META)
    tables = [r[0] for r in db.execute("SELECT name FROM sqlite_master WHERE type = 'table' ORDER BY 1")]
    inlined = [t for t in tables if t.startswith("ducklake_inlined_data_")]
    print(f"{META}: {META.stat().st_size / 1024:.0f} КБ, таблиц {len(tables)}, из них со вставками в каталоге: {inlined}")
    db.close()

    # два процесса пишут в одну таблицу через один файл SQLite
    print("конкурентная запись, 2 процесса по 20 INSERT:")
    procs = [subprocess.Popen([sys.executable, "-u", __file__, "writer", n]) for n in ("A", "B")]
    for p in procs:
        p.wait()
    con = connect()
    print("  строк от писателей:", con.sql(
        "SELECT country, count(*) FROM dl.events WHERE dt = DATE '2026-10-13' GROUP BY 1 ORDER BY 1").fetchall())


if __name__ == "__main__":
    if len(sys.argv) > 2 and sys.argv[1] == "writer":
        writer(sys.argv[2])
    else:
        main()
снапшоты:
  0: {'schemas_created': ['main']}
  1: {'tables_created': ['main.events'], 'tables_inserted_into': ['1']}
  2: {'tables_inserted_into': ['1']}
  3: {'tables_altered': ['1']}
  4: {'tables_inserted_into': ['1']}
  5: {'tables_deleted_from': ['1']}
строк сейчас: 2371428
строк AT (VERSION => 1): 2000000
строк AT (VERSION => 2): 2200000
строк AT (VERSION => 3): 2200000
channel по дням: [(datetime.date(2026, 10, 11), 0), (datetime.date(2026, 10, 12), 200000)]
кодек Parquet по умолчанию: [('SNAPPY',)]
файлы данных: 3, 29.9 МБ, файлов удалений: 1
work/lake.sqlite: 156 КБ, таблиц 31, из них со вставками в каталоге: ['ducklake_inlined_data_1_1', 'ducklake_inlined_data_1_2', 'ducklake_inlined_data_tables']
конкурентная запись, 2 процесса по 20 INSERT:
  писатель B: успешно 20, ошибок 0
  писатель A: успешно 20, ошибок 0
  строк от писателей: [('A', 20), ('B', 20)]
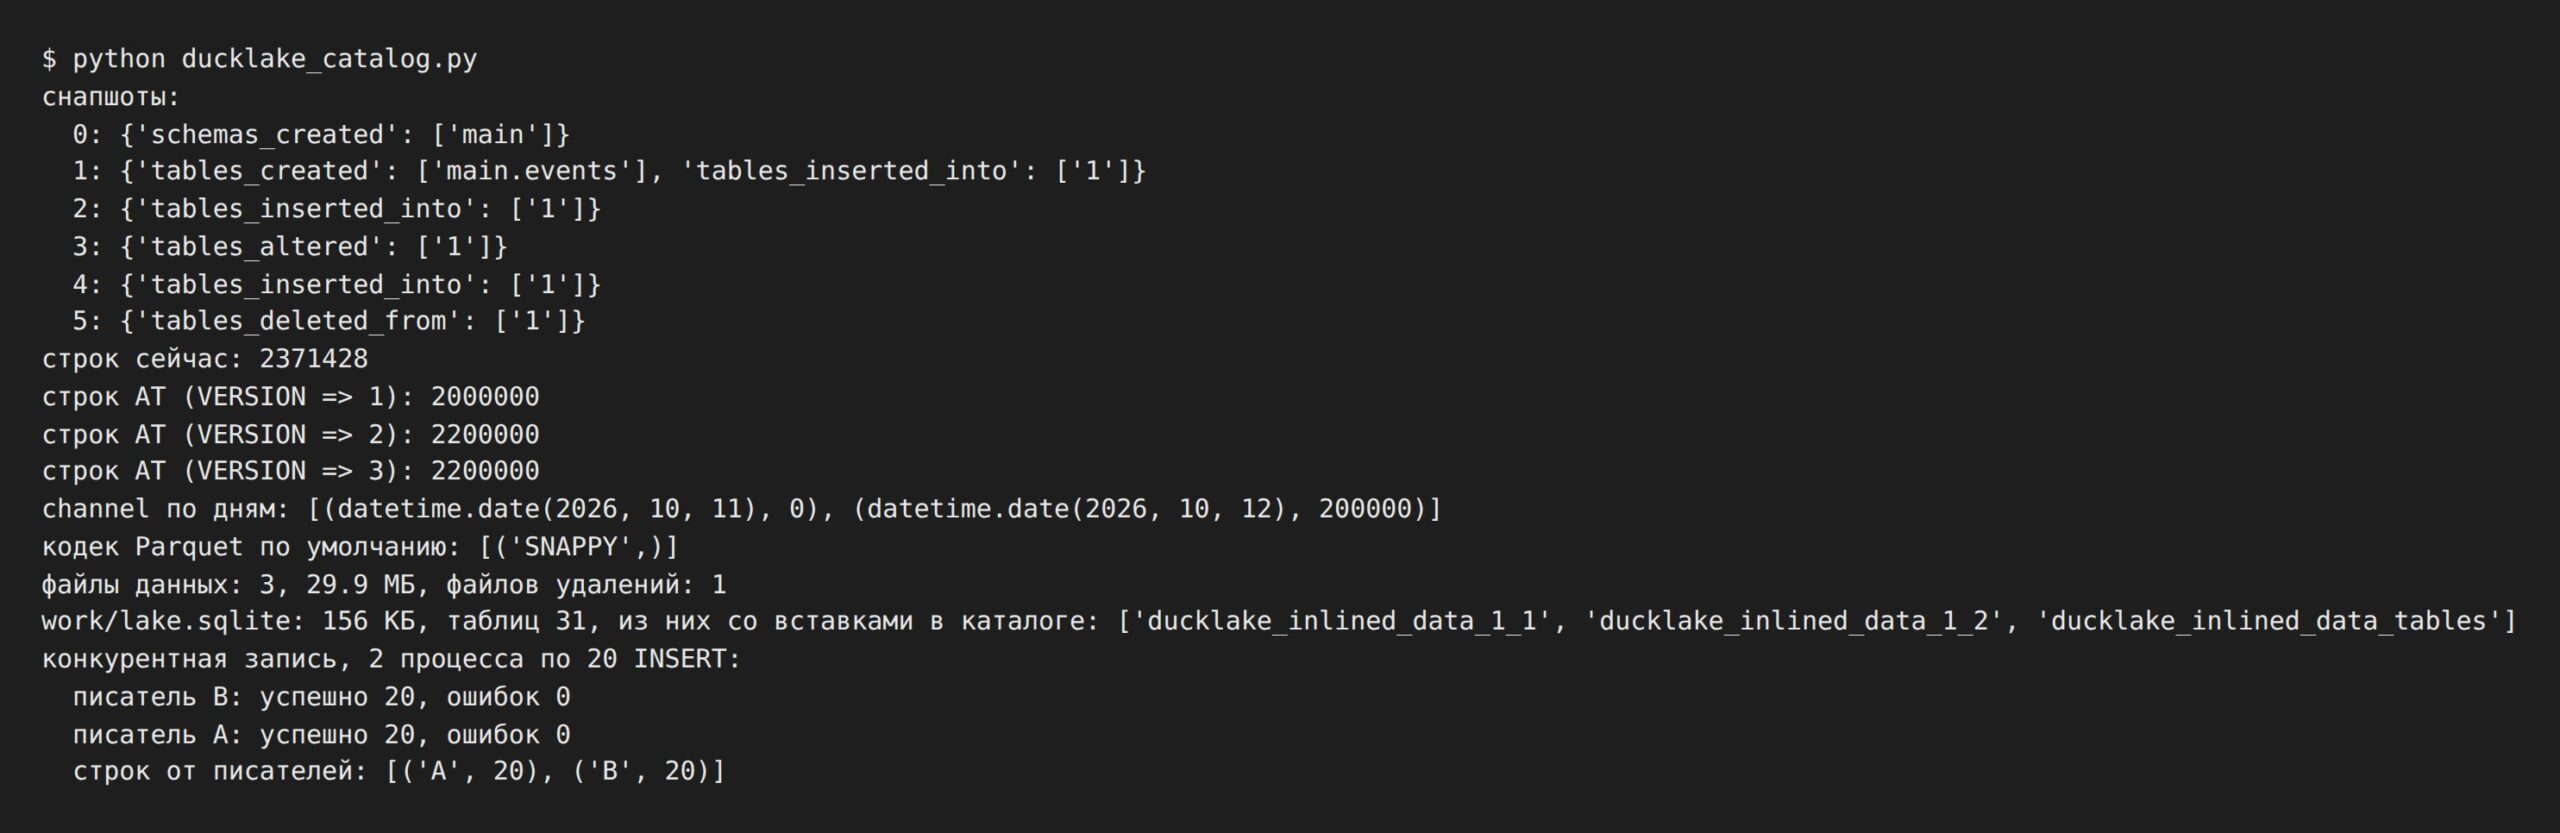
Шесть снапшотов соответствуют шести транзакциям, включая создание схемы main. Версия 3 содержит те же 2 200 000 строк, что версия 2, потому что ALTER TABLE поменял только схему. Колонка channel видна, у 11 октября она пустая, у 12 октября заполнена целиком. Удаление дало один файл удалений рядом с тремя файлами данных.
Отдельно стоит строка про кодек. DuckLake по умолчанию пишет Parquet в SNAPPY, а Iceberg в ZSTD, поэтому те же события заняли 29.9 МБ в DuckLake и около 13 МБ в Iceberg. Это различие настроек, а не каталогов. Кодек DuckLake меняется параметром parquet_compression, и в замере роста метаданных он выставлен в zstd.
Те же данные в Iceberg
Скрипт iceberg_catalog.py повторяет тот же сценарий через REST-каталог. Дополнительно он запрашивает у каталога описание таблицы и показывает, что каталог отдаёт любому движку только путь к metadata.json. DROP TABLE в тестовом каталоге не удаляет файлы, поэтому префикс таблицы скрипт чистит сам.
# duckdb 2.0.0 + iceberg, apache/iceberg-rest-fixture 1.10.1, SeaweedFS 4.48 как S3, прогнано на стенде 2026-10-22
"""Те же события в Iceberg через REST-каталог: метаданные и данные в s3://lake/iceberg/.

Запуск: python iceberg_catalog.py
"""
import json
import urllib.request

import boto3
import duckdb

con = duckdb.connect()
con.execute("""
    CREATE SECRET s3 (TYPE s3, KEY_ID 'admin', SECRET 'password123',
        ENDPOINT '127.0.0.1:8333', URL_STYLE 'path', USE_SSL false, REGION 'us-east-1')
""")
# DuckDB пишет в Iceberg только через подключённый каталог
con.execute("ATTACH 'warehouse' AS ice (TYPE iceberg, ENDPOINT 'http://127.0.0.1:8181', AUTHORIZATION_TYPE 'none')")
con.execute("CREATE SCHEMA IF NOT EXISTS ice.demo")
con.execute("DROP TABLE IF EXISTS ice.demo.events")
s3 = boto3.resource("s3", endpoint_url="http://127.0.0.1:8333", region_name="us-east-1",
                    aws_access_key_id="admin", aws_secret_access_key="password123")
# DROP в REST fixture не удаляет файлы: чистим префикс сами, иначе счёт пойдёт по прошлым прогонам
s3.Bucket("lake").objects.filter(Prefix="iceberg/demo/events/").delete()

RAW = "read_parquet('s3://lake/raw/events/*/*.parquet', hive_partitioning = true, union_by_name = true)"
con.execute(f"""
    CREATE TABLE ice.demo.events AS
    SELECT event_id, user_id, country, amount, dt FROM {RAW} WHERE dt <= DATE '2026-10-10'
""")
con.execute(f"INSERT INTO ice.demo.events SELECT event_id, user_id, country, amount, dt FROM {RAW} WHERE dt = DATE '2026-10-11'")

try:
    con.execute("ALTER TABLE ice.demo.events ADD COLUMN channel VARCHAR")
    con.execute(f"INSERT INTO ice.demo.events SELECT event_id, user_id, country, amount, dt, channel FROM {RAW} WHERE dt = DATE '2026-10-12'")
    print("ADD COLUMN: да")
except duckdb.Error as e:
    print("ADD COLUMN:", type(e).__name__, str(e).splitlines()[0][:200])
    con.execute(f"INSERT INTO ice.demo.events SELECT event_id, user_id, country, amount, dt FROM {RAW} WHERE dt = DATE '2026-10-12'")
con.execute("DELETE FROM ice.demo.events WHERE dt = DATE '2026-10-01' AND country = 'DE'")

snaps = con.sql("""
    SELECT sequence_number, snapshot_id, operation,
           summary['added-records'], summary['total-records']
    FROM iceberg_snapshots(ice.demo.events) ORDER BY 1
""").fetchall()
print("снапшоты:")
for seq, sid, op, added, total in snaps:
    print(f"  {seq}: {op}, добавлено {added}, всего {total} (id {sid})")

print("строк сейчас:", con.sql("SELECT count(*) FROM ice.demo.events").fetchall()[0][0])
# time travel по id снапшота
first = snaps[0][1]
try:
    print("строк AT (VERSION => первый):", con.sql(f"SELECT count(*) FROM ice.demo.events AT (VERSION => {first})").fetchall()[0][0])
except duckdb.Error as e:
    print("time travel:", type(e).__name__, str(e).splitlines()[0][:200])

# REST-каталог отдаёт любому движку только указатель на текущий metadata.json
with urllib.request.urlopen("http://127.0.0.1:8181/v1/namespaces/demo/tables/events") as r:
    print("REST metadata-location:", json.load(r)["metadata-location"])

objs = list(s3.Bucket("lake").objects.filter(Prefix="iceberg/demo/events/"))
for kind in ("metadata", "data"):
    part = [o for o in objs if f"/events/{kind}/" in o.key]
    print(f"{kind}/: {len(part)} файлов, {sum(o.size for o in part) / 1024:.0f} КБ")
ADD COLUMN: да
снапшоты:
  1: append, добавлено 2000000, всего 2000000 (id 7833041528442145357)
  2: append, добавлено 200000, всего 2200000 (id 848494574479033886)
  3: append, добавлено 200000, всего 2400000 (id 9084207296381994153)
  4: delete, добавлено None, всего 2400000 (id 227916775569835121)
строк сейчас: 2371428
строк AT (VERSION => первый): 2000000
REST metadata-location: s3://lake/iceberg/demo/events/metadata/00004-007c94be-67b2-4527-a235-18ef6d484e7d.metadata.json
metadata/: 13 файлов, 35 КБ
data/: 4 файлов, 12988 КБ
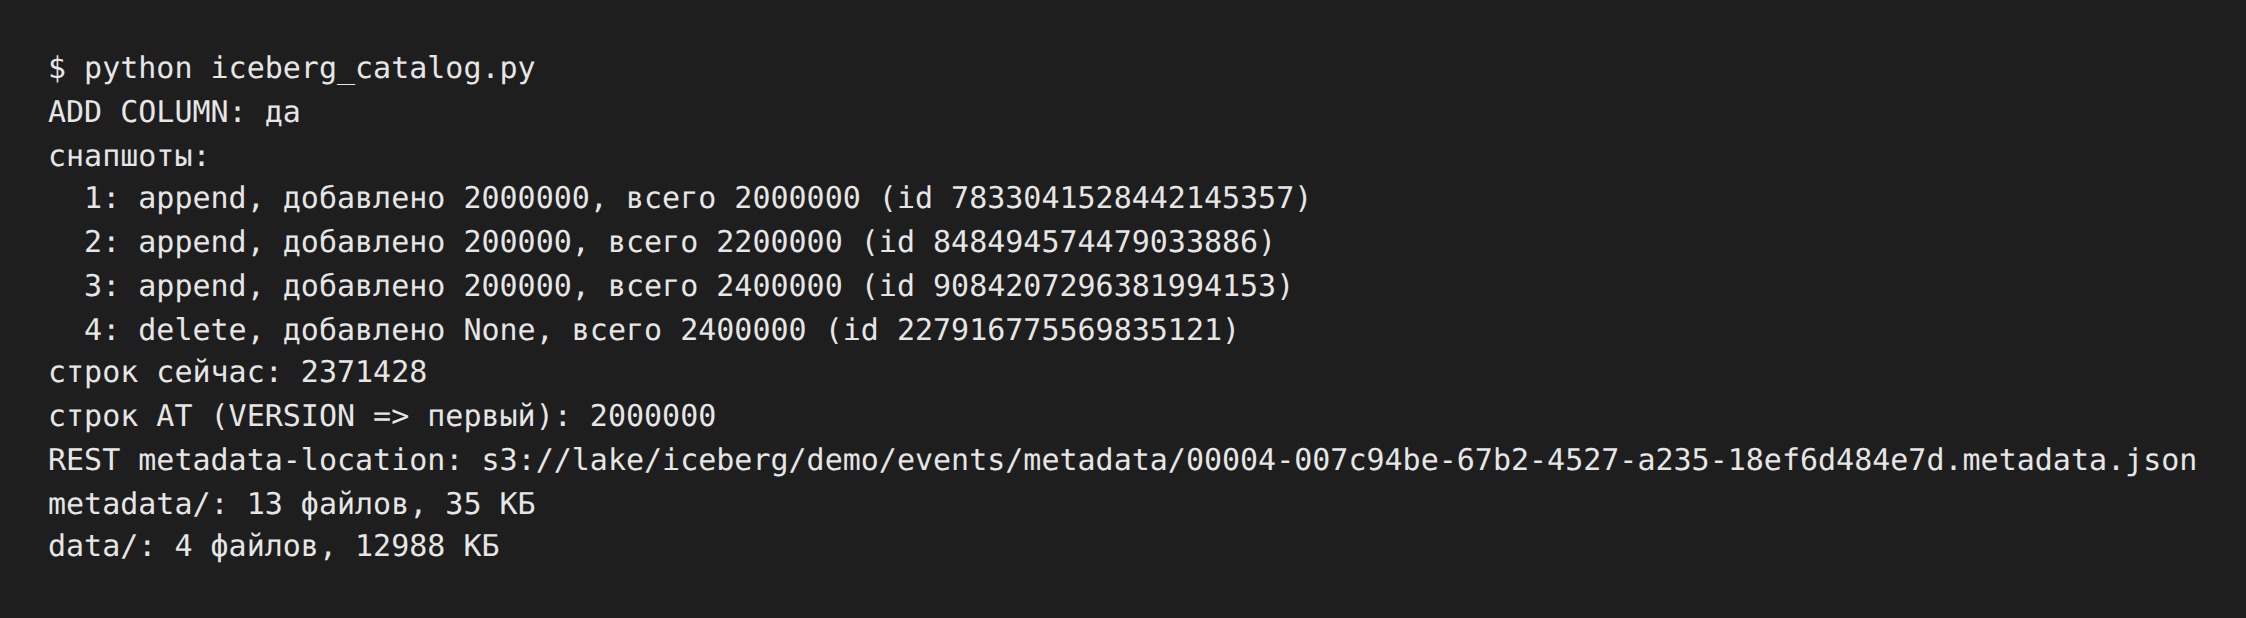
Число строк совпало с DuckLake до единицы, 2 371 428. Снапшотов четыре, потому что создание пустой схемы и ALTER TABLE в Iceberg снапшотов не дают. В строке delete итог остался 2 400 000, так как total-records считает строки в файлах данных, а удалённые строки лежат в отдельных файлах удалений. Пять операций оставили в metadata/ 13 файлов на 35 КБ.
Рост метаданных после 50 дозаписей
Мелкие частые дозаписи это обычная жизнь озера, куда пишут потоковые конвейеры. Скрипт metadata_growth.py делает 50 вставок по 1000 строк в пустые таблицы DuckLake и Iceberg с одинаковым кодеком, считает файлы в S3 и время полного скана, а затем запускает доступное из DuckDB обслуживание.
# duckdb 2.0.0 + ducklake (формат 1.1, SQLite) + iceberg (REST fixture 1.10.1), SeaweedFS 4.48, прогнано на стенде 2026-10-22
"""50 мелких дозаписей по 1000 строк в DuckLake и Iceberg: что растёт и что чистит обслуживание.

Запуск: python metadata_growth.py
"""
import time
from pathlib import Path

import boto3
import duckdb

APPENDS, ROWS = 50, 1000
META = Path("work/growth.sqlite")
s3 = boto3.client("s3", endpoint_url="http://127.0.0.1:8333", region_name="us-east-1",
                  aws_access_key_id="admin", aws_secret_access_key="password123")


def objects(prefix: str) -> list:
    pages = s3.get_paginator("list_objects_v2").paginate(Bucket="lake", Prefix=prefix)
    return [o for page in pages for o in page.get("Contents", [])]


def report(label: str, con: duckdb.DuckDBPyConnection) -> None:
    dl = objects("ducklake_growth/")
    ice = objects("iceberg/demo/growth/")
    ice_meta = [o for o in ice if "/metadata/" in o["Key"]]
    ice_data = [o for o in ice if "/data/" in o["Key"]]
    dl_snaps = con.sql("SELECT count(*) FROM ducklake_snapshots('dl')").fetchall()[0][0]
    ice_snaps = con.sql("SELECT count(*) FROM iceberg_snapshots(ice.demo.growth)").fetchall()[0][0]
    print(f"--- {label}")
    print(f"  DuckLake: Parquet в S3 {len(dl)} файлов, {sum(o['Size'] for o in dl) / 1024:.0f} КБ; "
          f"SQLite {META.stat().st_size / 1024:.0f} КБ; снапшотов {dl_snaps}")
    print(f"  Iceberg:  data/ {len(ice_data)} файлов, {sum(o['Size'] for o in ice_data) / 1024:.0f} КБ; "
          f"metadata/ {len(ice_meta)} файлов, {sum(o['Size'] for o in ice_meta) / 1024:.0f} КБ; снапшотов {ice_snaps}")
    for table in ("dl.growth", "ice.demo.growth"):
        t = time.time()
        n = con.sql(f"SELECT count(*), sum(amount) FROM {table}").fetchall()[0][0]
        print(f"  {table}: {n} строк, полный скан {time.time() - t:.2f} с")


META.parent.mkdir(exist_ok=True)
META.unlink(missing_ok=True)
for o in objects("ducklake_growth/"):
    s3.delete_object(Bucket="lake", Key=o["Key"])

con = duckdb.connect()
con.execute("""
    CREATE SECRET s3 (TYPE s3, KEY_ID 'admin', SECRET 'password123',
        ENDPOINT '127.0.0.1:8333', URL_STYLE 'path', USE_SSL false, REGION 'us-east-1')
""")
con.execute(f"ATTACH 'ducklake:sqlite:{META}' AS dl (DATA_PATH 's3://lake/ducklake_growth/')")
con.execute("ATTACH 'warehouse' AS ice (TYPE iceberg, ENDPOINT 'http://127.0.0.1:8181', AUTHORIZATION_TYPE 'none')")
con.execute("CREATE SCHEMA IF NOT EXISTS ice.demo")
con.execute("DROP TABLE IF EXISTS ice.demo.growth")
# DROP в REST fixture не удаляет файлы: чистим префикс сами, иначе счёт пойдёт по прошлым прогонам
for o in objects("iceberg/demo/growth/"):
    s3.delete_object(Bucket="lake", Key=o["Key"])
schema = "(event_id BIGINT, user_id BIGINT, country VARCHAR, amount DOUBLE)"
con.execute(f"CREATE TABLE dl.growth {schema}")
# Iceberg по умолчанию пишет Parquet в ZSTD, DuckLake в SNAPPY: выравниваем, чтобы сравнивать метаданные, а не кодек
con.execute("CALL dl.set_option('parquet_compression', 'zstd')")
con.execute(f"CREATE TABLE ice.demo.growth {schema}")

batch = f"SELECT i, (hash(i) % 50000)::BIGINT, 'DE', (i % 1000) / 10 FROM range({{n}} * {ROWS}, ({{n}} + 1) * {ROWS}) t(i)"
for table in ("dl.growth", "ice.demo.growth"):
    t = time.time()
    # каждая дозапись это отдельная транзакция и отдельный снапшот
    for n in range(APPENDS):
        con.execute(f"INSERT INTO {table} {batch.format(n=n)}")
    print(f"{table}: {APPENDS} INSERT по {ROWS} строк за {time.time() - t:.1f} с")

report(f"после {APPENDS} дозаписей", con)

# обслуживание DuckLake: склеить мелкие файлы, забыть старые снапшоты, удалить ненужное
for sql in ("CALL ducklake_merge_adjacent_files('dl')",
            "CALL ducklake_expire_snapshots('dl', older_than => now())",
            "CALL ducklake_cleanup_old_files('dl', cleanup_all => true)"):
    try:
        con.execute(sql)
        print("ok:", sql)
    except duckdb.Error as e:
        print("ошибка:", sql, "->", str(e).splitlines()[0][:200])
# у Iceberg в DuckDB есть только перезапись файлов данных, снапшоты и старые файлы чистит движок с полным API
try:
    con.execute("CALL iceberg_rewrite_data_files(ice.demo.growth)")
    print("ok: iceberg_rewrite_data_files")
except duckdb.Error as e:
    print("ошибка: iceberg_rewrite_data_files ->", str(e).splitlines()[0][:200])

report("после обслуживания", con)
dl.growth: 50 INSERT по 1000 строк за 4.3 с
ice.demo.growth: 50 INSERT по 1000 строк за 8.7 с
--- после 50 дозаписей
  DuckLake: Parquet в S3 50 файлов, 268 КБ; SQLite 168 КБ; снапшотов 52
  Iceberg:  data/ 50 файлов, 268 КБ; metadata/ 151 файлов, 1313 КБ; снапшотов 50
  dl.growth: 50000 строк, полный скан 0.06 с
  ice.demo.growth: 50000 строк, полный скан 0.09 с
ok: CALL ducklake_merge_adjacent_files('dl')
ok: CALL ducklake_expire_snapshots('dl', older_than => now())
ok: CALL ducklake_cleanup_old_files('dl', cleanup_all => true)
ok: iceberg_rewrite_data_files
--- после обслуживания
  DuckLake: Parquet в S3 1 файлов, 294 КБ; SQLite 168 КБ; снапшотов 1
  Iceberg:  data/ 51 файлов, 460 КБ; metadata/ 204 файлов, 1522 КБ; снапшотов 51
  dl.growth: 50000 строк, полный скан 0.05 с
  ice.demo.growth: 50000 строк, полный скан 0.10 с
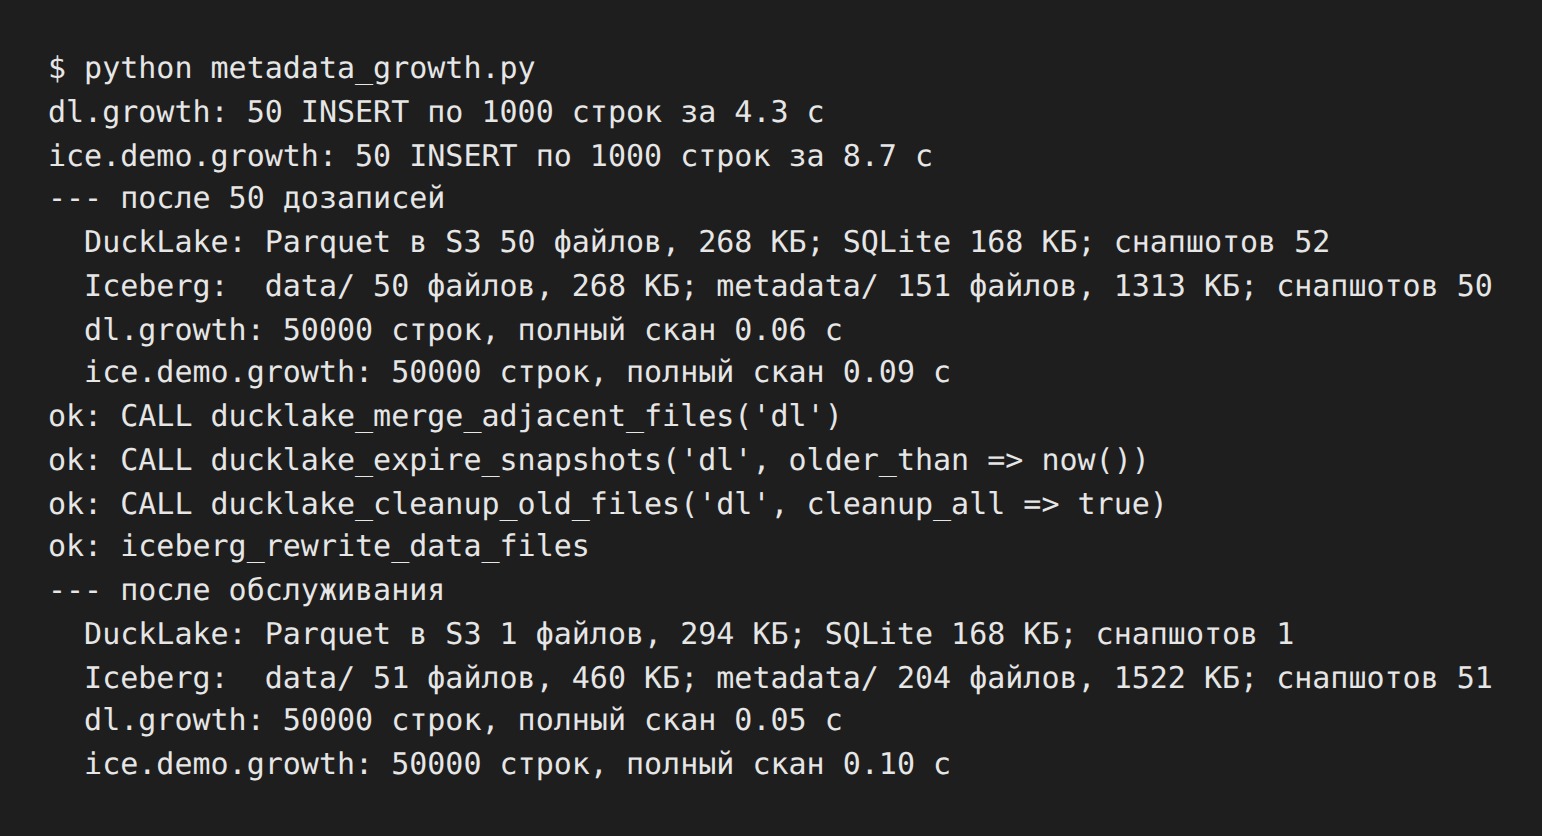
Файлов данных у обоих форматов по 50, и весят они одинаково, по 268 КБ. Разница в метаданных. Iceberg на каждый коммит кладёт в S3 около трёх файлов, а именно новый metadata.json, список манифестов и манифест, и за 50 дозаписей набрал 151 файл на 1313 КБ. DuckLake не положил в S3 ни одного файла метаданных, его SQLite весит 168 КБ. Вставки в DuckLake шли вдвое быстрее, 4.3 с против 8.7 с, хотя REST-каталог стоял на той же машине.
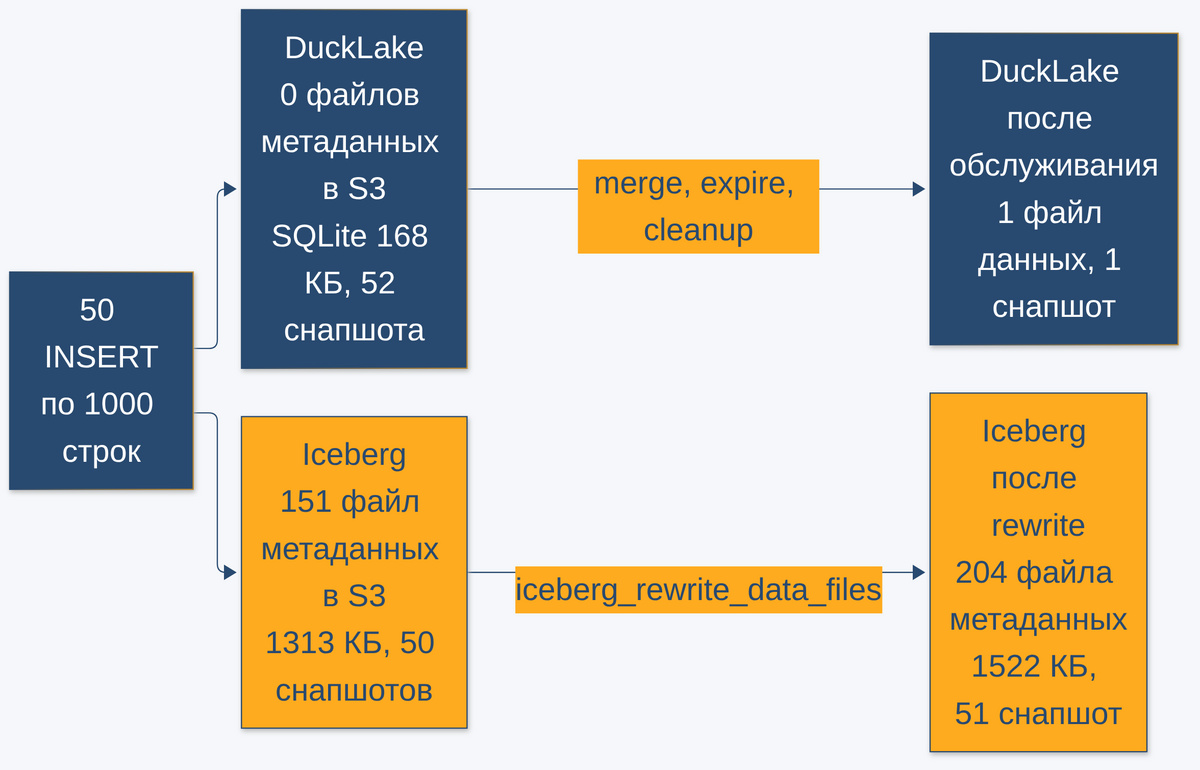
Обслуживание разошлось ещё сильнее. Три вызова DuckLake склеили 50 файлов в один, удалили старые снапшоты и файлы. Для Iceberg в DuckDB есть только перезапись файлов данных. Она добавила новый файл и новый снапшот, но старые файлы и снапшоты остались, и после такого обслуживания каталог metadata/ вырос до 204 файлов. Истечение снапшотов для Iceberg придётся запускать из Spark или другого движка с полным набором процедур.
Высокопроизводительная обработка данных на Python
Код курса
HPPY
Ближайшая дата курса
16 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Ограничения и подводные камни
Часть ограничений стенд нашёл сам, часть следует из документации.
- Смена схемы в представлениях. Новая колонка не видна без union_by_name, и об этом никто не сообщает. Параметр union_by_name объединяет схемы файлов по именам колонок, но вариант представления с ним на стенде мы не прогоняли.
- DuckDB 2.0 ломает старый код. У результата con.sql больше нет метода fetchone, а после con.execute результат нужно дочитать до конца, иначе следующий запрос падает с ResourceInUseException. Скрипты под 1.x придётся поправить.
- Типы Iceberg. Беззнаковых целых в Iceberg нет, поэтому UBIGINT из функций DuckDB нужно приводить к BIGINT до записи.
- Тестовый REST-каталог. iceberg-rest-fixture теряет каталог при перезапуске и не удаляет файлы при DROP. Для продакшна нужен настоящий REST-каталог.
- Обслуживание Iceberg из DuckDB. Есть только iceberg_rewrite_data_files, истечения снапшотов и удаления старых файлов нет. На стенде после такого обслуживания metadata/ выросла со 151 до 204 файлов.
- Конкурентная запись в SQLite. Документация DuckLake допускает одного писателя с повтором, а две серии по 20 вставок без ошибок не доказывают работу под нагрузкой. Для команды нужен PostgreSQL.
- Разные настройки по умолчанию. DuckLake пишет Parquet в SNAPPY, Iceberg в ZSTD, и на одних данных это 29.9 МБ против 13 МБ. Сравнивать объёмы без выравнивания кодека нельзя.
- DuckLake вне DuckDB. Метаданные открыты как обычные SQL-таблицы, но читателей формата кроме DuckDB мы не проверяли. Перед выбором DuckLake для смешанного стека это стоит проверить на своих движках.
Ни одно из ограничений не делает инструмент плохим, но каждое меняет ответ на вопрос, кому он подходит.
Что выбрать
Файл с представлениями подходит команде, которая хочет дать аналитикам общие имена над уже готовым озером и не готова поднимать ещё один сервис. Условие одно, схема файлов должна меняться редко и под контролем того же человека, который пересобирает каталог. DuckLake стоит брать, когда озеро пишут и читают в основном из DuckDB, нужны транзакции, история и частые мелкие записи, а для команды есть PostgreSQL под метаданные. Iceberg с REST-каталогом нужен, когда к тем же таблицам ходят Spark, Trino или Flink и переносимость важнее компактных метаданных. Глубже поработать с DuckDB, Parquet и производительностью Python можно на курсе высокопроизводительной обработки данных на Python, а живой пример DuckDB над Parquet есть в статье о наборе данных в Parquet и DuckDB.
Заключение
Каталог озера данных на DuckDB можно собрать за минуту из одного файла с представлениями, и для чтения стабильного озера этого хватает. Стенд показал, где кончается приём. Новая колонка пропадает молча, а снапшотов и транзакций нет. DuckLake закрывает эти места и держит метаданные в SQL-базе компактнее Iceberg, а Iceberg платит россыпью файлов в S3 за то, что его понимает весь стек.