3
Содержание
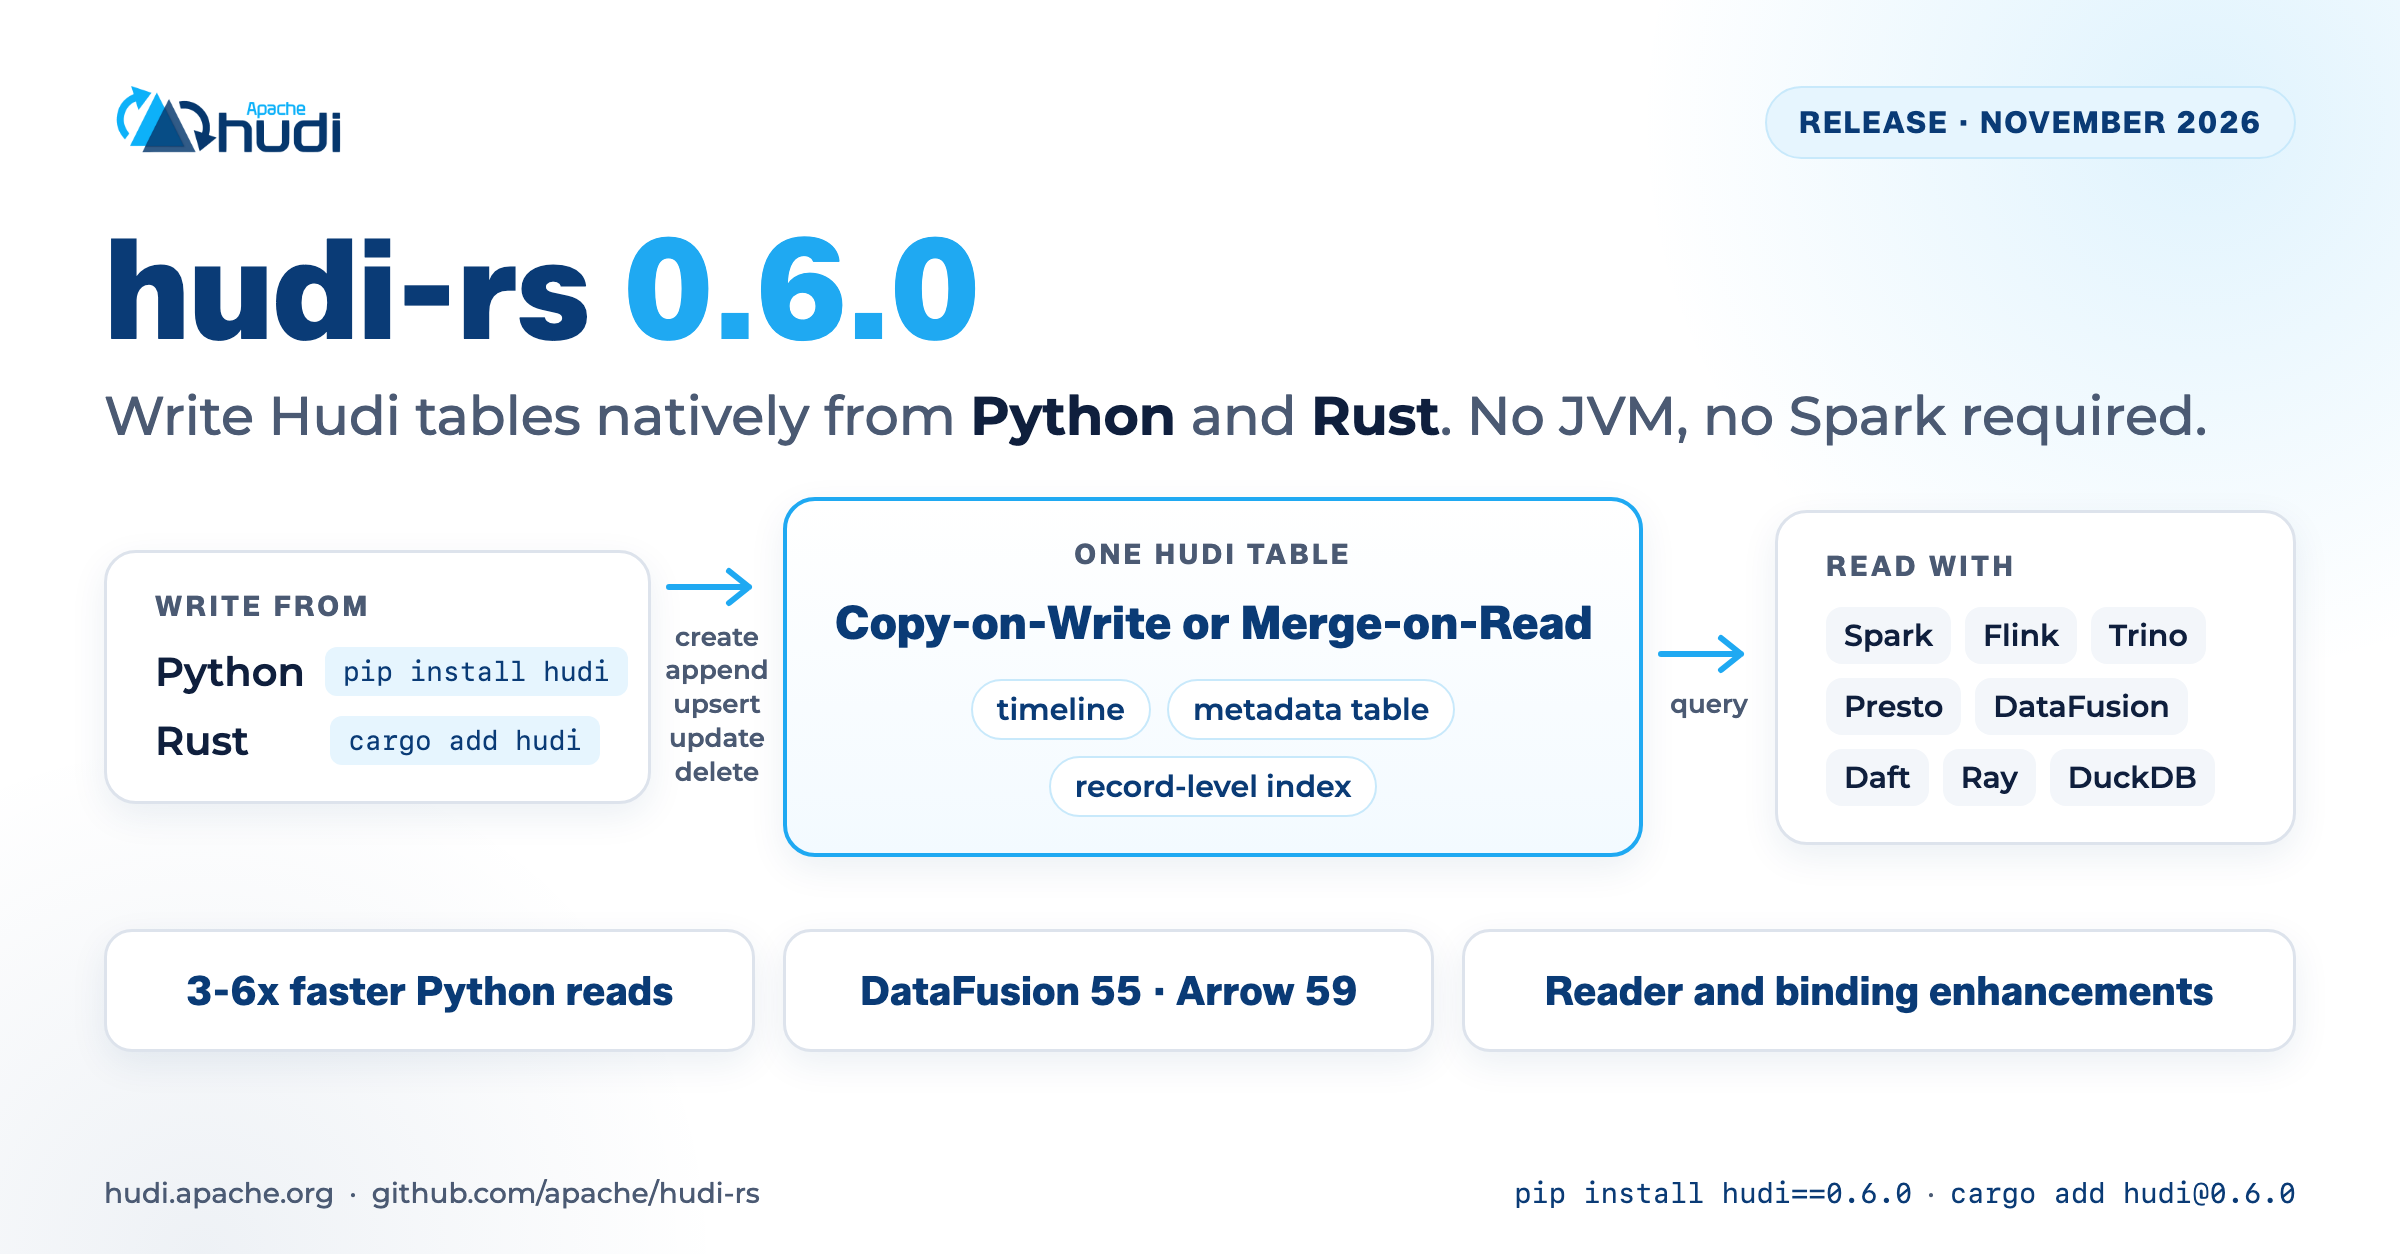
Релиз hudi-rs 0.6.0 приносит нативную поддержку записи в таблицы Hudi прямо из Rust и Python без JVM. Инженеры теперь могут создавать, дополнять, обновлять и удалять строки из обычных скриптов и сервисов, а результат остается полноценной таблицей Hudi, которую читают Spark, Flink и Trino. Это меняет подход к пайплайнам, где раньше приходилось поднимать кластер только ради небольших изменений.
Возможности записи без кластера
Теперь доступны операции create, append, upsert, update, delete и overwrite на Copy-on-Write и Merge-on-Read таблицах. Copy-on-Write хранит версии данных путем копирования файлов при изменении, а Merge-on-Read позволяет быстрее записывать изменения в отдельные файлы дельт, объединяя их при чтении. Записи работают с составными ключами и целочисленными идентификаторами, поддерживают частичные обновления и удаление по предикату или списку ключей. Каждая операция фиксируется атомарно в timeline Hudi — журнале событий, где фиксируются все коммиты, метаданные обновляются автоматически, а при сбое происходит откат к последнему согласованному состоянию.
Инженер может начать работу на ноутбуке, а при росте объема передать таблицу Spark для компакшена и кластеризации. При этом hudi-rs продолжает читать и дописывать небольшие батчи. Сериализация писателей внутри процесса требует, чтобы к одной таблице в один момент обращался только один движок. Это ограничение важно учитывать при планировании: если пайплайн предполагает одновременные записи из нескольких независимых сервисов, придется организовать очередь или координацию, иначе возможны конфликты и потеря данных.
Скорость и сценарии использования
Upsert и delete занимают меньше секунды на одной машине даже при миллионах строк благодаря record-level индексу, который позволяет быстро находить нужные записи без полного сканирования файлов. Это подходит для пайплайнов, где нужно поддерживать актуальность базы знаний, править примеры для файн-тюнинга или исправлять ошибки в данных сервисом.
Бенчмарки показывают преимущество перед другими библиотеками lakehouse для Python при точечных изменениях. Чтение из Python тоже ускорили, а интеграцию с DataFusion подняли до версии 55 и Arrow до 59. Запросы через HudiQueryType и HudiReadOptions работают с PyArrow, Polars и pandas 2.2+ без дополнительных зависимостей. Для команд, решающих, стоит ли внедрять инструмент, важно понимать, что выигрыш в скорости проявляется именно при небольших и средних объемах изменений, а не при массовой пакетной обработке, где кластерные решения могут оказаться эффективнее.
Совместимость и ограничения
Таблицы, созданные hudi-rs, читаются всеми движками, поддерживающими Hudi, с сохранением метаданных и индексов. Однако одновременная запись из двух разных процессов в одну таблицу не поддерживается. При переходе с JVM-решений нужно проверить, что пайплайн не требует параллельных записей от нескольких сервисов одновременно. Это ограничение может стать критичным для распределенных систем, где несколько микросервисов обновляют данные в реальном времени; в таких случаях придется либо использовать один координирующий процесс, либо оставить часть нагрузки на Spark или Flink.
В российском контуре это особенно полезно командам, которые уже используют Spark и Flink на собственных кластерах, но хотят убрать JVM из легких Python-сервисов и агентов. Отсутствие облачных зависимостей упрощает развертывание в закрытых сетях, однако инженерам придется самостоятельно планировать масштабирование и компакшен при росте данных. Перед выбором стоит оценить, насколько часто будут возникать ситуации с необходимостью параллельной записи и есть ли ресурсы на ручное управление ростом таблиц.
Что учитывать перед обновлением
Если текущие пайплайны опираются на Spark для всех записей, то hudi-rs 0.6.0 дает возможность вынести мелкие обновления в отдельные процессы и снизить нагрузку на кластер. При этом нужно добавить проверку сериализации писателей и протестировать откат при сбоях. Такая гибкость полезна, когда команда стремится минимизировать затраты на инфраструктуру и ускорить итерации в разработке, но требует дополнительного мониторинга за состоянием таблиц.
Для команд, работающих с DuckDB или DataFusion, релиз упрощает построение end-to-end решений без переключения контекста. Перед внедрением стоит измерить реальную скорость upsert на своих объемах и убедиться, что single-node ограничение не станет узким местом при пиковых нагрузках. В итоге решение о переходе зависит от того, преобладают ли в нагрузке небольшие инкрементальные изменения и готова ли команда взять на себя управление компакшеном и масштабированием без облачных инструментов.
Источник
Это краткий разбор материала Apache Hudi. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Hudi-rs 0.6.0 добавил запись таблиц из Rust и Python.
Курс по теме — Каталог курсов Школы Больших Данных