
В уроке 13 мы разбирались с kafka-metadata-shell.sh - интерактивным шеллом для чтения содержимого KRaft-метаданных. Если вы там заходили в директорию /features/ и видели там metadata.version с каким-то числом - это как раз то, чем управляет утилита сегодняшнего урока. kafka-features.sh отвечает за управление feature-флагами кластера. Звучит абстрактно, но на практике...
В уроке 12 мы разобрали kafka-metadata-quorum.sh - как смотреть состояние кворума KRaft, кто сейчас лидер контроллера и насколько отстают фолловеры. Это взгляд на кворум снаружи: числа, статусы, смещения. Но иногда нужно заглянуть внутрь - буквально открыть метаданные кластера и посмотреть, что там хранится. Для этого в Apache Kafka есть...
В уроке 11 мы разобрали kafka-cluster.sh - как получить cluster ID от работающего брокера и как корректно вывести брокер из KRaft-кластера через команду unregister. После вывода брокера логично проверить, что кворум не пострадал и кластер продолжает работать нормально. Именно для этого существует утилита следующего урока. kafka-metadata-quorum.sh - инструмент для...
В уроке 10 мы разобрали kafka-storage.sh - утилиту, которая работает с хранилищем метаданных напрямую через файловую систему. Она генерирует cluster ID, форматирует директорию и записывает meta.properties. Но всё это происходит в оффлайне - до старта брокера. Теперь представьте обратную ситуацию: кластер уже запущен и работает, и вам нужно узнать его...
В уроке 9 мы разобрали kafka-server-start.sh и kafka-server-stop.sh - как запускать брокер в foreground и daemon-режиме, какие переменные окружения влияют на JVM и как правильно останавливать процесс без потери данных. Но прежде чем брокер вообще сможет стартовать в KRaft-режиме, нужно сделать один обязательный шаг - отформатировать хранилище метаданных. Этот...
В уроке 8 мы разобрали kafka-console-consumer.sh - как читать сообщения из топика, управлять смещениями и фильтровать данные по партициям. Теперь сделаем шаг назад и посмотрим на кое-что фундаментальное: как именно запускается и останавливается сам брокер Kafka. Казалось бы, вопрос очевидный - мы уже запускали Kafka в уроках 2-4. Но...
В прошлом уроке мы научились отправлять сообщения через kafka-console-producer.sh: вводить строки вручную, работать с ключами и загружать данные из файла. Теперь нужно научиться их читать. За это отвечает kafka-console-consumer.sh - стандартная утилита для чтения сообщений из топика прямо в терминале. Это инструмент из той же категории «быстро проверить»: подключился,...
В предыдущем уроке мы научились работать с топиками через kafka-topics.sh: создавали, описывали, меняли настройки и удаляли. Теперь у нас есть готовый топик, и логичный следующий вопрос - как туда что-нибудь положить. Именно этим занимается kafka-console-producer.sh. Это утилита для ручной отправки сообщений в топик прямо из терминала. Незаменима для быстрых...
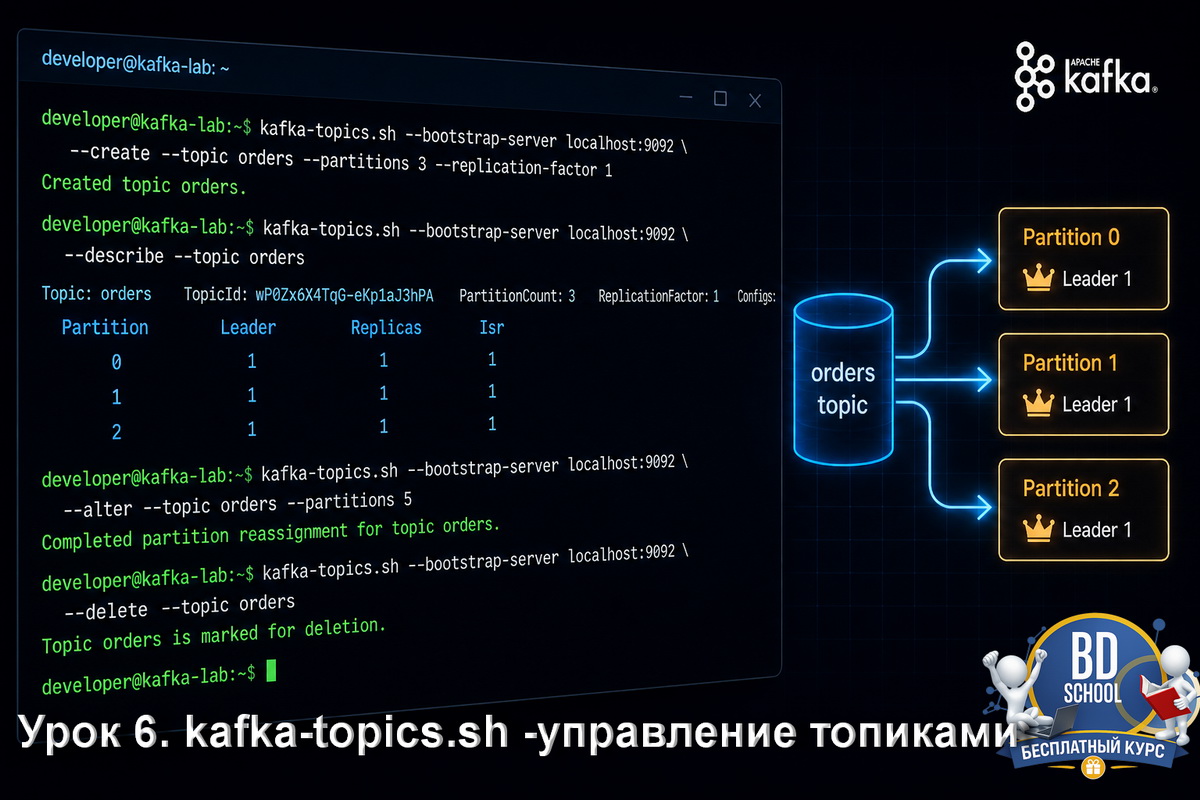
Изучаем Apache Kafka с нуля. Урок 6. kafka-topics.sh - Управление топиками ПО: Apache Kafka 4.2.0, KRaft-режим | Окружение: Ubuntu 22.04 LTS / macOS 14+ | Уровень: начинающий+ В прошлом уроке мы разобрались с переменными окружения, алиасами и базовой структурой каталога $KAFKA_HOME/bin/. Теперь умеем запускать утилиты из любой директории и понимаем...
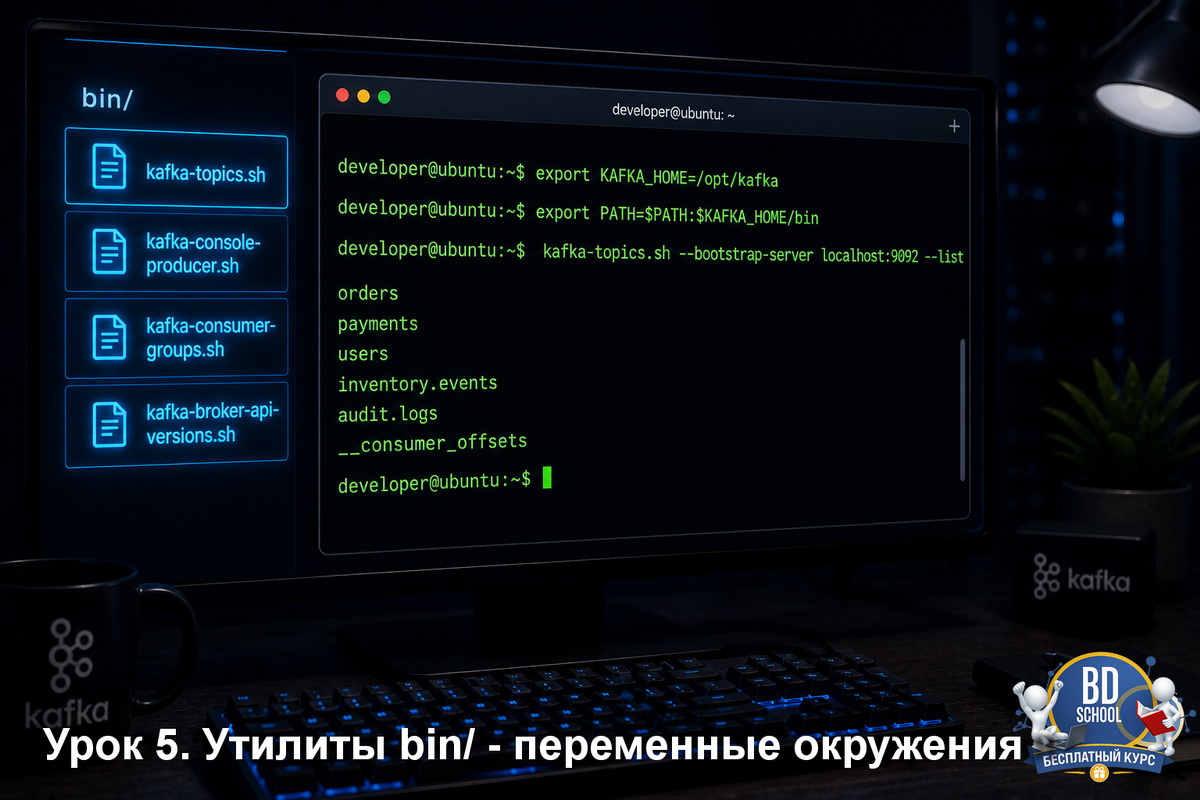
Изучаем Apache Kafka с нуля. Урок 5. Утилиты Kafka bin/ - переменные окружения и основы ПО: Apache Kafka 4.2.0 | Окружение: Ubuntu 22.04 LTS, Java 17 | Уровень: начинающий В четвёртом уроке мы собрали трёхнодовый Kafka-кластер в Docker Compose. Для проверки его работы запускали команды через docker exec и прописывали...
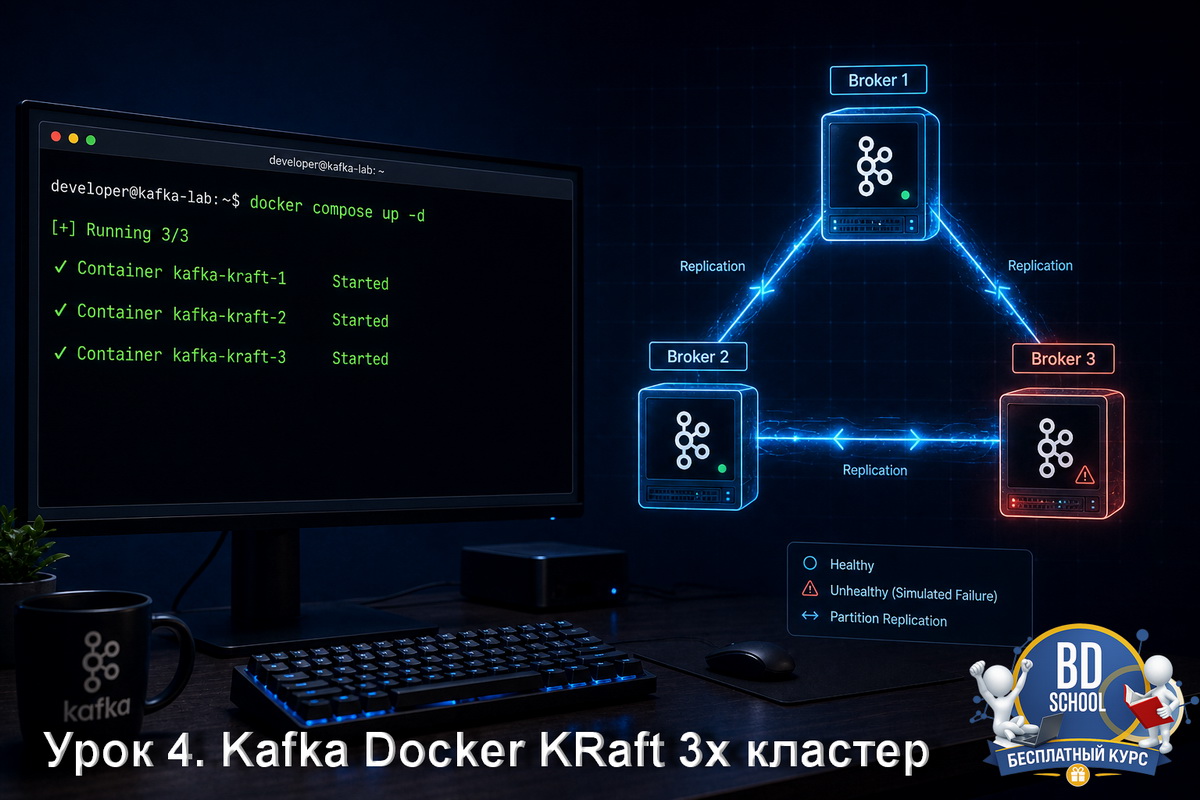
Изучаем Apache Kafka с нуля. Урок 4. Kafka Docker KRaft 3х узловый кластер ПО: Apache Kafka 4.2.0 (образ apache/kafka:4.2.0) | Docker: Engine 28.1, Compose v2.35 | Окружение: Ubuntu 22.04 LTS / macOS 14+ | Уровень: начинающий+ В прошлом уроке мы подняли один брокер Kafka в Docker за несколько...
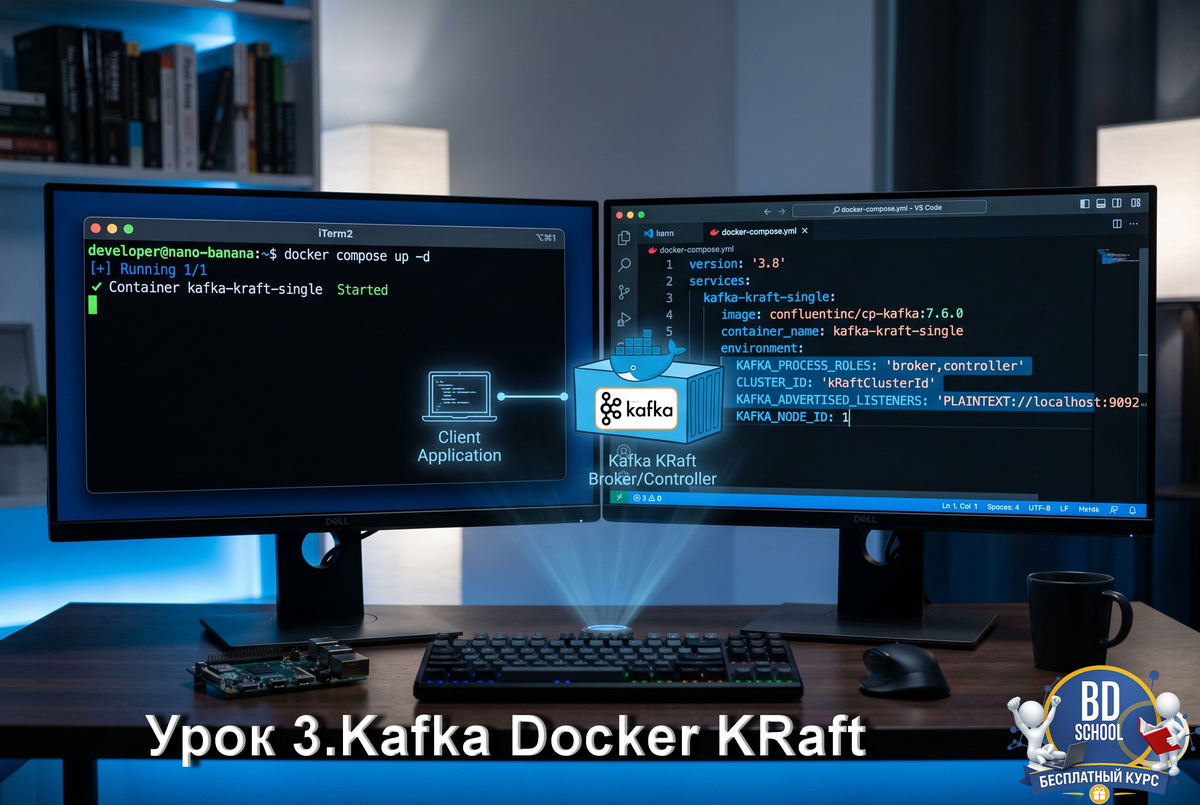
Изучаем Apache Kafka с нуля. Урок 3. Kafka Docker KRaft. Однонодовый кластер ПО: Apache Kafka 4.2.0 (образ apache/kafka:4.2.0) Docker: Engine 28.1, Compose v2.35 \ Окружение: Ubuntu 22.04 LTS / macOS 14+ Уровень: начинающий В прошлом уроке мы установили Apache Kafka 4.2.0 вручную прямо на хост. Получилось рабочее окружение, но...
До этого момента все наши DAG-и жили по расписанию. schedule_interval='@daily' - это классика. Но современный бизнес не хочет ждать "утреннего отчета". Если данные прилетели в 14:00, отчет должен быть готов в 14:10, а не на следующее утро. Здесь мы сталкиваемся с фундаментальным конфликтом: Airflow - это Batch-инструмент (запускает задачи...
Как управлять топиками Kafka: полное удаление, очистка и аварийные сценарии Apache Kafka — мощный инструмент, но без должного ухода он быстро "захламляется". Топики, которые вы создавали для тестов, старые проекты или просто логи, со временем начинают занимать место и мешать. А иногда они разрастаются так, что кластер "ложится"...
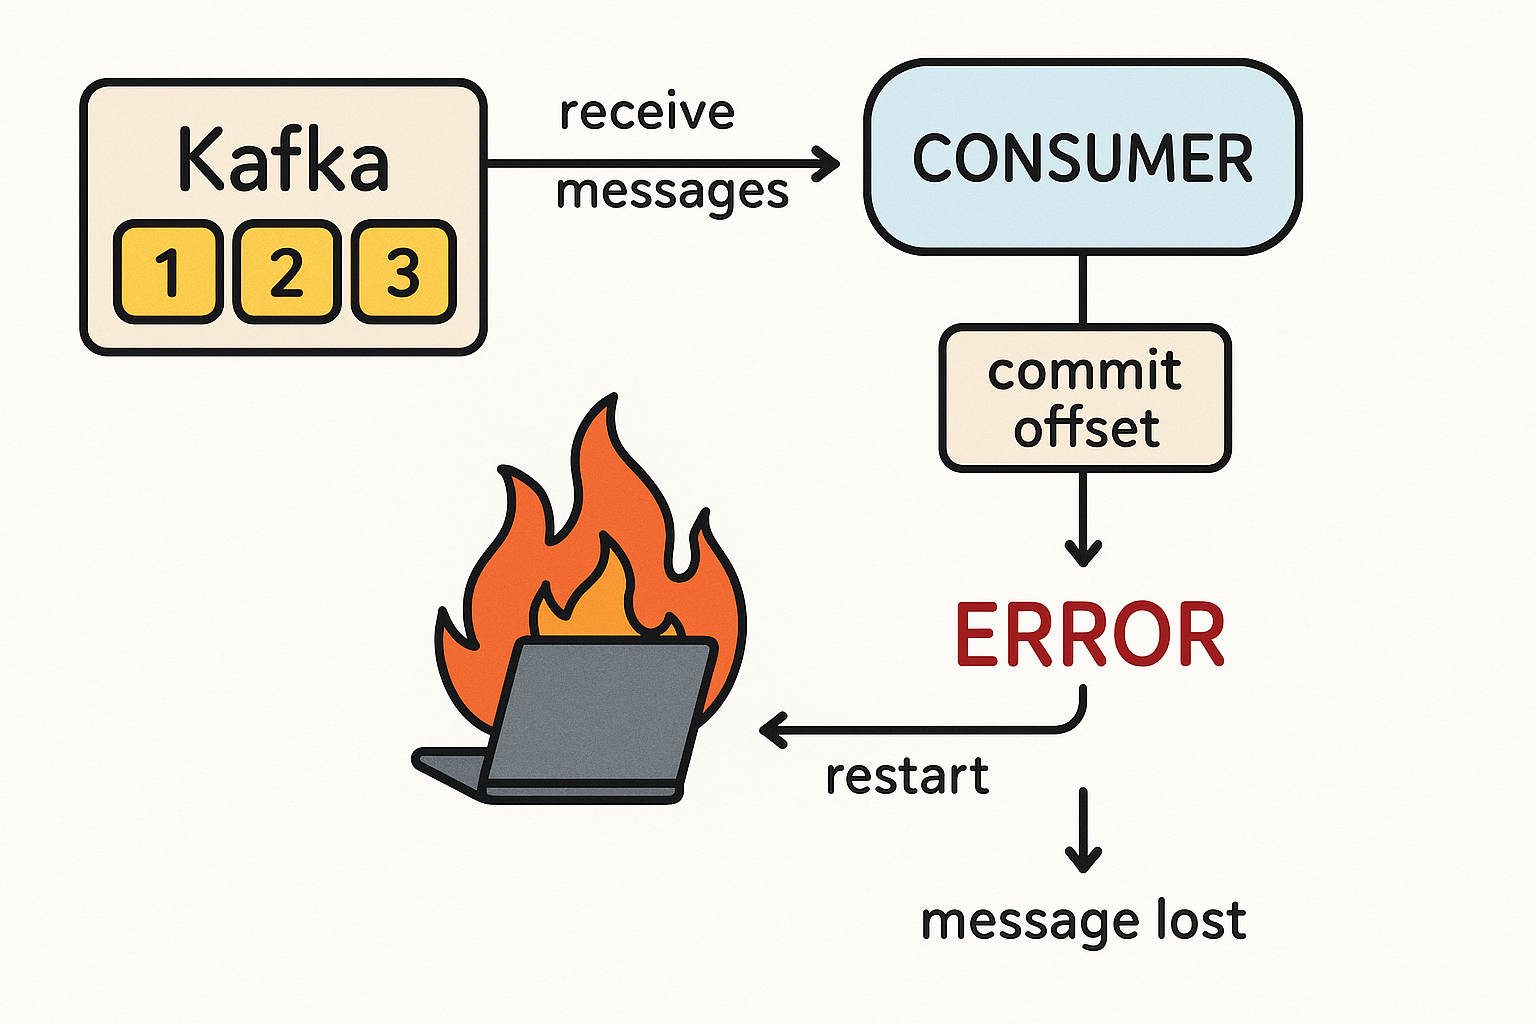
В мире распределенных систем, гарантии доставки сообщений, при передаче данных между сервисами — это фундаментальная задача. Но что происходит, когда мы отправляем сообщение из точки А в точку Б через сеть, которая по своей природе ненадежна? Сетевые задержки, сбои серверов, перезапуски приложений — все это может привести к потере или...
Почему провайдерам Kafka как сервиса недостаточно многоуровневого хранилища (KIP-405) и зачем они предложили новое улучшение KIP-1150, меняющее архитектуру хранения и репликации данных напрямую в объектные системы. Кому и зачем понадобилась бездисковая Kafka: что не так с KIP-405 Одной из наиболее интересных тем вокруг Apache Kafka в апреле 2025 года стало...
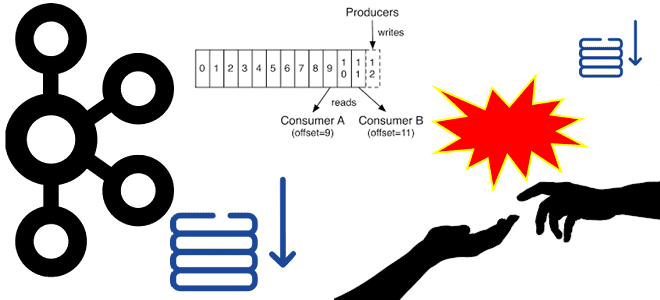
Когда и зачем фиксировать смещение потребителей Kafka вручную, с какими проблемами можно при этом столкнуться и как улучшение KIP-1094 обеспечивает целостность потоков данных в распределенных средах. Когда и зачем фиксировать смещения потребителей в Kafka вручную Недавно мы разбирали, как выполняется автоматическая фиксация смещений потребителей в Apache Kafka. Она выполняется периодически....
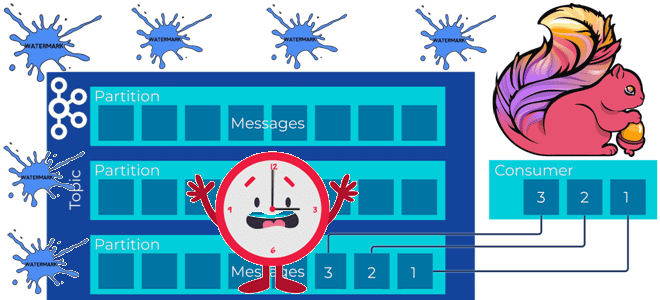
Почему задание Flink не обрабатывает потоковые данные из топика Kafka и при чем здесь водяные знаки: причины потери данных или растущей задержки вычислений и способы их решения. Почему задание Flink не обрабатывает потоковые данные и при чем здесь водяные знаки? Рассмотрим простой потоковый конвейер на Apache Flink и Kafka: задание...
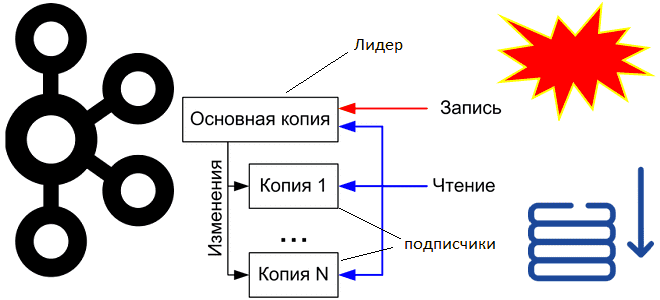
Как Apache Kafka обеспечивает упорядоченность сообщений в рамках раздела, где хранятся смещения потребителей и зачем их фиксировать вместе со эпохой брокера-лидера. Что такое смещения потребителей Apache Kafka и где они хранятся Асинхронная интеграция между информационными системами через Apache Kafka основана на смещениях потребителей – позиции сообщения в разделе топика. Раздел...
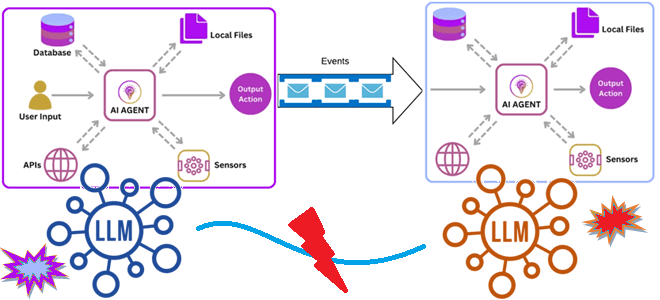
Как связать ИИ-агентов: событийно-ориентированная архитектура и потоковая передача событий для интеграции доменных LLM в мультиагентную систему. Зачем нужна интеграция ИИ-агентов О проблеме изоляции и рассинхронизации данных в корпоративных хранилищах мы уже писали здесь. Похожая ситуация наблюдается и при внедрении систем агентского ИИ, где большие языковые модели (LLM, Large Language Model)...