
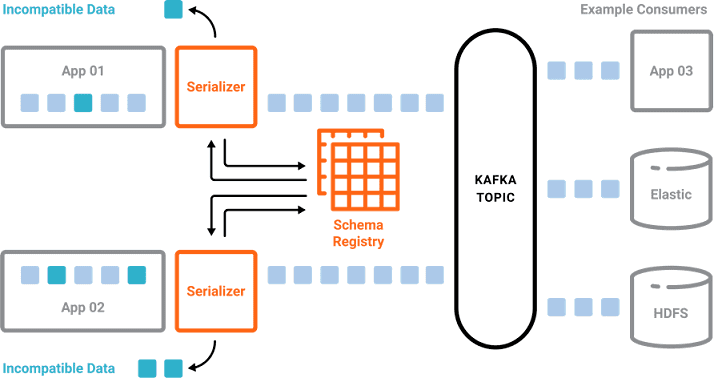
Продолжая серию публикаций про основы Apache Kafka для начинающих, в этой статье мы рассмотрим, зачем этой распределенной системе управления сообщениями нужен реестр схем данных (Schema Registry) и что такое сериализация файлов Big Data. Что такое схемы данных в Big Data и как они используются Понятие схемы неразрывно связано с форматом...
В рамках серии публикаций про основы Apache Kafka для начинающих, сегодня мы поговорим про информационную безопасность этой популярной в сфере Big Data распределенной системы управления сообщениями: шифрование, защищенные протоколы, аутентификация, авторизация и другие средства cybersecurity. Что обеспечивает безопасность Apache Kafka в кластере Big Data Информационная безопасность Apache Kafka основана на...
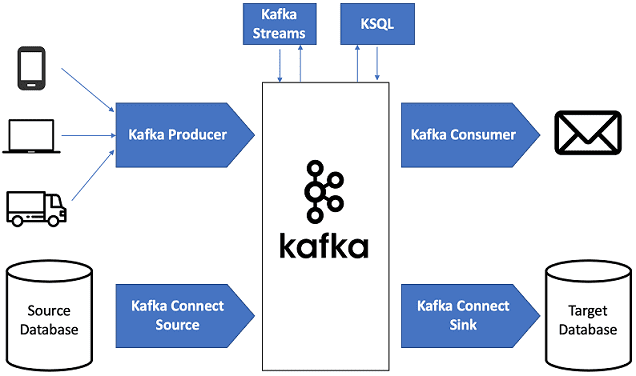
Продолжая разговор про основы Apache Kafka, сегодня мы рассмотрим, почему этот распределённый брокер сообщений стал таким популярным в архитектуре систем Big Data. Читайте в нашей статье, как Кафка обеспечивает высокую производительность процессов сбора и агрегации информационных потоков от множества источников, надежно гарантируя долговечную сохранность сообщений, и эффективно интегрируется с другими...
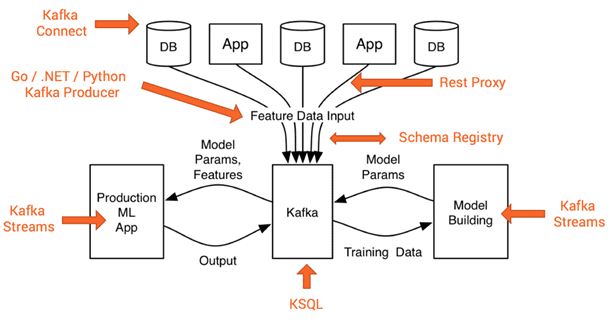
Рассмотрев основы Apache Kafka, сегодня мы расскажем о месте этого распределённого брокера сообщений в архитектуре Big Data систем. Читайте в нашей статье, какие компоненты Кафка обеспечивают ее использование в программных продуктах машинного обучения (Machine Learning, ML), интернете вещей (Internet Of Things, IoT), системах бизнес-аналитики (Business Intelligence, BI), а также других...
Мы уже упоминали Apache Kafka в статье про промышленный интернет вещей (Industrial Internet Of Things, IIoT). Сегодня поговорим о том, где и для чего еще в Big Data проектах используется эта распределённая, горизонтально масштабируемая система обработки сообщений. Как работает Apache Kafka Apache Kafka позволяет в режиме онлайн обеспечить сбор и...
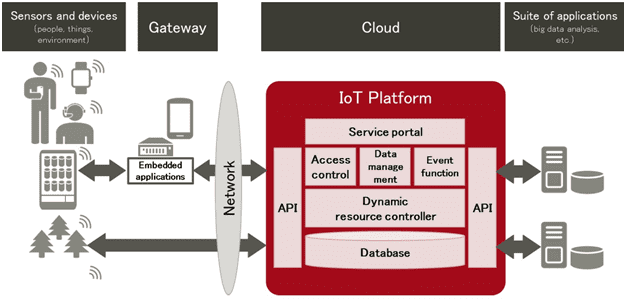
Рассматривая архитектуру и принципы работы IoT-систем, мы уже упоминали, что наиболее интеллектуальная часть работы по анализу данных выполняется в облаке с помощью специальных средств Big Data, объединенных в общую платформу. Сегодня поговорим о функциях IoT-платформ и технологиях, на которых основаны эти облачные решения. Также мы подготовили для вас краткий обзор...
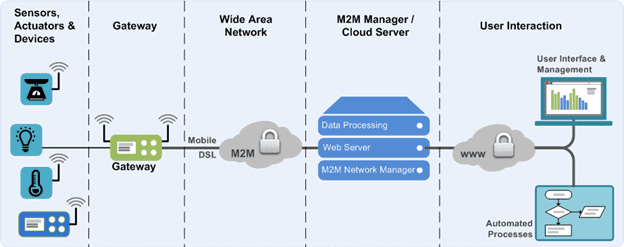
Мы уже немного рассказывали об архитектуре IoT-систем в статье про промышленный интернет вещей. Сегодня поговорим подробнее про аппаратные и программные компоненты Internet of Things и IIoT, а также разберем, как малые данные со множества датчиков преобразуются в Big Data. Архитектура IoT-системы Типовая архитектура IIoT-систем состоит из следующих 3-х уровней [1]:...
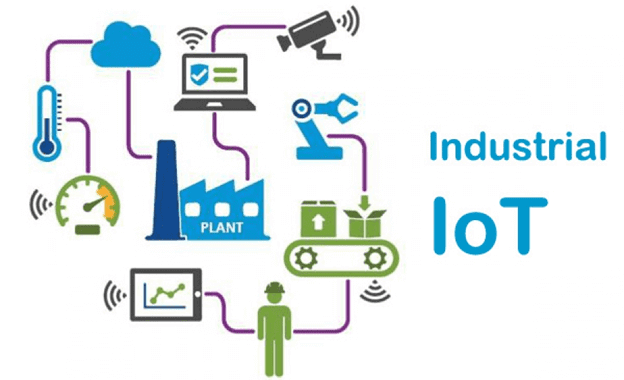
Мы уже рассказывали, как интернет вещей (Internet of Things, IoT) вместе с технологиями Big Data и машинного обучения (Machine Learning) используются в нефтегазовой, транспортной, сельскохозяйственной и машиностроительных отраслях. Сегодня поговорим подробнее про промышленный IoT (Industrial Internet of Things, IIoT) на примерах его применения в тяжелом машиностроении и рассмотрим, почему индустриальный...
Планируем рабочие процессы вместе с Apache Airflow Почему Apache Airflow? Большинство процессов обработки данных строятся на определении набора «задач» для извлечения, анализа, преобразования, загрузки и хранения данных. Например, последовательность обработки данных может состоять из таких задач, как чтение логов из S3, создание задания Spark для извлечения соответствующих объектов, индексирование объектов...
KSQL - это движок SQL с открытым исходным кодом для Apache Kafka. Он обеспечивает простой, но мощный интерактивный SQL интерфейс для потоковой обработки на Kafka, без необходимости писать код на языке программирования, таком как Java или Python. SELECT * FROM payments-kafka-stream WHERE fraud_probability > 0.8 ...