
 72

Содержание
- Что такое медальонная архитектура и зачем она нужна
- Архитектура и слои
- Bronze слой сырых данных
- Silver слой валидированных данных
- Gold слой обогащённых витрин
- Принцип работы медальонной архитектуры
- Инкрементальная загрузка и идемпотентность
- Контракт качества между слоями
- Медальон за пределами Databricks
- Ограничения и подводные камни
- Когда применять медальонную архитектуру, а когда не стоит
- Практика - демо Bronze, Silver и Gold на DuckDB
- Заключение
- Референсные ссылки
Медальонная архитектура (Medallion Architecture) — это паттерн организации данных в озере или хранилище через последовательность слоёв Bronze, Silver и Gold, где каждый следующий слой повышает качество и готовность данных к использованию. Термин ввела компания Databricks для описания собственного подхода к построению Lakehouse, но сам приём послойной инкрементальной очистки данных старше конкретной платформы и работает на самых разных движках.
Что такое медальонная архитектура и зачем она нужна
Формально медальонная архитектура относится к классу паттернов проектирования конвейеров данных, а не к конкретному продукту или формату хранения. Она отвечает на практическую проблему любой команды данных — сырые данные из источников, будь то базы данных, логи, очереди вроде Kafka или файлы от партнёров, приходят в разных форматах, с дублями и ошибками, а разным потребителям нужна разная степень готовности этих данных. Инженеру для отладки и повторной обработки нужна точная копия исходных событий. Аналитику нужна чистая таблица без дублей и с понятными типами. Руководителю нужна готовая цифра выручки по регионам за вчера. Медальонная архитектура решает это разделением ответственности по слоям вместо попытки удовлетворить всех одним преобразованием.
В официальной документации Databricks слои определены не только форматом хранения, но и ролью потребителя на каждом этапе. Bronze адресован инженерам данных и комплаенс-командам, Silver — аналитикам и дата сайентистам, Gold — бизнес-аналитикам, BI-разработчикам и руководителям. Это смещает фокус с физического расположения файлов на то, кто отвечает за качество данных на каждом шаге и на какие гарантии может рассчитывать потребитель следующего слоя.
Архитектура и слои
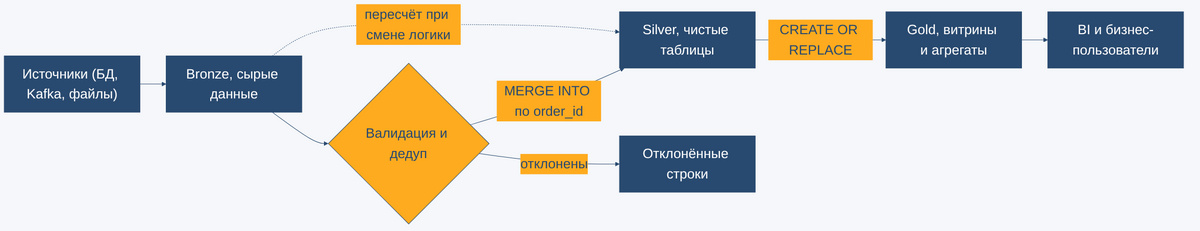
Классический вариант паттерна держится на трёх слоях, имя каждого совпадает с цветом медали и с уровнем готовности данных внутри него.
Bronze слой сырых данных
Bronze принимает данные в исходном виде, будь то выгрузка из PostgreSQL, поток из Kafka или файлы от внешней системы. Валидация здесь минимальна и обычно ограничивается базовой проверкой формата. Данные пишутся дозаписью, без дедупликации и без исправления ошибок источника, потому что цель слоя другая — сохранить точную копию для аудита и для повторной обработки, если через полгода изменится бизнес-логика следующих слоёв. Каждая запись обычно помечается идентификатором батча и временем загрузки, это даёт возможность понять, откуда взялась конкретная строка.
Silver слой валидированных данных
Silver превращает сырьё в пригодные для работы таблицы. Здесь применяются схема данных, приведение типов, обработка пустых значений и дедупликация по естественному ключу. Именно на этом слое начинается моделирование данных в привычном смысле слова. Документация Databricks отдельно предупреждает не писать данные напрямую из источника в Silver в обход Bronze, потому что изменение схемы у источника в этом случае ломает таблицу без предупреждения, а промежуточный Bronze-слой даёт время заметить такое изменение и обработать его. Потребители Silver это аналитики и дата-сайентисты, которым нужны чистые данные, но ещё не обязательно агрегированные под конкретную задачу.
Gold слой обогащённых витрин
Gold содержит агрегаты и витрины, выстроенные под конкретные бизнес-задачи, например выручку по дням и категориям или воронку конверсии по каналам. Здесь уместна классическая размерная модель хранилища данных, схема звезды или готовые показатели для BI-инструментов. Потребители этого слоя — бизнес-аналитики, разработчики дашбордов и руководители, которым не нужно и не должно быть нужно разбираться в сыром формате источника.
Принцип работы медальонной архитектуры
Слои связаны не общей базой данных, а последовательностью преобразований, у каждого из которых свои гарантии.
Инкрементальная загрузка и идемпотентность
Загрузка в Bronze идёт батчами или непрерывным потоком, и слой это просто принимает, не заботясь о повторах. Вся защита от дублей и от повторной обработки сосредоточена в переходе Bronze в Silve, и держится она на одной идее — трансформация должна быть идемпотентной, то есть повторный запуск с теми же входными данными не должен менять результат. Технически это делается через оператор слияния по естественному ключу, MERGE INTO в SQL, а не через слепой INSERT. В демо ниже видно эту механику на конкретных числах — первый прогон трансформации кладёт в Silver 2 строки из 5 сырых, а повторный прогон того же батча оставляет ровно те же 2 строки, потому что вторая проходка находит совпадение по order_id и ничего не меняет вместо того чтобы вставить дубли.
Gold устроен по-другому. Вместо инкрементального накопления слой пересчитывается целиком из Silver каждый раз, когда меняются входные данные, например через CREATE OR REPLACE TABLE. Это тоже идемпотентность, только достигнутая не хитрым слиянием, а отказом от накопления состояния вообще, ведь агрегат каждый раз считается заново, и ошибиться в нём дважды одинаково невозможно.
Контракт качества между слоями
Граница между слоями это не только техническое разделение таблиц, а описанный выше командный контракт. Команда, которая владеет Silver, обязуется перед потребителями, что в колонке order_id нет пропусков, а суммы приведены к одному типу и одной валюте. Команда, которая строит Gold, полагается на эту гарантию и не проверяет её заново на каждом отчёте. Если контракт нигде не зафиксирован явно, разные команды начинают тихо переизобретать одни и те же проверки качества в разных местах конвейера, а сбой обнаруживается только на дашборде у руководителя, а не там, где его дешевле было поймать.
Медальон за пределами Databricks
Несмотря на происхождение термина у Databricks, сам паттерн не привязан ни к Delta Lake (открытому формату хранения таблиц поверх Parquet, на котором Databricks строит свой Lakehouse), ни к конкретному движку вообще. Слои Bronze, Silver и Gold это в первую очередь про порядок ответственности за качество данных, а не про то, в каком файле они физически лежат. Разбор реализации медальонной архитектуры в ClickHouse в блоге Школы Больших Данных показывает это на практике — Silver-слой там собирается инкрементальными материализованными представлениями поверх таблиц Bronze, и для этого не нужен ни Delta Lake, ни какая-либо платформа Databricks.
Другой способ увидеть медальон вне контекста Lakehouse — сравнить его с методологией Data Vault, которая решает похожую задачу другими терминами.
| Медальонная архитектура | Data Vault | Роль слоя |
|---|---|---|
| Bronze | Staging | Сырые данные без изменений |
| Silver | Data Vault (хабы, линки, сателлиты) | Интеграция и полная история изменений |
| Gold | Схема звезды (витрины) | Плоские таблицы для BI-инструментов |
Data Vault добавляет к среднему слою собственную строгую модель хранения истории, а медальонная архитектура сама по себе такую модель не диктует, она задаёт только последовательность ответственности, а внутреннее устройство каждого слоя команда выбирает сама. Это же отличает медальон от лямбда- и каппа-архитектур, которые решают другую задачу, объединение пакетной и потоковой обработки, и вполне уживаются с медальоном на одном и том же конвейере.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Ограничения и подводные камни
Медальонная архитектура снимает часть проблем управления качеством данных, но создаёт свои собственные, и сама документация Databricks прямо называет её рекомендованной практикой, а не обязательным требованием.
- Рост стоимости хранения. Три слоя вместо одного означают три физические копии одних и тех же данных, и на больших объёмах это ощутимая статья расходов.
- Нужен отдельный оркестратор. Паттерн не говорит, кто и когда запускает переход между слоями, без Airflow или встроенных пайплайнов платформы слои быстро расходятся по расписанию.
- Не заменяет моделирование данных. Silver и Gold всё равно нужно спроектировать по правилам схемы звезды или Data Vault, медальон лишь задаёт порядок слоёв, а не их внутреннее устройство.
- Это рекомендация, а не требование. Для маленького конвейера с одним потребителем три слоя часто избыточны, и сама Databricks не настаивает на паттерне как на обязательной схеме.
Ни один из этих пунктов не отменяет пользу паттерна, но каждый стоит явно обсудить до того, как заводить три слоя вместо одного.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Когда применять медальонную архитектуру, а когда не стоит
Медальон уместен, когда данные приходят из многих источников, а получателей у результата тоже несколько, с разными требованиями к готовности.
- Несколько классов потребителей. Инженерам нужна сырая копия для аудита, аналитикам чистая таблица, бизнесу готовая цифра, и три слоя дают каждому своё, не заставляя остальных ждать общий компромиссный формат.
- Нужна возможность переиграть историю. Bronze хранит исходные данные достаточно долго, чтобы пересчитать Silver и Gold заново при смене бизнес-логики, без повторного похода к источнику.
- Конвейер батчевый или инкрементальный. Многошаговая обработка добавляет задержку, которая для ETL и ELT приемлема, а для действительно горячего пути обслуживания запросов уже нет.
Обратная сторона тоже реальна. Для одного источника с одним потребителем, для витрины на пять таблиц или для системы с жёстким требованием к задержке в единицы миллисекунд три слоя это накладные расходы без выгоды. Разобраться, какой архитектурный паттерн отвечает задаче бизнеса, DWH, Lakehouse или Data Mesh, помогает курс «Практическая архитектура данных» в Школе Больших Данных.
Практика — демо Bronze, Silver и Gold на DuckDB
Ниже полный код демо на DuckDB 1.5.5, локальном движке без внешних сервисов. Скрипт создаёт три таблицы, кладёт в Bronze пять сырых строк заказов, из которых одна дублирует другую, а две не проходят валидацию, переносит валидные и дедуплицированные строки в Silver через MERGE INTO, запускает ту же трансформацию второй раз подряд, чтобы показать идемпотентность, добавляет второй батч с исправленной ценой и новым заказом, и в конце пересчитывает витрину Gold.
# DuckDB 1.5.5, Python 3.12.13, прогнано на стенде 2026-08-26
"""
Демо медальонной архитектуры на DuckDB: Bronze -> Silver -> Gold на примере заказов.

Показывает три вещи, которые в тексте статьи описаны словами:
1. Bronze хранит сырьё как есть, включая дубли и невалидные строки, без отказа в приёме.
2. Переход Bronze -> Silver идёт через MERGE INTO по естественному ключу, поэтому повторный
   прогон того же батча не плодит дублей (идемпотентность), а невалидные строки отсеиваются
   с протоколом причины.
3. Переход Silver -> Gold это полный пересчёт агрегата (CREATE OR REPLACE), а не инкремент:
   Gold идемпотентен по построению, потому что каждый раз считается заново из Silver.
"""

import duckdb

DB_PATH = "medallion_demo.duckdb"


def reset_db(con):
    """Схема демо: одна витрина заказов на трёх слоях."""
    con.execute("DROP TABLE IF EXISTS bronze_orders")
    con.execute("DROP TABLE IF EXISTS silver_orders")
    con.execute("DROP TABLE IF EXISTS gold_daily_category_revenue")
    con.execute("""
        CREATE TABLE bronze_orders (
            order_id     VARCHAR,
            customer_id  VARCHAR,
            category     VARCHAR,
            amount_raw   VARCHAR,
            order_date   VARCHAR,
            batch_id     INTEGER,
            ingested_at  TIMESTAMP
        )
    """)
    con.execute("""
        CREATE TABLE silver_orders (
            order_id    VARCHAR PRIMARY KEY,
            customer_id VARCHAR,
            category    VARCHAR,
            amount      DECIMAL(10, 2),
            order_date  DATE
        )
    """)


def ingest_bronze(con, rows, batch_id):
    """Bronze не валидирует и не дедуплицирует - грузим строки как пришли из источника."""
    con.executemany(
        """
        INSERT INTO bronze_orders
            (order_id, customer_id, category, amount_raw, order_date, batch_id, ingested_at)
        VALUES (?, ?, ?, ?, ?, ?, now())
        """,
        [(*row, batch_id) for row in rows],
    )


def bronze_to_silver(con, batch_id):
    """
    Валидация и дедуп на входе в Silver, затем идемпотентный upsert по order_id.

    Дедуп берёт последнюю по времени загрузки строку на order_id внутри батча - так
    закрывается случай, когда источник в одном файле прислал две версии одного заказа.
    Строки без customer_id или с amount_raw, который не приводится к числу, в Silver не
    попадают вообще: они остаются в Bronze как есть, это и есть аудиторский след ошибки.
    """
    rejected = con.execute(
        """
        SELECT order_id, customer_id, amount_raw
        FROM bronze_orders
        WHERE batch_id = ?
          AND (customer_id IS NULL OR TRY_CAST(amount_raw AS DECIMAL(10, 2)) IS NULL)
        """,
        [batch_id],
    ).fetchall()

    con.execute(
        """
        MERGE INTO silver_orders AS s
        USING (
            SELECT order_id, customer_id, category,
                   CAST(amount_raw AS DECIMAL(10, 2)) AS amount,
                   CAST(order_date AS DATE) AS order_date
            FROM (
                SELECT *,
                       row_number() OVER (
                           PARTITION BY order_id ORDER BY ingested_at DESC
                       ) AS rn
                FROM bronze_orders
                WHERE batch_id = ?
                  AND customer_id IS NOT NULL
                  AND TRY_CAST(amount_raw AS DECIMAL(10, 2)) IS NOT NULL
            )
            WHERE rn = 1
        ) AS b
        ON s.order_id = b.order_id
        WHEN MATCHED THEN UPDATE SET
            customer_id = b.customer_id,
            category = b.category,
            amount = b.amount,
            order_date = b.order_date
        WHEN NOT MATCHED THEN INSERT (order_id, customer_id, category, amount, order_date)
            VALUES (b.order_id, b.customer_id, b.category, b.amount, b.order_date)
        """,
        [batch_id],
    )
    return rejected


def silver_to_gold(con):
    """Gold - полный пересчёт витрины, а не докатка дельты: так он идемпотентен сам по себе."""
    con.execute("""
        CREATE OR REPLACE TABLE gold_daily_category_revenue AS
        SELECT order_date, category,
               SUM(amount) AS revenue,
               COUNT(*) AS orders_count
        FROM silver_orders
        GROUP BY order_date, category
        ORDER BY order_date, category
    """)


def main():
    con = duckdb.connect(DB_PATH)
    reset_db(con)

    batch_1 = [
        ("ORD-1001", "CUST-1", "electronics", "129.90", "2026-08-20"),
        ("ORD-1002", "CUST-2", "books", "18.50", "2026-08-20"),
        ("ORD-1002", "CUST-2", "books", "18.50", "2026-08-20"),   # дубль строки в источнике
        ("ORD-1003", None, "electronics", "45.00", "2026-08-20"),  # нет customer_id
        ("ORD-1004", "CUST-3", "home", "not_a_number", "2026-08-20"),  # битая сумма
    ]

    print("=== батч 1: ингест в Bronze ===")
    ingest_bronze(con, batch_1, batch_id=1)
    print("Bronze строк:", con.execute("SELECT count(*) FROM bronze_orders").fetchone()[0])

    print("\n=== батч 1: первый прогон Bronze -> Silver ===")
    rejected = bronze_to_silver(con, batch_id=1)
    print("Отклонено строк:", len(rejected), rejected)
    silver_count_1 = con.execute("SELECT count(*) FROM silver_orders").fetchone()[0]
    print("Silver строк после первого прогона:", silver_count_1)

    print("\n=== батч 1: повторный прогон той же трансформации (идемпотентность) ===")
    bronze_to_silver(con, batch_id=1)
    silver_count_2 = con.execute("SELECT count(*) FROM silver_orders").fetchone()[0]
    print("Silver строк после повторного прогона:", silver_count_2)
    assert silver_count_1 == silver_count_2, "повторный прогон не должен плодить дубли"

    print("\n=== батч 2: исправление цены + новый заказ ===")
    batch_2 = [
        ("ORD-1001", "CUST-1", "electronics", "119.90", "2026-08-21"),  # исправлена цена и дата
        ("ORD-1005", "CUST-4", "books", "9.99", "2026-08-21"),
    ]
    ingest_bronze(con, batch_2, batch_id=2)
    bronze_to_silver(con, batch_id=2)
    silver_count_3 = con.execute("SELECT count(*) FROM silver_orders").fetchone()[0]
    print("Silver строк после батча 2:", silver_count_3)
    print(
        "Цена ORD-1001 после апдейта:",
        con.execute(
            "SELECT amount, order_date FROM silver_orders WHERE order_id = 'ORD-1001'"
        ).fetchone(),
    )

    print("\n=== Silver -> Gold: полный пересчёт витрины ===")
    silver_to_gold(con)
    print(con.execute("SELECT * FROM gold_daily_category_revenue").fetchdf().to_string(index=False))

    print("\n=== Gold после повторного вызова без изменений в Silver (тоже идемпотентно) ===")
    silver_to_gold(con)
    gold_count = con.execute("SELECT count(*) FROM gold_daily_category_revenue").fetchone()[0]
    print("Строк в Gold:", gold_count)

    con.close()


if __name__ == "__main__":
    main()
Прогон завершился успешно и вернул ожидаемую картину.
# реальный вывод run_output.txt, прогон на стенде 2026-08-26
Bronze строк: 5
Отклонено строк: 2 [('ORD-1003', None, '45.00'), ('ORD-1004', 'CUST-3', 'not_a_number')]
Silver строк после первого прогона: 2
Silver строк после повторного прогона: 2
Silver строк после батча 2: 3
Цена ORD-1001 после апдейта: (Decimal('119.90'), datetime.date(2026, 8, 21))
order_date    category  revenue  orders_count
2026-08-20       books    18.50             1
2026-08-21       books     9.99             1
2026-08-21 electronics   119.90             1
Строк в Gold: 3
Bronze честно принял все 5 строк, включая буквальный дубль заказа ORD-1002. В Silver первым прогоном прошли только 2 заказа, потому что оба проблемных заказа, ORD-1003 без customer_id и ORD-1004 с нечисловой суммой, отклонены с указанием причины. Повторный прогон той же трансформации оставил Silver с теми же 2 строками, это идемпотентность, доказанная числом, а не заявленная на словах. Второй батч исправил цену и дату заказа ORD-1001 и добавил ORD-1005, подняв Silver до 3 строк без дублирования уже загруженных заказов. Gold пересчитался из этих 3 строк в 3 агрегированные записи по датам и категориям, и повторный вызов пересчёта вернул то же самое количество строк.
Заключение
Медальонная архитектура даёт простой словарь для разговора о том, кто отвечает за качество данных на каждом шаге конвейера, от сырой копии в Bronze до готовой витрины в Gold. Ценность паттерна не в трёх конкретных именах слоёв, а в идемпотентных переходах между ними и в честном разделении ответственности, которое не даёт одной команде тихо переложить проверку качества на другую. Три копии данных и отдельный оркестратор конвейеров это цена этой ясности, и платить её стоит там, где потребителей действительно несколько и они действительно разные.