 3
Содержание
- Что такое ETL и какую задачу решает
- Архитектура ETL-конвейера от источников до хранилища
- Extract, три способа забрать данные из источника
- Transform, базовая очистка и производные вычисления
- Load, full load против incremental load
- Почему трансформация до загрузки это одновременно сила и ограничение
- ETL против ELT, эволюция подхода
- Когда выбирают ETL, а когда ELT
- Практика, простой ETL-конвейер на Python
- Заключение
- Референсные ссылки
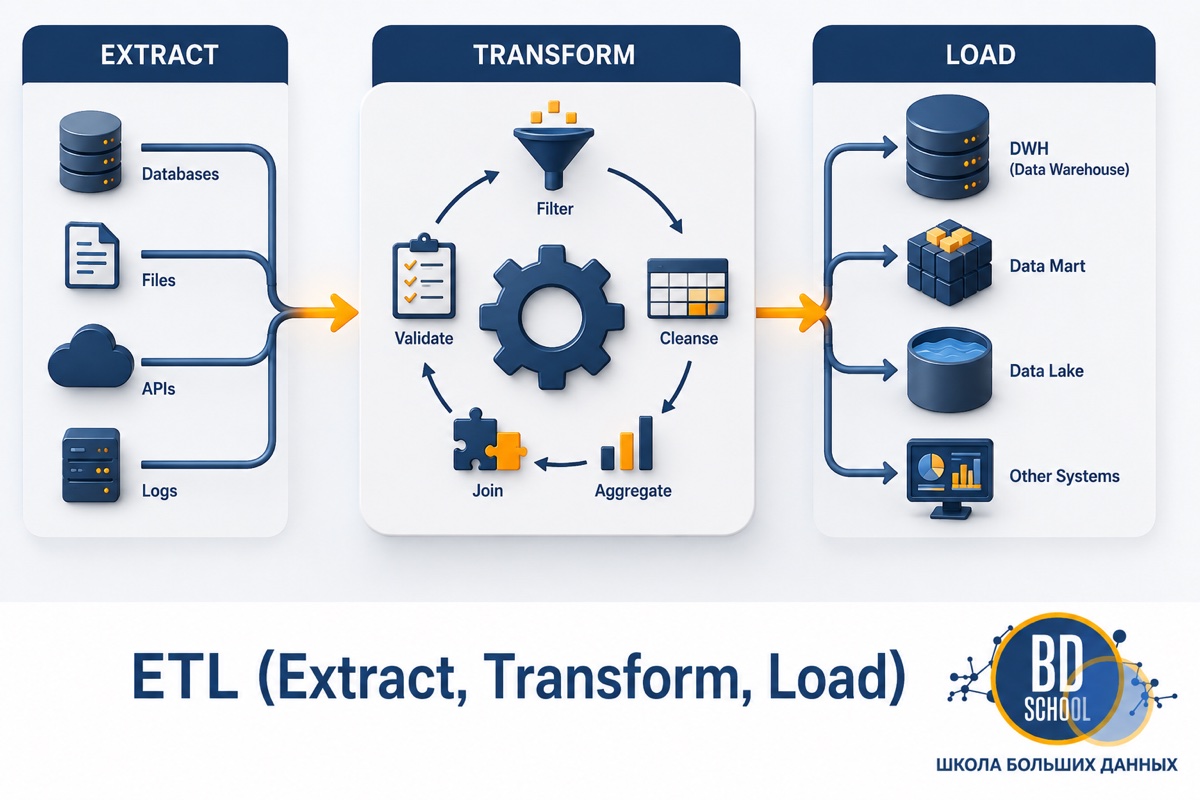
ETL (Extract, Transform, Load) это архитектурный паттерн обработки данных, в котором данные сначала извлекаются из источников, затем трансформируются во временной зоне вне целевой системы и только потом загружаются в готовом виде в хранилище данных (data warehouse). Три буквы в названии называют три последовательные стадии конвейера, и порядок этот не случаен. Трансформация происходит до загрузки, а не после неё, и именно это отличает ETL от более молодого подхода ELT, где те же три операции идут в другом порядке. Разница определяет, где физически считается нагрузка трансформации, насколько жёстко нужно проектировать целевую схему заранее и как быстро конвейер масштабируется под растущий объём данных.
Что такое ETL и какую задачу решает
Задачу, которую решает ETL, Amazon Web Services формулирует прямо, как процесс объединения данных из нескольких источников в большое центральное хранилище, называемое data warehouse. До этого объединения данные лежат разрозненно, в разных форматах и с разной степенью качества, и использовать их для аналитики напрямую нельзя. ETL-конвейер извлекает эти данные, приводит их к единому виду и загружает туда, где с ними уже можно работать.
Ядро определения за прошедшие годы не изменилось, а вот роль паттерна сместилась. Для облачных команд заметен сдвиг к более молодому ELT (Extract, Load, Transform), потому что современные хранилища и лейкхаусы (lakehouse) обладают достаточной вычислительной мощностью, чтобы трансформировать данные уже после загрузки, силами самой целевой системы. При этом классический ETL не потерял актуальность и остаётся рабочим выбором там, где данные нужно очистить, замаскировать или проверить на соответствие требованиям ещё до того, как они попадут в целевую систему, а не постфактум. Дальше в статье эта граница применимости разобрана подробно, а начать стоит с того, из каких компонентов конвейер ETL состоит физически.
Архитектура ETL-конвейера от источников до хранилища
У ETL-конвейера четыре архитектурных компонента, и структурно они одни и те же независимо от инструмента реализации. Источники данных это исходные базы и системы, из которых извлекаются записи. Промежуточная зона (staging area) это временное хранилище, куда данные попадают сразу после извлечения. Слой трансформации выполняет очистку, маппинг полей, дедупликацию и более сложные вычисления. Целевое хранилище данных получает уже трансформированный результат и отдаёт его для анализа.
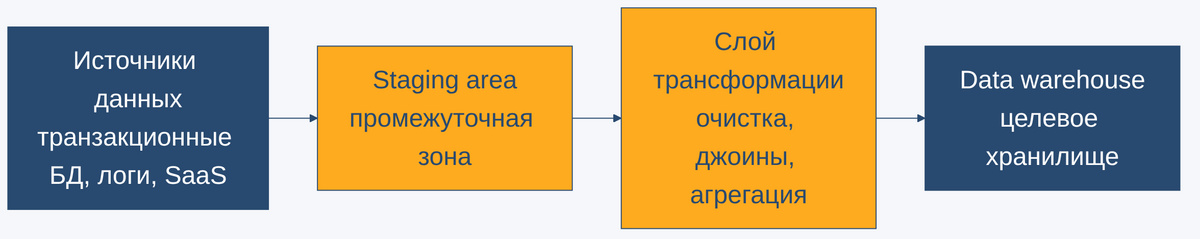
Именно staging area отличает архитектуру ETL от ELT. В ELT отдельной промежуточной зоны нет, вычисления выполняет сама целевая система, обычно лейкхаус, уже после загрузки. В ETL трансформация происходит раньше и вне хранилища, поэтому в целевую систему попадают только очищенные данные.
Extract, три способа забрать данные из источника
У извлечения есть три метода, которые AWS выделяет как основные. Update notification, при котором исходная система сама уведомляет о том, что записи изменились. Incremental extraction, когда конвейер сам определяет, какие данные изменились за период, обычно по метке времени. Full extraction, то есть полная перезагрузка всего датасета, применяется, когда в источнике нет механизма отслеживания изменений, но создаёт высокий объём передачи и годится только для небольших таблиц. Это семейство методов в индустрии часто называют более широким термином CDC (change data capture), особенно когда речь о непрерывном потоке изменений.
Transform, базовая очистка и производные вычисления
Трансформация в ETL-конвейере бывает двух уровней сложности. Базовый уровень наводит порядок в сырых данных без изменения их смысла, продвинутый уровень производит новые данные и связи между источниками.
- Базовая очистка. Удаление ошибочных записей, маппинг полей, дедупликация повторов.
- Производные вычисления. Derivation, расчёт новых значений на основе полей источника.
- Джоины. Joining, связывание данных из нескольких источников по общему ключу.
- Разбиение и агрегация. Splitting делит колонку на несколько, summarization агрегирует строки в сводные показатели.
- Шифрование. Encryption данных, которые по комплаенсу не должны попадать в хранилище в открытом виде.
Все эти операции выполняются до того, как данные покинут промежуточную зону, поэтому в целевое хранилище они попадают уже в финальном виде.
Load, full load против incremental load
Загрузка бывает полной или инкрементальной. Full load переносит весь трансформированный датасет целиком, обычно при первичном наполнении хранилища. Incremental load переносит только дельту относительно предыдущей загрузки, потоково (streaming) или пакетно (batch). У пакетной инкрементальной загрузки есть цена, потому что на время синхронизации операции приостанавливаются в обеих системах, и в источнике, и в приёмнике.
Почему трансформация до загрузки это одновременно сила и ограничение
Трансформация до загрузки даёт ETL то, чего у ELT нет по конструкции, а именно контроль над данными ещё до того, как они попадут в целевую систему. Для регулируемых отраслей вроде здравоохранения и финансов это не второстепенное удобство, а требование. В ELT сырые данные сначала загружаются как есть, а маскирование происходит уже внутри хранилища, поэтому в ETL проще проверить соответствие стандартам комплаенса, ведь шаг трансформации стоит явным звеном конвейера, а не растворён в запросах внутри хранилища.
У того же решения есть обратная сторона. Классический ETL требует больше проектирования в начале, потому что структуру и правила трансформации целевых данных нужно продумать заранее, до первой загрузки, а не постфактум. Процесс получается линейным и негибким, данные сложно переиспользовать для нового сценария анализа задним числом, ведь то, что не попало в исходную трансформацию, в хранилище просто не появится. Ресурсоёмкость тоже выше, а масштабировать конвейер под резкий рост объёма данных сложнее, чем там, где трансформацией занимается эластичное вычислительное ядро самого хранилища.
ETL против ELT, эволюция подхода
Оба подхода извлекают, трансформируют и загружают одни и те же данные, различие только в порядке двух последних стадий, но это различие каскадом расходится по всей архитектуре.
| Критерий | ETL | ELT |
|---|---|---|
| Где происходит трансформация | В отдельной промежуточной зоне, до загрузки | Внутри целевого хранилища, после загрузки |
| Гибкость | Ниже, данные сложно переиспользовать для нового сценария задним числом | Выше, сырые данные сохранены и доступны для повторной трансформации |
| Масштабируемость | Ограничена мощностью отдельного движка трансформации | Растёт вместе с масштабированием целевого хранилища |
| Комплаенс | Проще обеспечить строгие стандарты соответствия | Требует дополнительного контроля внутри хранилища |
Сравнение по этим критериям приводит Databricks, поставщик платформы для обработки данных на базе лейкхаус-архитектуры, в разборе ETL vs ELT. Сдвиг к ELT произошёл не потому, что ETL устарел как идея, а потому что изменилась инфраструктура. Современные лейкхаусы и облачные хранилища обладают достаточной вычислительной мощностью, чтобы выполнять трансформацию внутри себя, и это убрало главный аргумент в пользу отдельного движка трансформации, а именно недостаток ресурсов у целевой системы. Выбор между подходами поэтому всё чаще становится архитектурным решением уровня компании.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Когда выбирают ETL, а когда ELT
Официальная документация обоих подходов формулирует границы применимости достаточно конкретно, и она же задаёт практический критерий выбора. ETL остаётся рабочим выбором в нескольких повторяющихся сценариях.
- Миграция легаси-систем. Перенос данных из устаревшей транзакционной базы в хранилище данных.
- Структурированные транзакционные данные. Прогнозирование спроса, управление запасами или анализ поведения потребителей, задачи с заранее известной схемой.
- Регулируемые отрасли. Здравоохранение и финансы, где комплаенс проще соблюдать при явном шаге трансформации до загрузки.
ELT документация рекомендует в обратных условиях, а именно большие объёмы неструктурированных данных, которые нужно загружать часто и большими партиями, big data сценарии, где план аналитики формируется уже после того, как данные сохранены, и облачную инфраструктуру с потребностью в обновлениях, близких к реальному времени, и в разведочном анализе. В этих условиях жёсткая заранее спроектированная трансформация ETL превращается из преимущества в узкое место.
Развёрнутый разбор архитектурных решений при выборе между ETL и ELT есть в статье ETL vs ELT, как построить архитектуру пайплайна данных. Инструментом трансформации внутри хранилища в ELT чаще всего выступает dbt (data build tool), ему посвящён курс dbt для инженера данных.
Дополняет картину Azure Architecture Center отдельной ветвью эволюции подхода, а именно Reverse ETL. Это перенос уже трансформированных данных из аналитического хранилища обратно в операционные системы вроде CRM, чтобы бизнес-пользователи действовали на основе готовой аналитики прямо в привычном интерфейсе, а не в отчёте.
Практика, простой ETL-конвейер на Python
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо развёрнуто на локальном PostgreSQL 18.4, в двух таблицах одной базы etl_demo. Источник, таблица raw_orders, наполняет отдельный скрипт db_setup.py 5000 строками, к которым намеренно добавлены типичные дефекты выгрузки, а именно дубли записей, пропуски в количестве и цене и разнобой в написании региона (пробелы, регистр). Эти дефекты разбирает шаг трансформации в конвейере ниже, etl_pipeline.py.
Физическая граница staging area видна прямо в структуре кода. Между функциями extract() и load() данные целиком проходят через процесс pandas, а не через SQL внутри базы, и это и есть промежуточная зона классического ETL. В ELT ту же работу сделал бы SQL-запрос, выполненный уже после загрузки сырых данных в целевую таблицу.
# pandas 3.0.5, psycopg 3.3.4, PostgreSQL 18.4, прогнано на стенде 2026-08-29
"""Простой ETL-конвейер: Extract из raw_orders, Transform в pandas, Load в
sales_summary, обе таблицы в одной базе etl_demo, поднятой db_setup.py.

Ключевой момент архитектуры виден прямо в коде: между extract() и load()
данные целиком проходят через процесс pandas, а не через SQL внутри базы.
Это и есть staging area классического ETL, трансформация происходит до
загрузки, вне хранилища. В ELT то же самое сделал бы SQL-запрос уже после
загрузки сырых данных в целевую таблицу.
"""

import time

import pandas as pd
import psycopg

DSN = "host=localhost port=5432 dbname=etl_demo user=techfriends"

CREATE_TARGET = """
DROP TABLE IF EXISTS sales_summary;
CREATE TABLE sales_summary (
    region        text          NOT NULL,
    order_date    date          NOT NULL,
    order_count   integer       NOT NULL,
    total_revenue numeric(12,2) NOT NULL,
    PRIMARY KEY (region, order_date)
);
"""


def extract(conn: psycopg.Connection) -> pd.DataFrame:
    """Extract: полная выгрузка исходной таблицы, без фильтров на стороне источника,
    вся логика отбора и очистки идёт дальше, в transform."""
    with conn.cursor() as cur:
        cur.execute(
            "SELECT id, quantity, unit_price::double precision AS unit_price, "
            "region, order_date, status FROM raw_orders"
        )
        rows = cur.fetchall()
        columns = [d.name for d in cur.description]
    return pd.DataFrame(rows, columns=columns)


def transform(df: pd.DataFrame) -> pd.DataFrame:
    """Transform: базовая очистка, производный расчёт и агрегация, три вида
    трансформации из плана статьи, все на одном датафрейме."""
    extracted = len(df)

    # базовая очистка: дубли от повторной выгрузки источника, разнобой в
    # написании region, пропуски в полях, без которых нельзя посчитать выручку
    df = df.drop_duplicates(subset="id")
    df["region"] = df["region"].str.strip().str.title()
    df = df.dropna(subset=["quantity", "unit_price"])

    # бизнес-правило: в сводку идут только завершённые заказы
    df = df[df["status"] == "completed"]

    # производное вычисление: выручки в источнике нет, она считается здесь
    df["revenue"] = df["quantity"] * df["unit_price"]

    # агрегация: одна строка на регион и дату вместо одной на заказ
    summary = df.groupby(["region", "order_date"], as_index=False).agg(
        order_count=("id", "count"), total_revenue=("revenue", "sum")
    )

    print(
        f"extract: {extracted} строк -> после очистки и фильтра "
        f"status=completed: {len(df)} -> агрегировано в {len(summary)} строк"
    )
    return summary


def load(conn: psycopg.Connection, df: pd.DataFrame) -> None:
    """Load: full load, целевая таблица каждый раз очищается и наполняется
    заново целиком, без сравнения с предыдущим состоянием."""
    records = [
        (row.region, row.order_date, int(row.order_count), round(float(row.total_revenue), 2))
        for row in df.itertuples(index=False)
    ]
    with conn.cursor() as cur:
        cur.execute(CREATE_TARGET)
        cur.executemany(
            "INSERT INTO sales_summary (region, order_date, order_count, total_revenue) "
            "VALUES (%s, %s, %s, %s)",
            records,
        )
    conn.commit()


if __name__ == "__main__":
    with psycopg.connect(DSN) as conn:
        t0 = time.time()
        raw = extract(conn)
        t1 = time.time()
        summary = transform(raw)
        t2 = time.time()
        load(conn, summary)
        t3 = time.time()

    print(
        f"extract {t1 - t0:.3f} с, transform {t2 - t1:.3f} с, "
        f"load {t3 - t2:.3f} с, итого {t3 - t0:.3f} с"
    )
    print(summary.sort_values(["region", "order_date"]).head(10).to_string(index=False))
Функция extract() выгружает raw_orders целиком, без фильтров на стороне источника. Здесь скрыта первая практическая деталь. PostgreSQL отдаёт колонку unit_price типа numeric через psycopg3 как decimal.Decimal, а не float, и умножение quantity * unit_price в pandas упало бы TypeError при смешении типов. Обход сделан прямо в SQL-запросе, явным приведением типа unit_price::double precision.
Функция transform() делает три вида трансформации из архитектуры выше на одном датафрейме, базовую очистку по дублям и разнобою в написании региона, бизнес-фильтр по статусу completed и агрегацию с производным расчётом выручки. Функция load() делает full load, каждый раз пересоздаёт sales_summary и наполняет её заново целиком. Вторая деталь всплывает здесь. DataFrame.itertuples() отдаёт numpy-скаляры, которые psycopg не адаптирует по умолчанию, поэтому перед executemany они явно приведены к int() и float().
Реальный прогон на стенде даёт следующий вывод.
таблица raw_orders пересоздана, строк: 5030
  из них id с дублями: 30, строк с NULL в quantity/unit_price: 52
extract: 5030 строк -> после очистки и фильтра status=completed: 3183 -> агрегировано в 898 строк
extract 0.015 с, transform 0.007 с, load 0.030 с, итого 0.052 с
Числа между прогонами немного плавают, потому что db_setup.py генерирует данные случайно, но порядок величин устойчив. Именно линейность трёх последовательных стадий, extract целиком, потом transform целиком, потом load целиком, и есть то архитектурное ограничение, которое обсуждалось выше.
В демо конвейер запускается вручную одной командой, но в production такие шаги обычно оркестрирует отдельный планировщик вроде Apache Airflow, который следит за порядком запуска, повторяет упавшие шаги и хранит историю прогонов.
Apache Airflow для инженеров данных
Код курса
AIRF
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Заключение
ETL остаётся паттерном с чёткой инвариантой, трансформация всегда происходит до загрузки, в отдельной промежуточной зоне вне целевого хранилища. Это одновременно и сила подхода, потому что данные попадают в хранилище уже проверенными и готовыми к комплаенсу, и его ограничение, потому что требует спроектировать трансформацию заранее и линейно ждёт завершения каждой стадии. ELT вырос из того, что у современных хранилищ хватает мощности переносить трансформацию внутрь себя, но не отменил ETL целиком, а лишь сузил область, где классический подход остаётся лучшим выбором, до легаси-миграций, структурированных данных и регулируемых отраслей. Демо конвейер выше на паре таблиц PostgreSQL показывает эту границу в коде. Extract и load разделены полноценным шагом трансформации в pandas, который физически и есть staging area классического ETL.