 4
Содержание
- Что такое DWH и его место в архитектуре данных
- Архитектура и ключевые компоненты
- Источники данных и ETL/ELT-слой (staging area)
- Уровень хранения данных, схемы, таблицы, горячие и холодные данные
- Аналитический движок и BI-слой, витрины данных
- Путь данных от источника до отчёта
- DWH vs Data Lake vs Lakehouse
- Эволюция подхода от Инмона и Кимбалла к конвергенции с lakehouse
- Сценарии использования и когда DWH не подходит
- Практика, звёздная схема (Fact/Dimension) и ETL-запрос
- Заключение
- Референсные ссылки
DWH (Data Warehouse, хранилище данных) это центральный репозиторий, куда бизнес свозит данные из разрозненных операционных систем, чтобы анализировать историю и принимать решения на её основе. Определение звучит просто, но за ним стоит целая архитектура, слой загрузки, слой хранения со схемами и таблицами, аналитический движок и BI-инструменты сверху. Разберём, из чего состоит DWH, как данные проходят путь от источника до отчёта и чем понятие отличается от Data Lake и Lakehouse.
Что такое DWH и его место в архитектуре данных
DWH (Data Warehouse, хранилище данных) это архитектурная концепция и категория технологий для консолидации данных из разных систем в едином аналитическом слое. Amazon Web Services (AWS) в официальной документации определяет его как центральный репозиторий информации, который можно анализировать для принятия более обоснованных решений, а данные при этом регулярно поступают из транзакционных систем и баз данных, доступ к ним идёт через BI-инструменты и SQL.
Классическое определение связывают с именем Bill Inmon (Билл Инмон), которого называют «отцом» data warehousing. Широко цитируемая формулировка (доступна по вторичным источникам, точная ссылка на первоисточник Инмона не проверялась) звучит так: DWH это subject-oriented, integrated, time-variant and nonvolatile collection of data in support of management’s decision-making process, то есть предметно-ориентированная, интегрированная, историчная и неизменяемая коллекция данных для поддержки принятия управленческих решений. Каждое из четырёх свойств задаёт границу понятия. Данные организованы вокруг предметных областей бизнеса, а не вокруг отдельных приложений, сведены из разных источников к общему формату, хранят историю изменений, а не только текущее состояние, и после загрузки не перезаписываются задним числом. В архитектуре данных DWH обычно стоит над оперативными OLTP-системами (Online Transaction Processing, системами обработки транзакций) и служит источником правды для отчётности, дашбордов и регулярной аналитики, а не для отдельных транзакций.
Архитектура и ключевые компоненты
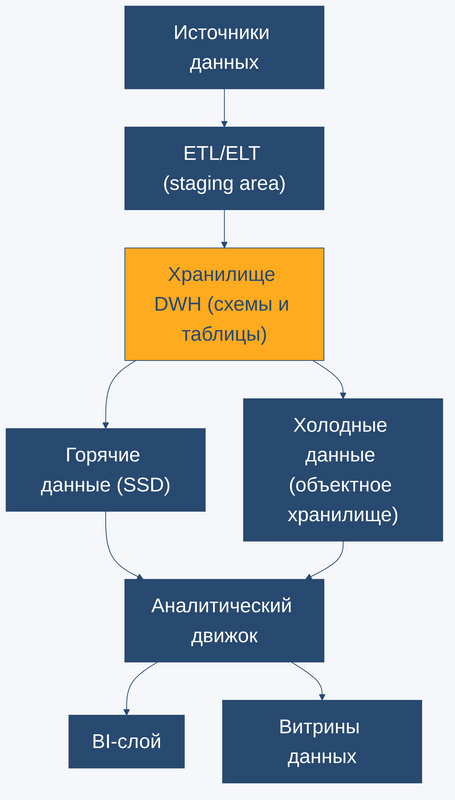
У DWH нет единого эталонного стека, но большинство описаний сходятся к трём-четырём слоям. AWS выделяет три уровня, хранилище, аналитический движок и BI-инструменты. Обзорные материалы вроде образовательного портала Guru99 традиционно детализируют схему до четырёх, выделяя ETL-слой (back-end tier) отдельным уровнем перед хранилищем. На уровне хранения классические реализации DWH строятся на MPP-платформах (Massively Parallel Processing, массивно-параллельная обработка) вроде Greenplum, распределяющих таблицы по узлам кластера, в Школе Больших Данных ей посвящён курс Greenplum для инженеров данных и аналитиков данных (GPDE). Дальше разберём слои по порядку, от источников до BI.
Источники данных и ETL/ELT-слой (staging area)
Данные в DWH поступают из операционных систем, транзакционных баз, файлов и внешних источников. Прежде чем попасть в целевые таблицы, они проходят через staging area (область подготовки), промежуточный слой, где данные очищают, дедуплицируют и приводят к единому формату. Классический процесс здесь называется ETL (extract, transform, load, извлечение, трансформация, загрузка), обзор архитектуры на Guru99 описывает его как back-end tier, отдельный от собственно хранилища. Современные облачные платформы чаще используют обратный порядок, ELT (extract, load, transform), когда сырые данные сначала загружаются в хранилище, а трансформация выполняется уже средствами самой СУБД. Этот сдвиг фиксируют отраслевые обзоры, а не вендорская документация, поэтому его стоит воспринимать как наблюдение индустрии, а не как формальный стандарт.
Уровень хранения данных, схемы, таблицы, горячие и холодные данные
Данные хранятся в таблицах и столбцах внутри базы данных, а таблицы группируются в схемы, которые AWS описывает как аналог папок в файловой системе. При загрузке данные записываются в таблицы согласно схеме, а инструменты запросов используют эту схему, чтобы понять, какие таблицы читать для конкретного анализа. Уровень БД-сервера у AWS делится на два типа памяти, быстрая (SSD) для часто запрашиваемых, горячих данных и дешёвая (например, объектное хранилище вроде Amazon S3) для редко используемых, холодных данных. Разделение по температуре данных снижает стоимость хранения истории на годы вперёд без потери доступа к ней.
Построение DWH на ClickHouse
Код курса
CLICH
Ближайшая дата курса
12 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Аналитический движок и BI-слой, витрины данных
Средний уровень архитектуры, аналитический движок, обрабатывает SQL-запросы к хранилищу и отдаёт результат инструментам отчётности. Guru99 выделяет его в отдельный OLAP tier (Online Analytical Processing), специализированный на многомерных агрегациях и быстрых срезах по измерениям. Сверху стоит front-end tier, BI-инструменты для визуализации, дашбордов и data mining, а также data mart (витрина данных), узкий срез хранилища под конкретный отдел или задачу, который строится поверх общего DWH и не дублирует его логику полностью.
Путь данных от источника до отчёта
Путь конкретной записи через DWH выглядит похоже для большинства архитектур. Событие или строка транзакции возникает в операционной системе, CRM, ERP или другом источнике. Планировщик ETL/ELT- процесса забирает данные пакетом по расписанию, кладёт их в staging area и приводит к целевой схеме, устраняя дубли и несоответствия типов. Затем строка попадает в таблицу факта или измерения внутри хранилища, где хранится согласно схеме звезды или снежинки. Аналитический движок выполняет над этими таблицами агрегирующий SQL-запрос, например для месячной выручки по регионам, и передаёт результат в BI-инструмент. Аналитик открывает готовый дашборд и видит цифру уже без выполнения запроса вручную, потому что тяжёлые вычисления выполнены на уровне хранилища и движка, а не на клиенте.
DWH vs Data Lake vs Lakehouse
Три термина путают чаще всего, потому что решают похожую задачу, консолидацию данных для аналитики, но расходятся в требованиях к формату и пользователю. Таблица ниже сводит ключевые отличия по данным AWS и обзорным материалам об архитектуре lakehouse.
| Критерий | DWH | Data Lake | Lakehouse |
|---|---|---|---|
| Формат данных | Только структурированные, табличные | Любые, структурированные, полу- и неструктурированные | Открытые табличные форматы поверх объектного хранилища |
| Основная задача | Регулярная бизнес-отчётность, BI | Big data, ML, полнотекстовый поиск | Аналитика и ML на одной копии данных |
| Стоимость хранения | Выше, данные предобработаны и оптимизированы под запросы | Ниже, дешёвое объектное хранилище | Ближе к data lake за счёт объектного хранилища |
| Типичный пользователь | Аналитик, BI-специалист | Data scientist, ML-инженер | Оба профиля на общих данных |
Граница между DWH и Data Lake проходит там, где данные требуют строгой схемы и SQL-доступа, а не гибких файловых форматов и произвольной обработки. Lakehouse пытается объединить оба мира одной копией данных в объектном хранилище, которую читают и аналитические движки, и ML-инструменты.
Эволюция подхода от Инмона и Кимбалла к конвергенции с lakehouse
Bill Inmon сформулировал подход «сверху вниз», где сначала проектируется единое нормализованное корпоративное хранилище, а витрины данных строятся уже поверх него. Ralph Kimball (Ральф Кимбалл), автор подхода dimensional modeling (многомерное моделирование), предложил обратный путь «снизу вверх», через независимые витрины данных со схемой звезды, которые постепенно объединяются в общее хранилище через согласованные измерения. Описание подхода Кимбалла здесь опирается на устоявшееся отраслевое изложение, отдельная проверка по первоисточнику dimensional modeling не проводилась. Оба подхода остаются основой проектирования DWH и сегодня, а выбор между ними определяется тем, что важнее для конкретной компании, единая модель данных сразу или быстрый запуск первых отчётов. Третий распространённый подход к моделированию, Data Vault, строит хранилище из хабов, линков и сателлитов ради гибкости при частых изменениях схемы источников, пошаговый пример такого проектирования разобран в материале 5 шагов проектирования DWH с подходом Data Vault: практический пример.
С переходом в облако DWH-платформы вроде Snowflake, Amazon Redshift и Google BigQuery сняли часть инфраструктурных ограничений классической схемы, масштабирование стало эластичным, а не заданным на этапе закупки железа. Индустриальные обзоры (не документация вендора и не стандарт какого-либо консорциума) описывают дальнейший сдвиг как конвергенцию DWH и lakehouse, современные хранилища всё чаще читают открытые табличные форматы вроде Iceberg или Delta поверх объектного хранилища, а lakehouse-платформы обзаводятся SQL-движками уровня DWH. Это наблюдение аналитиков рынка, а не переопределение термина официальным органом, и классическое определение Bill Inmon с его четырьмя свойствами формально не изменилось.
Сценарии использования и когда DWH не подходит
AWS в официальной документации перечисляет случаи, где DWH оправдан, и прямо указывает границу, за которой стоит выбрать data lake.
- Обоснованные бизнес-решения. DWH консолидирует данные из разных систем в едином слое отчётности, на основе которого проще принимать решения, а не гадать по разрозненным выгрузкам.
- Анализ истории. Историчность данных, заложенная ещё в определении Bill Inmon, даёт возможность сравнивать периоды и строить тренды.
- Повышение качества и согласованности данных. Единая схема и ETL/ELT-слой устраняют дубли и расхождения форматов между источниками.
Эти три сценария вместе описывают классическую зону ответственности DWH, регулярную аналитику поверх согласованных исторических данных.
AWS прямо рекомендует data lake вместо DWH, если данные полуструктурированные или неструктурированные, а задача требует возможностей big data, полнотекстового поиска или построения моделей машинного обучения. Требование к табличному, структурированному формату остаётся единственным чётко задокументированным ограничением DWH как концепции, числовых лимитов вроде максимального объёма данных или числа конкурентных запросов у самого понятия нет, они задаются конкретным продуктом.
Проектирование Online-хранилищ данных на StarRocks
Код курса
STAR
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика, звёздная схема (Fact/Dimension) и ETL-запрос
Ниже упрощённый пример звёздной схемы (star schema) для витрины продаж, стандартный SQL без привязки к конкретной СУБД, и запрос, который переносит данные из источника в таблицу измерения на этапе ETL. Пример иллюстрирует общепринятый синтаксис звёздной схемы, а не вывод реального прогона на стенде, поскольку статья разбирает архитектурную концепцию, а не конкретный продукт.
-- Пример: стандартный SQL (ANSI SQL), иллюстрация синтаксиса звёздной схемы (star schema)
CREATE TABLE dim_date (
    date_key INT PRIMARY KEY,
    full_date DATE NOT NULL,
    year INT NOT NULL,
    quarter INT NOT NULL,
    month INT NOT NULL
);

CREATE TABLE dim_product (
    product_key INT PRIMARY KEY,
    product_name VARCHAR(200) NOT NULL,
    category VARCHAR(100) NOT NULL
);

CREATE TABLE dim_customer (
    customer_key INT PRIMARY KEY,
    customer_name VARCHAR(200) NOT NULL,
    region VARCHAR(100) NOT NULL
);

-- Таблица фактов ссылается на измерения внешними ключами и хранит числовые метрики
CREATE TABLE fact_sales (
    sale_id BIGINT PRIMARY KEY,
    date_key INT REFERENCES dim_date(date_key),
    product_key INT REFERENCES dim_product(product_key),
    customer_key INT REFERENCES dim_customer(customer_key),
    quantity INT NOT NULL,
    amount NUMERIC(12,2) NOT NULL
);
Загрузка измерения на этапе ETL обычно идёт с проверкой на дубли, а финальный запрос к таблице фактов и измерениям отдаёт готовую агрегацию в BI-слой.
-- Пример: стандартный SQL (ANSI SQL), шаг ETL из staging area в измерение dim_product
INSERT INTO dim_product (product_key, product_name, category)
SELECT DISTINCT
    s.product_id AS product_key,
    s.product_name,
    s.category
FROM staging_products s
LEFT JOIN dim_product d ON d.product_key = s.product_id
WHERE d.product_key IS NULL;

-- Агрегирующий запрос для BI-слоя, выручка по регионам за квартал
SELECT
    c.region,
    d.year,
    d.quarter,
    SUM(f.amount) AS total_revenue
FROM fact_sales f
JOIN dim_customer c ON c.customer_key = f.customer_key
JOIN dim_date d ON d.date_key = f.date_key
GROUP BY c.region, d.year, d.quarter
ORDER BY d.year, d.quarter, total_revenue DESC;
Заключение
DWH остаётся рабочим термином для структурированного, централизованного хранения данных под регулярную отчётность и BI, даже когда границы с Data Lake и Lakehouse на практике размываются. Выбор архитектуры зависит не от моды, а от формата данных и задачи, табличные структурированные данные под BI прежде всего просятся в DWH, а разнородные данные под ML или поиск лучше ложатся в data lake или lakehouse. Подходы Bill Inmon и Ralph Kimball десятилетия спустя после появления термина всё ещё задают словарь, которым инженеры проектируют звёздные схемы и витрины данных.