 1
Содержание
- Что такое ELT и какую задачу он решает
- Архитектура ELT-конвейера
- Источники и слой извлечения
- Загрузка сырых данных инструментами Airbyte, Fivetran, Meltano
- Слой трансформации внутри хранилища
- Принцип работы, хранилище как процессинговый хаб
- ELT против ETL, в чём разница
- Ограничения и риски ELT
- Когда выбирать ELT, а когда классический ETL
- Практика, загрузка сырых данных и трансформация SQL внутри Postgres
- Заключение
- Референсные ссылки
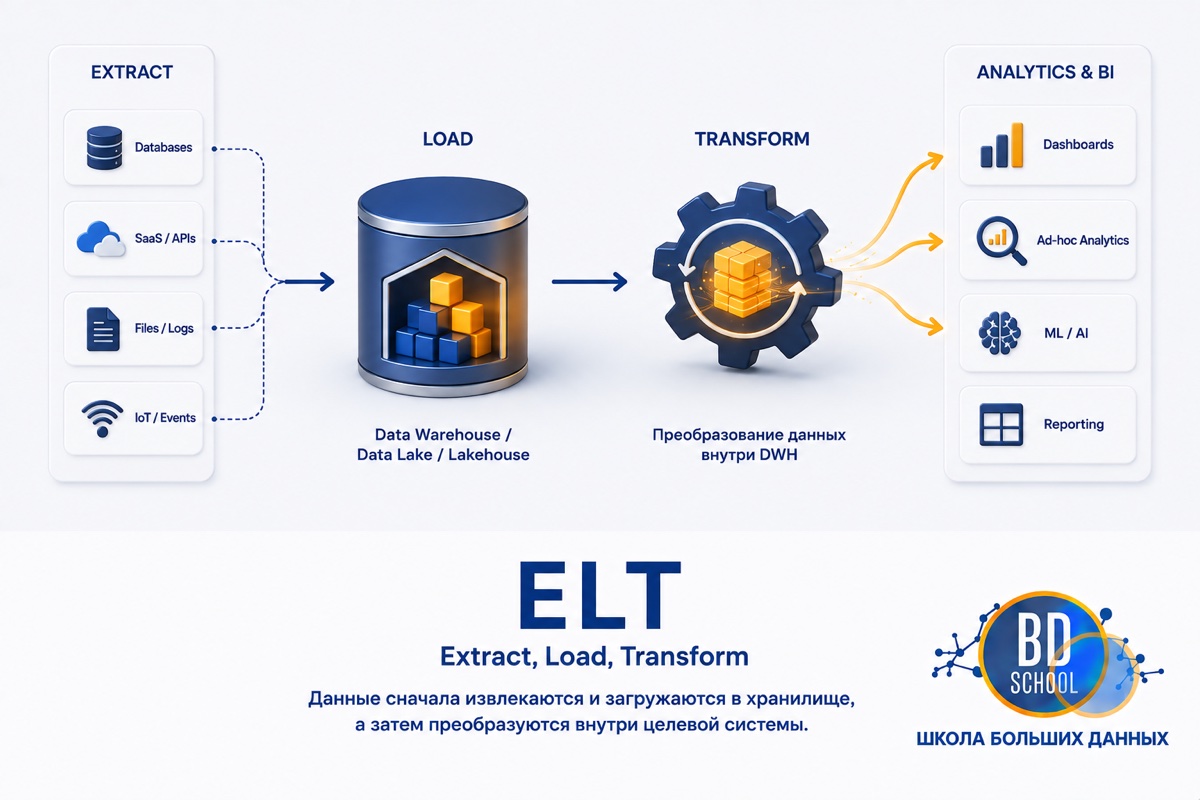
ELT (Extract, Load, Transform) это архитектурный паттерн интеграции данных, при котором данные сначала извлекаются из источников и загружаются в целевое хранилище как есть, а трансформация выполняется уже после загрузки, средствами вычислительной мощности самого хранилища. Три буквы называют те же три операции, что и в более старом подходе ETL, но две последние стадии в ELT поменяны местами. Трансформация происходит не в отдельном промежуточном слое, а внутри целевой системы, и такое смещение стало естественным выбором для облачных хранилищ данных (data warehouse) и лейкхаусов (data lakehouse), где хранение дёшево, а вычисления эластичны. У подхода при этом есть реальные ограничения, они разобраны дальше в статье вместе с границей, где классический ETL остаётся уместнее.
Что такое ELT и какую задачу он решает
Определение приводит Databricks, поставщик платформы для обработки данных на базе лейкхаус-архитектуры, данные сначала извлекаются из исходных систем, затем загружаются напрямую в центральный репозиторий, а трансформируются уже внутри целевой системы. Задачу это решает ту же, что и ETL, разрозненные данные из множества источников нужно свести в единое место для аналитики, но момент, когда над ними начинают работать, смещён на этап после загрузки.
Разницу с ETL точнее всего формулирует dbt Labs, компания-разработчик SQL-инструмента dbt для трансформации данных внутри хранилища, сырые данные сначала попадают в хранилище шагами extract и load, а уже потом трансформируются в хранилище средствами его собственных вычислений. В классическом ETL трансформация происходит до загрузки, в отдельном промежуточном слое (staging area), которого в ELT физически нет.
Databricks прямо связывает этот сдвиг с облачной инфраструктурой, современные архитектуры убрали многие из ограничений, ради которых изначально проектировался ETL. Дешёвое хранение и эластичные вычисления сделали ELT естественной эволюцией интеграции данных в облачном мире, а не заменой ETL по идейным причинам.
Архитектура ELT-конвейера
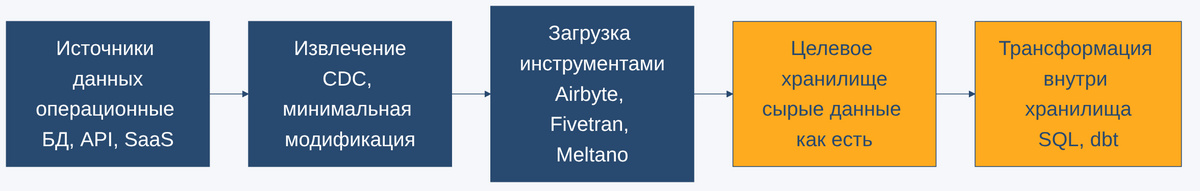
У ELT-конвейера пять архитектурных компонентов по данным Databricks. Источники данных (source systems) это операционные базы, API, SaaS-платформы, IoT-устройства и лог-файлы. Слой извлечения копирует данные с минимальной модификацией, чтобы сохранить достоверность, и часто использует CDC (change data capture) для инкрементального выявления новых и изменённых записей. Слой загрузки переносит сырые данные без трансформационных узких мест. Целевая инфраструктура принимает данные в нативном или слабоструктурированном формате, часто с партиционированием по времени или источнику. Слой трансформации выполняется уже внутри целевой системы её собственными вычислительными движками.
Источники и слой извлечения
Извлечение в ELT устроено так же аккуратно, как и в ETL, копия должна быть достоверной, поэтому модификация данных на этом шаге минимальна. Основной механизм здесь CDC, конвейер отслеживает, какие записи изменились с прошлого прохода, вместо того чтобы каждый раз выгружать источник целиком. Дальше сырые данные без изменений уходят в слой загрузки.
Загрузка сырых данных инструментами Airbyte, Fivetran, Meltano
Современные ELT-конвейеры переносят данные инструментами вроде Airbyte, Fivetran, Meltano и Matillion, специализированными платформами синхронизации, у которых нет встроенной трансформационной логики. Их задача узкая и конкретная, быстро и надёжно доставить сырые данные до целевого хранилища.
Насколько тесно слой загрузки и слой трансформации связаны в реальной индустрии, показывает завершённое 1 июня 2026 года слияние Fivetran, платформы автоматизированной синхронизации данных, и dbt Labs. В официальном пресс-релизе компании формулируют разделение ролей напрямую, Fivetran обеспечивает актуальные и надёжные данные, а dbt делает так, чтобы эти данные были описаны, проверены тестами и доверены как бизнес-логика. Loading-инструмент и transformation-инструмент объединились в одну компанию именно потому, что в архитектуре ELT это два звена одного и того же конвейера, а не конкурирующие продукты.
Слой трансформации внутри хранилища
Трансформация выполняется нативными вычислительными движками целевой системы. SQL-фреймворки вроде dbt управляют этой логикой и добавляют тестирование, документацию и отслеживание происхождения данных (lineage). По данным dbt Labs, хранилище становится процессинговым хабом, вместо предварительной трансформации во внешнем слое она происходит внутри хранилища с использованием его же вычислительной мощности, что позволяет итеративно уточнять бизнес-логику прямо на сырых исходных данных.
Построение DWH на ClickHouse
Код курса
CLICH
Ближайшая дата курса
12 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы, хранилище как процессинговый хаб
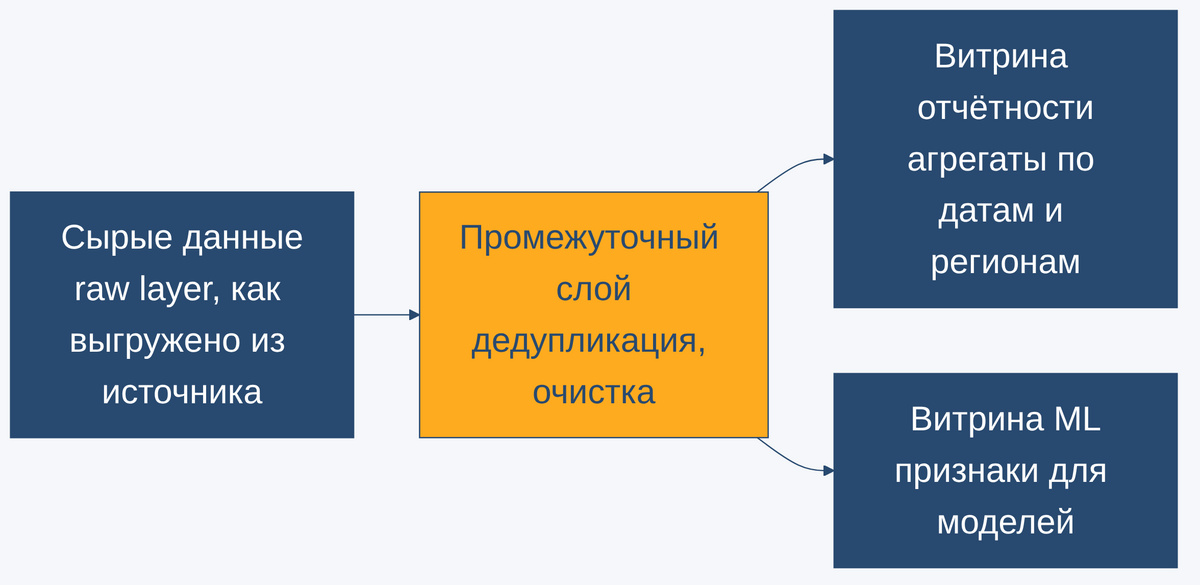
Databricks описывает механизм ELT тремя последовательными этапами. Extract копирует данные из операционных источников с минимальной модификацией. Load сразу записывает извлечённые данные в облачную инфраструктуру, обеспечивая быструю загрузку без промежуточной обработки. Transform применяет бизнес-логику уже внутри целевой системы, используя её эластичные вычислительные ресурсы для масштабирования.
Такая последовательность соответствует подходу schema-on-read, несколько слоёв трансформации могут сосуществовать одновременно поверх одних и тех же сырых данных, поддерживая разные сценарии использования. Один набор витрин обслуживает регулярную отчётность, второй готовит признаки для модели машинного обучения, и оба берут данные из одного и того же сырого слоя, а не из разных копий.
ELT против ETL, в чём разница
Обе схемы выполняют одни и те же три операции, различие только в порядке двух последних, но это различие расходится каскадом по всей архитектуре, от места хранения промежуточных данных до момента, когда данные впервые проверяются на качество.
| Критерий | ETL | ELT |
|---|---|---|
| Где происходит трансформация | В отдельной промежуточной зоне (staging area), до загрузки | Внутри целевого хранилища, после загрузки |
| Момент проверки качества данных | До попадания в хранилище | После загрузки, уже на downstream-этапах |
| Гибкость | Ниже, не попавшее в исходную трансформацию в хранилище не появится | Выше, сырые данные сохранены и доступны для повторной трансформации |
| Масштабируемость | Ограничена мощностью отдельного движка трансформации | Растёт вместе с масштабированием целевого хранилища |
Именно физическое отсутствие staging area и определяет остальные строки таблицы. Раз промежуточного слоя нет, качество сырых данных нельзя проверить до того, как они попадут в хранилище, зато та же самая эластичность хранилища снимает ограничение на объём и скорость трансформации.
Ограничения и риски ELT
Databricks и dbt Labs называют пересекающийся, но не идентичный набор ограничений, оба источника не противоречат друг другу, а дополняют.
- Качество данных. Сырые данные загружаются до валидации, поэтому проблемы с качеством проявляются уже на downstream-этапах, из-за чего фреймворки валидации становятся критически важны.
- Governance и комплаенс. Хранение сырых данных усложняет соответствие требованиям GDPR, HIPAA, SOX и PCI-DSS, а хранение нетрансформированной чувствительной информации добавляет риски безопасности.
- Контроль стоимости. При архитектурной простоте ELT может увеличивать использование хранилища и вычислений, что требует проактивного мониторинга затрат.
- Сложность трансформаций. По мере роста конвейеров управление бизнес-логикой и координация между командами усложняются, а неоптимизированные запросы становятся узким местом производительности.
Ни одно из этих ограничений не отменяет выгоду ELT, но каждое требует отдельного инженерного решения, а не решается по умолчанию самим паттерном.
Когда выбирать ELT, а когда классический ETL
По данным Databricks, ELT подходит для облачных хранилищ данных и data lake с эластичными вычислениями, для real-time и потоковых приложений, которым нужна быстрая доступность данных, для крупномасштабной аналитики от терабайт до петабайт, для ML-конвейеров, которым нужен доступ к сырым данным для feature engineering, и для миграций легаси-систем в облако.
dbt Labs формулирует это через тип компании, а не только через объём данных, ELT подходит cloud-native компаниям, которым нужны гибкость, масштабируемость и быстрые инсайты, отрасли вроде e-commerce, healthcare-аналитики и маркетинговых операций. Отрасли со строгими требованиями к governance данных до попадания в хранилище, чаще всего финансы и здравоохранение, по тем же данным нередко нуждаются в классическом ETL с провалидированными и очищенными данными на входе. dbt Labs также упоминает гибридную модель, лёгкая трансформация ещё до загрузки и основная трансформация уже внутри хранилища. В индустрии такой подход часто называют EtLT, он сочетает контроль качества ETL с гибкостью ELT.
Развёрнутый разбор перехода от ETL к ELT с приходом облачных хранилищ есть в статье про интеграцию и совместимость данных. Инструментом трансформации внутри хранилища в ELT чаще всего выступает dbt, ему посвящён курс dbt для инженера данных.
Практика, загрузка сырых данных и трансформация SQL внутри Postgres
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Apache Airflow для инженеров данных
Код курса
AIRF
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Демо развёрнуто на локальном PostgreSQL 18.4, в трёх схемах одной базы elt_demo. Источник, таблица source.orders, наполняет отдельный скрипт db_setup.py 5000 базовыми строками, к которым намеренно добавлены типичные дефекты выгрузки, а именно дубли записей, пропуски в количестве и цене и разнобой в написании региона (пробелы, регистр). Эти дефекты не разбираются на этом шаге, ими занимается только трансформация внутри базы в elt_pipeline.py.
Физическое отсутствие staging area видно прямо в структуре кода. Между функциями extract_and_load() и transform() сырые строки не проходят ни через pandas, ни через какую-либо другую обработку вне базы, они построчно копируются в схему raw как получены из источника. В ETL этот же шаг занял бы отдельный процесс трансформации до загрузки, здесь трансформация это единственный SQL-запрос, который выполняет сам Postgres уже после того, как данные оказались внутри.
# psycopg 3.3.4, PostgreSQL 18.4, прогнано на стенде 2026-08-29
"""Простой ELT-конвейер: Extract из source.orders, Load сырых строк как есть
в raw.orders_raw, Transform одним SQL-запросом внутри той же базы elt_demo
в analytics.sales_summary. База поднята db_setup.py.

Ключевой момент архитектуры виден прямо в коде: между extract и load нет
никакой обработки, pandas тут вообще нет, данные копируются построчно
как получены. Дедупликация, чистка region, отсев NULL и агрегация происходят
позже, одним запросом transform_sql, который выполняет сам Postgres после
загрузки. Это и есть ELT, трансформация это работа вычислительной мощности
целевого хранилища, а не отдельного процесса между извлечением и загрузкой.
В ETL то же самое сделал бы pandas ещё до load.
"""

import time

import psycopg

DSN = "host=localhost port=5432 dbname=elt_demo user=techfriends"

CREATE_RAW = """
CREATE SCHEMA IF NOT EXISTS raw;
DROP TABLE IF EXISTS raw.orders_raw;
CREATE TABLE raw.orders_raw (
    id          bigint,
    quantity    integer,
    unit_price  numeric(10,2),
    region      text,
    order_date  date,
    status      text
);
"""

# Один SQL-запрос, вся трансформация: детерминированная дедупликация по id,
# чистка региона, отсев брака, бизнес-фильтр по статусу, расчёт выручки и
# агрегация по региону и дате. Ничего из этого не покидает базу.
TRANSFORM_SQL = """
CREATE SCHEMA IF NOT EXISTS analytics;
DROP TABLE IF EXISTS analytics.sales_summary;
CREATE TABLE analytics.sales_summary (
    region        text          NOT NULL,
    order_date    date          NOT NULL,
    order_count   integer       NOT NULL,
    total_revenue numeric(12,2) NOT NULL,
    PRIMARY KEY (region, order_date)
);

INSERT INTO analytics.sales_summary (region, order_date, order_count, total_revenue)
WITH deduped AS (
    -- дубли от повторной выгрузки источника: одна строка на id
    SELECT DISTINCT ON (id) id, quantity, unit_price, region, order_date, status
    FROM raw.orders_raw
    ORDER BY id, ctid
),
cleaned AS (
    -- разнобой в region и пропуски в quantity/unit_price правятся здесь,
    -- а не на стороне источника или в промежуточном процессе
    SELECT
        initcap(trim(region)) AS region,
        order_date,
        quantity,
        unit_price::double precision AS unit_price
    FROM deduped
    WHERE quantity IS NOT NULL
      AND unit_price IS NOT NULL
      AND status = 'completed'
)
SELECT region, order_date, count(*) AS order_count,
       round(sum(quantity * unit_price)::numeric, 2) AS total_revenue
FROM cleaned
GROUP BY region, order_date;
"""


def extract_and_load(conn: psycopg.Connection) -> tuple[int, int]:
    """Extract: полная выгрузка source.orders без фильтров и очистки.
    Load: та же самая выгрузка построчно уходит в raw.orders_raw как есть,
    ни дублей, ни NULL, ни разнобоя в region никто не трогает."""
    with conn.cursor() as cur:
        cur.execute("SELECT id, quantity, unit_price, region, order_date, status FROM source.orders")
        rows = cur.fetchall()
        extracted = len(rows)

        cur.execute(CREATE_RAW)
        cur.executemany(
            "INSERT INTO raw.orders_raw (id, quantity, unit_price, region, order_date, status) "
            "VALUES (%s, %s, %s, %s, %s, %s)",
            rows,
        )
        loaded = cur.execute("SELECT count(*) FROM raw.orders_raw").fetchone()[0]
    conn.commit()
    return extracted, loaded


def transform(conn: psycopg.Connection) -> int:
    """Transform: один SQL-запрос выполняется внутри Postgres над уже
    загруженными сырыми данными и строит analytics.sales_summary."""
    with conn.cursor() as cur:
        cur.execute(TRANSFORM_SQL)
        summary_rows = cur.execute("SELECT count(*) FROM analytics.sales_summary").fetchone()[0]
    conn.commit()
    return summary_rows


if __name__ == "__main__":
    with psycopg.connect(DSN) as conn:
        t0 = time.time()
        extracted, loaded = extract_and_load(conn)
        t1 = time.time()
        summary_rows = transform(conn)
        t2 = time.time()

        with conn.cursor() as cur:
            cur.execute(
                "SELECT region, order_date, order_count, total_revenue "
                "FROM analytics.sales_summary ORDER BY region, order_date LIMIT 10"
            )
            preview = cur.fetchall()

    print(f"extract: {extracted} строк -> load (как есть, без очистки): {loaded} строк в raw.orders_raw")
    print(f"transform (один SQL-запрос внутри базы): {summary_rows} строк в analytics.sales_summary")
    print(f"extract+load {t1 - t0:.3f} с, transform {t2 - t1:.3f} с, итого {t2 - t0:.3f} с")
    print(f"{'region':<8} {'order_date':<12} {'order_count':<12} total_revenue")
    for region, order_date, order_count, total_revenue in preview:
        print(f"{region:<8} {str(order_date):<12} {order_count:<12} {total_revenue}")
Функция extract_and_load() выгружает source.orders целиком и построчно копирует результат в raw.orders_raw без единой проверки. Вся содержательная работа спрятана в TRANSFORM_SQL, одном запросе, который выполняет сам Postgres. Дедупликация сделана через DISTINCT ON (id), но здесь есть практическая деталь, без явного ORDER BY внутри группы Postgres берёт первую попавшуюся строку в том порядке, в каком физически хранит данные, а порядок хранения ничем не гарантирован. Порядок ORDER BY id, ctid в паре с DISTINCT ON закрывает эту неоднозначность и делает выбор детерминированным.
Реальный прогон на стенде даёт следующий вывод.
таблица source.orders пересоздана, строк: 5030
  из них id с дублями: 30, строк с NULL в quantity/unit_price: 52
extract: 5030 строк -> load (как есть, без очистки): 5030 строк в raw.orders_raw
transform (один SQL-запрос внутри базы): 902 строк в analytics.sales_summary
extract+load 0.066 с, transform 0.013 с, итого 0.079 с
Цифры прямо иллюстрируют принцип из раздела про хранилище как процессинговый хаб. Transform занял 0.013 с против 0.066 с на extract+load, в 5 раз быстрее, потому что это один INSERT … SELECT внутри Postgres, без выгрузки данных из процесса и обратно. В демо конвейер запускается вручную одной командой, но в production шаги extract и load обычно оркестрирует отдельный планировщик вроде Apache Airflow, который следит, чтобы transform не запускался раньше, чем сырые данные полностью окажутся в хранилище.
Заключение
ELT сохраняет ту же тройку операций, что и ETL, но переносит трансформацию за пределы загрузки, внутрь целевого хранилища. Такое смещение убирает отдельный промежуточный слой и делает конвейер настолько гибким, насколько эластично само хранилище, но одновременно откладывает проверку качества данных на момент, когда они уже лежат внутри системы. Демо на паре SQL-запросов в Postgres показывает эту границу физически, между извлечением и загрузкой нет ни строчки обработки, вся логика сосредоточена в одном запросе, который выполняет сама база. Выбор между ELT и ETL поэтому решается не модой на архитектуру, а тем, где организации важнее проверить данные раньше, до хранилища или позже, его собственными вычислениями.