
 1

Содержание
- Что такое Chunking и зачем он нужен в RAG
- Место chunking в конвейере индексации
- Размер чанка и перекрытие
- Метаданные чанка
- Как сплиттеры режут текст под капотом
- Фиксированный размер и рекурсивное разбиение по разделителям
- Разбиение по структуре документа
- Семантический chunking по близости эмбеддингов
- Символы или токены, ловушка единиц измерения
- Сравнение стратегий chunking
- Когда подбирать chunking тщательно, а когда нет
- Практика сравнения стратегий на своём корпусе
- Как один документ режут разные сплиттеры
- Hit rate и MRR при разном размере чанка
- Заключение
- Референсные ссылки
Chunking (чанкинг, разбиение документов на фрагменты) это этап индексации в RAG-системе, на котором длинные документы режутся на куски (чанки), и каждый кусок отдельно превращается в вектор и отдельно находится поиском. От размера чанка, перекрытия соседних кусков и места разреза зависит, достанет ли retriever ответ целиком или обрывок без контекста.
Практика ниже выполнена на сплиттерах LangChain и LlamaIndex, Python-фреймворков для приложений на языковых моделях (пакеты langchain-text-splitters 1.1.3 и llama-index-core 0.14.25), с моделью эмбеддингов (embeddings, векторных представлений текста) nomic-embed-text в Ollama 0.40.13, сервере для локального запуска моделей, на машине без GPU.
Что такое Chunking и зачем он нужен в RAG
RAG (Retrieval-Augmented Generation, генерация с дополнением поиском) отвечает на вопрос по фрагментам базы знаний, которые нашёл retriever (поисковый компонент). Искать по документам целиком плохо по двум причинам. Модель эмбеддингов сжимает любой текст в один вектор фиксированной длины, и в векторе регламента на десять страниц абзац про сроки подачи заявления растворяется среди остальных тем. Кроме того, окно контекста ограничено и у модели эмбеддингов, и у LLM (Large Language Model, большой языковой модели), поэтому длинный документ в него просто не помещается.
Документация LangChain описывает задачу сплиттера как разбиение больших документов на куски, которые находятся по отдельности и помещаются в окно модели. Единицей поиска становится чанк, поэтому chunking решает, что система вообще способна найти. Ответ, разрезанный границей пополам, не достанет ни один retriever, как его ни настраивай.
Место chunking в конвейере индексации
Индексация в RAG идёт в четыре шага. Парсер извлекает текст из PDF, HTML или Markdown, сплиттер режет его на чанки, модель эмбеддингов превращает каждый чанк в вектор, а векторная база хранит векторы вместе с текстом и метаданными. На вопрос retriever ищет ближайшие векторы и отдаёт LLM несколько чанков как контекст.
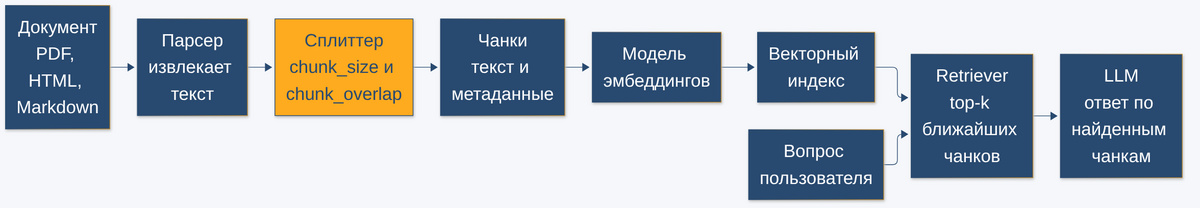
Число чанков задаёт и объём индекса. На этом строится планирование хранилища в статье блога Выбор векторной базы без лишней сложности, где считают не количество исходных файлов, а число чанков после разбиения.
Размер чанка и перекрытие
Размер чанка (chunk size, параметр chunk_size) это верхняя граница длины куска. Мелкий чанк даёт точный вектор про одну мысль, но теряет окружение, например фраза «не позднее чем за 14 календарных дней» без слов о том, к какому заявлению относится срок. Крупный чанк сохраняет контекст, однако размывает вектор и тратит окно LLM на лишний текст.
Перекрытие (chunk overlap, параметр chunk_overlap) это общий текст на стыке соседних чанков. Оно страхует от разреза мысли на границе, ведь фраза, оборванная в конце одного чанка, целиком попадёт в начало следующего. Платой служит дублирование текста в индексе. В практике ниже у сплиттеров с заданным размером перекрытие равно восьмой части размера.
Метаданные чанка
Чанк хранится не только как текст. К нему приписывают метаданные (metadata), а именно источник, заголовок раздела, номер страницы или дату. Они нужны для фильтрации при поиске и для ссылки на источник в ответе. MarkdownHeaderTextSplitter из LangChain кладёт в метаданные заголовки, под которыми лежал кусок, и в прогоне чанк регламента получил поле doc со значением «Регламент отпусков» и поле section со значением «Оформление». Заголовки можно дописать и в начало текста чанка, тогда они попадут в эмбеддинг, так устроена стратегия markdown в практике.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Как сплиттеры режут текст под капотом
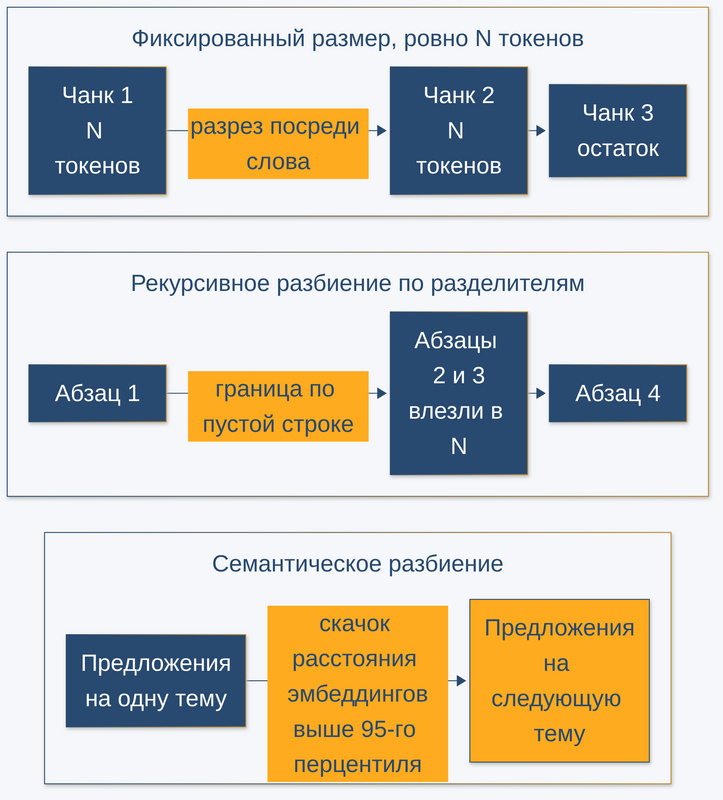
Сплиттеры различаются тем, где проводят границу. Размер задаётся числом, а место разреза правилом стратегии.
Фиксированный размер и рекурсивное разбиение по разделителям
Фиксированный размер (fixed-size chunking) режет текст ровно через N символов или токенов, не глядя на слова. В LangChain так работает TokenTextSplitter. Это быстро и предсказуемо, но граница попадает куда придётся. В прогоне на русском регламенте шесть границ из восьми прошли посреди слова, а одна разрезала сам кириллический символ, который занимает два байта UTF-8, и в чанке остался символ-заменитель U+FFFD.
Рекурсивное разбиение (recursive chunking) перебирает разделители от крупных к мелким. RecursiveCharacterTextSplitter в установленной версии по умолчанию идёт по списку из двойного перевода строки, одиночного перевода строки, пробела и пустой строки. Сплиттер сначала режет по абзацам, и если кусок всё ещё длиннее chunk_size, спускается к строкам, потом к словам и в крайнем случае к отдельным символам. Документация LangChain советует начинать именно с него, потому что он старается сохранить целыми крупные единицы вроде абзацев. SentenceSplitter из LlamaIndex устроен похоже, но собирает чанк из целых предложений.
Разбиение по структуре документа
Если у документа есть разметка, границу дают сами заголовки. MarkdownHeaderTextSplitter режет Markdown по заголовкам выбранных уровней, а для HTML, JSON и исходного кода у LangChain есть свои сплиттеры. Раздел документа обычно и есть законченная мысль, поэтому чанки получаются цельными, но разной длины. В прогоне разделы регламента отпусков заняли от 77 до 231 токена, и слишком длинный раздел приходится дорезать рекурсивным сплиттером.
Семантический chunking по близости эмбеддингов
Семантический chunking (semantic chunking) ищет границу там, где меняется тема. SemanticSplitterNodeParser из LlamaIndex считает эмбеддинг каждого предложения вместе с соседями, их число задаёт параметр buffer_size, по умолчанию 1. Разрез ставится между предложениями, где близость эмбеддингов падает сильнее порога, а порог задан перцентилем расстояний в параметре breakpoint_percentile_threshold, по умолчанию 95. Цена в том, что эмбеддинги считаются дважды, сначала для каждого предложения при разбиении, потом для каждого чанка при индексации.
Символы или токены, ловушка единиц измерения
Параметр chunk_size в разных библиотеках означает разное. Базовый TextSplitter в LangChain по умолчанию берёт chunk_size 4000 и chunk_overlap 200 и меряет длину функцией len, то есть в символах. SentenceSplitter в LlamaIndex по умолчанию берёт chunk_size 1024 и chunk_overlap 200, но в токенах. Число 200 совпадает, а объём перекрытия различается в разы.
Токены тоже бывают разными. Метод from_tiktoken_encoder в LangChain без аргументов берёт кодировку gpt2 (словарь токенизатора tiktoken от модели GPT-2), а не cl100k_base (словарь GPT-4). Регламент отпусков из практики занимает 2199 символов, 947 токенов cl100k_base и 2364 токена gpt2, то есть в старой кодировке русский текст в 2.5 раза длиннее. Одни и те же chunk_size=256 и chunk_overlap=32 дали на этом документе 11 чанков при счёте в символах, 5 в токенах cl100k_base, 12 в токенах gpt2 и 5 у SentenceSplitter.
Вторая ловушка прячется в окне модели эмбеддингов. Окно nomic-embed-text равно 2048 токенам её собственного токенизатора, а не cl100k_base. По документации API Ollama параметр truncate по умолчанию равен true, и длинный вход молча обрезается. Весь корпус практики в 5663 токена cl100k_base модель при true приняла без ошибки и учла только 2048 токенов, а при false сервер вернул HTTP 400. Хвост чанка, не влезший в окно, в векторе не участвует и найден не будет, поэтому chunk_size выбирают с запасом под токенизатор модели эмбеддингов.
Сравнение стратегий chunking
Сводка собрана по документации LangChain и LlamaIndex, по статье Anthropic, разработчика моделей Claude, о contextual retrieval и по прогону из практики.
| Стратегия | Где проходит граница | Цена индексации | Сильная сторона | Слабая сторона |
|---|---|---|---|---|
| Fixed-size | через N символов или токенов | минимальная | предсказуемый размер чанка | режет слова и мысли, на русском даже символы |
| Recursive | по абзацам, затем строкам и словам в пределах N | минимальная | разумное умолчание, границы по абзацам | не знает ни структуры, ни темы текста |
| По структуре | по заголовкам Markdown или тегам HTML | минимальная | цельные разделы, заголовки в метаданных | разная длина, нужен дорез, работает только на размеченных документах |
| Semantic | по скачку расстояния между эмбеддингами соседних предложений | эмбеддинг на каждое предложение, в прогоне 70.6 с против долей секунды | граница по смене темы | дорого, размер чанка не контролируется |
| Contextual retrieval | любая из стратегий выше | вызов LLM на каждый чанк | чанк получает контекст своего документа | стоимость индексации и зависимость от LLM |
Contextual retrieval это не способ резать, а надстройка над любым сплиттером, которую в сентябре 2024 года описала Anthropic. LLM получает документ целиком и один его чанк и пишет к чанку 50-100 токенов пояснения, откуда он и о чём. Пояснение приклеивается к чанку до эмбеддинга и до построения индекса BM25 (классического поиска по ключевым словам). В статье Anthropic о contextual retrieval доля промахов среди первых 20 найденных чанков снизилась на 35% на одних эмбеддингах, на 49% вместе с BM25 и на 67% с добавлением реранкинга (reranking, пересортировки найденного отдельной моделью). Стоимость подготовки оценена в $1.02 на миллион токенов документов с кэшированием промпта, и цифры относятся к моделям 2024 года.
Когда подбирать chunking тщательно, а когда нет
Универсального размера чанка нет. Тщательный подбор окупается в трёх случаях.
- Большая база знаний. Документы не помещаются в окно LLM целиком, и от разбиения зависит, что вообще попадёт в контекст.
- Неоднородные документы. Регламенты с таблицами, код, переписку и сканы PDF выгодно резать разными стратегиями, одна настройка на всё даёт средний результат везде.
- Жёсткий бюджет контекста. Каждый лишний токен в промпте стоит денег и времени ответа, поэтому крупные чанки ради надёжности обходятся дорого.
Метод замера показан в практике ниже.
Обратный случай это маленькая база. Anthropic в той же статье советует при базе до 200 тысяч токенов, около 500 страниц, обойтись без RAG и класть её в промпт целиком. Совет дан в 2024 году, и порог стоит сверять с окном своей модели. Корпус практики занимает 5.7 тысячи токенов и помещается в окно любой современной LLM, поэтому сравнение стратегий на нём показывает механизм, а не готовый рецепт. Как разбиение документов встраивается в архитектуру RAG-системы для корпоративной базы знаний, разбирают на курсе «Архитектура ML-систем».
Практика сравнения стратегий на своём корпусе
Корпус демо состоит из восьми регламентов вымышленной компании «Северная логистика» на русском, это 12846 символов Markdown с заголовками и двумя таблицами. К нему приложены 24 вопроса в questions.jsonl, у каждого в поле answer лежит подстрока ответа, которая встречается в корпусе ровно один раз. Эмбеддинги строит nomic-embed-text, открытая модель компании Nomic AI, в Ollama. LLM в демо не участвует, поэтому вывод детерминирован и совпал в трёх прогонах на машине с 4 vCPU без GPU под Ubuntu 24.04.
Ollama поднимается из docker-compose.yml, от неё нужна только модель эмбеддингов.
# ollama 0.40.13 в Docker, стенд для статьи про Chunking, проверено на стенде 2026-11-07
services:
  ollama:
    image: ollama/ollama:0.40.13
    container_name: chunking-ollama
    # нужна только модель эмбеддингов nomic-embed-text (около 0.4 ГБ), генеративная модель в демо не участвует
    mem_limit: 4g
    ports:
      - "127.0.0.1:11434:11434"
    volumes:
      - ./ollama:/root/.ollama
Зависимости закреплены в requirements.txt.
# версии, на которых снят вывод демо 2026-11-07 (Python 3.12.3, Ollama 0.40.13, nomic-embed-text)
langchain-text-splitters==1.1.3
langchain-core==1.7.6
llama-index-core==0.14.25
llama-index-embeddings-ollama==0.10.0
ollama==0.6.3
tiktoken==0.14.0
nltk==3.10.4
numpy==2.5.4
Окружение собирается и запускается из папки с кодом. Сплиттеры LlamaIndex делят текст на предложения через NLTK (Natural Language Toolkit, Python-библиотеку обработки текста) и при первом вызове докачивают его данные, поэтому нужен доступ в интернет.
# Python 3.12.3, langchain-text-splitters 1.1.3, llama-index-core 0.14.25, Ollama 0.40.13 в Docker, проверено на стенде 2026-11-07
# окружение Python с закреплёнными версиями
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/pip check
# Ollama и модель эмбеддингов
docker compose up -d
docker exec chunking-ollama ollama pull nomic-embed-text
# демо 1 идёт около 10 секунд, демо 2 около 10 минут на CPU
.venv/bin/python 01_split_compare.py
.venv/bin/python 02_retrieval_eval.py
Как один документ режут разные сплиттеры
Скрипт 01_split_compare.py берёт регламент отпусков vacation.md, печатает умолчания установленных пакетов, режет документ пятью сплиттерами и проверяет окно модели эмбеддингов. Сам документ выглядит так.
# Регламент отпусков

Документ описывает, как сотрудники компании «Северная логистика» планируют, оформляют и переносят отпуска. Регламент действует для всех офисов и для сотрудников на удалённой работе.

## Виды отпусков

Ежегодный оплачиваемый отпуск составляет 28 календарных дней. Сотрудникам с ненормированным рабочим днём добавляется ещё 3 календарных дня, список таких должностей утверждает директор по персоналу.

Отпуск без сохранения заработной платы предоставляется по заявлению сотрудника. Общая продолжительность такого отпуска не может превышать 30 календарных дней в году, если иное не требует закон.

Учебный отпуск оформляется по справке-вызову из учебного заведения. Справку нужно передать в отдел кадров до начала сессии, а не после возвращения.

## Планирование и график

График отпусков на следующий год формируется до 1 декабря. Руководитель отдела собирает пожелания команды и следит, чтобы в один период в отпуске было не больше трети сотрудников отдела.

Ежегодный отпуск можно делить на части. Одна из частей должна быть не короче 14 календарных дней, остальные дни сотрудник распределяет как удобно, но не меньше одного дня за раз.

## Оформление

Заявление на ежегодный отпуск подаётся в кадровом портале не позднее чем за 14 календарных дней до его начала. Руководитель согласует заявление в течение трёх рабочих дней, после чего отдел кадров готовит приказ.

Отпускные перечисляются не позднее чем за три дня до начала отпуска. Если заявление подано позже срока, отпуск переносится, а дата выплаты считается от новой даты начала.

## Перенос и отзыв из отпуска

Перенести согласованный отпуск можно по заявлению сотрудника, если руководитель не возражает. Новая дата согласуется так же, как исходная, через кадровый портал.

Отзыв из отпуска возможен только с письменного согласия сотрудника. Неиспользованные из-за отзыва дни предоставляются в удобное для сотрудника время в текущем году или присоединяются к отпуску следующего года.

## Компенсация за неиспользованный отпуск

При увольнении сотрудник получает денежную компенсацию за все неиспользованные дни отпуска. Во время работы заменить отпуск деньгами можно только для части, превышающей 28 календарных дней.
# langchain-text-splitters 1.1.3, llama-index-core 0.14.25, tiktoken 0.14.0, ollama 0.40.13 с nomic-embed-text, прогнано на стенде 2026-11-07
# Один документ режут разные сплиттеры: сколько чанков, какой длины и где проходит первая граница.
# Вторая часть показывает ловушку единиц: одинаковые chunk_size и chunk_overlap в символах и в токенах.
import inspect
import json
import statistics
import sys
import urllib.error
import urllib.request
from pathlib import Path

import tiktoken
from langchain_text_splitters import (
    CharacterTextSplitter,
    MarkdownHeaderTextSplitter,
    RecursiveCharacterTextSplitter,
    TextSplitter,
    TokenTextSplitter,
)
from llama_index.core import constants as li_constants
from llama_index.core.node_parser import SentenceSplitter

HERE = Path(__file__).resolve().parent
OLLAMA = "http://localhost:11434"
DOC = (HERE / "corpus" / "vacation.md").read_text(encoding="utf-8")
CL100K = tiktoken.get_encoding("cl100k_base")  # тот же токенизатор, что у LlamaIndex по умолчанию
GPT2 = tiktoken.get_encoding("gpt2")  # умолчание from_tiktoken_encoder в LangChain


def tokens(text):
    return len(CL100K.encode(text))


def stats(name, chunks):
    chars = [len(c) for c in chunks]
    toks = [tokens(c) for c in chunks]
    print(
        f"{name:<44} чанков {len(chunks):>3} | символы мин/сред/макс "
        f"{min(chars):>4}/{round(statistics.mean(chars)):>4}/{max(chars):>4} | "
        f"токены cl100k {min(toks):>3}/{round(statistics.mean(toks)):>3}/{max(toks):>3}"
    )


def boundary(name, chunks):
    # конец первого чанка и начало второго: видно, режет ли сплиттер по смыслу или посреди слова
    end = chunks[0][-45:].replace("\n", "⏎")
    start = chunks[1][:45].replace("\n", "⏎")
    print(f"{name:<12} …{end} ‖ {start}…")


print("=== УМОЛЧАНИЯ УСТАНОВЛЕННЫХ ПАКЕТОВ ===")
sig = inspect.signature(TextSplitter.__init__).parameters
print("LangChain TextSplitter: chunk_size =", sig["chunk_size"].default,
      "| chunk_overlap =", sig["chunk_overlap"].default,
      "| length_function =", sig["length_function"].default.__name__, "(символы)")
print("LangChain from_tiktoken_encoder: encoding_name =",
      inspect.signature(TextSplitter.from_tiktoken_encoder).parameters["encoding_name"].default)
print("LangChain RecursiveCharacterTextSplitter: separators =", RecursiveCharacterTextSplitter()._separators)
ss = SentenceSplitter()
print("LlamaIndex SentenceSplitter: chunk_size =", ss.chunk_size, "| chunk_overlap =", ss.chunk_overlap, "(токены)")
print("LlamaIndex constants: DEFAULT_CHUNK_SIZE =", li_constants.DEFAULT_CHUNK_SIZE,
      "| DEFAULT_CHUNK_OVERLAP =", li_constants.DEFAULT_CHUNK_OVERLAP)

print()
print("=== ДОКУМЕНТ vacation.md В РАЗНЫХ ЕДИНИЦАХ ===")
print("символов", len(DOC), "| токенов cl100k", tokens(DOC), "| токенов gpt2", len(GPT2.encode(DOC)))

print()
print("=== ЛОВУШКА ЕДИНИЦ: chunk_size=256, chunk_overlap=32 ВЕЗДЕ ===")
by_chars = RecursiveCharacterTextSplitter(chunk_size=256, chunk_overlap=32).split_text(DOC)
by_cl100k = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base", chunk_size=256, chunk_overlap=32).split_text(DOC)
by_gpt2 = RecursiveCharacterTextSplitter.from_tiktoken_encoder(chunk_size=256, chunk_overlap=32).split_text(DOC)
by_llama = SentenceSplitter(chunk_size=256, chunk_overlap=32).split_text(DOC)
stats("LangChain Recursive, len() = символы", by_chars)
stats("LangChain Recursive, токены cl100k", by_cl100k)
stats("LangChain Recursive, токены gpt2 (умолчание)", by_gpt2)
stats("LlamaIndex SentenceSplitter, токены cl100k", by_llama)

print()
print("=== ПЯТЬ СТРАТЕГИЙ НА ОДНОМ ДОКУМЕНТЕ, РАЗМЕР 128 ТОКЕНОВ cl100k, ПЕРЕКРЫТИЕ 16 ===")
fixed = TokenTextSplitter(encoding_name="cl100k_base", chunk_size=128, chunk_overlap=16).split_text(DOC)
character = CharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base", separator="\n\n", chunk_size=128, chunk_overlap=16).split_text(DOC)
recursive = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
    encoding_name="cl100k_base", chunk_size=128, chunk_overlap=16).split_text(DOC)
md_sections = MarkdownHeaderTextSplitter(headers_to_split_on=[("#", "doc"), ("##", "section")]).split_text(DOC)
sentence = SentenceSplitter(chunk_size=128, chunk_overlap=16).split_text(DOC)
stats("TokenTextSplitter (фиксированный размер)", fixed)
stats("CharacterTextSplitter по \\n\\n", character)
stats("RecursiveCharacterTextSplitter", recursive)
stats("MarkdownHeaderTextSplitter (# и ##)", [d.page_content for d in md_sections])
stats("LlamaIndex SentenceSplitter", sentence)

print()
print("=== ПЕРВАЯ ГРАНИЦА: КОНЕЦ ЧАНКА 1 ‖ НАЧАЛО ЧАНКА 2 ===")
boundary("fixed", fixed)
boundary("character", character)
boundary("recursive", recursive)
boundary("markdown", [d.page_content for d in md_sections])
boundary("sentence", sentence)
broken = sum(c.count("�") for c in fixed)
print("символов-заменителей U+FFFD в чанках TokenTextSplitter:", broken)


def mid_word_cuts(chunks):
    # граница посреди слова: последний символ чанка и следующий за ним в документе оба буквы или цифры;
    # U+FFFD в конце значит, что токен разрезал сам символ кириллицы (два байта UTF-8)
    cuts, example = 0, None
    for c in chunks[:-1]:
        if c.endswith("�"):
            cuts += 1
            example = example or c[-30:]
            continue
        start = DOC.find(c.lstrip("�").strip())
        end = start + len(c.lstrip("�").strip())
        if start >= 0 and end < len(DOC) and DOC[end - 1].isalnum() and DOC[end].isalnum():
            cuts += 1
            example = example or c[-30:]
    return cuts, example


for name, chunks in (("fixed", fixed), ("recursive", recursive), ("sentence", sentence)):
    cuts, example = mid_word_cuts(chunks)
    tail = f", пример конца чанка: …{example.replace(chr(10), '⏎')}" if example else ""
    print(f"{name:<10} границ посреди слова: {cuts} из {len(chunks) - 1}{tail}")

print()
print("=== МЕТАДАННЫЕ ЧАНКА ИЗ MarkdownHeaderTextSplitter ===")
for d in md_sections[2:4]:
    print(d.metadata, "|", d.page_content[:70].replace("\n", " "), "…")

print()
print("=== ОКНО МОДЕЛИ ЭМБЕДДИНГОВ nomic-embed-text ===")


def embed_raw(text, truncate):
    body = {"model": "nomic-embed-text", "input": [text], "truncate": truncate}
    req = urllib.request.Request(OLLAMA + "/api/embed", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    try:
        with urllib.request.urlopen(req, timeout=600) as r:
            return json.load(r)
    except urllib.error.HTTPError as e:
        return {"error": f"HTTP {e.code}: {e.read().decode()[:200]}"}


whole = "search_document: " + "\n\n".join(p.read_text(encoding="utf-8") for p in sorted((HERE / "corpus").glob("*.md")))
print("весь корпус одной строкой: символов", len(whole), "| токенов cl100k", tokens(whole))
r = embed_raw(whole, truncate=False)
print("truncate=false:", r.get("error") or f"принято, prompt_eval_count {r.get('prompt_eval_count')}")
r = embed_raw(whole, truncate=True)
print("truncate=true (умолчание):", r.get("error") or f"принято без ошибки, prompt_eval_count {r.get('prompt_eval_count')}")
sys.exit(0)
Вывод скрипта.
=== УМОЛЧАНИЯ УСТАНОВЛЕННЫХ ПАКЕТОВ ===
LangChain TextSplitter: chunk_size = 4000 | chunk_overlap = 200 | length_function = len (символы)
LangChain from_tiktoken_encoder: encoding_name = gpt2
LangChain RecursiveCharacterTextSplitter: separators = ['\n\n', '\n', ' ', '']
LlamaIndex SentenceSplitter: chunk_size = 1024 | chunk_overlap = 200 (токены)
LlamaIndex constants: DEFAULT_CHUNK_SIZE = 1024 | DEFAULT_CHUNK_OVERLAP = 20

=== ДОКУМЕНТ vacation.md В РАЗНЫХ ЕДИНИЦАХ ===
символов 2199 | токенов cl100k 947 | токенов gpt2 2364

=== ЛОВУШКА ЕДИНИЦ: chunk_size=256, chunk_overlap=32 ВЕЗДЕ ===
LangChain Recursive, len() = символы         чанков  11 | символы мин/сред/макс  173/ 206/ 252 | токены cl100k  70/ 89/108
LangChain Recursive, токены cl100k           чанков   5 | символы мин/сред/макс  232/ 447/ 579 | токены cl100k  99/193/253
LangChain Recursive, токены gpt2 (умолчание) чанков  12 | символы мин/сред/макс   41/ 186/ 227 | токены cl100k  18/ 81/102
LlamaIndex SentenceSplitter, токены cl100k   чанков   5 | символы мин/сред/макс  232/ 476/ 597 | токены cl100k  99/205/249

=== ПЯТЬ СТРАТЕГИЙ НА ОДНОМ ДОКУМЕНТЕ, РАЗМЕР 128 ТОКЕНОВ cl100k, ПЕРЕКРЫТИЕ 16 ===
TokenTextSplitter (фиксированный размер)     чанков   9 | символы мин/сред/макс  117/ 276/ 317 | токены cl100k  51/120/130
CharacterTextSplitter по \n\n                чанков  11 | символы мин/сред/макс  173/ 206/ 252 | токены cl100k  70/ 89/108
RecursiveCharacterTextSplitter               чанков  11 | символы мин/сред/макс  173/ 206/ 252 | токены cl100k  70/ 89/108
MarkdownHeaderTextSplitter (# и ##)          чанков   6 | символы мин/сред/макс  181/ 340/ 543 | токены cl100k  77/147/231
LlamaIndex SentenceSplitter                  чанков  10 | символы мин/сред/макс   97/ 218/ 293 | токены cl100k  42/ 95/121

=== ПЕРВАЯ ГРАНИЦА: КОНЕЦ ЧАНКА 1 ‖ НАЧАЛО ЧАНКА 2 ===
fixed        …ваемый отпуск составляет 28 календарных дней. ‖  составляет 28 календарных дней. Сотрудникам …
character    …дников на удалённой работе.⏎⏎## Виды отпусков ‖ ## Виды отпусков⏎⏎Ежегодный оплачиваемый отпу…
recursive    …дников на удалённой работе.⏎⏎## Виды отпусков ‖ ## Виды отпусков⏎⏎Ежегодный оплачиваемый отпу…
markdown     …офисов и для сотрудников на удалённой работе. ‖ Ежегодный оплачиваемый отпуск составляет 28 к…
sentence     …офисов и для сотрудников на удалённой работе. ‖ ## Виды отпусков⏎⏎Ежегодный оплачиваемый отпу…
символов-заменителей U+FFFD в чанках TokenTextSplitter: 1
fixed      границ посреди слова: 6 из 8, пример конца чанка: …такого отпуска не может превыш
recursive  границ посреди слова: 0 из 10
sentence   границ посреди слова: 0 из 9

=== МЕТАДАННЫЕ ЧАНКА ИЗ MarkdownHeaderTextSplitter ===
{'doc': 'Регламент отпусков', 'section': 'Планирование и график'} | График отпусков на следующий год формируется до 1 декабря. Руководител …
{'doc': 'Регламент отпусков', 'section': 'Оформление'} | Заявление на ежегодный отпуск подаётся в кадровом портале не позднее ч …

=== ОКНО МОДЕЛИ ЭМБЕДДИНГОВ nomic-embed-text ===
весь корпус одной строкой: символов 12877 | токенов cl100k 5663
truncate=false: HTTP 400: {"error":"the input length exceeds the context length"}
truncate=true (умолчание): принято без ошибки, prompt_eval_count 2048
На первой границе TokenTextSplitter видно перекрытие, фраза «составляет 28 календарных дней» стоит и в конце первого чанка, и в начале второго. CharacterTextSplitter по двойному переводу строки и рекурсивный сплиттер дали одинаковые 11 чанков, потому что все абзацы короче 128 токенов и спускаться ниже абзаца не пришлось.
Hit rate и MRR при разном размере чанка
Скрипт 02_retrieval_eval.py индексирует корпус в 18 конфигурациях, это четыре стратегии на четырёх размерах от 128 до 1024 токенов cl100k_base, семантическое разбиение и документы целиком без разбиения. Hit@k равен доле вопросов, у которых эталонная подстрока целиком лежит в одном из первых k найденных чанков. MRR@10 (Mean Reciprocal Rank, средний обратный ранг) усредняет величину 1/r, где r это позиция первого такого чанка. Метрика hit@512ток проверяет, попадёт ли ответ в первые 512 токенов склейки найденных чанков, и тем самым уравнивает бюджет контекста. Без неё hit@k систематически выгоден крупным чанкам, ведь чем больше чанк, тем вероятнее в нём нужная подстрока.
# langchain-text-splitters 1.1.3, llama-index-core 0.14.25, llama-index-embeddings-ollama 0.10.0, ollama 0.40.13 с nomic-embed-text, прогнано на стенде 2026-11-07
# Как стратегия и размер чанка влияют на поиск: hit rate@k и MRR по эталонным подстрокам, без LLM.
# Корпус: 8 Markdown-регламентов вымышленной компании, 24 вопроса с подстрокой ответа из корпуса.
import json
import re
import statistics
import time
import urllib.error
import urllib.request
from pathlib import Path

import numpy as np
import tiktoken
from langchain_text_splitters import (
    MarkdownHeaderTextSplitter,
    RecursiveCharacterTextSplitter,
    TokenTextSplitter,
)
from llama_index.core import Document
from llama_index.core.node_parser import SemanticSplitterNodeParser, SentenceSplitter
from llama_index.embeddings.ollama import OllamaEmbedding

HERE = Path(__file__).resolve().parent
OLLAMA = "http://localhost:11434"
MODEL = "nomic-embed-text"
SIZES = [128, 256, 512, 1024]  # размер чанка в токенах cl100k
TOP_K = 3
BUDGET = 512  # бюджет контекста для LLM в токенах: честное сравнение мелких и крупных чанков
CL100K = tiktoken.get_encoding("cl100k_base")

DOCS = {p.name: p.read_text(encoding="utf-8") for p in sorted((HERE / "corpus").glob("*.md"))}
QUESTIONS = [json.loads(line) for line in (HERE / "questions.jsonl").read_text(encoding="utf-8").splitlines() if line]


def norm(text):
    # сплиттеры по-разному склеивают переводы строк, сравниваем текст без учёта пробельных символов
    return re.sub(r"\s+", " ", text)


def overflows(text):
    # не влезает ли чанк в окно модели: с truncate=false Ollama отвечает 400 вместо молчаливой обрезки
    body = {"model": MODEL, "input": ["search_document: " + text], "truncate": False, "keep_alive": "30m"}
    req = urllib.request.Request(OLLAMA + "/api/embed", data=json.dumps(body).encode(),
                                 headers={"Content-Type": "application/json"})
    try:
        with urllib.request.urlopen(req, timeout=600):
            return False
    except urllib.error.HTTPError as e:
        return e.code == 400


def embed(texts):
    # nomic-embed-text обучена с префиксами задачи: search_document для чанков, search_query для вопросов
    out = []
    for i in range(0, len(texts), 32):
        body = {"model": MODEL, "input": texts[i:i + 32], "keep_alive": "30m"}
        req = urllib.request.Request(OLLAMA + "/api/embed", data=json.dumps(body).encode(),
                                     headers={"Content-Type": "application/json"})
        with urllib.request.urlopen(req, timeout=600) as r:
            out.extend(json.load(r)["embeddings"])
    m = np.array(out, dtype=np.float32)
    return m / np.linalg.norm(m, axis=1, keepdims=True)


# --- стратегии: каждая возвращает список чанков-строк для одного документа ---

def fixed(text, size):
    # ровно size токенов, граница не смотрит ни на слова, ни на абзацы
    return TokenTextSplitter(encoding_name="cl100k_base", chunk_size=size, chunk_overlap=size // 8).split_text(text)


def recursive(text, size):
    # сначала абзацы, потом строки, потом слова; длина в токенах cl100k
    return RecursiveCharacterTextSplitter.from_tiktoken_encoder(
        encoding_name="cl100k_base", chunk_size=size, chunk_overlap=size // 8).split_text(text)


def markdown(text, size):
    # граница по заголовкам # и ##, длинный раздел дорезается рекурсивно;
    # заголовки документа и раздела дописываются в начало чанка как контекст
    sections = MarkdownHeaderTextSplitter(headers_to_split_on=[("#", "doc"), ("##", "section")]).split_text(text)
    chunks = []
    for s in sections:
        prefix = " / ".join(v for v in (s.metadata.get("doc"), s.metadata.get("section")) if v)
        for part in recursive(s.page_content, size):
            chunks.append(f"{prefix}\n{part}")
    return chunks


def sentence(text, size):
    # LlamaIndex: собирает чанк из целых предложений до size токенов
    return SentenceSplitter(chunk_size=size, chunk_overlap=size // 8).split_text(text)


def whole(text, size):
    # без разбиения: документ целиком как один чанк
    return [text]


SEMANTIC = SemanticSplitterNodeParser(
    buffer_size=1,
    breakpoint_percentile_threshold=95,
    embed_model=OllamaEmbedding(model_name=MODEL, base_url=OLLAMA, text_instruction="search_document: "),
)


def semantic(text, size):
    # граница там, где близость эмбеддингов соседних предложений резко падает; размер не задаётся
    return [n.get_content() for n in SEMANTIC.get_nodes_from_documents([Document(text=text)])]


def within_budget(order, chunks):
    # склеиваем найденные чанки по рангу, пока не кончится бюджет; последний обрезаем по токенам
    ids = []
    for i in order:
        ids.extend(CL100K.encode(chunks[i][1] + "\n"))
        if len(ids) >= BUDGET:
            break
    return norm(CL100K.decode(ids[:BUDGET]))


def evaluate(name, split, size, qvecs):
    t0 = time.time()
    chunks = [(doc, c) for doc, text in DOCS.items() for c in split(text, size)]
    t_split = time.time() - t0
    t0 = time.time()
    cvecs = embed(["search_document: " + c for _, c in chunks])
    t_embed = time.time() - t0

    texts = [norm(c) for _, c in chunks]
    sims = qvecs @ cvecs.T
    hits1 = hits3 = rr = cut = hits_budget = 0
    ctx_tokens = []
    for q, row in zip(QUESTIONS, sims):
        order = np.argsort(-row)
        gold = norm(q["answer"])
        if not any(gold in t for t in texts):
            cut += 1  # ответ разрезан границей чанка: ни один чанк не содержит его целиком
        ranks = [r for r, i in enumerate(order[:10], start=1) if gold in texts[i]]
        if ranks:
            rr += 1 / ranks[0]
            hits1 += ranks[0] == 1
            hits3 += ranks[0] <= TOP_K
        hits_budget += gold in within_budget(order, chunks)
        ctx_tokens.append(sum(len(CL100K.encode(chunks[i][1])) for i in order[:TOP_K]))
    n = len(QUESTIONS)
    toks = [len(CL100K.encode(c)) for _, c in chunks]
    # русский текст в токенизаторе nomic примерно вдвое длиннее, чем в cl100k: проверяем только длинные чанки
    over = sum(overflows(c) for (_, c), t in zip(chunks, toks) if t > 800)
    print(f"{name:<10} {size if size else '—':>5} | чанков {len(chunks):>3} | сред. токенов {round(statistics.mean(toks)):>4} | "
          f"hit@1 {hits1 / n:.2f} | hit@3 {hits3 / n:.2f} | MRR@10 {rr / n:.2f} | hit@{BUDGET}ток {hits_budget / n:.2f} | разрезано {cut:>2} | "
          f"контекст top-3 {round(statistics.mean(ctx_tokens)):>4} ток. | длиннее окна {over} | разбиение {t_split:5.1f} с, эмбеддинги {t_embed:5.1f} с",
          flush=True)


print(f"корпус: {len(DOCS)} документов, {sum(len(t) for t in DOCS.values())} символов, "
      f"{sum(len(CL100K.encode(t)) for t in DOCS.values())} токенов cl100k; вопросов {len(QUESTIONS)}")
print("перекрытие везде size // 8; hit@k: эталонная подстрока целиком внутри одного из k найденных чанков")
print(f"hit@{BUDGET}ток: подстрока внутри первых {BUDGET} токенов склейки найденных чанков по рангу")
print()
qvecs = embed(["search_query: " + q["question"] for q in QUESTIONS])
for size in SIZES:
    for name, split in (("fixed", fixed), ("recursive", recursive), ("markdown", markdown), ("sentence", sentence)):
        evaluate(name, split, size, qvecs)
    print()
evaluate("semantic", semantic, 0, qvecs)
evaluate("whole", whole, 0, qvecs)
Прогон занял 610 секунд, из них по 25-35 секунд на эмбеддинги корпуса в каждой конфигурации. Ключевые колонки вывода сведены в таблицу.
| Стратегия | Размер, токенов | Чанков | Средний чанк, токенов | hit@1 | hit@3 | MRR@10 | hit@512ток | Контекст top-3, токенов |
|---|---|---|---|---|---|---|---|---|
| fixed | 128 | 54 | 118 | 0.08 | 0.21 | 0.17 | 0.21 | 376 |
| recursive | 128 | 71 | 83 | 0.29 | 0.46 | 0.41 | 0.67 | 261 |
| markdown | 128 | 69 | 96 | 0.29 | 0.38 | 0.39 | 0.54 | 288 |
| sentence | 128 | 59 | 97 | 0.25 | 0.46 | 0.38 | 0.50 | 301 |
| fixed | 256 | 29 | 218 | 0.25 | 0.67 | 0.45 | 0.58 | 675 |
| recursive | 256 | 30 | 194 | 0.33 | 0.58 | 0.49 | 0.54 | 579 |
| markdown | 256 | 43 | 142 | 0.46 | 0.54 | 0.52 | 0.54 | 423 |
| sentence | 256 | 29 | 203 | 0.29 | 0.46 | 0.43 | 0.46 | 623 |
| fixed | 512 | 16 | 386 | 0.33 | 0.62 | 0.50 | 0.46 | 942 |
| recursive | 512 | 16 | 361 | 0.25 | 0.50 | 0.44 | 0.46 | 849 |
| markdown | 512 | 43 | 142 | 0.46 | 0.54 | 0.52 | 0.54 | 423 |
| sentence | 512 | 17 | 356 | 0.33 | 0.62 | 0.51 | 0.46 | 942 |
| fixed | 1024 | 8 | 708 | 0.62 | 0.88 | 0.76 | 0.46 | 2233 |
| recursive | 1024 | 8 | 708 | 0.62 | 0.88 | 0.76 | 0.46 | 2233 |
| markdown | 1024 | 43 | 142 | 0.46 | 0.54 | 0.52 | 0.54 | 423 |
| sentence | 1024 | 8 | 708 | 0.62 | 0.88 | 0.76 | 0.46 | 2233 |
| semantic | не задаётся | 16 | 354 | 0.38 | 0.54 | 0.50 | 0.42 | 1046 |
| whole | не задаётся | 8 | 708 | 0.62 | 0.88 | 0.76 | 0.46 | 2233 |
Цифры читаются с оговорками, демо не подгонялось под ожидания.
- При равном бюджете контекста лучшим оказался recursive на 128 токенах. Его hit@512ток равен 0.67, тогда как документы целиком и чанки fixed, recursive и sentence на 512-1024 токена дают 0.46. Мелкий размер сам по себе не спасает, fixed на 128 токенах даёт худшие 0.21.
- Крупные чанки берут hit@3 ценой контекста. На 1024 токенах hit@3 равен 0.88, но в контекст уходит 2233 токена против 261 у recursive на 128. Все документы корпуса короче 1024 токенов, такой чанк совпадает с документом целиком, и поиск вырождается в выбор трёх документов из восьми.
- Фиксированный размер плох только на мелких чанках. На 128 токенах у fixed худший hit@1, 0.08 против 0.25-0.29 у остальных, а на 256 у него лучший hit@3 среди стратегий того же размера, 0.67.
- Разбиение по заголовкам чаще всего ставит ответ первым. Среди конфигураций со средним чанком до 200 токенов лучший hit@1 и MRR у markdown со средним чанком 142 токена, 0.46 и 0.52. Разделы регламентов короче 256 токенов, поэтому начиная с 256 строки markdown одинаковые.
- Семантическое разбиение не окупилось. Его hit@3 0.54 против 0.50-0.62 у чанков сопоставимого размера, а само разбиение заняло 70.6 секунды против долей секунды у остальных стратегий.
Абсолютный уровень метрик невысокий, а 24 вопроса дают шаг доли 0.04, поэтому разница в 0.04-0.08 означает один-два вопроса. Демо показывает метод выбора, а не победителя.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Заключение
Chunking определяет единицу поиска в RAG, и ошибку на этом этапе не исправят ни модель эмбеддингов, ни реранкер. Разумная отправная точка это рекурсивный сплиттер с размером в токенах, небольшим перекрытием и заголовками разделов в метаданных. Перед сменой стратегии стоит проверить, в каких единицах считается chunk_size и влезает ли чанк в окно модели эмбеддингов, а сам размер выбирать замером hit rate при фиксированном бюджете контекста на своих вопросах.