
 13
Содержание
- Что такое LlamaIndex и какую задачу он решает
- Архитектура и ключевые компоненты
- Коннекторы данных и индексы
- Query engines, chat engines и retrievers
- Агенты и workflows поверх данных
- Принцип работы RAG-пайплайна под капотом
- От индексатора для RAG к агентному фреймворку
- Чем LlamaIndex отличается от LangChain
- Ограничения и когда RAG не подходит
- Сценарии использования и когда LlamaIndex не нужен
- Базовый RAG-пайплайн на LlamaIndex на практике
- Заключение
- Референсные ссылки
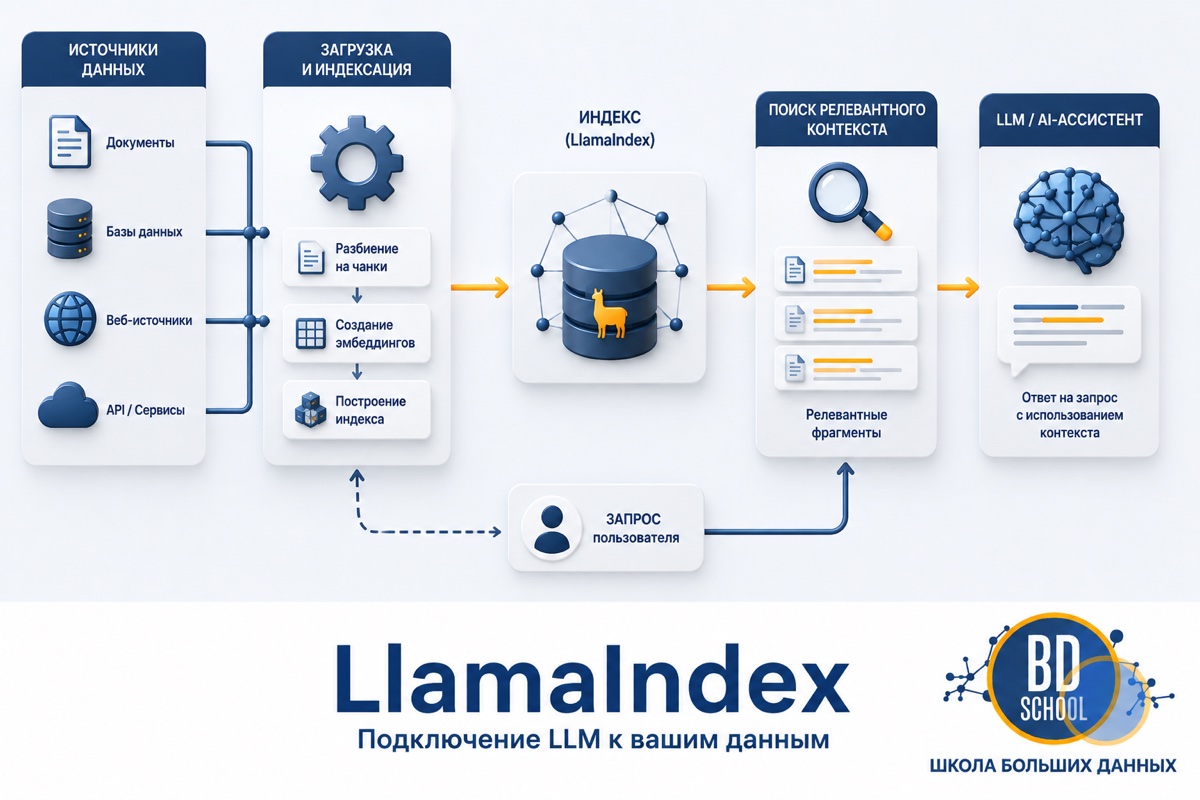
LlamaIndex — это фреймворк с открытым исходным кодом на Python, который подключает приватные и корпоративные данные к большим языковым моделям (LLM, Large Language Model). Задача LlamaIndex простая на словах и сложная на практике, потому что модель ничего не знает о внутренних документах компании, и фреймворк берёт на себя загрузку, индексацию и поиск нужных фрагментов, чтобы отдать их модели вместе с вопросом пользователя. В экосистеме RAG-инструментов (Retrieval-Augmented Generation) LlamaIndex занимает нишу дата-слоя, тогда как соседний по популярности LangChain больше сфокусирован на оркестрации цепочек вызовов.
Что такое LlamaIndex и какую задачу он решает
Официальный обзор фреймворка формулирует назначение LlamaIndex как «ведущий инструмент для построения LLM-агентов поверх ваших данных с использованием LLM и workflows». Ключевая идея, которую разработчики называют context augmentation, состоит в том, что модель сама по себе не имеет доступа к приватным и доменным данным. LlamaIndex делает эти данные доступными во время инференса, в первую очередь через RAG-пайплайн, а не через дообучение модели.
Для новичка фреймворк даёт запуск в пять строк кода на готовых компонентах по умолчанию. Для продвинутого разработчика те же компоненты открываются на уровень ниже, вплоть до собственного алгоритма чанкинга или собственной логики ранжирования найденных фрагментов. Именно эта двухслойность, простой высокоуровневый API поверх настраиваемых низкоуровневых блоков, отличает LlamaIndex от однослойных инструментов индексации.
Архитектура и ключевые компоненты
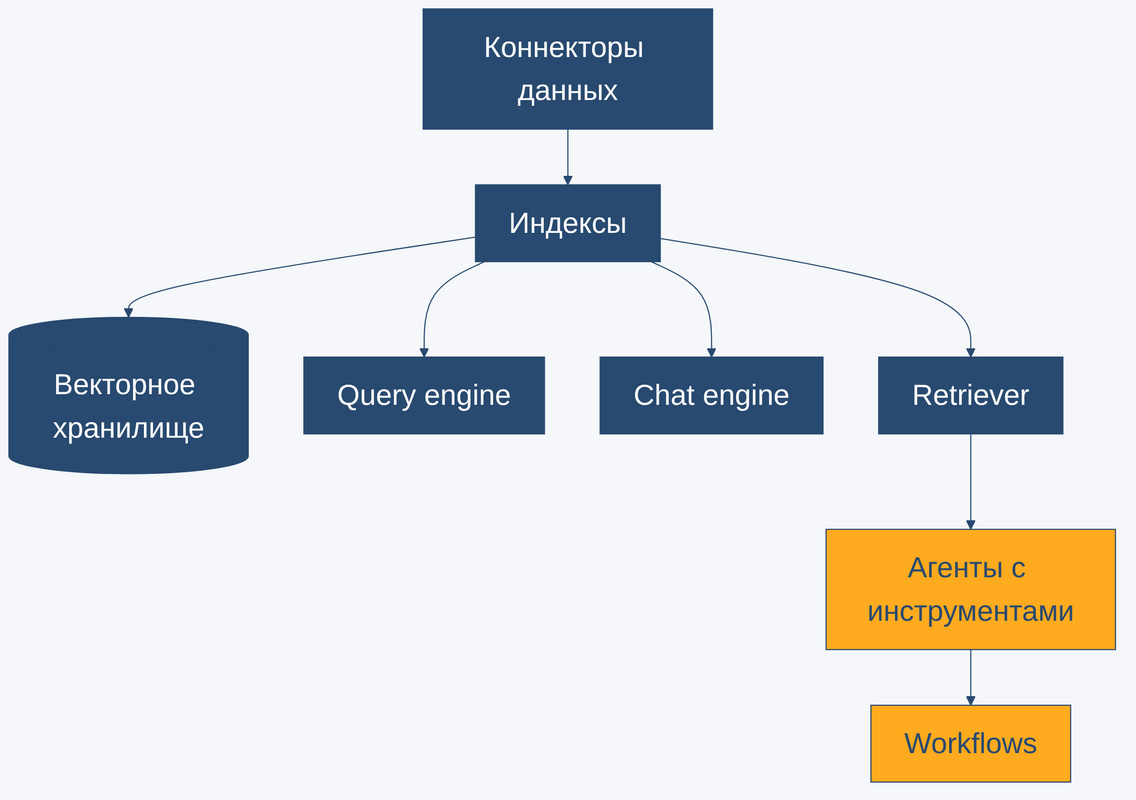
Документация группирует внутренние блоки LlamaIndex в четыре зоны ответственности, управление данными, запросы и взаимодействие, агенты и инфраструктура. По заявлению разработчиков, фреймворк поддерживает более ста интеграций с LLM, векторными базами данных и провайдерами эмбеддингов, поэтому конкретная реализация каждого блока подбирается под стек, который уже есть у компании.
Коннекторы данных и индексы
Data connectors загружают данные из источников любого рода, от PDF и API до таблиц SQL, и превращают их в объекты Document. Дальше data indexes разбивают документ на более мелкие единицы, Node, и структурируют их так, чтобы модель эмбеддингов и векторное хранилище могли с ними работать. Разбиением по умолчанию занимается SentenceSplitter с параметрами chunk_size и chunk_overlap, и в llama-index-core 0.14.24 их дефолтные значения равны 1024 и 200 соответственно.
Важная деталь, которую документация явно не проговаривает и которую пришлось проверить прогоном. Число в chunk_size измеряется в токенах внутреннего токенизатора, а не в символах строки. На кириллическом тексте один токен занимает заметно больше двух символов, поэтому чанк, собранный с chunk_size=256, на практике вышел размером 480-566 символов, а не около 256. Планировать размер контекста под контекстное окно модели нужно по токенам, а не по интуитивной оценке длины строки.
Query engines, chat engines и retrievers
Query engine отвечает на разовый вопрос по проиндексированным данным, chat engine удерживает историю диалога поверх того же индекса, а retriever отвечает только за поиск релевантных Node без генерации финального текста. Такое разделение позволяет собирать нестандартные пайплайны, например заменить retriever на гибридный поиск, не трогая остальную цепочку. Как именно векторные базы данных хранят эмбеддинги и отвечают на запрос по сходству, разобрано в материале об ИИ и векторных базах данных.
Нейронные сети на Python
Код курса
PYNN
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Агенты и workflows поверх данных
Верхний слой архитектуры это агенты, которые используют инструменты (tools) для исследовательских и операционных задач, и workflows, которые связывают несколько агентов и источников данных в единый процесс. Рядом стоит инфраструктурный слой, observability и evaluation для контроля качества ответов, и подсистема персистентного хранения поверх векторных баз данных.
Принцип работы RAG-пайплайна под капотом
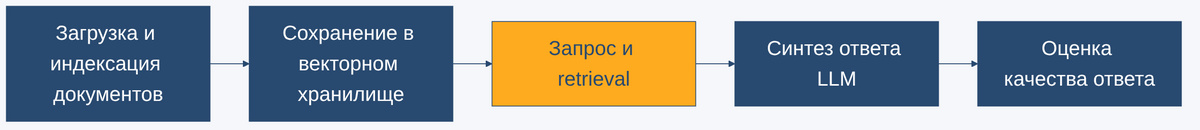
Getting Started документации описывает RAG-пайплайн LlamaIndex как последовательность из пяти стадий. Loading and Indexing загружает данные и организует их в индекс вместо того, чтобы отправлять модели весь корпус целиком. Storing сохраняет проиндексированные данные в векторном хранилище для последующего извлечения. Querying and Retrieval находит и достаёт релевантные фрагменты по запросу пользователя. Response Synthesis объединяет извлечённый контекст с исходным вопросом перед отправкой в LLM. Evaluation оценивает качество итогового ответа отдельными метриками.
На демо-корпусе из шести документов, регламентов внутри вымышленной компании, вся индексация заняла 0.91 с, а полный запрос от вопроса до готового ответа, включая retrieval и генерацию через локальную модель qwen2.5:7b на Ollama (открытом инструменте для запуска LLM на своей машине без обращения к облаку), занял 10.46 с. Подробный код и вывод собраны в практическом разделе ниже. Похожий пайплайн, только поверх графовой базы данных вместо чисто векторного индекса, разобран в материале о поддержке векторного индекса в Neo4j для RAG-приложений.
От индексатора для RAG к агентному фреймворку
Более ранние описания LlamaIndex, знакомые тем, кто следит за экосистемой LLM больше года, называли проект data framework для RAG, инструментом индексации данных под задачу вопрос-ответ. Текущая формулировка на developers.llamaindex.ai уже ставит на первое место агентов и workflows, а RAG упоминается как один из сценариев применения, а не единственное назначение фреймворка.
Это наблюдение стоит воспринимать как гипотезу, а не как подтверждённый факт смены версий. Прямое сравнение архивных версий страницы «What is LlamaIndex» не проводилось, поэтому статья не утверждает точную дату сдвига акцента, только фиксирует, что современная документация формулирует его иначе, чем помнят опытные пользователи RAG-инструментов.
Чем LlamaIndex отличается от LangChain
LlamaIndex и LangChain на практике часто оказываются в одном стеке, но решают разные по акценту задачи. Таблица ниже сводит ключевые отличия.
| Критерий | LlamaIndex | LangChain |
|---|---|---|
| Основной фокус | Данные, индексация и retrieval | Оркестрация цепочек вызовов и агентов |
| Сильная сторона | Продвинутые стратегии индексации и запросов к разнородным источникам | Гибкая композиция шагов, инструментов и провайдеров LLM |
| Типичная точка входа | Корпус документов, который нужно сделать доступным модели | Сценарий или процесс, который нужно автоматизировать |
| Когда берут вместе | LlamaIndex строит и обслуживает индекс | LangChain оборачивает его в более широкий агентный процесс |
Граница между инструментами размыта не случайно, оба развиваются в сторону агентов и workflows, поэтому выбор часто определяется тем, какой API уже освоен командой, а не жёстким разделением возможностей.
Ограничения и когда RAG не подходит
Документация LlamaIndex прямо называет ситуации, где RAG-подход, реализуемый фреймворком, работает хуже альтернатив.
- Вычисления в реальном времени. Retrieval и синтез ответа добавляют задержку, которая неприемлема там, где ответ нужен без заметной паузы.
- Сложное многошаговое рассуждение. RAG хорошо достаёт факты, но не заменяет модель, которую нужно провести через длинную цепочку логических выводов.
- Случаи, где эффективнее дообучить модель. Если нужный стиль или узкая предметная область должны стать частью самой модели, а не контекста запроса, fine-tune специализированной модели может обойтись дешевле RAG-пайплайна в эксплуатации.
Ни один из этих пунктов не запрещает использовать LlamaIndex, они лишь очерчивают границу, за которой чистый RAG перестаёт быть лучшим инструментом для задачи.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Сценарии использования и когда LlamaIndex не нужен
Фреймворк подходит для построения data-backed LLM-приложений, где нужно подключить приватную или доменную информацию, вопрос-ответных систем по внутренней базе знаний, чат-ботов поддержки и извлечения структурированных данных из проприетарных источников. Курс «ИИ-агенты для оптимизации бизнес-процессов» разбирает именно такие блоки, загрузку документов, индексацию и retrieval, на практике поверх LangGraph, LangChain и векторных баз данных.
LlamaIndex не нужен, если данные помещаются целиком в контекстное окно модели без всякого поиска, если задача не про данные компании, а про общие знания, уже доступные модели, или если продукту важнее консистентный стиль ответа, чем свежие факты, и дообучение решает эту задачу лучше поиска по индексу.
Базовый RAG-пайплайн на LlamaIndex на практике
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Первый пример показывает, как SentenceSplitter режет длинный документ на Node, и на каком именно чанке становится видно перекрытие chunk_overlap.
# llama-index-core 0.14.24, прогнано на стенде 2026-08-26
"""
Демонстрирует, как LlamaIndex разбивает Document на Node при индексации:
дефолтный SentenceSplitter, размер чанка, перекрытие и границы между узлами.
"""
from llama_index.core import Document
from llama_index.core.node_parser import SentenceSplitter

# Один длинный документ: свод правил компании про доступ к базам данных.
# Специально длиннее одного чанка, чтобы splitter разрезал его на несколько Node.
LONG_DOC_TEXT = """
Регламент доступа к продуктивным базам данных компании определяет порядок выдачи,
контроля и отзыва прав на боевые СУБД. Любой доступ к продуктивным базам данных
выдаётся только через заявку в системе управления доступом и требует подтверждения
непосредственного руководителя и владельца системы. Прямой доступ разработчиков
к таблицам с персональными данными клиентов запрещён без отдельного согласования
службы безопасности, даже при наличии действующей заявки на общий доступ к базе.

Доступ на чтение выдаётся сроком на девяносто дней и продлевается повторной заявкой,
доступ на запись - сроком на тридцать дней с обязательным указанием задачи, для
которой он нужен. По истечении срока доступ отзывается автоматически системой
управления доступом без дополнительного уведомления пользователя, поэтому заявку
на продление стоит подавать заранее, за три-пять рабочих дней до истечения срока.

Все действия с продуктивными базами данных логируются на уровне СУБД и хранятся
не менее одного года. Логи доступны службе безопасности и аудиторам по запросу.
Попытка обойти логирование, например через локальный дамп базы данных на рабочую
станцию, является нарушением регламента и основанием для немедленного отзыва
всех прав доступа сотрудника, независимо от роли и стажа работы в компании.

Экстренный доступ (hotfix) в нерабочее время выдаётся дежурным инженером через
отдельную процедуру эскалации и подлежит обязательному постфактум-согласованию
в течение одного рабочего дня. Если постфактум-согласование не получено, доступ
считается выданным с нарушением регламента, и инцидент передаётся на разбор
в комитет по информационной безопасности для дальнейшего решения.
""".strip()


def main():
    document = Document(text=LONG_DOC_TEXT, metadata={"title": "Регламент доступа к продуктивным БД"})
    print("Длина исходного документа:", len(document.text), "символов")

    # Дефолтные параметры SentenceSplitter в llama-index-core 0.14.24
    default_splitter = SentenceSplitter()
    print("Дефолтный chunk_size:", default_splitter.chunk_size)
    print("Дефолтный chunk_overlap:", default_splitter.chunk_overlap)

    # Наш документ короче дефолтного chunk_size (1024), поэтому для демонстрации
    # реального разбиения на несколько Node берём чанк заметно меньше документа.
    demo_splitter = SentenceSplitter(chunk_size=256, chunk_overlap=40)
    nodes = demo_splitter.get_nodes_from_documents([document])

    print(f"\nДокумент разбит на {len(nodes)} Node (chunk_size=256, chunk_overlap=40):")
    for i, node in enumerate(nodes):
        text = node.get_content()
        print(f"  Node {i}: {len(text)} символов")
        print(f"    начало: {text[:60]!r}")
        print(f"    конец:  {text[-60:]!r}")

    # Перекрытие видно по совпадению хвоста одного узла с началом следующего.
    if len(nodes) >= 2:
        tail_of_first = nodes[0].get_content()[-40:]
        head_of_second = nodes[1].get_content()[:40]
        print("\nХвост Node 0 (40 симв.):", repr(tail_of_first))
        print("Начало Node 1 (40 симв.):", repr(head_of_second))


if __name__ == "__main__":
    main()
Так выглядит реальный вывод прогона.
Длина исходного документа: 1669 символов
Дефолтный chunk_size: 1024
Дефолтный chunk_overlap: 200

Документ разбит на 4 Node (chunk_size=256, chunk_overlap=40):
  Node 0: 486 символов
    начало: 'Регламент доступа к продуктивным базам данных компании опред'
    конец:  ' даже при наличии действующей заявки на общий доступ к базе.'
  Node 1: 566 символов
    начало: 'Доступ на чтение выдаётся сроком на девяносто дней и продлев'
    конец:  'а. Логи доступны службе безопасности и аудиторам по запросу.'
  Node 2: 481 символов
    начало: 'Логи доступны службе безопасности и аудиторам по запросу.\nПо'
    конец:  'ьному постфактум-согласованию\nв течение одного рабочего дня.'
  Node 3: 190 символов
    начало: 'Если постфактум-согласование не получено, доступ\nсчитается в'
    конец:  'итет по информационной безопасности для дальнейшего решения.'

Хвост Node 0 (40 симв.): 'йствующей заявки на общий доступ к базе.'
Начало Node 1 (40 симв.): 'Доступ на чтение выдаётся сроком на девя'
Перекрытие проявилось не на каждой границе. Между Node 0 и Node 1 хвост и начало не совпали, потому что разрыв пришёлся ровно на конец предложения. Между Node 1 и Node 2 повтор виден буквально, оба узла содержат фразу «Логи доступны службе безопасности и аудиторам по запросу», потому что там splitter разрезал многосоставный абзац посередине. SentenceSplitter режет по границам предложений, а не механически по символам, поэтому дословное перекрытие это не гарантия, а побочный эффект того, где именно прошла граница чанка.
Второй пример собирает полноценный RAG-пайплайн поверх шести коротких документов, регламентов вымышленной компании, и отвечает на вопрос пользователя только по их содержимому.
# llama-index-core 0.14.24, llama-index-llms-ollama 0.10.1, llama-index-embeddings-ollama 0.9.0
# модели: ollama qwen2.5:7b (LLM) и nomic-embed-text (эмбеддинги), прогнано на стенде 2026-08-26
"""
Базовый RAG-пайплайн на LlamaIndex поверх локальной Ollama:
Loading & Indexing -> Storing -> Querying & Retrieval -> Response Synthesis.
Корпус - внутренняя база знаний компании, вопрос пользователя закрывается
одним конкретным документом, остальные документы намеренно про смежные темы.
"""
import time

from llama_index.core import Document, VectorStoreIndex, Settings
from llama_index.embeddings.ollama import OllamaEmbedding
from llama_index.llms.ollama import Ollama

# Модель для генерации ответа и модель для эмбеддингов задаются глобально через Settings,
# дальше индекс и query engine используют их без явной передачи в каждый вызов.
Settings.llm = Ollama(model="qwen2.5:7b", request_timeout=120)
Settings.embed_model = OllamaEmbedding(model_name="nomic-embed-text")

KNOWLEDGE_BASE = [
    Document(
        text=(
            "Регламент доступа к продуктивным базам данных: доступ на чтение выдаётся "
            "на 90 дней, на запись - на 30 дней, оформляется заявкой в системе управления "
            "доступом с подтверждением руководителя и владельца системы."
        ),
        metadata={"title": "Доступ к продуктивным БД"},
    ),
    Document(
        text=(
            "Регламент удалённой работы: сотрудник вправе работать удалённо до трёх дней "
            "в неделю по согласованию с руководителем, подключение к внутренним сервисам "
            "только через корпоративный VPN с двухфакторной аутентификацией."
        ),
        metadata={"title": "Удалённая работа и VPN"},
    ),
    Document(
        text=(
            "Порядок оформления отпуска: заявление подаётся в кадровую систему не позднее "
            "чем за две недели до даты начала отпуска, график отпусков утверждается "
            "руководителем подразделения в начале календарного года."
        ),
        metadata={"title": "Оформление отпуска"},
    ),
    Document(
        text=(
            "Возврат корпоративного оборудования: при увольнении сотрудник обязан сдать "
            "ноутбук, пропуск и токены доступа в течение последнего рабочего дня, иначе "
            "стоимость оборудования удерживается из расчёта при увольнении."
        ),
        metadata={"title": "Возврат оборудования"},
    ),
    Document(
        text=(
            "Регламент код-ревью: любой пул-реквест в основную ветку требует минимум одного "
            "одобрения от другого разработчика команды, автоматические проверки (линтер, "
            "тесты) должны пройти до запроса ревью."
        ),
        metadata={"title": "Код-ревью"},
    ),
    Document(
        text=(
            "Порядок компенсации обучения: компания возмещает стоимость курсов повышения "
            "квалификации до 100 000 рублей в год при условии, что сотрудник отработает "
            "в компании не менее года после окончания курса."
        ),
        metadata={"title": "Компенсация обучения"},
    ),
]


def main():
    t0 = time.time()
    index = VectorStoreIndex.from_documents(KNOWLEDGE_BASE)
    print(f"Индексация {len(KNOWLEDGE_BASE)} документов заняла {time.time() - t0:.2f} с")
    print("Узлов (Node) в индексе:", len(index.docstore.docs))

    query_engine = index.as_query_engine(similarity_top_k=2)

    question = "Сколько времени действует доступ на запись к продуктивной базе данных?"
    print(f"\nВопрос: {question}")

    t0 = time.time()
    response = query_engine.query(question)
    elapsed = time.time() - t0

    print(f"Ответ ({elapsed:.2f} с): {response}")

    print("\nИсточники, которые ушли в контекст LLM (Retrieval):")
    for node_with_score in response.source_nodes:
        title = node_with_score.node.metadata.get("title")
        print(f"  score={node_with_score.score:.4f}  [{title}]  {node_with_score.node.get_content()[:70]!r}")


if __name__ == "__main__":
    main()
Так выглядит реальный вывод прогона.
Индексация 6 документов заняла 0.91 с
Узлов (Node) в индексе: 6

Вопрос: Сколько времени действует доступ на запись к продуктивной базе данных?
Ответ (10.46 с): Доступ на запись к продуктивной базе данных действует на протяжении 30 дней.

Источники, которые ушли в контекст LLM (Retrieval):
  score=0.8180  [Доступ к продуктивным БД]  'Регламент доступа к продуктивным базам данных: доступ на чтение выдаёт'
  score=0.7605  [Оформление отпуска]  'Порядок оформления отпуска: заявление подаётся в кадровую систему не п'
Ответ верный, документ про доступ к базам данных действительно называет 30 дней сроком доступа на запись. Но список источников честно показывает слабое место демо. Вторым по score попал документ про отпуска, тематически никак не связанный с вопросом, и его score 0.7605 расположен почти вплотную к правильному 0.8180. Причина в том, что интеграция llama-index-embeddings-ollama не подставляет автоматически task-префиксы search_query и search_document, которые модель nomic-embed-text ожидает как асимметричная модель эмбеддингов. Без них сходство между документами считается менее точно, и на маленьком корпусе это может поднять случайный документ ближе к вершине списка. Итоговый ответ модели при этом остался верным, потому что первый по score документ всё же оказался релевантным, но на большем корпусе такая погрешность в ранжировании способна испортить ответ целиком.
Заключение
LlamaIndex закрывает конкретный участок стека LLM-приложений, превращение разрозненных корпоративных данных в структуру, по которой модель может искать и отвечать. Фреймворк одинаково честно работает и как пятистрочный quick start, и как набор настраиваемых блоков для нестандартного пайплайна, а его развитие в сторону агентов и workflows показывает, что RAG сегодня это один из сценариев применения, а не единственная причина существования проекта.
Референсные ссылки
- Framework overview, официальная документация LlamaIndex, архитектурные компоненты и общее назначение фреймворка
- Getting Started, Concepts, стадии RAG-пайплайна и границы применимости RAG
- Releases репозитория run-llama/llama_index на GitHub, история версий фреймворка
- Changelog официальной документации LlamaIndex, журнал изменений по релизам