
 71
Содержание
- Что такое reranking и какую задачу решает
- Архитектура bi-encoder retrieval и cross-encoder reranking
- Bi-encoder против cross-encoder
- Место reranking в pipeline поиска и RAG
- Принцип работы cross-encoder под капотом
- Совместное кодирование пары запрос-документ
- Сырые логиты против нормализованной шкалы 0-1
- Ограничения и подводные камни
- Почему cross-encoder не масштабируется на весь корпус
- Нелинейность relevance score и калибровка порога
- Reranking как сервис и как библиотека
- Когда применять reranking, а когда не стоит
- Практика переранжирования результатов векторного поиска
- Baseline, поиск по эмбеддингам
- Reranking cross-encoder и сравнение порядка выдачи
- Заключение
- Референсные ссылки
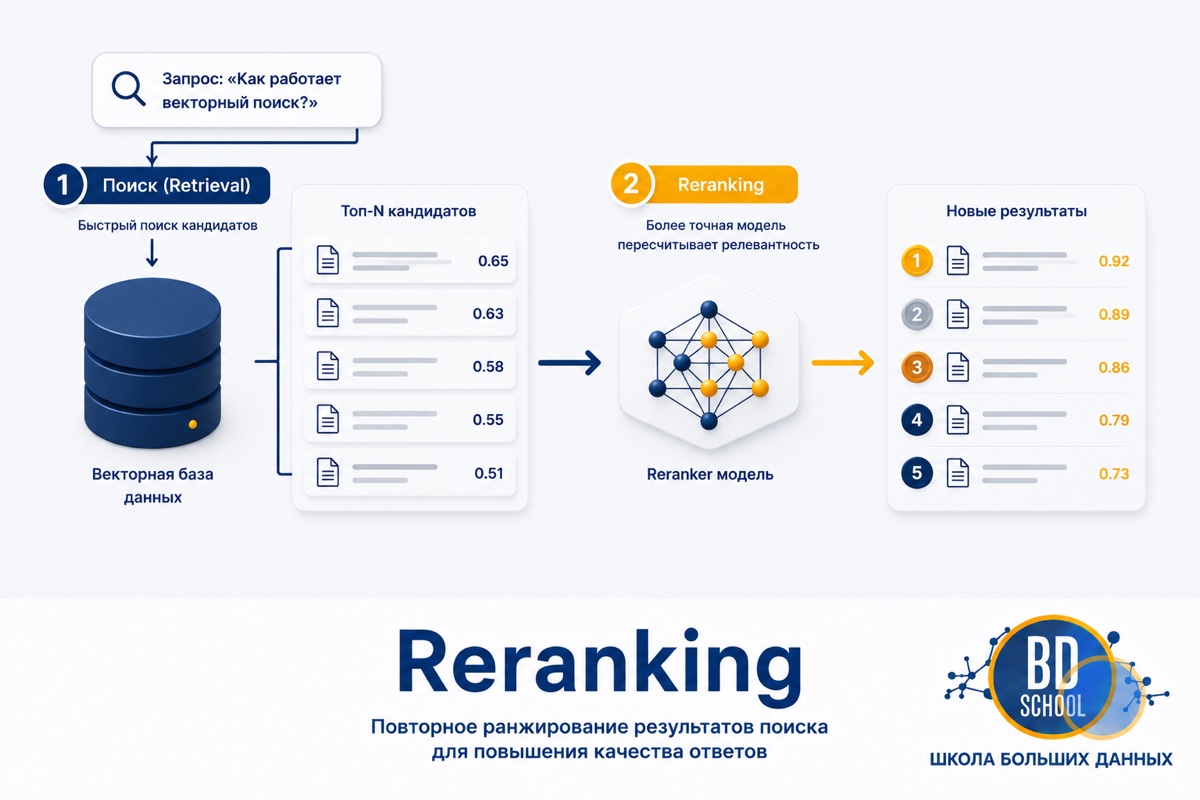
Реранкинг, или переранжирование результатов поиска (reranking), это дополнительный этап в конвейере поиска, на котором система пересчитывает релевантность уже отобранных кандидатов и меняет их порядок перед тем, как выдать ответ пользователю или передать контекст языковой модели. Термин особенно часто встречается в приложениях RAG (Retrieval-Augmented Generation), где от порядка документов в контексте напрямую зависит качество ответа модели.
Что такое reranking и какую задачу решает
Быстрый поиск по векторной базе или по лексическому индексу BM25 (алгоритм ранжирования по совпадению термов, используется, например, в Elasticsearch) отбирает кандидатов, похожих на запрос, но похожий и отвечающий по существу это не одно и то же. Документ может упоминать те же слова и ту же тему, что и запрос, и получать высокое сходство эмбеддингов, но не содержать ответа на конкретный вопрос. Reranking решает именно эту задачу. Он берёт уже отобранный короткий список кандидатов и пересчитывает их релевантность более точной, хотя и более медленной моделью, которая смотрит на пару запрос-документ целиком, а не сравнивает два отдельных вектора.
Из-за высокой цены такого пересчёта reranking почти никогда не применяется ко всему корпусу. Его место во втором проходе, после того как первый, дешёвый этап уже сократил тысячи или миллионы документов до десятков.
Архитектура bi-encoder retrieval и cross-encoder reranking
Двухэтапная архитектура строится на двух принципиально разных моделях, у каждой своя роль и своя цена вычисления.
Bi-encoder против cross-encoder
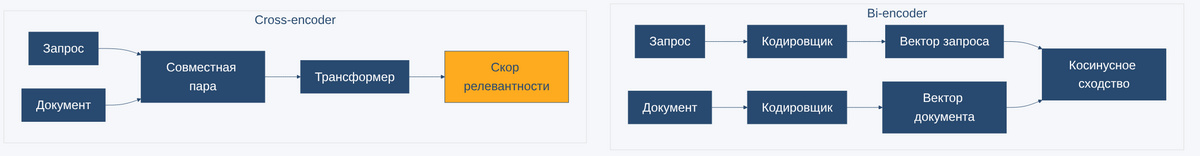
Bi-encoder (би-энкодер) кодирует запрос и документ независимо друг от друга. Каждый текст превращается в вектор эмбеддинга заранее, а на этапе поиска сравниваются уже готовые числа через косинусное сходство. Это позволяет один раз посчитать эмбеддинги для всего корпуса, сохранить их в векторной базе и искать по ним со скоростью приближённого поиска соседей. Устройство такого конвейера подробно разобрано в материале ИИ и векторные базы данных: как это работает?
Cross-encoder (кросс-энкодер) устроен иначе. Он не кодирует запрос и документ по отдельности, а подаёт пару текстов в трансформер совместно и на выходе получает один скор релевантности именно для этой пары. Совместное кодирование позволяет модели видеть оба текста одновременно и улавливать взаимосвязь между ними, поэтому cross-encoder точнее bi-encoder. Платой служит невозможность переиспользовать вычисление между разными парами, на каждую пару запрос-документ нужен отдельный проход модели, а значит cross-encoder заметно медленнее.
Место reranking в pipeline поиска и RAG
Типовой конвейер строится в два шага. Сначала bi-encoder или лексический поиск вроде BM25 быстро отбирает top-N кандидатов, условно от нескольких десятков до нескольких сотен документов, из всего корпуса. Затем cross-encoder пересчитывает релевантность только этого короткого списка и переранжирует его, оставляя для дальнейшей работы top-K лучших документов. В приложениях RAG именно этот top-K становится контекстом, который система передаёт языковой модели вместе с вопросом пользователя. Подход к построению таких приложений разобран в статье RAG-приложения и Neo4j: поддержка векторного индекса для LLM

Нейронные сети на Python
Код курса
PYNN
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Принцип работы cross-encoder под капотом
Механизм cross-encoder отличается от bi-encoder именно тем, как пара текстов встречается внутри модели.
Совместное кодирование пары запрос-документ
На вход трансформера подаётся не два отдельных текста, а одна последовательность, где запрос и документ склеены через специальный разделительный токен. Модель обрабатывает эту последовательность целиком, и внимание между токенами запроса и токенами документа считается напрямую, а не восстанавливается по двум заранее посчитанным векторам. На выходе стоит один линейный слой, который превращает представление пары в единственное число, скор релевантности. Архитектура и формат вызова описаны в документации Sentence Transformers CrossEncoder
Сырые логиты против нормализованной шкалы 0-1
Модели, обученные на наборе MS MARCO (эталонный датасет Microsoft для задач поиска и ранжирования), вроде cross-encoder/ms-marco-MiniLM-L-6-v2, на выходе отдают сырой логит, а не число от 0 до 1. Для порядка документов это не проблема, ранжирование строится на сравнении логитов между собой. Если нужна интерпретируемая шкала, логит пропускают через сигмоиду, но само по себе значение от 0 до 1 моделями на MS MARCO не гарантировано.
Ограничения и подводные камни
Почему cross-encoder не масштабируется на весь корпус
Раздельное кодирование bi-encoder позволяет посчитать эмбеддинг документа один раз и переиспользовать его для любого будущего запроса. У cross-encoder такой возможности нет. Каждая новая пара запрос-документ требует отдельного прохода через трансформер, поэтому оценить сходу миллион документов невозможно, только десятки или сотни кандидатов. У коммерческого API Cohere Rerank это ограничение закреплено формально, документация задаёт жёсткий потолок в 10000 документов на один запрос и отдельно рекомендует не превышать 1000.
Нелинейность relevance score и калибровка порога
У сервисов вроде Cohere Rerank relevance score изначально нормализован в диапазон от 0 до 1, что выглядит удобнее сырого логита, но создаёт свою ловушку. Документация Cohere прямо предупреждает, что шкала нелинейна, и скор 0.91 не означает вдвое большую релевантность, чем скор 0.44. Порог отсечения рекомендуют калибровать эмпирически, на тестовом наборе из 30-50 запросов с пограничными по релевантности документами, а не жёстко фиксировать число вроде 0.5 как границу между релевантным и нерелевантным.
Есть и менее очевидная ловушка, которая всплывает уже на своём стенде, а не в документации. Конструктор класса CrossEncoder в Sentence Transformers инициализируется не мгновенно даже при уже скачанных весах модели, счёт идёт на секунды. Если мерить время первого вызова predict без поправки на эту инициализацию, легко приписать reranking задержку, которая на самом деле принадлежит запуску модели, а не самому пересчёту релевантности. В проде reranker имеет смысл прогревать заранее, а не на первом реальном запросе.
Reranking как сервис и как библиотека
Cohere Rerank и Sentence Transformers CrossEncoder решают одну задачу разными средствами, и выбор между ними определяется скорее инфраструктурными ограничениями, чем качеством ранжирования.
| Критерий | Sentence Transformers CrossEncoder | Cohere Rerank |
|---|---|---|
| Формат | Открытая библиотека, модель выполняется локально | Управляемый API, вызов по сети |
| Скор релевантности | Сырой логит, не нормализован | Нормализован в диапазон 0-1, но нелинейно |
| Лимит длины запроса | Определяется токенизатором конкретной модели | 2048 токенов в версии 3.5, 16384 токена в версии 4.0 |
| Лимит документов на запрос | Ограничен доступной памятью и временем | Рекомендовано не больше 1000, жёсткий потолок 10000 |
| Мультимодальность | С версии 5.4 заявлена поддержка пар текст, изображение, аудио, видео | Не выяснено в источниках разведки |
Открытая библиотека даёт контроль над моделью и не тарифицирует вызовы, но требует своих вычислительных ресурсов и обслуживания. Управляемый API снимает эту заботу, однако добавляет сетевую задержку и числовые лимиты, с которыми приходится считаться при проектировании пайплайна.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Когда применять reranking, а когда не стоит
Reranking оправдан, когда базовый retrieval и так возвращает достаточно кандидатов, чтобы было что пересчитывать, вопрос пользователя точный, а не общий, и порядок документов в контексте напрямую влияет на качество ответа языковой модели.
- Стоит применять. RAG-приложения, где неправильный порядок контекста меняет ответ модели, поисковые системы с высокой ценой ошибки, базы знаний с большим числом похожих по теме, но разных по сути документов.
- Не стоит применять. Простые точные запросы, на которые bi-encoder или полнотекстовый поиск и так возвращают единственный подходящий результат, сценарии с очень жёстким бюджетом задержки на весь запрос, куда не укладывается даже проход прогретого cross-encoder по нескольким кандидатам, и корпуса, которые обновляются быстрее, чем успевает пересчитываться список кандидатов.
Граница проходит там, где заканчивается выигрыш в качестве и начинается чистая потеря скорости.
Если вы строите систему на базе ИИ-агентов, которым нужен полноценный RAG-контур с retrieval и последующей перегенерацией ответов, у Школы Больших Данных есть практический курс ИИ-агенты для оптимизации бизнес-процессов, где reranking разбирается в контексте полного конвейера.
Практика переранжирования результатов векторного поиска
Демо строится на корпусе из десяти коротких документов про Apache Kafka и смежные big data системы и одном запросе, как Kafka Producer гарантирует ровно однократную доставку сообщений при сбоях. Только один документ отвечает на этот вопрос по существу, остальные девять либо про другие технологии, либо про Kafka вообще, но не про механизм exactly-once. Сначала top-5 кандидатов отбираются по эмбеддингам, затем этот же top-5 переранжируется cross-encoder’ом.
Baseline, поиск по эмбеддингам
Эмбеддинги считает локальная модель nomic-embed-text через Ollama, сервер для локального запуска моделей без обращения к внешнему API. Модель асимметричная, и запрос с документом нужно кодировать с разными префиксами задачи, иначе косинусное сходство считается некорректно.
# ollama 0.6.2, модель nomic-embed-text (768 измерений), прогнано на стенде 2026-08-26
# nomic-embed-text асимметричная: без префиксов задачи cosine similarity считается
# некорректно (см. грабли в 02. Wiki/stand.md), префиксы обязательны

import ollama


def embed_query(text: str) -> list[float]:
    r = ollama.embed(model="nomic-embed-text", input=f"search_query: {text}")
    return r["embeddings"][0]


def embed_document(text: str) -> list[float]:
    r = ollama.embed(model="nomic-embed-text", input=f"search_document: {text}")
    return r["embeddings"][0]


def cosine_similarity(a: list[float], b: list[float]) -> float:
    dot = sum(x * y for x, y in zip(a, b))
    norm_a = sum(x * x for x in a) ** 0.5
    norm_b = sum(y * y for y in b) ** 0.5
    return dot / (norm_a * norm_b)


def baseline_retrieve(query: str, documents: list[tuple[str, str]], top_n: int):
    """Возвращает top_n документов по косинусному сходству эмбеддингов, отсортированных
    по убыванию сходства. documents, список (id, текст)."""
    query_vec = embed_query(query)
    scored = []
    for doc_id, text in documents:
        doc_vec = embed_document(text)
        scored.append((doc_id, text, cosine_similarity(query_vec, doc_vec)))
    scored.sort(key=lambda item: item[2], reverse=True)
    return scored[:top_n]
Reranking cross-encoder и сравнение порядка выдачи
Top-5 из baseline передаются в CrossEncoder, который пересчитывает релевантность каждой пары запрос-документ и переранжирует список заново.
# sentence-transformers 6.0.0, модель cross-encoder/ms-marco-MiniLM-L-6-v2 (CPU)
# прогнано на стенде 2026-08-26; по документации https://sbert.net/docs/cross_encoder/usage/usage.html

from sentence_transformers import CrossEncoder

_MODEL_NAME = "cross-encoder/ms-marco-MiniLM-L-6-v2"
_model: CrossEncoder | None = None


def _get_model() -> CrossEncoder:
    global _model
    if _model is None:
        _model = CrossEncoder(_MODEL_NAME)
    return _model


def rerank(query: str, candidates: list[tuple[str, str, float]]):
    """Пересчитывает релевантность пар (запрос, документ) для кандидатов, отобранных
    baseline-поиском. candidates, список (id, текст, baseline_score).
    Возвращает список (id, текст, cross_encoder_score), отсортированный по убыванию
    cross_encoder_score. Скор это сырой логит модели MS MARCO, не нормализован в 0-1,
    важен порядок значений, а не само число."""
    model = _get_model()
    pairs = [(query, text) for _, text, _ in candidates]
    scores = model.predict(pairs)
    reranked = [
        (doc_id, text, float(score))
        for (doc_id, text, _), score in zip(candidates, scores)
    ]
    reranked.sort(key=lambda item: item[2], reverse=True)
    return reranked
Ключевые строки реального вывода собраны здесь, числа взяты из run_output.txt побуквенно.
# ключевые строки run_output.txt, прогон на стенде 2026-08-26
Baseline (cosine): kafka_consumer_group 0.7891, kafka_connect 0.7772,
kafka_overview 0.7479, kafka_exactly_once 0.7261, hdfs_replication 0.6770

После reranking (cross-encoder): kafka_exactly_once 8.0848, kafka_consumer_group 5.9943,
kafka_overview 5.6014, kafka_connect 5.5615, hdfs_replication 3.5220

Порядок изменился: True
Baseline по эмбеддингам ставит документ с точным ответом на вопрос, kafka_exactly_once, лишь на четвёртое место из пяти, хотя из всех десяти документов корпуса именно он ближе всего к запросу по буквальным словам. Косинусное сходство эмбеддингов явно считает иначе, и по одному прогону нельзя сказать, что именно в векторах сыграло роль, только то, что итог разошёлся с интуицией по ключевым словам. После reranking cross-encoder верно поднимает нужный документ на первое место, а вот у оставшихся четырёх порядок частично меняется тоже, документы про Kafka Connect и общий обзор Kafka меняются местами. Сам пересчёт top-5 пар в этом прогоне занял 7.21 секунды. Отдельным замером на стадии подготовки кода зафиксировано, что конструктор CrossEncoder с уже закэшированными весами инициализируется около 6.8 секунды, а сам predict() на прогретой модели укладывается в доли секунды, так что в 7.21 секунды этого конкретного прогона, скорее всего, тоже преобладает одноразовая инициализация, хотя точное разбиение именно этого вызова на составляющие не измерялось.
Заключение
Reranking закрывает конкретный разрыв между быстрым, но приблизительным поиском по эмбеддингам и точным, но дорогим сравнением пары текстов целиком. Bi-encoder отбирает кандидатов из всего корпуса за доли секунды, а cross-encoder наводит порядок внутри уже отобранного короткого списка, опираясь на более глубокое понимание связи между запросом и документом. Именно такое разделение труда, а не выбор одной модели вместо другой, определяет качество современных систем поиска и RAG.
Референсные ссылки
- Sentence Transformers, документация CrossEncoder, архитектура, механизм совместного кодирования, формат скора.
- Cohere, Reranking Best Practices, лимиты API, калибровка порога релевантности.
- Cohere, Rerank API reference, формат запроса, параметр max_tokens_per_doc.
- Sentence Transformers, релиз-ноуты на GitHub, версия 5.4, мультимодальные reranker-модели.
- Cohere, changelog Rerank v3.5, анонс модели.