
 1

Содержание
- Что такое BM25
- Из чего складывается оценка BM25
- IDF, вес редкого слова
- Насыщение частоты и параметр k1
- Нормализация длины и параметр b
- Как BM25 работает внутри поискового движка
- Варианты BM25 и почему библиотеки расходятся в цифрах
- BM25, TF-IDF и векторный поиск
- Когда BM25 подходит и когда нет
- Практика, BM25 на Python и SQLite
- Стенд
- Формула руками против rank-bm25 и bm25s
- Как k1 и b меняют выдачу
- Русская морфология и стемминг
- BM25 внутри SQLite FTS5
- Заключение
- Референсные ссылки
BM25 (Best Matching 25, полное имя Okapi BM25) это функция ранжирования для полнотекстового (лексического) поиска, которая решает, в каком порядке показать документы, где нашлись слова запроса. Оценка складывается по словам запроса из трёх множителей, а именно редкости слова в коллекции, частоты слова в документе с насыщением и поправки на длину документа. BM25 стоит функцией ранжирования по умолчанию в Apache Lucene и Elasticsearch и встроен в SQLite FTS5 как функция bm25().
Практика ниже воспроизведена на rank-bm25 0.2.2, bm25s 0.3.16, PyStemmer 3.1.0 и SQLite 3.45.1 под Python 3.12.3.
Что такое BM25
Инвертированный индекс (inverted index) быстро отвечает на вопрос, в каких документах есть слово. На вопрос, какой из сотни найденных документов показать первым, он не отвечает. Эту часть работы делает функция ранжирования, и BM25 самая распространённая из них. Она принадлежит вероятностной модели информационного поиска, которую в 1970-х и 1980-х развивали Stephen Robertson (Стивен Робертсон) и Karen Spärck Jones (Карен Спарк Джонс), британские исследователи информационного поиска. Имя Okapi пришло от поисковой системы Okapi в City University London, где формулу впервые применили. Javadoc класса BM25Similarity в Lucene ссылается на статью «Okapi at TREC-3» группы Робертсона.
BM25 работает с мешком слов (bag of words). Порядок слов в документе, их смысл и синонимы формула не видит, она сравнивает токены побуквенно. Поэтому результат сильно зависит от того, как анализатор разрезал текст на токены, и от того, привёл ли он словоформы к одной основе. Кроме того, BM25 оценивает только документы, где есть хотя бы одно слово запроса. Документ без общих слов получает ноль, даже если отвечает на вопрос дословно другими словами.
Из чего складывается оценка BM25
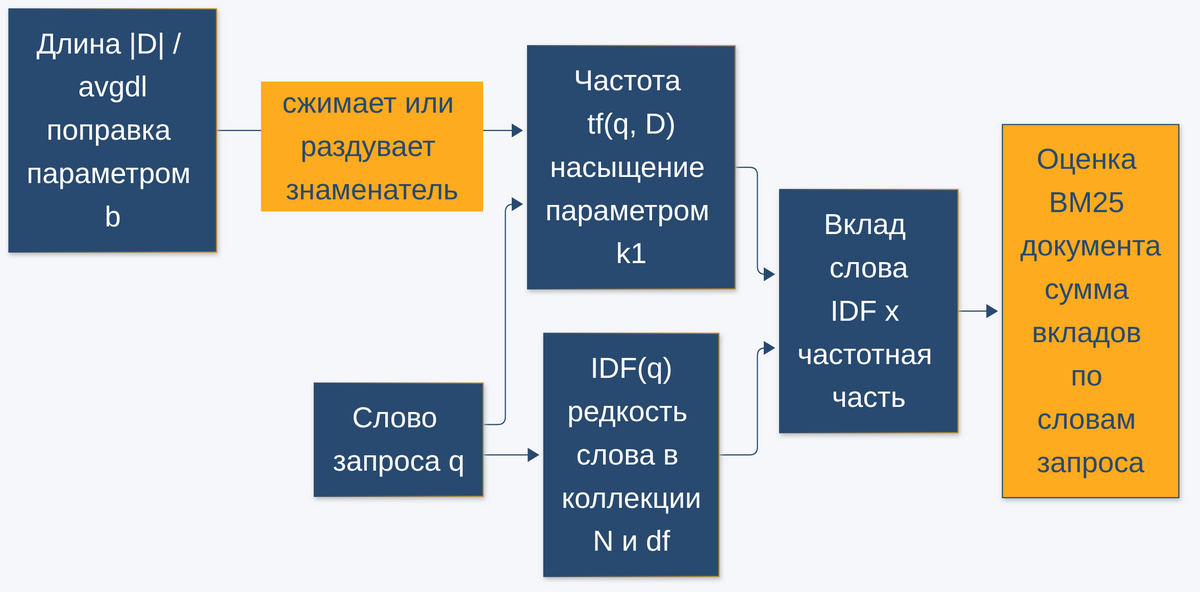
Оценка документа D по запросу Q это сумма вкладов слов запроса. Ниже классическая запись Okapi с множителем (k1 + 1), её численно повторяет класс BM25Okapi из rank-bm25.
# формула Okapi BM25, сверена с rank-bm25 0.2.2 до 2.66e-15 на стенде 2026-11-13
score(D, Q) = сумма по словам q из Q:
    IDF(q) * tf(q, D) * (k1 + 1) / (tf(q, D) + k1 * (1 - b + b * |D| / avgdl))

# tf(q, D)  сколько раз слово q встречается в документе D
# |D|       длина документа в токенах
# avgdl     средняя длина документа по коллекции
# IDF(q)    вес редкости слова, формула зависит от реализации
# k1, b     параметры насыщения частоты и нормализации длины
IDF, вес редкого слова
IDF (Inverse Document Frequency, обратная документная частота) поднимает вес слов, которые встречаются в немногих документах. В классической формуле Робертсона IDF равен логарифму от (N — n + 0.5) / (n + 0.5), где N это число документов, а n число документов со словом. Если слово есть больше чем в половине коллекции, дробь меньше единицы и IDF уходит в минус. В демо-корпусе из 16 документов союз «и» стоит в 13, и его IDF по Робертсону равен -1.3499. Документ, где «и» встречается, проигрывает документу без него. Lucene добавляет единицу под логарифм, поэтому IDF у неё всегда положительный, у того же «и» он 0.2305, а у редкого «инвертированный» 1.9169.
Насыщение частоты и параметр k1
В TF-IDF (Term Frequency — Inverse Document Frequency) вклад слова растёт линейно с числом повторов, и документ, где слово стоит двадцать раз, весит в двадцать раз больше. BM25 ставит частоту в дробь tf / (tf + k1 * …), у которой есть предел. При длине документа, равной средней, и k1 = 1.2 первое вхождение даёт 0.455, десятое 0.893, двадцатое 0.943. Каждый следующий повтор добавляет всё меньше. Чем меньше k1, тем быстрее насыщение. При k1 = 0.5 десятый повтор даёт 0.952, почти потолок, и частота перестаёт что-либо решать. При k1 = 2.0 тот же десятый повтор даёт 0.833, и разница между тремя и десятью вхождениями заметнее. Lucene и Elasticsearch по умолчанию берут k1 = 1.2.
Множитель (k1 + 1) при фиксированном k1 одинаков для всех документов и порядок выдачи не меняет. Lucene убрала его из числителя в версии 8.0 (задача LUCENE-8563), поэтому оценки Lucene и Elasticsearch ниже классических при том же порядке документов.
Нормализация длины и параметр b
Длинный документ содержит больше слов и чаще случайно совпадает с запросом. Множитель 1 — b + b * |D| / avgdl раздувает знаменатель у документов длиннее среднего и сжимает у коротких. Параметр b задаёт силу поправки. При b = 0 длина не учитывается вовсе, при b = 1 частота нормализуется полностью, умолчание Lucene и Elasticsearch 0.75. Документация Elasticsearch отмечает, что BM25 лучше работает на коротких полях.
Как BM25 работает внутри поискового движка
При индексации анализатор разбивает текст поля на токены, приводит их к нижнему регистру и, если настроено, к основе. Для каждого токена движок хранит список документов с частотами (postings), а для каждого документа длину поля. Отдельно лежит статистика коллекции, то есть число документов, документная частота каждого слова и средняя длина. При запросе движок берёт из индекса списки документов только по словам запроса, считает BM25 для этих документов и возвращает k лучших. Остальная коллекция не трогается, поэтому BM25 дёшев даже на миллионах документов. Как это выглядит в прикладной задаче на Elasticsearch и Kibana, разобрано в статье Практический пример монетизации Big Data с помощью Elasticsearch и Kibana.
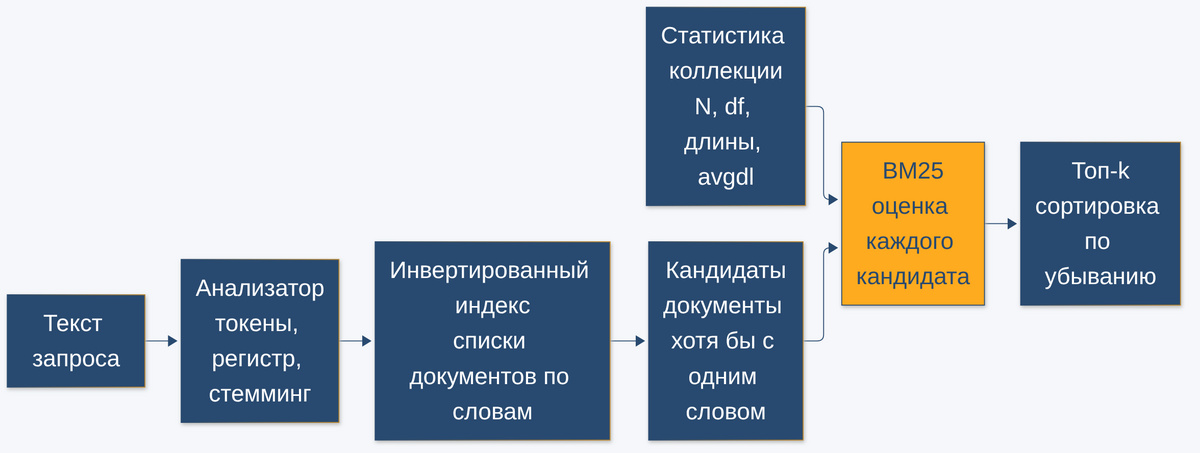
В Elasticsearch функция ранжирования называется similarity и задаётся на уровне поля. По документации Elastic о similarity умолчание это BM25 с k1 = 1.2, b = 0.75 и discount_overlaps = true. Параметры меняются в настройках индекса, если поле устроено необычно, например состоит из длинных однотипных текстов. Библиотека bm25s для Python идёт другим путём. Она считает оценку каждого слова в каждом документе заранее и хранит их в разреженной матрице, а запрос сводится к сложению строк матрицы по словам запроса.
Варианты BM25 и почему библиотеки расходятся в цифрах
Под именем BM25 живёт семейство формул. Они отличаются формулой IDF, наличием множителя (k1 + 1) и тем, как обходится длинный документ. Таблица собрана по исходному коду bm25s 0.3.16, который ссылается на сравнительную работу по вариантам BM25 с конференции ECIR 2020.
| Вариант | IDF | Частотная часть | Идея |
|---|---|---|---|
| Robertson (Okapi) | log((N — n + 0.5) / (n + 0.5)), в bm25s отрицательный обрезается до нуля | tf / (tf + k1 * (1 — b + b * |D| / avgdl)), в bm25s без (k1 + 1), в rank-bm25 и SQLite FTS5 с ним | классическая форма, частое слово может уйти в минус |
| Lucene | log(1 + (N — n + 0.5) / (n + 0.5)) | та же, без (k1 + 1) | IDF всегда положительный, умолчание Lucene и Elasticsearch |
| ATIRE | log(N / n) | с множителем (k1 + 1) | упрощённый IDF без поправки 0.5 |
| BM25L | log((N + 1) / (n + 0.5)) | к нормализованной частоте добавляется delta | не даёт длинному документу провалиться в ноль |
| BM25+ | log((N + 1) / n) | к частотной части добавляется delta | вклад найденного слова не опускается ниже IDF * delta |
| BM25F | как у базовой формулы | частоты по полям с весами | учитывает структуру документа, например заголовок и текст |
Расхождение на практике больше, чем кажется по таблице. Обе популярные Python-библиотеки, rank-bm25 и bm25s, по умолчанию берут k1 = 1.5, а не 1.2, как Lucene. Класс BM25Okapi в rank-bm25 считает IDF Робертсона, а отрицательный IDF подменяет на 0.25 от среднего IDF словаря, и частому «и» в демо-корпусе достаётся вес 0.5470, больше чем вдвое выше, чем у Lucene. Комментарий в исходнике rank-bm25 при этом называет вариант ATIRE. Наконец, разные токенизаторы по-разному режут дефисы и однобуквенные слова, и при другой токенизации меняются tf, длины и словарь. Вывод для практики простой. Между реализациями сравнивают порядок выдачи, а не абсолютные оценки, и порог отсечения по оценке из одной библиотеки в другую не переносят.
BM25, TF-IDF и векторный поиск
BM25 вырос из TF-IDF и до сих пор соревнуется с векторным поиском, который сравнивает эмбеддинги по смыслу. Различия удобнее видеть по осям.
| Ось | TF-IDF | BM25 | Векторный поиск |
|---|---|---|---|
| Что сравнивает | совпадение токенов | совпадение токенов | близость эмбеддингов |
| Повторы слова | вклад растёт линейно | вклад насыщается через k1 | не считаются явно |
| Длина документа | зависит от нормировки | поправка через b | длинный текст сжимается в один вектор |
| Синонимы и перефразы | не находит | не находит | находит |
| Коды, артикулы, имена | находит точно | находит точно | часто промахивается |
| Стоимость индекса | инвертированный индекс | инвертированный индекс | модель эмбеддингов и векторный индекс |
| Объяснимость | вклад каждого слова | вклад каждого слова | одно число близости |
В RAG (Retrieval-Augmented Generation) BM25 часто работает первым этапом отбора или лексической половиной гибридного поиска, где его выдачу сливают с векторной. Так закрываются обе слабости сразу. Векторная половина ловит перефразы, BM25 ловит код ошибки и название таблицы. Индексацию и retrieval для RAG в прикладных задачах разбирает курс AI-агенты для оптимизации бизнес-процессов.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Когда BM25 подходит и когда нет
BM25 выигрывает там, где пользователь знает точные слова, которые стоят в документе:
- Идентификаторы. Артикулы, коды ошибок вроде ORA-01555, имена функций и таблиц, номера версий.
- Логи и короткие поля. Сообщения об ошибках, заголовки, названия товаров.
- Бейзлайн. Отправная точка для оценки любой системы retrieval, с которой сравнивают векторный поиск и реранкинг.
- Скромное железо. Нет GPU и бюджета на модель эмбеддингов, а индекс надо обновлять на лету.
Во всех этих случаях совпадение токенов и есть релевантность.
Хуже BM25 справляется, когда слова запроса и документа расходятся:
- Перефразированные вопросы. Пользователь спрашивает своими словами, а документ написан терминами.
- Синонимы и кросс-язычный поиск. «Отказ узла» и «падение ноды» для BM25 не связаны.
- Русский текст без морфологии. Без стемминга или лемматизации «индекс» и «индексом» разные слова.
Такие задачи закрывают анализатором с морфологией, гибридным поиском или реранкингом поверх выдачи BM25.
Практика, BM25 на Python и SQLite
Четыре скрипта на одном корпусе из 16 коротких русских документов по дата-инженерии. Первый считает BM25 руками и сверяет с библиотеками, второй крутит k1 и b, третий проверяет стемминг, четвёртый смотрит на BM25 внутри SQLite. Корпус подобран под механизм, а не под реализм. Длинный обзор с тремя повторами слова, частое «и» и код ошибки в единственном документе стоят там намеренно.
Стенд
Прогон сделан на Ubuntu 24.04 с Python 3.12.3. Docker, GPU и внешние модели не нужны, venv занимает около 90 МБ. bm25s 0.3.16 тянет только numpy, без scipy. SQLite берётся из стандартной библиотеки Python, модуль FTS5 в сборке 3.45.1 есть.
# Python 3.12.3, rank-bm25 0.2.2, bm25s 0.3.16, PyStemmer 3.1.0, numpy 2.5.4; проверено на стенде 2026-11-13
cd /path/to/bm25
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/python -c "import sqlite3; print(sqlite3.sqlite_version)"   # 3.45.1 на стенде
# скрипты по очереди
.venv/bin/python 01_formula_by_hand.py
.venv/bin/python 02_k1_b_effect.py
.venv/bin/python 03_russian_stemming.py
.venv/bin/python 04_sqlite_fts5.py
Файл requirements.txt фиксирует версии.
# прогнано на стенде 2026-11-13, Python 3.12.3
rank-bm25==0.2.2
bm25s==0.3.16
PyStemmer==3.1.0
numpy==2.5.4
Файл corpus.py держит корпус, запросы и общий токенизатор. Токенизатор режет текст так же, как unicode61 в SQLite FTS5, поэтому длины документов во всех четырёх скриптах совпадают.
# общий корпус для демо BM25; rank-bm25 0.2.2, bm25s 0.3.16, PyStemmer 3.1.0, прогнано на стенде 2026-11-13
"""Шестнадцать коротких документов по дата-инженерии и общий токенизатор.

Корпус собран под механику BM25, а не под реализм:
- документ d2 в два с лишним раза длиннее среднего и повторяет «индекс» трижды: без
  поправки на длину (b=0) он первый, с умолчанием b=0.75 уступает коротким;
- слово «индекс» встречается в разных падежах в разных документах, на этом
  проверяется стемминг;
- служебное «и» стоит больше чем в половине документов, у него отрицательный
  IDF в классической формуле Робертсона;
- код ошибки ORA-01555 есть ровно в одном документе.
"""
import re

DOCS = [
    ("Инвертированный индекс",
     "Инвертированный индекс хранит для каждого слова список документов, где это слово "
     "встречается. Поиск по индексу читает только списки слов из запроса."),
    ("B-дерево в PostgreSQL",
     "Индекс на B-дереве ускоряет поиск строк по ключу и сортировку. Для поиска слов "
     "внутри длинного текста такой индекс не годится."),
    ("Обзор индексов",
     "Индекс бывает разным: индекс в базе данных и индекс в книге. В этом длинном "
     "обзоре автор перечисляет все виды подряд, вспоминает кластерные, покрывающие "
     "и частичные варианты, а заодно рассказывает историю библиотечных каталогов, "
     "карточек, шкафов и библиотекарей, которые вели учет книг задолго до "
     "появления компьютеров."),
    ("Ошибка ORA-01555",
     "Ошибка ORA-01555 snapshot too old возникает в Oracle, когда сегмент отката "
     "перезаписан раньше, чем закончился долгий запрос."),
    ("Партиции в Kafka",
     "Топик Kafka делится на партиции, и каждая партиция это упорядоченный журнал "
     "сообщений. Консьюмеры читают данные из партиций параллельно."),
    ("Shuffle в Spark",
     "Shuffle в Spark перераспределяет данные между узлами кластера и часто становится "
     "самым дорогим этапом задачи."),
    ("Озеро данных",
     "Озеро данных хранит сырые данные в объектном хранилище в форматах Parquet и JSON, "
     "а схема применяется при чтении."),
    ("Хранилище данных",
     "Хранилище данных содержит очищенные данные в схеме звезда для отчетов и аналитики."),
    ("Векторный поиск",
     "Векторный поиск сравнивает эмбеддинги запроса и документов и находит тексты, "
     "близкие по смыслу, даже без общих слов."),
    ("Полнотекстовый поиск в Elasticsearch",
     "Elasticsearch строит инвертированный индекс по каждому текстовому полю и "
     "ранжирует найденные документы функцией BM25."),
    ("Поиск по логам",
     "Логи приложений разбирают на поля уровень, сервис и сообщение, чтобы искать "
     "ошибки по коду и по тексту."),
    ("Индексы в базе данных",
     "Индексы ускоряют выборку строк, но замедляют вставку, потому что каждый индекс "
     "надо обновить при записи."),
    ("Data Vault",
     "Data Vault делит модель на хабы, ссылки и сателлиты, и хранилище данных "
     "спокойно переживает изменения источников."),
    ("CDC",
     "CDC читает журнал транзакций базы данных и передает изменения строк в Kafka "
     "без нагрузки на таблицы."),
    ("Партиционирование таблиц",
     "Партиционирование делит большую таблицу на части по дате, и запрос с фильтром "
     "по дате читает только нужные партиции."),
    ("Качество данных",
     "Проверки качества данных ловят пустые значения, дубли и нарушения ссылочной "
     "целостности до загрузки данных в витрину."),
]

# документ для BM25 это заголовок плюс текст одной строкой
TEXTS = [f"{title}. {body}" for title, body in DOCS]

QUERIES = {
    "q1": "инвертированный индекс для поиска",
    "q2": "ORA-01555",
    "q3": "индексом ускорить поиск",
    "q4": "хранилище и данные",
}


def tokenize(text: str) -> list[str]:
    """Нижний регистр и разбиение по всему, что не буква и не цифра.

    Так же режет текст токенизатор unicode61 в SQLite FTS5, поэтому числа длины
    документа во всех четырех демо совпадают. Стоп-слова не выкидываем намеренно:
    на «и» видно, что делает IDF с частым словом.
    """
    return re.findall(r"[^\W_]+", text.lower())


def short(doc_id: int, width: int = 34) -> str:
    """Подпись документа в выводе: номер и начало заголовка."""
    title = DOCS[doc_id][0]
    return f"d{doc_id:<2} {title[:width]:<{width}}"
Формула руками против rank-bm25 и bm25s
Скрипт 01_formula_by_hand.py считает BM25 на чистом Python в трёх вариантах и сравнивает с библиотеками на тех же токенах при k1 = 1.2 и b = 0.75.
# rank-bm25 0.2.2, bm25s 0.3.16, numpy 2.5.4, Python 3.12.3, прогнано на стенде 2026-11-13
"""BM25 руками по формуле и сверка с rank-bm25 и bm25s на одной токенизации.

Оценка документа D по запросу Q это сумма по словам запроса:
    IDF(q) * tf(q, D) * [k1 + 1] / (tf(q, D) + k1 * (1 - b + b * |D| / avgdl))
Библиотеки расходятся в двух местах: как считать IDF и есть ли множитель (k1 + 1).
"""
import inspect
import math
from collections import Counter

import bm25s
import numpy as np
import rank_bm25

from corpus import QUERIES, TEXTS, short, tokenize

K1, B = 1.2, 0.75  # умолчания Lucene и Elasticsearch

corpus_tokens = [tokenize(t) for t in TEXTS]
N = len(corpus_tokens)
doc_len = [len(d) for d in corpus_tokens]
avgdl = sum(doc_len) / N
tf = [Counter(d) for d in corpus_tokens]
df = Counter(w for d in corpus_tokens for w in set(d))


# ── три формулы IDF ──────────────────────────────────────────────────────
def idf_robertson(n: int) -> float:
    """Классика Робертсона: у слова из больше чем половины документов уходит в минус."""
    return math.log((N - n + 0.5) / (n + 0.5))


def idf_lucene(n: int) -> float:
    """Lucene и Elasticsearch: единица под логарифмом, IDF всегда больше нуля."""
    return math.log(1 + (N - n + 0.5) / (n + 0.5))


# rank-bm25 подменяет отрицательный IDF на epsilon * средний IDF по словарю
ROB = {w: idf_robertson(n) for w, n in df.items()}
EPS_FLOOR = 0.25 * (sum(ROB.values()) / len(ROB))


def idf_rank_bm25(n_word: str) -> float:
    v = ROB[n_word]
    return v if v >= 0 else EPS_FLOOR


def idf_bm25s_robertson(n: int) -> float:
    """bm25s, method='robertson': отрицательный IDF обрезается до нуля."""
    return math.log(max((N - n + 0.5) / (n + 0.5), 1.0))


# ── частотная часть ─────────────────────────────────────────────────────
def tf_part(f: int, dl: int, k1: float, b: float, plus1: bool) -> float:
    norm = k1 * (1 - b + b * dl / avgdl)
    return f * ((k1 + 1) if plus1 else 1) / (f + norm)


def score(query: list[str], d: int, idf, plus1: bool) -> float:
    s = 0.0
    for q in query:
        f = tf[d].get(q, 0)
        if f:
            s += idf(q) * tf_part(f, doc_len[d], K1, B, plus1)
    return s


VARIANTS = {
    # имя: (IDF по слову, множитель k1+1)
    "rank-bm25 BM25Okapi": (idf_rank_bm25, True),
    "bm25s lucene": (lambda w: idf_lucene(df[w]), False),
    "bm25s robertson": (lambda w: idf_bm25s_robertson(df[w]), False),
}

# ── библиотеки на тех же токенах ────────────────────────────────────────
okapi = rank_bm25.BM25Okapi(corpus_tokens, k1=K1, b=B, epsilon=0.25)
lib_lucene = bm25s.BM25(method="lucene", k1=K1, b=B)
lib_lucene.index(corpus_tokens, show_progress=False)
lib_rob = bm25s.BM25(method="robertson", k1=K1, b=B)
lib_rob.index(corpus_tokens, show_progress=False)


def lib_scores(name: str, q: list[str]) -> np.ndarray:
    if name == "rank-bm25 BM25Okapi":
        return np.asarray(okapi.get_scores(q))
    lib = lib_lucene if name == "bm25s lucene" else lib_rob
    known = [w for w in q if w in df]  # bm25s молча выкидывает слова вне словаря
    return lib.get_scores(known).astype(float) if known else np.zeros(N)


print("Умолчания библиотек (inspect.signature):")
print(f"  rank_bm25.BM25Okapi{inspect.signature(rank_bm25.BM25Okapi.__init__)}")
sig = inspect.signature(bm25s.BM25.__init__).parameters
print(f"  bm25s.BM25: k1={sig['k1'].default}, b={sig['b'].default}, method={sig['method'].default!r}")
print(f"Корпус: N={N} документов, avgdl={avgdl:.3f} токена, словарь {len(df)} слов")
print(f"k1={K1}, b={B}; floor rank-bm25 для отрицательного IDF = 0.25 * средний IDF = {EPS_FLOOR:.4f}")

# 1. Сверка «руками против библиотек»: максимальное расхождение по всем запросам и документам
print("\n=== 1. Формула руками против библиотек, max |разница| по 4 запросам x 16 документам ===")
for name, (idf, plus1) in VARIANTS.items():
    worst = 0.0
    for qtext in QUERIES.values():
        q = tokenize(qtext)
        hand = np.array([score(q, d, idf, plus1) for d in range(N)])
        worst = max(worst, float(np.max(np.abs(hand - lib_scores(name, q)))))
    print(f"{name:<22} {worst:.2e}")

# 2. Разбор одной оценки по словам: что именно складывается
q = tokenize(QUERIES["q1"])
best = int(np.argmax([score(q, d, VARIANTS['bm25s lucene'][0], False) for d in range(N)]))
print(f"\n=== 2. Разбор оценки Lucene: запрос «{QUERIES['q1']}», документ {short(best).strip()} ===")
print(f"|D|={doc_len[best]}, |D|/avgdl={doc_len[best] / avgdl:.3f}")
print(f"{'слово':<18}{'tf':>4}{'df':>4}{'IDF':>8}{'tf-часть':>10}{'вклад':>9}")
total = 0.0
for w in q:
    f = tf[best].get(w, 0)
    i = idf_lucene(df[w]) if w in df else 0.0
    part = tf_part(f, doc_len[best], K1, B, False) if f else 0.0
    total += i * part
    print(f"{w:<18}{f:>4}{df.get(w, 0):>4}{i:>8.4f}{part:>10.4f}{i * part:>9.4f}")
print(f"{'итого':<18}{'':>26}{total:>9.4f}   bm25s: {lib_scores('bm25s lucene', q)[best]:.4f}")

# 3. Одинаковые данные, разные числа и разный порядок
for key in ("q1", "q4"):
    q = tokenize(QUERIES[key])
    print(f"\n=== 3. Топ-5 по запросу «{QUERIES[key]}» ===")
    for w in q:
        print(f"   слово «{w}»: df={df.get(w, 0)}, IDF Робертсона={idf_robertson(df[w]) if w in df else float('nan'):+.4f},"
              f" IDF Lucene={idf_lucene(df[w]) if w in df else float('nan'):.4f}")
    for name in VARIANTS:
        s = lib_scores(name, q)
        top = np.argsort(-s, kind="stable")[:5]
        row = "  ".join(f"d{int(d)}:{s[d]:.3f}" for d in top)
        print(f"{name:<22} {row}")
# вывод 01_formula_by_hand.py, прогон на стенде 2026-11-13 16:45 UTC, Ubuntu 24.04, Python 3.12.3
Умолчания библиотек (inspect.signature):
  rank_bm25.BM25Okapi(self, corpus, tokenizer=None, k1=1.5, b=0.75, epsilon=0.25)
  bm25s.BM25: k1=1.5, b=0.75, method='lucene'
Корпус: N=16 документов, avgdl=21.062 токена, словарь 220 слов
k1=1.2, b=0.75; floor rank-bm25 для отрицательного IDF = 0.25 * средний IDF = 0.5470

=== 1. Формула руками против библиотек, max |разница| по 4 запросам x 16 документам ===
rank-bm25 BM25Okapi    2.66e-15
bm25s lucene           1.27e-07
bm25s robertson        1.29e-07

=== 2. Разбор оценки Lucene: запрос «инвертированный индекс для поиска», документ d0  Инвертированный индекс ===
|D|=23, |D|/avgdl=1.092
слово               tf  df     IDF  tf-часть    вклад
инвертированный      2   2  1.9169    0.6092   1.1679
индекс               2   5  1.1285    0.6092   0.6875
для                  1   3  1.5805    0.4381   0.6923
поиска               0   1  2.4277    0.0000   0.0000
итого                                          2.5477   bm25s: 2.5477

=== 3. Топ-5 по запросу «инвертированный индекс для поиска» ===
   слово «инвертированный»: df=2, IDF Робертсона=+1.7579, IDF Lucene=1.9169
   слово «индекс»: df=5, IDF Робертсона=+0.7376, IDF Lucene=1.1285
   слово «для»: df=3, IDF Робертсона=+1.3499, IDF Lucene=1.5805
   слово «поиска»: df=1, IDF Робертсона=+2.3354, IDF Lucene=2.4277
rank-bm25 BM25Okapi    d0:4.646  d1:4.387  d9:2.653  d7:1.565  d2:0.925
bm25s lucene           d0:2.548  d1:2.363  d9:1.472  d7:0.833  d2:0.643
bm25s robertson        d0:2.112  d1:1.994  d9:1.206  d7:0.711  d2:0.420

=== 3. Топ-5 по запросу «хранилище и данные» ===
   слово «хранилище»: df=3, IDF Робертсона=+1.3499, IDF Lucene=1.5805
   слово «и»: df=13, IDF Робертсона=-1.3499, IDF Lucene=0.2305
   слово «данные»: df=4, IDF Робертсона=+1.0217, IDF Lucene=1.3291
rank-bm25 BM25Okapi    d7:3.867  d6:2.980  d12:2.220  d5:1.668  d4:1.571
bm25s lucene           d7:1.912  d6:1.457  d12:0.914  d5:0.754  d4:0.710
bm25s robertson        d7:1.470  d6:1.101  d12:0.652  d5:0.494  d4:0.465
Формула руками совпала с rank-bm25 до 2.66e-15, а с bm25s до 1.29e-07, остаток объясняется хранением оценок bm25s во float32. Разбор документа d0 показывает механику целиком. Редкое «инвертированный» с IDF 1.9169 даёт почти половину оценки, а слово «поиска» ничего не даёт, потому что в d0 стоит «поиск» и для BM25 это другое слово. На запросе «хранилище и данные» все три реализации ставят документы в одном порядке, но rank-bm25 даёт d7 оценку 3.867, а bm25s lucene 1.912. Причина в множителе (k1 + 1) и в трёх разных способах обойти отрицательный IDF у «и».
LakeHouse, Python и эффективная обработка данных: выбор вычислительного движка
Код курса
HPPY
Ближайшая дата курса
16 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Как k1 и b меняют выдачу
Скрипт 02_k1_b_effect.py показывает насыщение частоты и сетку k1 x b на запросе «индекс» через bm25s с методом lucene.
# bm25s 0.3.16 (method="lucene"), numpy 2.5.4, Python 3.12.3, прогнано на стенде 2026-11-13
"""Как k1 и b меняют выдачу BM25.

k1 отвечает за насыщение: насколько десятое повторение слова весит меньше первого.
b отвечает за длину: насколько длинный документ штрафуется за то, что слов в нем больше.
"""
from collections import Counter

import bm25s
import numpy as np

from corpus import TEXTS, short, tokenize

corpus_tokens = [tokenize(t) for t in TEXTS]
doc_len = np.array([len(d) for d in corpus_tokens])
avgdl = doc_len.mean()
QUERY = ["индекс"]

# 1. Насыщение частоты при |D| = avgdl: формула Lucene, без множителя (k1 + 1)
print("=== 1. Частотная часть tf / (tf + k1) при |D| = avgdl, предел 1.0 ===")
tfs = [1, 2, 3, 5, 10, 20]
print(f"{'':<12}" + "".join(f"{'tf=' + str(t):>9}" for t in tfs))
for k1 in (0.5, 1.2, 2.0):
    print(f"{'k1=' + str(k1):<12}" + "".join(f"{t / (t + k1):>9.3f}" for t in tfs))
print(f"{'TF-IDF':<12}" + "".join(f"{t:>9}" for t in tfs) + "   (линейно, без предела)")

# 2. Документы со словом «индекс»: частота и длина
hits = [d for d, toks in enumerate(corpus_tokens) if "индекс" in toks]
print(f"\n=== 2. Документы со словом «индекс», avgdl={avgdl:.2f} ===")
for d in hits:
    print(f"{short(d)} tf={Counter(corpus_tokens[d])['индекс']:<3} |D|={doc_len[d]:<4} |D|/avgdl={doc_len[d] / avgdl:.2f}")

# 3. Сетка k1 x b: оценки и порядок
print("\n=== 3. Сетка k1 x b, запрос «индекс», порядок документов и оценки ===")
for k1 in (0.5, 1.2, 2.0):
    for b in (0.0, 0.75, 1.0):
        model = bm25s.BM25(method="lucene", k1=k1, b=b)
        model.index(corpus_tokens, show_progress=False)
        s = model.get_scores(QUERY)
        order = sorted(hits, key=lambda d: -s[d])
        row = "  ".join(f"d{d}:{s[d]:.3f}" for d in order)
        print(f"k1={k1:<4} b={b:<5} {row}")
# вывод 02_k1_b_effect.py, прогон на стенде 2026-11-13 16:45 UTC, Ubuntu 24.04, Python 3.12.3
=== 1. Частотная часть tf / (tf + k1) при |D| = avgdl, предел 1.0 ===
                 tf=1     tf=2     tf=3     tf=5    tf=10    tf=20
k1=0.5          0.667    0.800    0.857    0.909    0.952    0.976
k1=1.2          0.455    0.625    0.714    0.806    0.893    0.943
k1=2.0          0.333    0.500    0.600    0.714    0.833    0.909
TF-IDF              1        2        3        5       10       20   (линейно, без предела)

=== 2. Документы со словом «индекс», avgdl=21.06 ===
d0  Инвертированный индекс             tf=2   |D|=23   |D|/avgdl=1.09
d1  B-дерево в PostgreSQL              tf=2   |D|=25   |D|/avgdl=1.19
d2  Обзор индексов                     tf=3   |D|=46   |D|/avgdl=2.18
d9  Полнотекстовый поиск в Elasticsear tf=1   |D|=18   |D|/avgdl=0.85
d11 Индексы в базе данных              tf=1   |D|=19   |D|/avgdl=0.90

=== 3. Сетка k1 x b, запрос «индекс», порядок документов и оценки ===
k1=0.5  b=0.0   d2:0.967  d0:0.903  d1:0.903  d9:0.752  d11:0.752
k1=0.5  b=0.75  d0:0.890  d1:0.878  d2:0.858  d9:0.781  d11:0.771
k1=0.5  b=1.0   d0:0.886  d1:0.870  d2:0.827  d9:0.791  d11:0.778
k1=1.2  b=0.0   d2:0.806  d0:0.705  d1:0.705  d9:0.513  d11:0.513
k1=1.2  b=0.75  d0:0.688  d1:0.670  d2:0.643  d9:0.545  d11:0.534
k1=1.2  b=1.0   d0:0.682  d1:0.659  d2:0.602  d9:0.557  d11:0.542
k1=2.0  b=0.0   d2:0.677  d0:0.564  d1:0.564  d9:0.376  d11:0.376
k1=2.0  b=0.75  d0:0.545  d1:0.527  d2:0.500  d9:0.406  d11:0.396
k1=2.0  b=1.0   d0:0.539  d1:0.516  d2:0.459  d9:0.417  d11:0.402
Документ d2 «Обзор индексов» длиннее среднего в 2.18 раза и содержит «индекс» трижды. При b = 0 он первый при любом k1, а оценки d0 и d1 с двумя вхождениями совпадают, потому что длину формула не видит. При b = 0.75 d2 опускается на третье место, уступая двум коротким документам. Именно ради этого b и существует, длинный обзор, где слово мелькает между делом, не должен обходить короткий документ, целиком посвящённый теме.
Русская морфология и стемминг
Скрипт 03_russian_stemming.py строит два индекса bm25s, без стемминга и со стеммером Snowball russian из PyStemmer, и ищет по ним запрос со словоформами.
# bm25s 0.3.16, PyStemmer 3.1.0 (Snowball russian), Python 3.12.3, прогнано на стенде 2026-11-13
"""BM25 на русском тексте без стемминга и со стеммингом.

BM25 сравнивает токены побуквенно. «индекс», «индекса» и «индексом» для него три разных
слова, пока анализатор не приведет их к одной основе.
"""
import bm25s
import numpy as np
import Stemmer

from corpus import QUERIES, TEXTS, short

stemmer = Stemmer.Stemmer("russian")

print("=== 1. Что делает стеммер Snowball russian ===")
for group in (["индекс", "индекса", "индексу", "индексом", "индексы", "индексами"],
              ["ускоряет", "ускоряют", "ускорить"],
              ["данные", "данных", "данным"],
              ["поиск", "поиска", "поисковике"]):
    print("  ".join(f"{w}->{stemmer.stemWord(w)}" for w in group))


def build(stem):
    """Индекс bm25s: русские стоп-слова встроены в bm25s, стеммер опционален."""
    toks = bm25s.tokenize(TEXTS, stopwords="ru", stemmer=stem,
                          return_ids=False, show_progress=False)
    model = bm25s.BM25(method="lucene", k1=1.2, b=0.75)
    model.index(toks, show_progress=False)
    return model


def search(model, stem, text, k=5):
    q = bm25s.tokenize(text, stopwords="ru", stemmer=stem,
                       return_ids=False, show_progress=False)[0]
    known = [w for w in q if w in model.vocab_dict]
    scores = model.get_scores(known) if known else np.zeros(len(TEXTS))
    top = [int(d) for d in np.argsort(-scores, kind="stable")[:k] if scores[d] > 0]
    return q, known, [(d, float(scores[d])) for d in top]


plain, stemmed = build(None), build(stemmer)
print(f"\nСловарь индекса: без стемминга {len(plain.vocab_dict)} токенов, со стеммингом {len(stemmed.vocab_dict)}")

for key in ("q3", "q1"):
    text = QUERIES[key]
    print(f"\n=== 2. Запрос «{text}» ===")
    for name, model, stem in (("без стемминга", plain, None), ("Snowball russian", stemmed, stemmer)):
        q, known, top = search(model, stem, text)
        print(f"{name}: токены запроса {q}, найдены в словаре {known}")
        if not top:
            print("   ничего не найдено")
        for d, s in top:
            print(f"   {short(d)} {s:.3f}")
# вывод 03_russian_stemming.py, прогон на стенде 2026-11-13 16:45 UTC, Ubuntu 24.04, Python 3.12.3
=== 1. Что делает стеммер Snowball russian ===
индекс->индекс  индекса->индекс  индексу->индекс  индексом->индекс  индексы->индекс  индексами->индекс
ускоряет->ускоря  ускоряют->ускоря  ускорить->ускор
данные->дан  данных->дан  данным->дан
поиск->поиск  поиска->поиск  поисковике->поисковик

Словарь индекса: без стемминга 194 токенов, со стеммингом 161

=== 2. Запрос «индексом ускорить поиск» ===
без стемминга: токены запроса ['индексом', 'ускорить', 'поиск'], найдены в словаре ['поиск']
   d8  Векторный поиск                    0.732
   d10 Поиск по логам                     0.556
   d9  Полнотекстовый поиск в Elasticsear 0.527
   d1  B-дерево в PostgreSQL              0.514
   d0  Инвертированный индекс             0.489
Snowball russian: токены запроса ['индекс', 'ускор', 'поиск'], найдены в словаре ['индекс', 'поиск']
   d1  B-дерево в PostgreSQL              1.412
   d0  Инвертированный индекс             1.275
   d9  Полнотекстовый поиск в Elasticsear 1.054
   d11 Индексы в базе данных              0.840
   d8  Векторный поиск                    0.732

=== 2. Запрос «инвертированный индекс для поиска» ===
без стемминга: токены запроса ['инвертированный', 'индекс', 'поиска'], найдены в словаре ['инвертированный', 'индекс', 'поиска']
   d0  Инвертированный индекс             1.841
   d1  B-дерево в PostgreSQL              1.811
   d9  Полнотекстовый поиск в Elasticsear 1.423
   d2  Обзор индексов                     0.637
   d11 Индексы в базе данных              0.556
Snowball russian: токены запроса ['инвертирова', 'индекс', 'поиск'], найдены в словаре ['инвертирова', 'индекс', 'поиск']
   d0  Инвертированный индекс             2.433
   d9  Полнотекстовый поиск в Elasticsear 1.950
   d1  B-дерево в PostgreSQL              1.412
   d11 Индексы в базе данных              0.840
   d8  Векторный поиск                    0.732
Без стемминга слова «индексом» и «ускорить» в словаре нет, и BM25 ищет только по «поиск». Первым выходит d8 «Векторный поиск», к индексам отношения не имеющий. После стемминга «индексом» сходится с «индекс», и наверх поднимаются d1 и d0. Стеммер при этом работает правилами по окончаниям, а не словарём. «Ускорить» он режет до «ускор», а «ускоряет» до «ускоря», и документ d11 «Индексы в базе данных», где индексы как раз ускоряют выборку, остаётся только четвёртым. Для русского текста это аргумент за лемматизацию в анализаторе.
BM25 внутри SQLite FTS5
Скрипт 04_sqlite_fts5.py кладёт тот же корпус в виртуальную таблицу FTS5 с колонками заголовка и текста и сверяет функцию bm25() с формулой из исходника ext/fts5/fts5_aux.c. В FTS5 константы k1 = 1.2 и b = 0.75 зашиты в код, IDF считается по Робертсону, неположительный IDF заменяется на 1e-6, а результат умножается на -1, чтобы сортировка по возрастанию ставила лучший документ первым.
# SQLite 3.45.1 (модуль sqlite3 из stdlib Python 3.12.3), формула bm25() по ext/fts5/fts5_aux.c, прогнано на стенде 2026-11-13
"""BM25 внутри SQLite FTS5: знак, сверка с формулой и веса колонок.

Функция bm25() в FTS5 считает классический BM25 с IDF Робертсона, k1=1.2 и b=0.75
зашиты в код. Неположительный IDF заменяется на 1e-6. Результат умножается на -1,
чтобы ORDER BY по возрастанию ставил лучшее совпадение первым.
"""
import math
import sqlite3
from collections import Counter

from corpus import DOCS, QUERIES, short, tokenize

con = sqlite3.connect(":memory:")
print(f"SQLite {sqlite3.sqlite_version}")
# две колонки: заголовок и текст; токенизатор unicode61 по умолчанию
con.execute("CREATE VIRTUAL TABLE docs USING fts5(title, body)")
con.executemany("INSERT INTO docs(rowid, title, body) VALUES (?, ?, ?)",
                [(i, t, b) for i, (t, b) in enumerate(DOCS)])


def fts_query(text: str) -> str:
    """В FTS5 слова через пробел означают AND. BM25 ранжирует по любому слову, поэтому OR."""
    return " OR ".join(f'"{w}"' for w in tokenize(text))


# формула bm25() из fts5_aux.c на Python, длина документа по обеим колонкам
toks = [tokenize(t) + tokenize(b) for t, b in DOCS]
title_toks = [Counter(tokenize(t)) for t, _ in DOCS]
body_toks = [Counter(tokenize(b)) for _, b in DOCS]
N = len(toks)
avgdl = sum(len(t) for t in toks) / N
df = Counter(w for t in toks for w in set(t))


def fts5_formula(query: list[str], d: int, w_title=1.0, w_body=1.0) -> float:
    k1, b = 1.2, 0.75
    s = 0.0
    for q in query:
        idf = math.log((N - df[q] + 0.5) / (df[q] + 0.5)) if df[q] else 0.0
        if idf <= 0:
            idf = 1e-6
        f = w_title * title_toks[d][q] + w_body * body_toks[d][q]
        s += idf * f * (k1 + 1) / (f + k1 * (1 - b + b * len(toks[d]) / avgdl))
    return -s


for key in ("q1", "q2", "q4"):
    text = QUERIES[key]
    q = tokenize(text)
    print(f"\n=== Запрос «{text}», MATCH '{fts_query(text)}' ===")
    rows = con.execute(
        "SELECT rowid, bm25(docs) FROM docs WHERE docs MATCH ? ORDER BY bm25(docs) LIMIT 5",
        (fts_query(text),)).fetchall()
    for rowid, sc in rows:
        hand = fts5_formula(q, rowid)
        print(f"{short(rowid)} bm25()={sc:+.6f}  формула={hand:+.6f}  разница={abs(sc - hand):.1e}")

# пробел без OR: только документы, где есть все слова
q1 = QUERIES["q1"]
n_and = con.execute("SELECT count(*) FROM docs WHERE docs MATCH ?",
                    (" ".join(f'"{w}"' for w in tokenize(q1)),)).fetchone()[0]
n_or = con.execute("SELECT count(*) FROM docs WHERE docs MATCH ?", (fts_query(q1),)).fetchone()[0]
print(f"\nЗапрос «{q1}»: через пробел (AND) найдено {n_and} документов, через OR {n_or}")

# rank это bm25() без весов, ORDER BY rank дает тот же порядок
same = con.execute(
    "SELECT count(*) FROM docs WHERE docs MATCH ? AND rank = bm25(docs)", (fts_query(q1),)).fetchone()[0]
print(f"rank = bm25(docs) в {same} строках из {n_or}")

# веса колонок: попадание в заголовок весит как 10 попаданий в текст
q = "индекс"
print(f"\n=== Веса колонок, запрос «{q}»: bm25(docs) против bm25(docs, 10.0, 1.0) ===")
for weights in ((1.0, 1.0), (10.0, 1.0)):
    rows = con.execute(
        "SELECT rowid, bm25(docs, ?, ?) FROM docs WHERE docs MATCH ? ORDER BY 2 LIMIT 5",
        (*weights, f'"{q}"')).fetchall()
    order = "  ".join(f"d{r}:{s:+.3f}" for r, s in rows)
    check = max(abs(s - fts5_formula([q], r, *weights)) for r, s in rows)
    print(f"веса title={weights[0]:<4} body={weights[1]:<4} {order}   max |bm25()-формула|={check:.1e}")
for d in (0, 2, 11):
    print(f"   {short(d)} в заголовке {title_toks[d]['индекс']}, в тексте {body_toks[d]['индекс']}, |D|={len(toks[d])}")
# вывод 04_sqlite_fts5.py, прогон на стенде 2026-11-13 16:45 UTC, Ubuntu 24.04, Python 3.12.3
SQLite 3.45.1

=== Запрос «инвертированный индекс для поиска», MATCH '"инвертированный" OR "индекс" OR "для" OR "поиска"' ===
d0  Инвертированный индекс             bm25()=-4.645689  формула=-4.645689  разница=0.0e+00
d1  B-дерево в PostgreSQL              bm25()=-4.387022  формула=-4.387022  разница=0.0e+00
d9  Полнотекстовый поиск в Elasticsear bm25()=-2.653279  формула=-2.653279  разница=0.0e+00
d7  Хранилище данных                   bm25()=-1.564539  формула=-1.564539  разница=0.0e+00
d2  Обзор индексов                     bm25()=-0.924524  формула=-0.924524  разница=1.1e-16

=== Запрос «ORA-01555», MATCH '"ora" OR "01555"' ===
d3  Ошибка ORA-01555                   bm25()=-6.427645  формула=-6.427645  разница=0.0e+00

=== Запрос «хранилище и данные», MATCH '"хранилище" OR "и" OR "данные"' ===
d7  Хранилище данных                   bm25()=-3.233498  формула=-3.233498  разница=8.9e-16
d6  Озеро данных                       bm25()=-2.421552  формула=-2.421552  разница=0.0e+00
d12 Data Vault                         bm25()=-1.435303  формула=-1.435303  разница=2.2e-16
d5  Shuffle в Spark                    bm25()=-1.086266  формула=-1.086266  разница=2.2e-16
d4  Партиции в Kafka                   bm25()=-1.022894  формула=-1.022894  разница=0.0e+00

Запрос «инвертированный индекс для поиска»: через пробел (AND) найдено 0 документов, через OR 6
rank = bm25(docs) в 6 строках из 6

=== Веса колонок, запрос «индекс»: bm25(docs) против bm25(docs, 10.0, 1.0) ===
веса title=1.0  body=1.0  d0:-0.989  d1:-0.964  d2:-0.925  d9:-0.784  d11:-0.768   max |bm25()-формула|=1.1e-16
веса title=10.0 body=1.0  d0:-1.453  d1:-0.964  d2:-0.925  d9:-0.784  d11:-0.768   max |bm25()-формула|=2.2e-16
   d0  Инвертированный индекс             в заголовке 1, в тексте 1, |D|=23
   d2  Обзор индексов                     в заголовке 0, в тексте 3, |D|=46
   d11 Индексы в базе данных              в заголовке 0, в тексте 1, |D|=19
Формула совпала с bm25() на всех запросах, наибольшая разница 8.9e-16. Тут же видны две ловушки. Слова через пробел в MATCH означают AND, и запрос из четырёх слов не нашёл ни одного документа, для ранжирования запрос собирается через OR. Дефис в ORA-01555 токенизатор unicode61 режет на «ora» и «01555», и код ошибки ищется двумя токенами, зато находится ровно один документ с оценкой -6.427645. Веса колонок в bm25(docs, 10.0, 1.0) умножают частоту слова в заголовке, это упрощённый аналог BM25F. Документ d0, где «индекс» стоит в заголовке, усилился с -0.989 до -1.453, остальные не изменились.
Заключение
BM25 это три понятных множителя, а именно редкость слова, насыщение частоты и поправка на длину, сложенные по словам запроса. Формула дешёвая, объяснимая по каждому слову и точная там, где важно буквальное совпадение. Числа BM25 зависят от реализации и токенизатора, поэтому между библиотеками переносится порядок, а не оценка. Слабое место BM25 в словах, которых нет в документе, то есть синонимах, перефразах и словоформах. Его закрывают морфологией в анализаторе, а там, где этого мало, гибридным поиском с векторной половиной.