
 15

Содержание
- Что такое Apache Paimon
- Архитектура и ключевые компоненты
- Каталог, снапшоты и манифесты
- Таблицы с первичным ключом и append-таблицы
- Бакеты и партиции
- Принцип работы, LSM-дерево, компакция и merge engine
- Changelog producer, таблица как источник потока
- Apache Paimon, Apache Iceberg и Apache Hudi, чем они отличаются
- Сценарии использования, когда применять и когда не стоит
- Практика с pypaimon и Spark SQL
- Таблица с первичным ключом и changelog
- Четыре merge engine на одном ключе
- Компакция в Spark SQL
- Заключение
- Референсные ссылки
Apache Paimon это открытый табличный формат (open table format) для потокового Lakehouse, который хранит таблицу с первичным ключом в LSM-дереве (Log-Structured Merge-tree, журнально-структурированное дерево слияния) поверх файлов Parquet в объектном хранилище или HDFS. Благодаря этому таблица принимает частые upsert’ы (вставку или обновление строки по ключу) из потока, сливает версии одной строки по правилу выбранного merge engine и сама отдаёт поток изменений (changelog) следующим джобам. Проект вырос из Flink Table Store, развивается в Apache Software Foundation, актуальная версия 2.1.0 вышла 12 октября 2026 года.
Что такое Apache Paimon
Табличные форматы Lakehouse исторически рассчитаны на пакетную запись. Apache Iceberg и Delta Lake хорошо держат редкие крупные коммиты, а поток мелких обновлений по ключу порождает в них множество маленьких файлов, которые приходится сливать отдельной операцией. Apache Paimon заходил с другой стороны. Его предшественник Flink Table Store создавался в сообществе Apache Flink как хранилище для потоковых джоб и взял LSM-дерево из мира KV-хранилищ (key-value, ключ-значение) вроде RocksDB, где частая запись по ключу и есть основная нагрузка.
12 марта 2023 года проект вошёл в инкубатор Apache Software Foundation под именем Paimon, а 21 марта 2024 года стал проектом верхнего уровня. Сегодня документация называет его Data Lake Platform, единым форматом для пакетной, потоковой и мультимодальной AI-нагрузки, однако ядро формата осталось прежним, и разбор ниже посвящён именно ему.
Архитектура и ключевые компоненты
Таблица Paimon складывается из схемы, истории снапшотов и файлов, на которые эти снапшоты ссылаются. Своего сервера у формата нет. Писатель и читатель это библиотеки внутри Flink, Spark или Python-процесса, а согласованность обеспечивает атомарная публикация снапшота. Полное описание компонентов даёт документация Apache Paimon 2.1.
Каталог, снапшоты и манифесты
Каталог (catalog) упорядочивает базы и таблицы и хранит их схемы, а метаданные каталога живут на файловой системе хранилища (по умолчанию), в Hive Metastore, в базе через JDBC или за REST-сервисом. Каждый коммит публикует снапшот (snapshot), на файловой системе это JSON-файл snapshot-N. Снапшот ссылается на версию схемы и списки манифестов. Манифест (manifest) перечисляет добавленные и удалённые файлы данных со статистикой, а список манифестов (manifest list) хранит имена манифестов и статистику партиций, по которой читатель пропускает ненужное. Удалённый в манифесте файл физически остаётся, пока он нужен старым снапшотам для time travel, то есть чтения таблицы в состоянии прошлого снапшота.
Таблицы с первичным ключом и append-таблицы
Тип таблицы определяется наличием первичного ключа. Append-таблица хранит строки в том виде, в каком они пришли, и подходит для логов событий и пакетных наборов данных. Таблица с первичным ключом (primary-key table) держит одну логическую строку на ключ, хотя физических версий этой строки в файлах может быть несколько, пока их не сольёт чтение или компакция. Каждая запись в файле данных несёт тип изменения (row kind) и порядковый номер (sequence number), по которому решается, какая версия новее.
Бакеты и партиции
Партиции делят таблицу по значениям столбцов, например по дате, а бакеты (bucket) делят данные внутри партиции. У каждого бакета своё LSM-дерево, и бакет служит единицей параллелизма записи. Режим задаёт параметр bucket.
- Фиксированные бакеты. Положительное число, бакет выбирается по хэшу ключа, а сменить число бакетов можно только процедурой перемасштабирования (rescale).
- Динамические бакеты. Значение -1, режим по умолчанию для таблиц с ключом. Paimon ведёт индекс соответствия ключей бакетам и добавляет бакеты по мере роста таблицы, но в одну партицию может писать только одна джоба, иначе появятся дубли.
- Отложенные бакеты. Значение -2, настоящий бакет назначается позже пакетной операцией или компакцией.
Выбор режима сводится к балансу между параллелизмом записи и размером файлов, и для старта документация предлагает ориентир от 200 МБ до 1 ГБ данных на бакет, потому что лишние бакеты дают мелкие файлы.
Потоковая обработка данных с помощью Apache Flink
Код курса
FLINK
Ближайшая дата курса
22 декабря, 2026
Продолжительность
16 ак.часов
Стоимость обучения
51 200
Принцип работы, LSM-дерево, компакция и merge engine
Писатель копит записи бакета в памяти, сортирует их по ключу и сбрасывает отсортированным файлом на уровень 0. Каждый файл уровня 0 это отдельный отсортированный прогон (sorted run), а на верхних уровнях файлы не пересекаются по ключам и образуют один прогон на уровень. Разные прогоны хранят разные версии ключа, поэтому по умолчанию работает режим Merge On Read (MOR, слияние при чтении), где читатель сливает прогоны и применяет merge engine. Ту же схему хранения имел предшественник формата, её разбирает статья Под капотом табличного хранилища Apache Flink.
Чтобы чтение не деградировало, писатель в фоне запускает компакцию по универсальной политике (universal compaction). Порог задаёт num-sorted-run.compaction-trigger, по умолчанию 5 прогонов, а при 8 прогонах запись останавливается и ждёт компакцию (num-sorted-run.stop-trigger). Число уровней по умолчанию на единицу больше порога, поэтому уровней шесть, с 0 по 5, и полная компакция складывает весь бакет на уровень 5. Компакция публикует собственный снапшот.
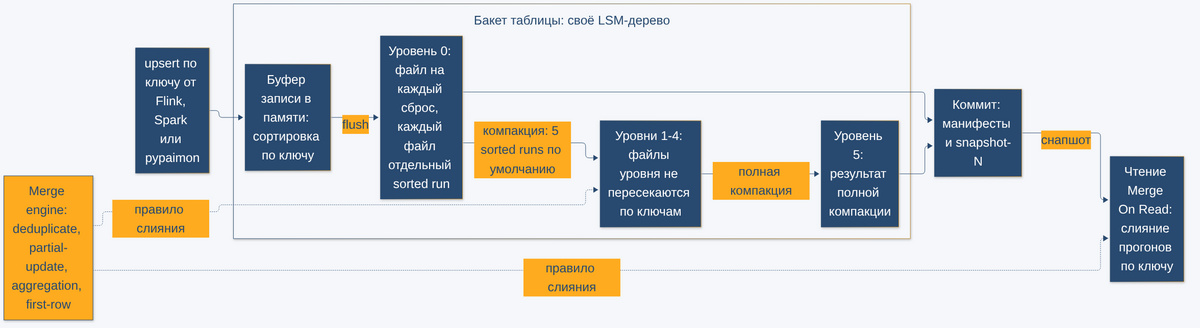
Merge engine определяет, как записи с одним ключом превращаются в одну логическую строку, и задаётся параметром merge-engine.
- deduplicate. Вариант по умолчанию, остаётся последняя полная строка. NULL в новой строке затирает прежнее значение, а пришедшая последней запись удаления убирает строку.
- partial-update. Обновляются только непустые поля, поэтому разные потоки могут дописывать разные столбцы одной сущности.
- aggregation. Каждое поле сворачивается своей функцией, например sum или max.
- first-row. Остаётся первая строка по ключу, что удобно для дедупликации событий.
Таким образом, одни и те же записи дают разный результат в зависимости от движка, что видно в практике ниже.
Если порядок прихода записей не совпадает с бизнес-порядком, задают поле последовательности (sequence field). Кроме MOR, документация описывает ещё два режима таблицы. Copy On Write (COW, копирование при записи) делает полную компакцию после каждого коммита и платит за быстрое чтение усилением записи. В Merge On Write (MOW, слияние при записи) по параметру deletion-vectors.enabled компакция помечает устаревшие строки векторами удалений (deletion vectors), и читатель обходится без слияния версий.
Changelog producer, таблица как источник потока
Потоковому потребителю мало знать новое значение строки. Если сумма заказа поменялась с 4 на 5, нижестоящая агрегация должна вычесть 4 и прибавить 5, и для этого ей нужна пара событий -U (UPDATE_BEFORE, старое значение) и +U (UPDATE_AFTER, новое значение). Какие изменения получит читатель, задаёт параметр changelog-producer, независимый от merge engine.
- none. Значение по умолчанию. Инкрементальное чтение отдаёт upsert’ы без старых значений, и Flink при необходимости восстанавливает их оператором нормализации с состоянием по всем ключам.
- input. Входные записи сохраняются ещё и в changelog-файлы и отдаются читателю как есть, без восстановления старых значений. Вариант подходит, когда полный changelog даёт сам источник, например CDC (Change Data Capture, захват изменений данных) из базы.
- lookup. Во время компакции писатель находит текущее значение ключа и порождает полный changelog. По умолчанию коммит ждёт этой компакции, так что растут задержка записи и расход памяти и локального диска на кэш.
- full-compaction. Changelog вычисляется как разница между результатами последовательных полных компакций. Промежуточные изменения между ними схлопываются, а задержка равна интервалу полной компакции.
Документация советует брать самый дешёвый вариант, который выполняет контракт потребителя, потому что лишний changelog стоит записи и места.
Apache Paimon, Apache Iceberg и Apache Hudi, чем они отличаются
Все три формата дают атомарные коммиты, снапшоты, time travel и эволюцию схемы, а различаются тем, как устроено обновление по ключу и как наружу выходит поток изменений. Delta Lake в таблицу не включён, его основная экосистема это Spark и Databricks.
| Критерий | Apache Paimon | Apache Iceberg | Apache Hudi |
|---|---|---|---|
| Хранение обновлений по ключу | LSM-дерево в каждом бакете, версии сливаются при чтении или компакции | delete-файлы или векторы удалений рядом с файлами данных | таблицы Copy On Write или Merge On Read, во втором случае обновления пишутся в лог-файлы группы файлов |
| Слияние версий ключа | четыре merge engine, включая partial-update и aggregation | строка заменяется целиком | последняя версия по полю упорядочивания, логика слияния настраивается |
| Поток изменений | changelog producer none, input, lookup или full-compaction, Flink читает изменения потоково | Flink потоково читает только append-снапшоты, CDC-чтение во Flink не поддерживается, в Spark есть процедура create_ |
CDC-запросы с образами строки до и после изменения, инкрементальные запросы |
| Основной движок записи | Flink, также Spark и Python SDK pypaimon | независим от движка, пишут Spark, Flink, Trino и другие | Spark и Flink |
| Сильная сторона | частые upsert’ы и готовый changelog в потоковых конвейерах | одна таблица для многих движков, самая широкая экосистема | инкрементальная обработка и индексы на уровне записи |
Форматы не обязательно исключают друг друга. Paimon умеет публиковать метаданные Iceberg рядом со своими (параметр metadata.iceberg.storage), и тогда таблицу читают Iceberg-коннекторы Trino, Athena или DuckDB. Запись и компакция остаются за Paimon, а обновления таблицы с ключом Iceberg-читатель видит только после полной компакции.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Сценарии использования, когда применять и когда не стоит
Paimon оправдан там, где таблица в озере постоянно меняется по ключу и её изменения нужно отдавать дальше по конвейеру.
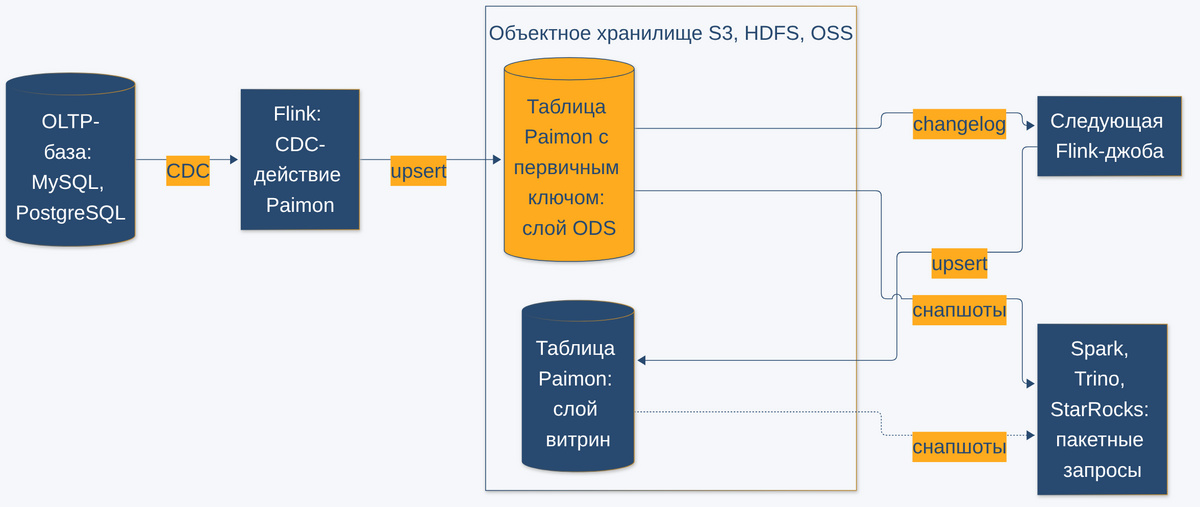
- CDC из OLTP-баз в озеро. CDC-действия Paimon на Flink забирают изменения из MySQL, PostgreSQL, MongoDB, Kafka и Pulsar, сами создают таблицы и применяют изменения схемы на ходу.
- Streamhouse на Flink. Слои конвейера соединяются таблицами Paimon, следующая джоба читает changelog предыдущей, а пакетные движки читают снапшоты. Архитектуру разбирает статья Еще одна архитектура данных: Streamhouse с Apache Paimon.
- Широкие таблицы из нескольких потоков. partial-update собирает строку сущности из событий разных систем без соединения потоков во Flink, а aggregation держит предагрегированные метрики.
- История для Apache Fluss. Потоковое хранилище Fluss переносит остывшие данные в таблицы Paimon сервисом tiering.
Общее у этих сценариев в том, что таблица в озере часто меняется по ключу, а её данные нужны и потоковым, и пакетным потребителям.
Есть и обратные случаи. Если таблица загружается пакетами раз в сутки и почти не обновляется по ключу, LSM-дерево и компакция только добавляют движущихся частей, и хватит Iceberg. На платформе, где таблицу пишут много разных движков, у Iceberg шире экосистема, а Paimon отдаёт свои таблицы Iceberg-движкам только на чтение. Команде, которая работает только из Python, стоит помнить, что pypaimon 2.1.0 компакцию не выполняет.
Практика с pypaimon и Spark SQL
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Таблицы в демо пишет pypaimon 2.1.0, Python-реализация Paimon без JVM, в каталог filesystem в локальной папке, а компакцию делает Spark 4.0.4 с коннектором paimon-spark 2.1.0 поверх тех же файлов. Прогон выполнен 15 ноября 2026 года на Ubuntu 24.04.4 с Python 3.12.3. В рабочих конвейерах основной путь записи и потокового чтения идёт через Flink SQL, его разбирает курс по потоковой обработке данных в Apache Flink.
# Apache Paimon 2.1.0, pypaimon 2.1.0, Spark 4.0.4, команды из README.md, прогнано на стенде 2026-11-15
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/python pk_table_demo.py
.venv/bin/python merge_engine_demo.py
mkdir -p jars && curl -sSfo jars/paimon-spark-4.0_2.13-2.1.0.jar \
  https://repo1.maven.org/maven2/org/apache/paimon/paimon-spark-4.0_2.13/2.1.0/paimon-spark-4.0_2.13-2.1.0.jar
HOST_UID=$(id -u) HOST_GID=$(id -g) docker compose run --rm spark-sql
Таблица с первичным ключом и changelog
Скрипт pk_table_demo.py создаёт таблицу заказов с ключом order_id на два бакета, делает два коммита и печатает снапшоты, файлы по уровням LSM-дерева и каталог таблицы. Потоковый читатель подключается между коммитами.
# pypaimon 2.1.0 (Apache Paimon 2.1.0), pyarrow 19.0.1, Python 3.12.3, прогнано на стенде 2026-11-15
"""Таблица Apache Paimon с первичным ключом: два коммита upsert'ов, снапшоты, файлы LSM и changelog.

Каталог filesystem лежит в локальной папке, JVM и кластер не нужны.
Путь к хранилищу задаётся переменной PAIMON_WAREHOUSE, по умолчанию ./warehouse рядом со скриптом.
"""
import json
import os
import shutil
from importlib.metadata import version

import pyarrow as pa
from pypaimon import CatalogFactory, Schema

HERE = os.path.dirname(os.path.abspath(__file__))
WAREHOUSE = os.environ.get("PAIMON_WAREHOUSE", os.path.join(HERE, "warehouse"))
TABLE = "shop.orders"

SCHEMA = pa.schema([
    pa.field("order_id", pa.int64(), nullable=False),
    ("customer", pa.string()),
    ("status", pa.string()),
    ("amount", pa.float64()),
])


def write_commit(table, rows):
    """Один пакет строк = один коммит = один новый снапшот."""
    wb = table.new_batch_write_builder()
    write, commit = wb.new_write(), wb.new_commit()
    write.write_arrow(pa.Table.from_pylist(rows, schema=SCHEMA))
    commit.commit(write.prepare_commit())
    write.close()
    commit.close()


def read_all(table):
    rb = table.new_read_builder()
    return rb.new_read().to_arrow(rb.new_scan().plan().splits()).sort_by("order_id")


def show(title, arrow_table):
    print(f"\n--- {title}: {arrow_table.num_rows} строк")
    print(arrow_table.to_pandas().to_string(index=False))


# Демо начинается с чистой базы shop, чтобы номера снапшотов совпадали с текстом статьи
shutil.rmtree(os.path.join(WAREHOUSE, "shop.db"), ignore_errors=True)
print("pypaimon", version("pypaimon"), "| pyarrow", pa.__version__, "| warehouse:", WAREHOUSE)

catalog = CatalogFactory.create({"warehouse": WAREHOUSE})
catalog.create_database("shop", True)
catalog.create_table(TABLE, Schema.from_pyarrow_schema(
    SCHEMA,
    primary_keys=["order_id"],
    options={
        "bucket": "2",                   # фиксированное число бакетов: ключ -> бакет по хэшу
        "merge-engine": "deduplicate",   # по ключу остаётся последняя версия строки
        "changelog-producer": "input",   # входные записи пишутся ещё и файлами changelog
    }), False)
table = catalog.get_table(TABLE)

# 1. Первый коммит: четыре новых заказа
write_commit(table, [
    {"order_id": 1, "customer": "anna", "status": "created", "amount": 120.0},
    {"order_id": 2, "customer": "boris", "status": "created", "amount": 80.0},
    {"order_id": 3, "customer": "vera", "status": "created", "amount": 45.5},
    {"order_id": 4, "customer": "gleb", "status": "created", "amount": 300.0},
])
show("чтение после коммита 1", read_all(table))

# Потоковый читатель подключается после первого коммита: сначала получает полный снимок,
# дальше только изменения новых снапшотов
srb = table.new_stream_read_builder().with_include_row_kind(True)
stream = srb.new_streaming_scan().stream_sync()
initial = next(stream)
print(f"\n--- потоковый читатель: стартовый план по снапшоту {initial.snapshot_id}, "
      f"строк {srb.new_read().to_arrow(initial.splits()).num_rows}")

# 2. Второй коммит: апдейты, два изменения одного ключа в одном пакете и новый заказ
write_commit(table, [
    {"order_id": 2, "customer": "boris", "status": "paid", "amount": 80.0},
    {"order_id": 3, "customer": "vera", "status": "cancelled", "amount": 45.5},
    {"order_id": 2, "customer": "boris", "status": "shipped", "amount": 80.0},
    {"order_id": 5, "customer": "dina", "status": "created", "amount": 15.0},
])
show("чтение после коммита 2 (merge-on-read, последняя версия по ключу)", read_all(table))

delta = next(stream)
show(f"потоковый читатель: изменения снапшота {delta.snapshot_id} (changelog-producer=input)",
     srb.new_read().to_arrow(delta.splits()))

# 3. Снапшоты: каждый коммит оставляет JSON-файл с номером, видом коммита и счётчиками
table_path = os.path.join(WAREHOUSE, "shop.db", "orders")
print("\n--- снапшоты")
for name in sorted(os.listdir(os.path.join(table_path, "snapshot"))):
    if not name.startswith("snapshot-"):
        continue
    with open(os.path.join(table_path, "snapshot", name)) as f:
        s = json.load(f)
    print(f"{name}: commitKind={s['commitKind']} totalRecordCount={s['totalRecordCount']} "
          f"deltaRecordCount={s['deltaRecordCount']} changelogRecordCount={s.get('changelogRecordCount')}")

# 4. Файлы данных последнего снапшота по бакетам и уровням LSM-дерева
print("\n--- файлы данных последнего снапшота (бакет, уровень LSM, строк, seq-номера)")
for split in sorted(table.new_read_builder().new_scan().plan().splits(), key=lambda s: s.bucket):
    for f in split.files:
        print(f"bucket={split.bucket} level={f.level} rows={f.row_count} "
              f"seq={f.min_sequence_number}..{f.max_sequence_number} {f.file_name}")
    print(f"bucket={split.bucket}: файлов {len(split.files)}, строк в файлах {split.row_count}, "
          f"raw_convertible={split.raw_convertible}")

# 5. Что лежит на диске
print("\n--- каталог таблицы")
for root, dirs, files in sorted(os.walk(table_path)):
    dirs.sort()
    rel = os.path.relpath(root, table_path)
    for name in sorted(files):
        print(os.path.join(rel, name) if rel != "." else name)
Вывод прогона целиком.
# run_output.txt, pk_table_demo.py, pypaimon 2.1.0, прогон 2026-11-15
pypaimon 2.1.0 | pyarrow 19.0.1 | warehouse: /dev/shm/apache_paimon/warehouse

--- чтение после коммита 1: 4 строк
 order_id customer  status  amount
        1     anna created   120.0
        2    boris created    80.0
        3     vera created    45.5
        4     gleb created   300.0

--- потоковый читатель: стартовый план по снапшоту 1, строк 4

--- чтение после коммита 2 (merge-on-read, последняя версия по ключу): 5 строк
 order_id customer    status  amount
        1     anna   created   120.0
        2    boris   shipped    80.0
        3     vera cancelled    45.5
        4     gleb   created   300.0
        5     dina   created    15.0

--- потоковый читатель: изменения снапшота 2 (changelog-producer=input): 3 строк
_row_kind  order_id customer    status  amount
       +I         2    boris   shipped    80.0
       +I         5     dina   created    15.0
       +I         3     vera cancelled    45.5

--- снапшоты
snapshot-1: commitKind=APPEND totalRecordCount=4 deltaRecordCount=4 changelogRecordCount=4
snapshot-2: commitKind=APPEND totalRecordCount=7 deltaRecordCount=3 changelogRecordCount=3

--- файлы данных последнего снапшота (бакет, уровень LSM, строк, seq-номера)
bucket=0 level=0 rows=3 seq=0..2 data-fcb2a267-0fdf-457e-950b-34886e05a98d-0.parquet
bucket=0 level=0 rows=2 seq=4..5 data-0441d022-2120-4169-8c15-90f048cf7fdc-0.parquet
bucket=0: файлов 2, строк в файлах 5, raw_convertible=False
bucket=1 level=0 rows=1 seq=0..0 data-11ec20e4-9d5b-478b-8107-55448a86da50-0.parquet
bucket=1 level=0 rows=1 seq=1..1 data-4c2c04f7-c850-43c8-9576-30e2a43ef0ef-0.parquet
bucket=1: файлов 2, строк в файлах 2, raw_convertible=False

--- каталог таблицы
bucket-0/changelog-678f3719-5496-4716-a888-00089b9f85cd-0.parquet
bucket-0/changelog-720b5d85-c421-4a07-adc5-513e5036ec71-0.parquet
bucket-0/data-0441d022-2120-4169-8c15-90f048cf7fdc-0.parquet
bucket-0/data-fcb2a267-0fdf-457e-950b-34886e05a98d-0.parquet
bucket-1/changelog-a7a6bdb3-05b2-410f-b2af-be2593bcb41f-0.parquet
bucket-1/changelog-b93f4dab-7e37-491e-aaf6-14ac5a7ff291-0.parquet
bucket-1/data-11ec20e4-9d5b-478b-8107-55448a86da50-0.parquet
bucket-1/data-4c2c04f7-c850-43c8-9576-30e2a43ef0ef-0.parquet
manifest/manifest-008a1a8f-30cf-4144-9731-728f967369d5-changelog-0
manifest/manifest-4955c3d5-c993-491e-9e85-07d72483eb97-0
manifest/manifest-6c3b1491-c8a7-4b13-9d06-cd7d5b959397-changelog-0
manifest/manifest-a8b5ab3b-e583-41a8-ad61-3b29f93f61cb-0
manifest/manifest-list-59f63c40-bcd1-43a0-b636-6af3dc3875c2-0
manifest/manifest-list-59f63c40-bcd1-43a0-b636-6af3dc3875c2-1
manifest/manifest-list-59f63c40-bcd1-43a0-b636-6af3dc3875c2-changelog
manifest/manifest-list-c108a652-940c-42e6-ac5d-3ae00257d9f0-0
manifest/manifest-list-c108a652-940c-42e6-ac5d-3ae00257d9f0-1
manifest/manifest-list-c108a652-940c-42e6-ac5d-3ae00257d9f0-changelog
schema/schema-0
snapshot/LATEST
snapshot/snapshot-1
snapshot/snapshot-2
После второго коммита чтение отдаёт пять строк, у заказа 2 статус shipped. В снапшоте 2 при этом стоит deltaRecordCount=3, а не 4, потому что две записи по ключу 2 пришли в одном пакете и слились ещё в буфере писателя. В файлах лежат 7 записей на 5 логических строк, все четыре файла находятся на уровне 0, а флаг raw_convertible=False говорит, что читатель обязан их сливать. Потоковый читатель получил изменения снапшота 2 тремя событиями +I, поскольку changelog-producer=input передаёт входные записи как есть и пару -U и +U не строит.
Четыре merge engine на одном ключе
Скрипт merge_engine_demo.py отправляет одну и ту же последовательность из трёх коммитов по ключу 1 в четыре таблицы с разными merge engine. Пустые поля во втором и третьем коммитах означают, что поле в событии не пришло.
# pypaimon 2.1.0 (Apache Paimon 2.1.0), pyarrow 19.0.1, Python 3.12.3, прогнано на стенде 2026-11-15
"""Одна и та же последовательность записей в четыре таблицы Apache Paimon с разным merge engine.

Три коммита по одному ключу: заказ создан, затем пришёл только статус, затем только доплата.
Пустые поля (None) в записях 2 и 3 означают «это поле в событии не пришло».
"""
import os
import shutil

import pyarrow as pa
from pypaimon import CatalogFactory, Schema

HERE = os.path.dirname(os.path.abspath(__file__))
WAREHOUSE = os.environ.get("PAIMON_WAREHOUSE", os.path.join(HERE, "warehouse"))

SCHEMA = pa.schema([
    pa.field("order_id", pa.int64(), nullable=False),
    ("customer", pa.string()),
    ("status", pa.string()),
    ("amount", pa.float64()),
])

COMMITS = [
    [{"order_id": 1, "customer": "anna", "status": "created", "amount": 100.0}],
    [{"order_id": 1, "customer": None, "status": "paid", "amount": None}],
    [{"order_id": 1, "customer": None, "status": None, "amount": 25.0}],
]

ENGINES = {
    "deduplicate": {"merge-engine": "deduplicate"},
    "partial_update": {"merge-engine": "partial-update"},
    "aggregation": {
        "merge-engine": "aggregation",
        "fields.amount.aggregate-function": "sum",                  # сумма платежей
        "fields.default-aggregate-function": "last_non_null_value",  # остальное: последнее непустое
    },
    "first_row": {"merge-engine": "first-row"},
}

# Каждый запуск с чистой базы engines; база shop из pk_table_demo.py не трогается
shutil.rmtree(os.path.join(WAREHOUSE, "engines.db"), ignore_errors=True)
catalog = CatalogFactory.create({"warehouse": WAREHOUSE})
catalog.create_database("engines", True)

print("последовательность коммитов по ключу order_id=1:")
for i, rows in enumerate(COMMITS, 1):
    print(f"  коммит {i}: {rows[0]}")

print(f"\n{'merge engine':<16}{'customer':<10}{'status':<10}{'amount':>8}")
for name, options in ENGINES.items():
    ident = f"engines.orders_{name}"
    try:
        catalog.create_table(ident, Schema.from_pyarrow_schema(
            SCHEMA, primary_keys=["order_id"], options={"bucket": "1", **options}), False)
        table = catalog.get_table(ident)
        for rows in COMMITS:
            wb = table.new_batch_write_builder()
            write, commit = wb.new_write(), wb.new_commit()
            write.write_arrow(pa.Table.from_pylist(rows, schema=SCHEMA))
            commit.commit(write.prepare_commit())
            write.close()
            commit.close()
        rb = table.new_read_builder()
        rows = rb.new_read().to_arrow(rb.new_scan().plan().splits()).to_pylist()
        if rows:
            r = rows[0]
            print(f"{options['merge-engine']:<16}{str(r['customer']):<10}{str(r['status']):<10}{r['amount']:>8}")
        else:
            # first-row: пакетное чтение пропускает уровень 0 LSM, а pypaimon компакцию не делает.
            # Стартовый план потокового чтения уровень 0 включает и показывает, что строка на месте.
            srb = table.new_stream_read_builder()
            plan = next(srb.new_streaming_scan().stream_sync())
            r = srb.new_read().to_arrow(plan.splits()).to_pylist()[0]
            print(f"{options['merge-engine']:<16}пакетное чтение: 0 строк (видит только файлы после компакции)")
            print(f"{'':<16}{str(r['customer']):<10}{str(r['status']):<10}{r['amount']:>8}"
                  "  <- потоковое чтение, уровень 0")
    except Exception as e:  # неподдержанное в Python-клиенте сочетание тоже результат
        print(f"{options['merge-engine']:<16}ОШИБКА {type(e).__name__}: {e}")
# run_output.txt, merge_engine_demo.py, pypaimon 2.1.0, прогон 2026-11-15
последовательность коммитов по ключу order_id=1:
  коммит 1: {'order_id': 1, 'customer': 'anna', 'status': 'created', 'amount': 100.0}
  коммит 2: {'order_id': 1, 'customer': None, 'status': 'paid', 'amount': None}
  коммит 3: {'order_id': 1, 'customer': None, 'status': None, 'amount': 25.0}

merge engine    customer  status      amount
deduplicate     None      None          25.0
partial-update  anna      paid          25.0
aggregation     anna      paid         125.0
first-row       пакетное чтение: 0 строк (видит только файлы после компакции)
                anna      created      100.0  <- потоковое чтение, уровень 0
deduplicate оставил последнюю строку целиком вместе с пустыми полями, partial-update собрал строку из непустых значений, а aggregation сложил платежи в 125.0. first-row в пакетном чтении вернул пустую таблицу, и это не ошибка. Пакетное чтение first-row не видит уровень 0, пока его не обработает lookup-компакция, а pypaimon 2.1.0 компакцию не выполняет. Потоковое чтение уровень 0 включает и показывает, что строка на месте.
Компакция в Spark SQL
Файл compaction.sql запускается в spark-sql с jar paimon-spark-4.0_2.13-2.1.0 поверх того же хранилища и смотрит на таблицы через системные таблицы $files и $snapshots. Каталог подключается ключами запуска spark-sql, это spark.sql.catalog.paimon со значением org.apache.paimon.spark.SparkCatalog, путь к хранилищу в spark.sql.catalog.paimon.warehouse и PaimonSparkSessionExtensions в spark.sql.extensions, без которых не работают процедуры CALL.
-- Apache Paimon 2.1.0: paimon-spark-4.0_2.13 2.1.0 на Spark 4.0.4, прогнано на стенде 2026-11-15
-- Таблицы записаны pypaimon (pk_table_demo.py и merge_engine_demo.py), компакцию делает Spark.
USE paimon;

-- 1. До компакции: все файлы на уровне 0 LSM-дерева, по файлу на коммит в каждом бакете
SELECT 'orders до компакции' AS stage, bucket, level, record_count
FROM shop.`orders$files` ORDER BY bucket, level, record_count;

-- 2. Компакция сливает файлы бакета в один отсортированный файл на верхнем уровне
CALL sys.compact(table => 'shop.orders');

SELECT 'orders после компакции' AS stage, bucket, level, record_count
FROM shop.`orders$files` ORDER BY bucket, level;

-- 3. Компакция это отдельный снапшот вида COMPACT, данные таблицы не меняются
SELECT snapshot_id, commit_kind, total_record_count, delta_record_count, changelog_record_count
FROM shop.`orders$snapshots` ORDER BY snapshot_id;

SELECT * FROM shop.orders ORDER BY order_id;

-- 4. first-row: пакетное чтение видит строку только после компакции
SELECT 'first-row до компакции, строк' AS stage, count(*) FROM engines.orders_first_row;
CALL sys.compact(table => 'engines.orders_first_row');
SELECT 'first-row после компакции' AS stage, * FROM engines.orders_first_row;
# run_output.txt, compaction.sql, Spark 4.0.4 и paimon-spark 2.1.0, прогон 2026-11-15, служебные строки Spark master, Response code и Time taken опущены
stage	bucket	level	record_count
orders до компакции	0	0	2
orders до компакции	0	0	3
orders до компакции	1	0	1
orders до компакции	1	0	1
result
true
stage	bucket	level	record_count
orders после компакции	0	5	4
orders после компакции	1	5	1
snapshot_id	commit_kind	total_record_count	delta_record_count	changelog_record_count
1	APPEND	4	4	4
2	APPEND	7	3	3
3	COMPACT	5	-2	NULL
order_id	customer	status	amount
1	anna	created	120.0
2	boris	shipped	80.0
3	vera	cancelled	45.5
4	gleb	created	300.0
5	dina	created	15.0
stage	count(1)
first-row до компакции, строк	0
result
true
stage	order_id	customer	status	amount
first-row после компакции	1	anna	created	100.0
До компакции в таблице четыре файла уровня 0. После CALL sys.compact в каждом бакете остаётся один файл на уровне 5, верхнем при шести уровнях по умолчанию. В бакете 0 пять записей слились в четыре, в бакете 1 две записи в одну, поэтому снапшот 3 вида COMPACT показывает 5 записей и дельту -2, а данные таблицы не изменились. Таблица first-row после компакции наконец отдала строку anna created 100.0.
Заключение
Apache Paimon переносит в озеро данных модель KV-хранилища. Таблица с первичным ключом пишется в LSM-дерево по бакетам, версии строки сливаются по merge engine при чтении или компакции, а changelog producer превращает таблицу в источник потока. Прогон показал обе стороны модели. Upsert’ы и changelog работают даже из чистого Python, но без компакции файлы копятся на уровне 0, поэтому в рабочем конвейере рядом с Paimon стоит Flink или Spark. Формат стоит брать для CDC в озеро и потоковых конвейеров на Flink, а для редких пакетных загрузок обычно достаточно Iceberg.