
 4

Содержание
- Что такое OLTP и какую задачу он закрывает
- Архитектура OLTP-системы
- ACID и короткие транзакции
- Строчное хранение, индексы и нормализация
- Как работает OLTP под капотом
- WAL и надёжный commit
- MVCC и уровни изоляции
- Конкуренция за строки и сбои сериализации
- OLTP, OLAP и HTAP в одной таблице
- Когда нужен OLTP, а когда нет
- Практика, нагрузка pgbench и конфликт транзакций на PostgreSQL
- Стенд PostgreSQL в Docker
- Пропускная способность и горячая строка в pgbench
- Потерянное обновление, перекос записи и повтор транзакции
- Заключение
- Референсные ссылки
OLTP (Online Transaction Processing, оперативная обработка транзакций) это класс нагрузки на базу данных, в котором тысячи пользователей одновременно выполняют короткие транзакции над отдельными строками. Оплата заказа, списание с карты, бронирование места в самолёте, смена статуса доставки делают одно и то же: читают и меняют несколько строк по ключу, а затем фиксируют изменения так, чтобы они пережили сбой сервера. От OLTP-системы ждут миллисекундного отклика на каждую операцию и правильного результата, даже когда сотни сессий одновременно трогают одни и те же данные.
Что такое OLTP и какую задачу он закрывает
Термин описывает не продукт, а характер работы с данными. OLTP-база обслуживает приложение, а не аналитика. Запросы в ней заранее известны и повторяются миллионы раз, каждый касается единиц строк, а данные в ней это текущее состояние бизнеса, то есть остатки, балансы и статусы. Типичные представители OLTP-СУБД это PostgreSQL, MySQL, Oracle Database и Microsoft SQL Server.
Общепринятым эталоном такой нагрузки служит TPC-C, бенчмарк, утверждённый в июле 1992 года консорциумом Transaction Processing Performance Council (TPC), который выпускает отраслевые тесты производительности баз данных. TPC-C моделирует оптового поставщика с 9 таблицами и 5 типами параллельных транзакций разной сложности, а результат выражается в метрике tpmC, числе транзакций в минуту. Сам консорциум подчёркивает, что модель годится для любой отрасли, которая продаёт товар или услугу.
Главная задача OLTP-системы противоречива по своей природе. Ей нужно пропустить как можно больше транзакций в секунду и при этом не дать ни одной из них увидеть или испортить чужую незаконченную работу. Всё устройство OLTP-движка вырастает из попытки совместить эти два требования.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Архитектура OLTP-системы
Архитектура OLTP-базы подчинена одному сценарию, а именно быстро найти несколько строк, изменить их и надёжно зафиксировать. Ниже разобраны две опоры этой архитектуры, транзакционная модель и способ хранения данных.
ACID и короткие транзакции
Единица работы в OLTP это транзакция, группа операций, которая выполняется целиком или не выполняется вовсе. Гарантии транзакции описывает аббревиатура ACID:
- Атомарность (Atomicity). Перевод денег либо списывает и зачисляет сумму, либо не меняет ничего.
- Согласованность (Consistency). После транзакции соблюдены все ограничения схемы, например первичные ключи и проверки CHECK.
- Изоляция (Isolation). Параллельные транзакции не мешают друг другу сильнее, чем допускает выбранный уровень изоляции.
- Долговечность (Durability). Зафиксированная транзакция переживает падение сервера.
Самой дорогой из четырёх гарантий на практике оказывается изоляция, потому что именно она определяет, сколько сессий могут работать одновременно. Поэтому правило хорошего OLTP-кода звучит просто. Транзакция должна быть короткой, не ждать ответа пользователя и не держать открытым соединение, пока приложение ходит во внешний сервис.
Строчное хранение, индексы и нормализация
OLTP-СУБД хранят данные построчно (row-oriented storage). Все поля одной записи лежат рядом на одной странице, поэтому для чтения или обновления заказа целиком движку достаточно найти одну страницу данных. Найти эту страницу помогают индексы, чаще всего B-дерево (B-tree) по первичному ключу, которое превращает поиск среди миллионов строк в несколько переходов по дереву.
Схема OLTP-базы обычно нормализована до третьей нормальной формы. Каждый факт хранится в одном месте, и смена адреса клиента означает обновление одной строки, а не тысячи копий. Обратная сторона нормализации проявляется в аналитике, где отчёт по продажам за год вынужден соединять десяток таблиц и читать каждую строку целиком, хотя нужны две колонки.
Как работает OLTP под капотом
Механику OLTP-движка удобно разбирать на примере PostgreSQL, свободной СУБД с открытым кодом, документация которой подробно описывает каждый механизм. Нагрузку в ней держат два механизма, журнал упреждающей записи и многоверсионность.
WAL и надёжный commit
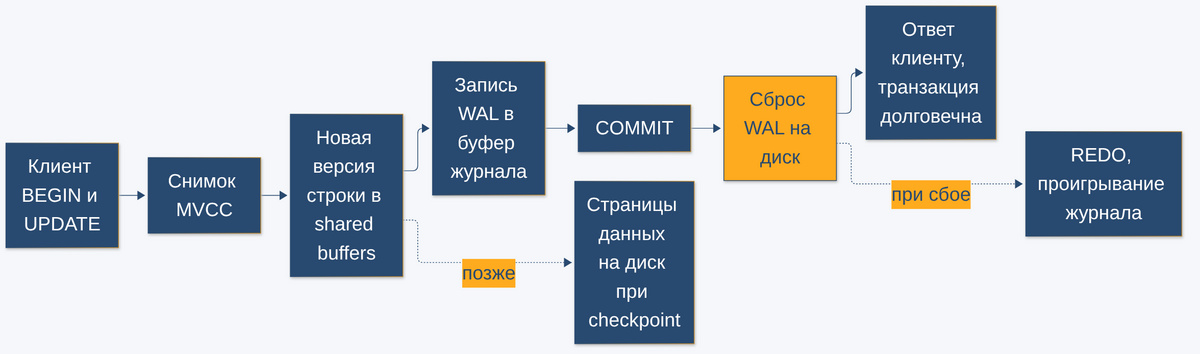
Журнал упреждающей записи (Write-Ahead Log, WAL) решает проблему долговечности без записи каждой изменённой страницы на диск. Документация PostgreSQL формулирует правило так, что изменения в файлах данных разрешено записывать только после того, как описывающие их записи WAL сброшены на постоянный носитель. При commit сервер ждёт сброса на диск только записей журнала, а сами страницы таблиц и индексов остаются в памяти и уходят на диск позже. Журнал пишется последовательно, поэтому его синхронизация обходится намного дешевле, чем запись разбросанных по файлам страниц. После сбоя PostgreSQL проигрывает журнал заново (REDO) и восстанавливает всё, что было зафиксировано.
Параметр synchronous_commit позволяет ослабить эту гарантию ради скорости. С асинхронным commit сервер отвечает клиенту до сброса журнала, и при падении теряются последние транзакции, но база остаётся согласованной. По документации асинхронного commit окно риска не превышает трёх интервалов wal_writer_delay. Для журнала событий такой обмен допустим, для платежей нет.
MVCC и уровни изоляции
Многоверсионное управление конкурентным доступом (Multi-Version Concurrency Control, MVCC) позволяет читающим и пишущим транзакциям не ждать друг друга. UPDATE в PostgreSQL не перезаписывает строку на месте, а создаёт её новую версию, и каждая транзакция видит снимок данных (snapshot), согласованный на определённый момент. В документации это сформулировано прямо, чтение никогда не блокирует запись, а запись никогда не блокирует чтение. Старые версии строк остаются в таблице мёртвыми, пока их не уберёт автовакуум, и при долгой интенсивной записи это сказывается на производительности.
Какой снимок видит транзакция, задаёт уровень изоляции. PostgreSQL принимает четыре уровня стандарта SQL, но различает внутри три, потому что Read Uncommitted ведёт себя как Read Committed.
| Уровень | Когда берётся снимок | Что допускает | Что делать приложению |
|---|---|---|---|
| Read Committed (по умолчанию) | перед каждой командой | потерянное обновление (lost update) при чтении и записи в разных командах | писать изменение в самом UPDATE или брать SELECT FOR UPDATE |
| Repeatable Read | при первой команде транзакции | перекос записи (write skew) | повторять транзакцию при SQLSTATE 40001 |
| Serializable (SSI) | как у Repeatable Read | ничего, результат эквивалентен последовательному выполнению | повторять транзакцию при SQLSTATE 40001 |
Полное описание аномалий и примеры к каждому уровню приведены в разделе документации Transaction Isolation.
Конкуренция за строки и сбои сериализации
MVCC избавляет от конфликтов между чтением и записью, но две транзакции, которые меняют одну и ту же строку, по-прежнему выстраиваются в очередь. Такая строка называется горячей (hot row). Классический пример это счётчик остатка популярного товара или баланс общего счёта, который обновляют сотни сессий в секунду. На Read Committed вторая транзакция просто ждёт блокировки строки, и пропускная способность падает без единой ошибки в журнале.
На уровнях Repeatable Read и Serializable поведение другое. Если транзакция пытается изменить строку, которую после её снимка изменила и зафиксировала конкурентная транзакция, PostgreSQL прерывает её с SQLSTATE 40001 и сообщением could not serialize access due to concurrent update. Повторять после такой ошибки нужно всю транзакцию, включая чтение, а не только упавший UPDATE, потому что исходные данные уже устарели.
Serializable в PostgreSQL реализован как сериализуемая изоляция снимков (Serializable Snapshot Isolation, SSI). Движок не ставит дополнительных блокировок, которые заставили бы транзакции ждать, а отслеживает зависимости чтения и записи между ними предикатными блокировками (predicate locks) и отменяет одну из транзакций, если из этих зависимостей складывается опасный цикл. Цена такого подхода в том, что сбои сериализации становятся штатной частью работы, и в приложении нужен общий механизм повтора для любой транзакции. Документация также советует держать транзакции короткими, помечать читающие как READ ONLY и не оставлять сессии в состоянии idle in transaction.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
OLTP, OLAP и HTAP в одной таблице
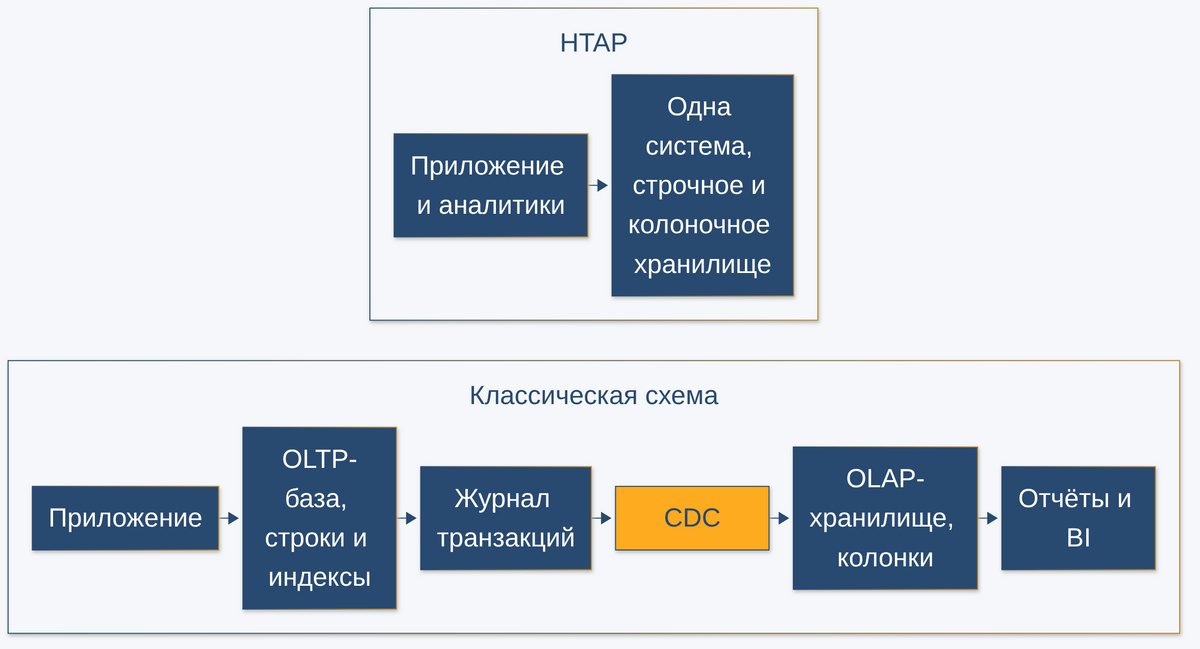
Противоположный класс нагрузки называется OLAP (Online Analytical Processing). Аналитическая база получает мало запросов, но каждый из них сканирует миллионы строк и агрегирует несколько колонок. Системы, которые пытаются обслуживать оба вида нагрузки в одном движке, называют HTAP (Hybrid Transactional/Analytical Processing).
| Признак | OLTP | OLAP | HTAP |
|---|---|---|---|
| Типичный запрос | чтение и изменение строк по ключу | агрегация по большому диапазону | оба типа в одной системе |
| Объём одной операции | единицы строк | миллионы строк | зависит от запроса |
| Хранение | строчное, индексы B-tree | колоночное, сжатие | строчное и колоночное хранилище вместе |
| Схема | нормализованная | звезда, снежинка, широкие таблицы | нормализованная с колоночными репликами |
| Метрика | TPS и задержка транзакции | время отчёта | свежесть аналитики при заданном TPS |
| Примеры | PostgreSQL, MySQL, Oracle Database | ClickHouse, Greenplum, Apache Druid | TiDB, SingleStore |
В классической архитектуре данные из OLTP-базы попадают в аналитическое хранилище через захват изменений (Change Data Capture, CDC), который читает журнал транзакций и передаёт изменения дальше без нагрузки на рабочие таблицы. Чем PostgreSQL как OLTP-СУБД отличается от MPP-платформы для аналитики, разобрано в статье блога Greenplum vs PostgreSQL, 7 сходств и 3 отличия. Построение онлайн-хранилища с потоком CDC из PostgreSQL проходят на курсе по StarRocks и HTAP-хранилищам.
Когда нужен OLTP, а когда нет
OLTP-база нужна везде, где приложение изменяет состояние и цена ошибки высока. Банковские счета, корзины и заказы интернет-магазина, складские остатки, учётные записи пользователей требуют ACID-гарантий и миллисекундного отклика, и отказаться от транзакционной СУБД здесь обычно нельзя.
Плохо OLTP-движок справляется с тяжёлыми отчётами по всей истории. Сканирование миллионов строк вытесняет из кэша рабочие данные, конкурирует с транзакциями за диск и процессор, а долгий запрос к тому же всё время выполнения не даёт очистить старые версии строк. Для таких задач данные выгружают в OLAP-хранилище. Не подходит OLTP и для потока событий, который только дописывается и никогда не обновляется, потому что журнал транзакций и индексы на каждой вставке становятся лишними издержками.
Практика, нагрузка pgbench и конфликт транзакций на PostgreSQL
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо поднимает PostgreSQL 18.6 в Docker и проверяет на нём два свойства OLTP-нагрузки. Утилита pgbench из поставки PostgreSQL показывает, как растёт пропускная способность с числом клиентов и что делает с ней горячая строка. Скрипт на Python с драйвером psycopg 3.3.7 воспроизводит конфликты двух транзакций на трёх уровнях изоляции. Прогон выполнен на Ubuntu 24.04 с 4 vCPU, контейнеру выделено 2 ГБ памяти.
Стенд PostgreSQL в Docker
Файл docker-compose.yml поднимает один контейнер с базой oltp и публикует порт только на локальный интерфейс.
# postgres 18.6 в Docker, стенд для статьи про OLTP, прогнано на стенде 2026-11-03
services:
  postgres:
    image: postgres:18.6
    container_name: oltp-postgres
    mem_limit: 2g
    environment:
      POSTGRES_USER: demo
      POSTGRES_PASSWORD: demo
      POSTGRES_DB: oltp
    ports:
      - "127.0.0.1:55433:5432"
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U demo -d oltp"]
      interval: 2s
      timeout: 3s
      retries: 30
Весь прогон запускается пятью командами из README репозитория.
# PostgreSQL 18.6, psycopg 3.3.7, прогнано на стенде 2026-11-03
# поднять базу и дождаться healthcheck
docker compose up -d --wait
# нагрузка pgbench, около полутора минут
./pgbench_load.sh
# окружение Python для второго демо
python3 -m venv .venv && .venv/bin/pip install "psycopg[binary]==3.3.7"
.venv/bin/python serialization_retry.py
# удалить контейнер вместе с данными
docker compose down -v
Пропускная способность и горячая строка в pgbench
Встроенный сценарий pgbench tpcb-like в каждой транзакции обновляет случайный счёт в pgbench_accounts, читает его баланс, обновляет кассира в pgbench_tellers и отделение в pgbench_branches и вставляет строку в pgbench_history. Документация pgbench честно оговаривает, что сценарий лишь вдохновлён бенчмарком TPC-B и им не является. Масштаб -s задаёт число строк, и при scale 1 в таблице отделений ровно одна строка.
#!/usr/bin/env bash
# pgbench 18.6 из образа postgres:18.6, сценарий tpcb-like, прогнано на стенде 2026-11-03
# OLTP-нагрузка на PostgreSQL: TPS при 1, 4 и 16 клиентах и эффект горячей строки.
set -euo pipefail

CONTAINER=${CONTAINER:-oltp-postgres}
DB=oltp
DUR=${DUR:-20}   # секунд на каждый замер

# pgbench запускается внутри контейнера, отдельная установка не нужна
pgb() { docker exec -e PGPASSWORD=demo "$CONTAINER" pgbench -h localhost -U demo "$@"; }

# из длинного отчёта pgbench оставляем строки, которые сравниваем между замерами
summary() { grep -E '^(scaling factor|number of clients|number of transactions actually|number of failed|latency average|tps)'; }

# 1. Инициализация: scale 16 даёт 16 строк branches, 160 tellers и 1 600 000 accounts
echo "--- инициализация, scale 16 ---"
pgb -i -s 16 -q "$DB" 2>&1 | tail -n 1

# 2. Масштабирование по клиентам: каждая транзакция tpcb-like это 3 UPDATE, SELECT и INSERT
for c in 1 4 16; do
  j=$(( c &1 | summary
done

# 3. Горячая строка: при scale 1 в branches одна строка, и все 16 клиентов обновляют именно её
echo
echo "--- инициализация, scale 1 ---"
pgb -i -s 1 -q "$DB" 2>&1 | tail -n 1
echo
echo "--- tpcb-like, scale 1, клиентов 16 (горячая строка) ---"
pgb -c 16 -j 4 -T "$DUR" "$DB" 2>&1 | summary
# вывод прогона на стенде 2026-11-03, pgbench 18.6
--- инициализация, scale 16 ---
done in 5.29 s (drop tables 0.01 s, create tables 0.04 s, client-side generate 3.98 s, vacuum 0.29 s, primary keys 0.97 s).

--- tpcb-like, scale 16, клиентов 1 ---
scaling factor: 16
number of clients: 1
number of transactions actually processed: 1990
number of failed transactions: 0 (0.000%)
latency average = 10.042 ms
tps = 99.580371 (without initial connection time)

--- tpcb-like, scale 16, клиентов 4 ---
scaling factor: 16
number of clients: 4
number of transactions actually processed: 4908
number of failed transactions: 0 (0.000%)
latency average = 16.307 ms
tps = 245.286641 (without initial connection time)

--- tpcb-like, scale 16, клиентов 16 ---
scaling factor: 16
number of clients: 16
number of transactions actually processed: 9752
number of failed transactions: 0 (0.000%)
latency average = 32.882 ms
tps = 486.588358 (without initial connection time)

--- инициализация, scale 1 ---
done in 0.65 s (drop tables 0.09 s, create tables 0.04 s, client-side generate 0.29 s, vacuum 0.14 s, primary keys 0.10 s).

--- tpcb-like, scale 1, клиентов 16 (горячая строка) ---
scaling factor: 1
number of clients: 16
number of transactions actually processed: 2708
number of failed transactions: 0 (0.000%)
latency average = 118.766 ms
tps = 134.718748 (without initial connection time)
Рост пропускной способности оказался сублинейным. Четыре клиента дали 245.286641 TPS, в 2.46 раза больше одного, а шестнадцать клиентов 486.588358 TPS, в 4.89 раза больше, хотя средняя задержка транзакции выросла с 10.042 до 32.882 ms. Часть этого эффекта объясняется стендом, где pgbench и сервер делят те же 4 vCPU, и документация pgbench прямо советует запускать нагрузку с отдельной машины.
Горячая строка видна сразу. Те же 16 клиентов при scale 1 обработали 134.718748 TPS, в 3.6 раза меньше, чем при scale 16, а средняя задержка выросла до 118.766 ms. Ошибок при этом 0 во всех замерах, потому что на Read Committed спор за единственную строку pgbench_branches выражается ожиданием блокировки, а не сбоем. Именно поэтому документация pgbench требует, чтобы масштаб был не меньше числа клиентов, иначе тест измеряет очередь к одной строке, а не производительность базы.
Потерянное обновление, перекос записи и повтор транзакции
Скрипт serialization_retry.py открывает две сессии и вручную чередует их шаги, поэтому конфликт воспроизводится каждый раз одинаково. Первый сценарий списывает по 100 с баланса 1000 двумя транзакциями, второй отправляет с дежурства двух врачей при правиле, что дежурить должен хотя бы один.
# PostgreSQL 18.6 (postgres:18.6), psycopg 3.3.7, прогнано на стенде 2026-11-03
"""Две конкурирующие OLTP-транзакции на PostgreSQL.

Сценарий 1. Потерянное обновление (lost update): приложение читает баланс и пишет
вычисленное значение. На READ COMMITTED одно списание пропадает, на REPEATABLE READ
вторая транзакция получает SQLSTATE 40001 и повторяется целиком.

Сценарий 2. Перекос записи (write skew): две транзакции читают общее условие и меняют
разные строки. REPEATABLE READ его пропускает, SERIALIZABLE (SSI) ловит без блокировок.
"""
import os

import psycopg
from psycopg import errors

DSN = os.environ.get("PG_DSN", "postgresql://demo:demo@127.0.0.1:55433/oltp")


def connect():
    # autocommit=True: границы транзакций задаём сами командами BEGIN и COMMIT
    return psycopg.connect(DSN, autocommit=True)


def reset(conn):
    conn.execute("DROP TABLE IF EXISTS accounts, doctors")
    conn.execute("CREATE TABLE accounts (id int PRIMARY KEY, balance int NOT NULL)")
    conn.execute("INSERT INTO accounts VALUES (1, 1000)")
    conn.execute("CREATE TABLE doctors (name text PRIMARY KEY, on_call bool NOT NULL)")
    conn.execute("INSERT INTO doctors VALUES ('alice', true), ('bob', true)")


def balance(conn):
    return conn.execute("SELECT balance FROM accounts WHERE id = 1").fetchone()[0]


def withdraw(conn, amount):
    # чтение и запись разнесены, как в типичном коде приложения
    current = balance(conn)
    conn.execute("UPDATE accounts SET balance = %s WHERE id = 1", (current - amount,))
    return current


def lost_update(level):
    print(f"\n--- сценарий 1, {level}: два списания по 100 с баланса 1000 ---")
    admin, t1, t2 = connect(), connect(), connect()
    reset(admin)

    # T1 начинает и читает баланс, но запись пока не делает
    t1.execute(f"BEGIN ISOLATION LEVEL {level}")
    seen = balance(t1)
    print(f"T1 прочитала баланс {seen}")

    # T2 успевает целиком: прочитать, списать 100 и зафиксироваться
    t2.execute(f"BEGIN ISOLATION LEVEL {level}")
    withdraw(t2, 100)
    t2.execute("COMMIT")
    print(f"T2 списала 100 и сделала COMMIT, в базе {balance(admin)}")

    # T1 пишет значение, вычисленное из своего чтения
    attempt = 1
    while True:
        try:
            if attempt > 1:
                t1.execute(f"BEGIN ISOLATION LEVEL {level}")
                seen = balance(t1)
            t1.execute("UPDATE accounts SET balance = %s WHERE id = 1", (seen - 100,))
            t1.execute("COMMIT")
            print(f"T1 попытка {attempt}: записала {seen - 100}, COMMIT")
            break
        except errors.SerializationFailure as e:
            # 40001: повторять нужно всю транзакцию с чтением, а не один UPDATE
            t1.execute("ROLLBACK")
            print(f"T1 попытка {attempt}: SQLSTATE {e.sqlstate} {e.diag.message_primary}")
            attempt += 1

    print(f"итог: баланс {balance(admin)}, ожидалось 800")
    for c in (admin, t1, t2):
        c.close()


def go_off_call(conn, name):
    # правило: уйти с дежурства можно, только если дежурит хотя бы ещё один врач
    on_call = conn.execute("SELECT count(*) FROM doctors WHERE on_call").fetchone()[0]
    if on_call >= 2:
        conn.execute("UPDATE doctors SET on_call = false WHERE name = %s", (name,))
    return on_call


def write_skew(level):
    print(f"\n--- сценарий 2, {level}: alice и bob одновременно уходят с дежурства ---")
    admin, t1, t2 = connect(), connect(), connect()
    reset(admin)

    t1.execute(f"BEGIN ISOLATION LEVEL {level}")
    t2.execute(f"BEGIN ISOLATION LEVEL {level}")
    # обе транзакции видят двух дежурных и меняют разные строки, блокировок друг на друга нет
    print(f"T1 (alice) видит дежурных: {go_off_call(t1, 'alice')}")
    print(f"T2 (bob) видит дежурных: {go_off_call(t2, 'bob')}")

    for tag, conn in (("T1", t1), ("T2", t2)):
        try:
            conn.execute("COMMIT")
            print(f"{tag}: COMMIT прошёл")
        except errors.SerializationFailure as e:
            conn.execute("ROLLBACK")
            print(f"{tag}: SQLSTATE {e.sqlstate} {e.diag.message_primary}")
            print(f"{tag}: detail {e.diag.message_detail}")

    left = admin.execute("SELECT count(*) FROM doctors WHERE on_call").fetchone()[0]
    print(f"итог: дежурных {left}, правило требует не меньше 1")
    for c in (admin, t1, t2):
        c.close()


if __name__ == "__main__":
    with connect() as c:
        print("server_version:", c.execute("SHOW server_version").fetchone()[0])
        print("default_transaction_isolation:",
              c.execute("SHOW default_transaction_isolation").fetchone()[0])
    print("psycopg:", psycopg.__version__)

    lost_update("READ COMMITTED")
    lost_update("REPEATABLE READ")
    write_skew("REPEATABLE READ")
    write_skew("SERIALIZABLE")
# вывод прогона на стенде 2026-11-03, PostgreSQL 18.6, psycopg 3.3.7
server_version: 18.6 (Debian 18.6-1.pgdg13+2)
default_transaction_isolation: read committed
psycopg: 3.3.7

--- сценарий 1, READ COMMITTED: два списания по 100 с баланса 1000 ---
T1 прочитала баланс 1000
T2 списала 100 и сделала COMMIT, в базе 900
T1 попытка 1: записала 900, COMMIT
итог: баланс 900, ожидалось 800

--- сценарий 1, REPEATABLE READ: два списания по 100 с баланса 1000 ---
T1 прочитала баланс 1000
T2 списала 100 и сделала COMMIT, в базе 900
T1 попытка 1: SQLSTATE 40001 could not serialize access due to concurrent update
T1 попытка 2: записала 800, COMMIT
итог: баланс 800, ожидалось 800

--- сценарий 2, REPEATABLE READ: alice и bob одновременно уходят с дежурства ---
T1 (alice) видит дежурных: 2
T2 (bob) видит дежурных: 2
T1: COMMIT прошёл
T2: COMMIT прошёл
итог: дежурных 0, правило требует не меньше 1

--- сценарий 2, SERIALIZABLE: alice и bob одновременно уходят с дежурства ---
T1 (alice) видит дежурных: 2
T2 (bob) видит дежурных: 2
T1: COMMIT прошёл
T2: SQLSTATE 40001 could not serialize access due to read/write dependencies among transactions
T2: detail Reason code: Canceled on identification as a pivot, during commit attempt.
итог: дежурных 1, правило требует не меньше 1
Самый неприятный результат дал уровень по умолчанию. На Read Committed обе транзакции зафиксировались без единой ошибки, а в базе остался баланс 900 вместо 800, и одно списание исчезло. От такой потери защищает запись вида balance = balance — 100 прямо в UPDATE, блокировка строки через SELECT FOR UPDATE или более строгий уровень изоляции. На Repeatable Read первая попытка T1 получила SQLSTATE 40001, вторая перечитала баланс и записала верные 800.
Перекос записи Repeatable Read не заметил. Транзакции меняли разные строки, конфликта по записи не возникло, и в итоге не осталось ни одного дежурного врача. Serializable поймал ту же ситуацию, причём ошибка пришла не на UPDATE, а на COMMIT второй транзакции с пометкой Canceled on identification as a pivot. Блокировок, которые заставили бы T1 или T2 ждать, при этом не было.
Заключение
OLTP это нагрузка из множества коротких транзакций над отдельными строками, и вся архитектура транзакционной СУБД, от строчного хранения и индексов до WAL и MVCC, служит тому, чтобы такие транзакции шли параллельно и не портили друг другу данные. Прогон на PostgreSQL 18.6 показал две вещи, которые не видны из документации на первый взгляд. Горячая строка срезает пропускную способность в разы без единой ошибки, а потерянное обновление на уровне изоляции по умолчанию проходит молча. Поэтому проектирование OLTP-системы начинается с вопросов, какие строки станут горячими и какой уровень изоляции нужен каждой транзакции, а код приложения с самого начала должен уметь повторять транзакцию при SQLSTATE 40001.