
 14
Содержание
- Что такое Apache Fluss
- Архитектура и ключевые компоненты
- CoordinatorServer, TabletServer и ZooKeeper
- Log Table и Primary Key Table
- Remote storage и Lakehouse tiering
- Принцип работы, колоночный лог, changelog и Union Read
- Apache Fluss и Apache Kafka, хранилище против транспорта
- Ограничения и подводные камни версии 1.0
- Сценарии использования, когда применять и когда не стоит
- Практика на Python-клиенте pyfluss
- Стенд из бинарного дистрибутива
- Таблица с первичным ключом, upsert, lookup и changelog
- Лог-таблица, проекция и фильтр
- Заключение
- Референсные ссылки
Apache Fluss это открытое потоковое хранилище (streaming storage) для аналитики реального времени, которое держит поток событий не как очередь сообщений, а как таблицы со схемой. Таблица без первичного ключа пишется колоночным логом в формате Apache Arrow, таблица с первичным ключом принимает upsert, отвечает на точечный lookup по ключу и отдаёт поток изменений (changelog), а старые данные переносятся в форматы Lakehouse вроде Apache Paimon и Apache Iceberg. Проект Apache Software Foundation, основной движок для него Apache Flink, версия 1.0.0 вышла 21 сентября 2026 года как первый релиз после инкубатора.
Что такое Apache Fluss
Документация определяет Apache Fluss как lakehouse-native streaming storage, то есть потоковое хранилище, изначально рассчитанное на работу в паре с Lakehouse. Название по-немецки значит «река». Задачу проекта видно на типичном конвейере Flink. События лежат в топиках Apache Kafka, джоба обогащает их данными справочника из внешнего KV-хранилища (key-value store, хранилище ключ-значение) вроде Redis и пишет результат в следующий топик, а для аналитики те же данные ещё раз копируются в озеро. Получается три системы, и у каждой своя модель согласованности.
Fluss сводит эти роли в одно хранилище. Промежуточный результат пишется в таблицу и читается следующей джобой как changelog, справочник хранится в таблице с первичным ключом для lookup join (соединение с поиском по ключу), а история уходит в Paimon или Iceberg без отдельной выгрузки. Мотивацию проекта для Flink-конвейеров подробно разбирает статья Зачем вам Fluss: новое унифицированное потоковое хранилище для работы с Apache Flink. В версии 1.0 проект позиционирует себя ещё и как слой данных для AI-нагрузок с выборкой признаков по ключу (feature lookup).
Архитектура и ключевые компоненты
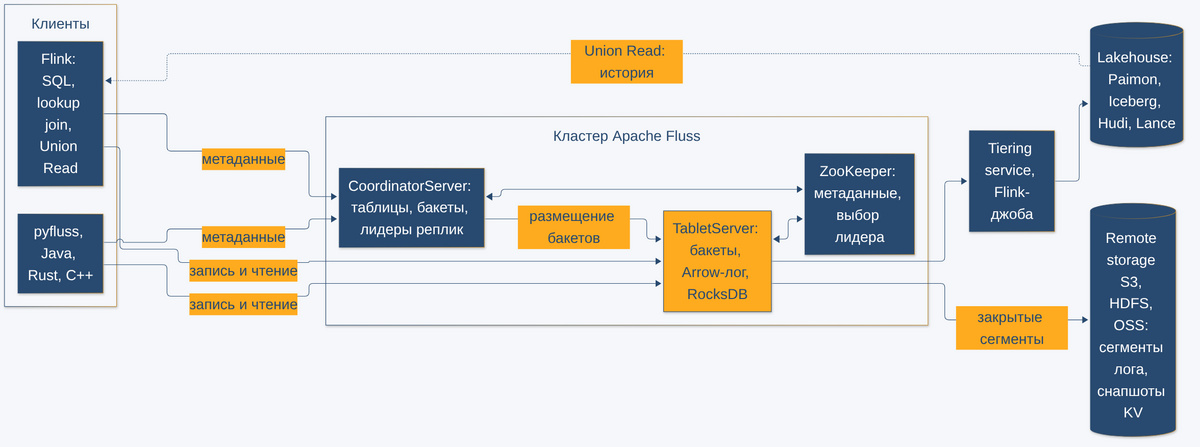
Кластер Apache Fluss внешне похож на кластер Kafka, но единица данных у него таблица, а не топик. Таблица делится на бакеты (bucket), и бакет служит единицей распределения данных, порядка записей в логе и размещения реплик. Параметр default.bucket.number по умолчанию равен единице, поэтому в рабочих таблицах число бакетов задают явно.
CoordinatorServer, TabletServer и ZooKeeper
Серверная часть состоит из трёх ролей, их обязанности описаны в разделе архитектуры официальной документации.
- CoordinatorServer. Управляет метаданными баз, таблиц и партиций, следит за составом TabletServer и решает, где лежат реплики бакетов и какая из них лидер. Данные через координатор не идут, клиенты пишут и читают напрямую с TabletServer. С версии 1.0 координаторов может быть несколько (Coordinator HA, High Availability).
- TabletServer. Хранит реплики бакетов, обслуживает запись и чтение, реплицирует лог и выполняет фоновые задачи с локальным диском. Текущее состояние таблиц с первичным ключом он держит в RocksDB, встраиваемой KV-базе.
- ZooKeeper. Хранит метаданные кластера, регистрирует серверы и выбирает лидера среди координаторов.
Основной клиент это коннектор Flink, в версии 1.0 поддержан Flink 2.3. Кроме того, есть интеграция с Apache Spark и клиенты на Java, Rust, Python и C++, а новый Fluss Gateway, REST-сервис на Rust без JVM (Java Virtual Machine), даёт управление таблицами и пакетную запись по HTTP.
Log Table и Primary Key Table
Тип таблицы определяется одним признаком, наличием первичного ключа. Log Table (лог-таблица) создаётся без ключа и принимает только добавление строк. По умолчанию её лог хранится в колоночном формате Apache Arrow (параметр table.log.format, значение ARROW) со сжатием ZSTD (Zstandard). Колоночный лог позволяет серверу отдать читателю только нужные колонки.
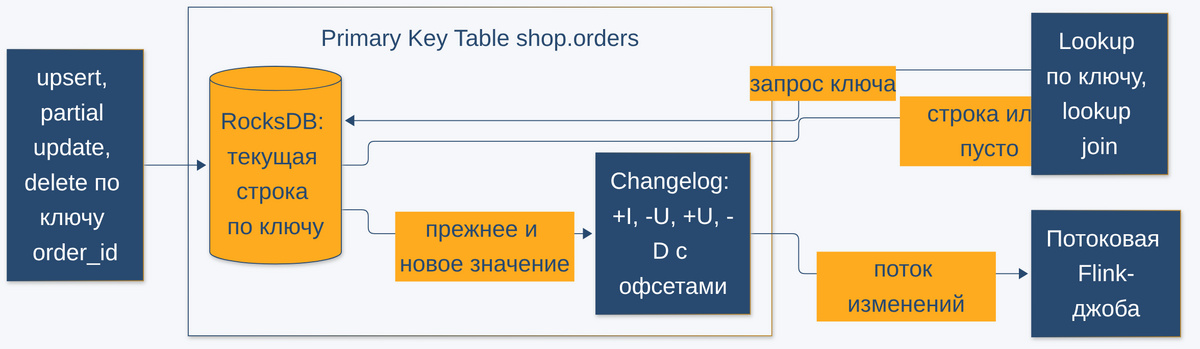
Primary Key Table (таблица с первичным ключом) хранит текущее состояние строк в RocksDB и принимает upsert, частичное обновление (partial update) и удаление по ключу. Каждая операция дописывает событие в changelog, поэтому таблица служит и KV-хранилищем для lookup, и потоком изменений. Как сливаются записи с одинаковым ключом, задаёт merge engine. По умолчанию побеждает последняя запись (LastRow), кроме того, есть варианты FirstRow, Versioned и Aggregation.
Remote storage и Lakehouse tiering
Локальный диск TabletServer хранит только свежую часть данных. Закрытые сегменты лога и снапшоты RocksDB уходят в удалённое хранилище (remote storage), например S3, HDFS или OSS, во внутреннем формате Fluss.
Для аналитики служит второй уровень, Lakehouse tiering. Tiering service (служба переноса в озеро) работает отдельной Flink-джобой, читает таблицы Fluss и пишет их в табличный формат озера. Документация называет Apache Paimon, Apache Iceberg, Apache Hudi (добавлен в 1.0) и Lance, колоночный формат компании LanceDB для данных машинного обучения. Связка потокового хранилища с Paimon близка к архитектуре из статьи Еще одна архитектура данных: Streamhouse с Apache Paimon.
Потоковая обработка данных с помощью Apache Flink
Код курса
FLINK
Ближайшая дата курса
22 декабря, 2026
Продолжительность
16 ак.часов
Стоимость обучения
51 200
Принцип работы, колоночный лог, changelog и Union Read
Запись в лог-таблицу приходит батчами Arrow и в том же колоночном виде ложится на диск. При чтении клиент или Flink-коннектор передаёт список нужных колонок, и сервер вырезает их из батча до отправки по сети. Фильтр работает грубее. Сервер по колоночной статистике отбрасывает батчи, где нужного значения быть не может, а строки внутри оставшихся проверяет движок.
В таблице с первичным ключом каждая запись меняет строку в RocksDB, а в changelog уходят события в нотации Flink. Новый ключ даёт +I (insert), замена существующей строки даёт пару -U (update_before, прежнее значение) и +U (update_after, новое значение), удаление даёт -D. Flink-джоба получает готовый поток изменений, а не сырые upsert-сообщения, которые пришлось бы сворачивать в своё состояние. Lookup отвечает из того же RocksDB, и в lookup join условие соединения обязано включать все колонки первичного ключа.
Union Read (объединённое чтение) закрывает разрыв между двумя уровнями хранения. Запрос к таблице с включённым tiering читает уже перенесённую часть из озера, а свежий хвост, который до озера ещё не дошёл, добирает из Fluss. Работает это только через коннектор Fluss для Flink или Spark, а движок, читающий Paimon или Iceberg напрямую, увидит лишь зафиксированное tiering.
Apache Fluss и Apache Kafka, хранилище против транспорта
Fluss тоже хранит упорядоченный лог и читается потоком с офсета, но Kafka это транспорт сообщений, содержимое которых брокер не разбирает, а Fluss это хранилище таблиц со схемой.
| Критерий | Apache Kafka | Apache Fluss 1.0 |
|---|---|---|
| Модель данных | Топик с сообщениями, ключ и значение это байты, схема живёт во внешнем Schema Registry | Таблица со схемой в базе, тип таблицы задаёт наличие первичного ключа |
| Формат хранения | Батчи записей построчно | Колонки Arrow для лог-таблиц, RocksDB для состояния таблиц с ключом |
| Обновление по ключу | Compacted topic со временем оставляет последнее значение, прежнее значение потребитель не получает | Upsert и partial update, changelog с парами -U и +U |
| Точечный lookup | Нет, нужно внешнее KV-хранилище | Lookup по первичному ключу и по префиксу ключа |
| Проекция и фильтр при чтении | Потребитель получает сообщение целиком | Сервер вырезает колонки, фильтр отбрасывает батчи по статистике |
| Связь с Lakehouse | Tiered Storage выносит сегменты в объектное хранилище в формате Kafka, в таблицы озера данные переносят коннекторы | Tiering в Paimon, Iceberg, Hudi и Lance, Union Read свежего хвоста |
| Экосистема и зрелость | Индустриальный стандарт, клиенты почти на любом языке, Kafka Connect и Kafka Streams | Первый релиз после инкубатора в 2026 году, движки Flink и Spark, клиенты Java, Rust, Python и C++ |
Таким образом, Fluss не заменяет Kafka как шину между сервисами и коннекторами CDC (Change Data Capture, захват изменений данных). Он выигрывает внутри аналитического конвейера на Flink, где топики, внешний KV и выгрузка в озеро сводятся к таблицам одного хранилища.
Apache Kafka для инженеров данных
Код курса
DEVKI
Ближайшая дата курса
7 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Ограничения и подводные камни версии 1.0
Анонс релиза Apache Fluss 1.0 сам перечисляет ограничения, прогон к статье добавил свои.
- Изменение числа бакетов. Bucket rescaling не работает для непартиционированных таблиц, для таблиц с merge engine Aggregation и для таблиц с доступом к историческим партициям.
- Исторические партиции. Чтение партиций, которые уже ушли в озеро, поддержано только для Paimon и только при одной колонке партиционирования.
- Filter pushdown. Работает только для лог-таблиц в формате Arrow и только для данных, записанных после включения колоночной статистики. По умолчанию статистика не собирается, её включает свойство таблицы table.statistics.columns, и без него фильтр в прогоне не отсёк ни одного батча.
- Протоколы. PostgreSQL wire protocol, gRPC и сервер MCP (Model Context Protocol, протокол подключения инструментов к LLM) запланированы, но в 1.0 их нет.
- Системные колонки. Новые lake-таблицы Paimon и Iceberg по умолчанию создаются без колонок __bucket, __offset и __timestamp.
- Защита диска. TabletServer перестаёт принимать запись, когда диск с данными заполнен на 85%, и возобновляет её при 80% (параметры server.data-disk.write-limit-ratio и server.data-disk.write-recover-ratio в справочнике конфигурации Fluss). В прогоне клиент pyfluss не получил исключения, flush() просто висел, а причина нашлась в логе сервера.
- Вес стенда. Минимальный кластер это три JVM, а официальный quickstart добавляет Flink и S3-совместимое хранилище.
Большая часть ограничений касается эксплуатации, поэтому число бакетов и запас диска планируют заранее.
Сценарии использования, когда применять и когда не стоит
Fluss окупается там, где конвейер на Flink или Spark держит рядом несколько систем ради одной задачи.
- Обогащение потока через lookup join. Справочник обновляется тем же потоком, а не загрузкой во внешний KV.
- Многоступенчатые конвейеры. Результат джобы читается следующей как changelog, без промежуточного топика.
- Широкие события и частичное чтение. Проекция колоночного лога экономит сеть, когда отчёту из 50 колонок нужны 3.
- Свежие данные поверх озера. Union Read добавляет к запросу по Paimon или Iceberg хвост, который ещё не перенесён.
- Признаки для моделей. Признаки по ключу пользователя читаются из таблицы, которую пишет потоковый конвейер.
Fluss лишний, если поток нужен только как транспорт между сервисами, если потребители живут вне Flink и Spark и ждут протокол Kafka, или если нужна одна лёгкая система без нескольких JVM. Заменой базе с миллисекундными точечными чтениями он тоже не служит, особенно через Python-клиент, как показала практика ниже.
Практика на Python-клиенте pyfluss
Демо проверяет оба типа таблиц без Flink, через официальный Python-клиент pyfluss 1.0.0 поверх Rust-клиента Fluss. Кластер Apache Fluss 1.0.0 поднят из бинарного дистрибутива штатным скриптом local-cluster.sh в контейнере с JDK (Java Development Kit) 17 в сборке Temurin 17.0.19, клиент работает на Python 3.12.3 с pyarrow 26.0.1, хост Ubuntu 24.04. Lookup join, tiering и Union Read требуют Flink и разбираются в программе курса потоковой обработки данных на Apache Flink.
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Стенд из бинарного дистрибутива
Из дистрибутива на 522 МБ кластеру нужны только каталоги lib, bin и conf, около 86 МБ. Файл server.yaml повторяет conf/server.yaml из дистрибутива и добавляет лимиты памяти JVM.
# Apache Fluss 1.0.0, conf/server.yaml для local cluster, прогнано на стенде 2026-11-14
# Основа: conf/server.yaml из дистрибутива 1.0.0, добавлены только лимиты памяти JVM.
zookeeper.address: localhost:2181
bind.listeners: FLUSS://localhost:9123
# локальные данные TabletServer: лог-сегменты и RocksDB для таблиц с первичным ключом
data.dir: /tmp/fluss-data
# сюда уходят старые сегменты лога и снапшоты KV; в проде это S3, OSS или HDFS
remote.data.dir: /tmp/fluss-remote-data
default.bucket.number: 1
default.replication.factor: 1
tablet-server.id: 0
# дистрибутив не задаёт heap, и JVM берёт четверть памяти; для демо хватает 512 МБ на сервер
env.java.opts.all: -Xmx512m
zookeeper.heap.mb: 128
Файл docker-compose.yml запускает три JVM в одном контейнере. Сеть хоста нужна потому, что TabletServer в режиме local cluster слушает случайный порт и сообщает его клиентам через метаданные.
# Apache Fluss 1.0.0, local cluster из бинарного дистрибутива на JDK 17 (Temurin), прогнано на стенде 2026-11-14
# Один контейнер держит три JVM: ZooKeeper, CoordinatorServer и TabletServer, их запускает штатный
# bin/local-cluster.sh из дистрибутива. Сам дистрибутив лежит рядом в ./fluss-1.0.0 (см. RUNBOOK, шаг 1).
services:
  fluss:
    # любой образ с JDK 17+; Fluss 1.0 проверяет версию Java при старте (bin/config.sh)
    image: ${JAVA_IMAGE:-eclipse-temurin:17-jre}
    container_name: apache-fluss-local
    # TabletServer в local cluster слушает случайный порт и сообщает его клиентам через метаданные,
    # поэтому проброс отдельных портов не годится: контейнер живёт в сети хоста (Linux)
    network_mode: host
    # пишем логи в ./fluss-1.0.0/log от имени владельца папки, а не от root
    user: "${HOST_UID:-1000}:${HOST_GID:-1000}"
    mem_limit: 3g
    environment:
      FLUSS_HOME: /opt/fluss
    volumes:
      - ./fluss-1.0.0:/opt/fluss
      - ${FLUSS_SERVER_YAML:-./server.yaml}:/opt/fluss/conf/server.yaml:ro
    entrypoint: ["bash", "-c"]
    # старт трёх процессов в фоне, затем ждём SIGTERM от docker compose down и гасим кластер штатно
    command:
      - |
        /opt/fluss/bin/local-cluster.sh start
        trap '/opt/fluss/bin/local-cluster.sh stop; exit 0' TERM INT
        sleep infinity & wait
    healthcheck:
      # CoordinatorServer принимает клиентов на 9123; готовность TabletServer проверяют сами скрипты
      test: ["CMD-SHELL", "bash -c 'echo > /dev/tcp/127.0.0.1/9123'"]
      interval: 3s
      timeout: 3s
      retries: 40
Весь прогон укладывается в несколько команд из README.md репозитория.
# Apache Fluss 1.0.0, pyfluss 1.0.0, команды из README.md, прогнано на стенде 2026-11-14
# из дистрибутива берём только lib, bin и conf
curl -sL https://dlcdn.apache.org/fluss/fluss-1.0.0/fluss-1.0.0-bin.tgz \
  | tar xzf - fluss-1.0.0/lib fluss-1.0.0/bin fluss-1.0.0/conf
docker compose up -d --wait            # или с локальным JDK 17: см. RUNBOOK, шаг 2
# клиент в отдельном venv
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/python pk_table_demo.py
.venv/bin/python log_table_projection.py
docker compose down
Открытый порт 9123 ещё не значит готовый кластер. Первый запрос иногда получает ошибку «This coordinator server is not the current leader», поэтому скрипты подключаются в цикле до 90 секунд. В работе контейнер занял 401.9 МиБ памяти, кластер поднимался за 4-5 секунд.
Таблица с первичным ключом, upsert, lookup и changelog
Скрипт pk_table_demo.py создаёт таблицу заказов shop.orders с ключом order_id, пишет три заказа, обновляет статус, повторяет ту же строку, частично обновляет сумму и удаляет заказ, проверяя каждый шаг через lookup, затем замеряет задержку lookup и читает changelog.
# pyfluss 1.0.0, Apache Fluss 1.0.0 local cluster, прогнано на стенде 2026-11-14
"""Таблица с первичным ключом в Apache Fluss: upsert, частичное обновление, удаление,
точечный lookup по ключу и changelog, который та же таблица отдаёт потоковому читателю.

Запуск: python pk_table_demo.py [--bootstrap localhost:9123]
"""
import argparse
import asyncio
import time

import fluss
import pyarrow as pa

DB = "shop"
TABLE = "orders"


async def connect(bootstrap: str) -> fluss.FlussConnection:
    """Подключение к кластеру и ожидание, пока зарегистрируется TabletServer."""
    deadline = time.monotonic() + 90
    while True:
        try:
            conn = await fluss.FlussConnection.create(fluss.Config({"bootstrap.servers": bootstrap}))
            nodes = await conn.get_admin().get_server_nodes()
            kinds = sorted(n.server_type for n in nodes)
            if any("Tablet" in k for k in kinds):
                print("кластер:", ", ".join(f"{n.server_type} {n.host}:{n.port}" for n in nodes))
                return conn
            await conn.close()
        except Exception as e:  # кластер ещё поднимается
            last = e
        if time.monotonic() > deadline:
            raise RuntimeError(f"кластер не готов за 90 с: {last!r}")
        await asyncio.sleep(1)


def show(row) -> str:
    if row is None:
        return "None (ключа нет)"
    return f"{row['order_id']} {row['customer']:<6} {row['status']:<9} {row['amount']:>7.2f}"


async def main(bootstrap: str) -> None:
    conn = await connect(bootstrap)
    admin = conn.get_admin()
    path = fluss.TablePath(DB, TABLE)

    # 1. Схема задаётся через Arrow, первичный ключ отдельным списком. Наличие ключа делает
    # таблицу Primary Key Table: под ней KV-хранилище на RocksDB плюс changelog.
    schema = fluss.Schema(
        pa.schema([
            ("order_id", "int64"),
            ("customer", "string"),
            ("status", "string"),
            ("amount", "float64"),
        ]),
        primary_keys=["order_id"],
    )
    await admin.create_database(DB, ignore_if_exists=True)
    await admin.drop_table(path, ignore_if_not_exists=True)
    await admin.create_table(path, fluss.TableDescriptor(schema, bucket_count=1))
    table = await conn.get_table(path)
    info = await admin.get_table_info(path)
    print(f"таблица {path.table_path_str()}: первичный ключ {info.get_primary_keys()}, "
          f"бакетов {info.num_buckets}, has_primary_key={table.has_primary_key()}")
    props = info.get_properties()
    for k in sorted(props):
        print(f"  {k} = {props[k]}")

    writer = table.new_upsert().create_writer()
    lookuper = table.new_lookup().create_lookuper()

    # 2. Три новых заказа: для ключей, которых ещё нет, upsert работает как вставка
    print("\n--- шаг 1: три вставки")
    for row in [
        {"order_id": 1, "customer": "anna", "status": "created", "amount": 120.0},
        {"order_id": 2, "customer": "boris", "status": "created", "amount": 75.5},
        {"order_id": 3, "customer": "vera", "status": "created", "amount": 310.0},
    ]:
        writer.upsert(row)
    await writer.flush()
    print("lookup 2:", show(await lookuper.lookup({"order_id": 2})))

    # 3. Тот же ключ ещё раз: строка заменяется целиком, отдельного UPDATE нет
    print("\n--- шаг 2: upsert по существующему ключу 2 (status -> paid)")
    await writer.upsert({"order_id": 2, "customer": "boris", "status": "paid", "amount": 75.5}).wait()
    print("lookup 2:", show(await lookuper.lookup({"order_id": 2})))

    # 4. Повтор той же самой строки: проверяем, пишет ли Fluss событие, если ничего не поменялось
    print("\n--- шаг 3: повторный upsert той же строки для ключа 2")
    await writer.upsert({"order_id": 2, "customer": "boris", "status": "paid", "amount": 75.5}).wait()

    # 5. Частичное обновление: передаём ключ и только те колонки, которые меняем
    print("\n--- шаг 4: partial update ключа 3, только amount")
    partial = table.new_upsert().partial_update_by_name(["order_id", "amount"]).create_writer()
    await partial.upsert({"order_id": 3, "amount": 290.0}).wait()
    print("lookup 3:", show(await lookuper.lookup({"order_id": 3})))

    # 6. Удаление по ключу
    print("\n--- шаг 5: delete ключа 1")
    await writer.delete({"order_id": 1}).wait()
    for k in (1, 2, 3):
        print(f"lookup {k}:", show(await lookuper.lookup({"order_id": k})))

    # 7. Задержка lookup. Клиент копит запросы в батч до 128 ключей и ждёт заполнения до 100 мс
    # (lookup_batch_timeout_ms в Rust-клиенте). Один Lookuper в pyfluss обслуживает запросы по
    # одному, поэтому последовательные lookup каждый раз упираются в этот таймаут.
    n = 50
    t0 = time.perf_counter()
    for i in range(n):
        await lookuper.lookup({"order_id": 2 + i % 2})
    print(f"\n{n} последовательных lookup через один Lookuper: {(time.perf_counter() - t0) / n * 1000:.1f} мс на запрос")
    # Много Lookuper параллельно наполняют общий батч, и он уходит на сервер без ожидания
    for k in (1, 32, 128):
        lks = [table.new_lookup().create_lookuper() for _ in range(k)]
        t0 = time.perf_counter()
        found = await asyncio.gather(*[lks[i % k].lookup({"order_id": 2 + i % 2}) for i in range(512)])
        print(f"512 lookup параллельно через {k:>3} Lookuper: {(time.perf_counter() - t0) * 1000:7.0f} мс всего, "
              f"найдено {sum(r is not None for r in found)}")

    # 8. Changelog: та же таблица читается как поток изменений с начального офсета.
    # Именно его потребляет Flink-джоба, подписанная на PK-таблицу.
    end = (await admin.list_offsets(path, [0], fluss.OffsetSpec.latest()))[0]
    print(f"\n--- changelog таблицы {TABLE}, бакет 0, офсеты 0..{end - 1}")
    scanner = await table.new_scan().create_log_scanner()
    scanner.subscribe(0, fluss.EARLIEST_OFFSET)
    seen = 0
    idle = 0
    while seen < end and idle < 10:
        records = await scanner.poll(1000)
        if records.is_empty():
            idle += 1
            continue
        for rec in records:
            r = rec.row
            print(f"offset {rec.offset:>2}  {rec.change_type.short_string()}  {show(r)}")
            seen += 1
    print(f"событий в changelog: {seen}")

    await conn.close()


if __name__ == "__main__":
    ap = argparse.ArgumentParser()
    ap.add_argument("--bootstrap", default="localhost:9123")
    asyncio.run(main(ap.parse_args().bootstrap))
Вывод скрипта приведён без изменений, кроме служебной шапки прогона.
# run_output.txt, pk_table_demo.py, Apache Fluss 1.0.0 и pyfluss 1.0.0, прогон 2026-11-14
кластер: CoordinatorServer 127.0.0.1:9123, TabletServer 127.0.0.1:40901
таблица shop.orders: первичный ключ ['order_id'], бакетов 1, has_primary_key=True
  table.kv.format-version = 2
  table.kv.value-layout-version = 1
  table.replication.factor = 1

--- шаг 1: три вставки
lookup 2: 2 boris  created     75.50

--- шаг 2: upsert по существующему ключу 2 (status -> paid)
lookup 2: 2 boris  paid        75.50

--- шаг 3: повторный upsert той же строки для ключа 2

--- шаг 4: partial update ключа 3, только amount
lookup 3: 3 vera   created    290.00

--- шаг 5: delete ключа 1
lookup 1: None (ключа нет)
lookup 2: 2 boris  paid        75.50
lookup 3: 3 vera   created    290.00

50 последовательных lookup через один Lookuper: 102.7 мс на запрос
512 lookup параллельно через   1 Lookuper:   52405 мс всего, найдено 512
512 lookup параллельно через  32 Lookuper:    1639 мс всего, найдено 512
512 lookup параллельно через 128 Lookuper:      72 мс всего, найдено 512

--- changelog таблицы orders, бакет 0, офсеты 0..9
offset  0  +I  1 anna   created    120.00
offset  1  +I  2 boris  created     75.50
offset  2  +I  3 vera   created    310.00
offset  3  -U  2 boris  created     75.50
offset  4  +U  2 boris  paid        75.50
offset  5  -U  2 boris  paid        75.50
offset  6  +U  2 boris  paid        75.50
offset  7  -U  3 vera   created    310.00
offset  8  +U  3 vera   created    290.00
offset  9  -D  1 anna   created    120.00
событий в changelog: 10
Вставки дали +I, обновление статуса заказа 2 дало пару -U и +U. Повторный upsert той же самой строки тоже записал пару -U и +U на офсетах 5 и 6, то есть сервер не подавляет обновления, которые ничего не меняют, и потребитель changelog должен быть к ним готов. Частичное обновление передало только order_id и amount, но в changelog попала полная строка с прежними customer и status.
Последовательный lookup через pyfluss занял 102.7 мс на запрос, и это не скорость сервера. Rust-клиент, на котором построен pyfluss, копит запросы в батч до 128 ключей и ждёт его заполнения до 100 мс, а Python-обёртка обслуживает запросы одного Lookuper по очереди. Как следствие, 512 параллельных запросов через один Lookuper шли 52405 мс, через 32 Lookuper 1639 мс, а через 128 всего 72 мс. Таймаут батча Python-конфиг 1.0.0 не принимает, Java-клиент не проверялся.
Лог-таблица, проекция и фильтр
Скрипт log_table_projection.py пишет 200 тысяч кликов за 10 дней в две одинаковые лог-таблицы на 12 колонок, и у второй включена колоночная статистика по event_day. Трафик скрипт меряет счётчиком интерфейса loopback, клиент и кластер стоят на одной машине.
# pyfluss 1.0.0, Apache Fluss 1.0.0 local cluster, прогнано на стенде 2026-11-14
"""Лог-таблица Apache Fluss в формате Arrow: чтение всех колонок против проекции двух колонок
и фильтр, который сервер применяет к батчам до отправки клиенту.

Сколько байт реально прошло по сети, скрипт меряет счётчиком интерфейса lo в /proc/net/dev:
клиент и кластер на одной машине, поэтому весь их трафик идёт через loopback.

Запуск: python log_table_projection.py [--bootstrap localhost:9123] [--days 10] [--rows-per-day 20000]
"""
import argparse
import asyncio
import random
import time

import fluss
import pyarrow as pa

DB = "shop"
TABLE = "clicks"


async def connect(bootstrap: str) -> fluss.FlussConnection:
    """Подключение к кластеру и ожидание, пока зарегистрируется TabletServer."""
    deadline = time.monotonic() + 90
    while True:
        try:
            conn = await fluss.FlussConnection.create(fluss.Config({"bootstrap.servers": bootstrap}))
            nodes = await conn.get_admin().get_server_nodes()
            if any("Tablet" in n.server_type for n in nodes):
                return conn
            await conn.close()
        except Exception as e:  # кластер ещё поднимается
            last = e
        if time.monotonic() > deadline:
            raise RuntimeError(f"кластер не готов за 90 с: {last!r}")
        await asyncio.sleep(1)


def lo_bytes() -> int:
    """Байты через loopback (rx), Linux. На другой ОС вернёт -1."""
    try:
        with open("/proc/net/dev") as f:
            for line in f:
                if line.strip().startswith("lo:"):
                    return int(line.split(":", 1)[1].split()[0])
    except OSError:
        pass
    return -1


def make_day(day: int, rows: int, first_id: int, rnd: random.Random) -> pa.Table:
    """Одна пачка кликов за день: 12 колонок, из них несколько широких строковых."""
    pages = [f"/catalog/item/{i}" for i in range(500)]
    agents = [f"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 Chrome/{120 + i}.0 Safari/537.36" for i in range(40)]
    ids = range(first_id, first_id + rows)
    return pa.table({
        "event_id": pa.array(ids, pa.int64()),
        "user_id": pa.array([rnd.randrange(50_000) for _ in ids], pa.int64()),
        "event_day": pa.array([day] * rows, pa.int32()),
        "event_type": pa.array([rnd.choice(["view", "click", "add_to_cart"]) for _ in ids]),
        "url": pa.array([rnd.choice(pages) for _ in ids]),
        "referrer": pa.array([f"https://search.example/?q={rnd.randrange(10_000)}" for _ in ids]),
        "user_agent": pa.array([rnd.choice(agents) for _ in ids]),
        "ip": pa.array([f"10.{rnd.randrange(256)}.{rnd.randrange(256)}.{rnd.randrange(256)}" for _ in ids]),
        "country": pa.array([rnd.choice(["RU", "KZ", "BY", "AM", "UZ"]) for _ in ids]),
        "session_id": pa.array([f"s{rnd.getrandbits(64):016x}" for _ in ids]),
        "price": pa.array([round(rnd.uniform(1, 500), 2) for _ in ids], pa.float64()),
        "payload": pa.array([f'{{"ab":"v{rnd.randrange(4)}","pos":{rnd.randrange(60)},"t":{rnd.random():.6f}}}' for _ in ids]),
    })


async def read_all(table: fluss.FlussTable, end: int, scan: fluss.TableScan) -> tuple[int, int, int, float, list[int]]:
    """Читает бакет 0 с начала до конца лога. Возвращает строки, батчи, байты по lo, секунды, дни."""
    scanner = await scan.create_record_batch_log_scanner()
    scanner.subscribe(0, fluss.EARLIEST_OFFSET)
    rows = batches = 0
    days: set[int] = set()
    lo0, t0 = lo_bytes(), time.perf_counter()
    t_last = t0  # время последнего непустого ответа: хвост пустых опросов в замер не входит
    last, idle = -1, 0
    while last + 1 < end and idle < 5:
        got = await scanner.poll_record_batch(1000)
        if not got:
            idle += 1
            continue
        idle = 0
        t_last = time.perf_counter()
        for b in got:
            rows += b.batch.num_rows
            batches += 1
            last = max(last, b.last_offset)
            if "event_day" in b.batch.schema.names:
                days.update(b.batch.column("event_day").unique().to_pylist())
    return rows, batches, lo_bytes() - lo0, t_last - t0, sorted(days)


async def main(bootstrap: str, n_days: int, per_day: int) -> None:
    conn = await connect(bootstrap)
    admin = conn.get_admin()

    # 1. Таблица без первичного ключа это Log Table: только добавление, формат лога Arrow.
    # Две одинаковые таблицы: clicks с настройками по умолчанию и clicks_stats, где включена
    # колоночная статистика по event_day (по умолчанию Fluss её не собирает).
    rnd = random.Random(42)
    days = [make_day(day, per_day, (day - 1) * per_day, rnd) for day in range(1, n_days + 1)]
    await admin.create_database(DB, ignore_if_exists=True)
    tables = {}
    for name, props in ((TABLE, {}), (TABLE + "_stats", {"table.statistics.columns": "event_day"})):
        path = fluss.TablePath(DB, name)
        await admin.drop_table(path, ignore_if_not_exists=True)
        await admin.create_table(path, fluss.TableDescriptor(fluss.Schema(days[0].schema), bucket_count=1, properties=props))
        table = await conn.get_table(path)
        info = await admin.get_table_info(path)
        print(f"таблица {path.table_path_str()}: колонок {info.get_column_count()}, "
              f"первичный ключ {info.get_primary_keys() or 'нет'}, бакетов {info.num_buckets}, свойства {info.get_properties()}")

        # 2. Запись: каждый день отдельной пачкой с flush, чтобы батчи лога не смешивали дни
        writer = table.new_append().create_writer()
        t0 = time.perf_counter()
        for day_table in days:
            writer.write_arrow(day_table)
            await writer.flush()
        end = (await admin.list_offsets(path, [0], fluss.OffsetSpec.latest()))[0]
        print(f"  записано {n_days * per_day} строк за {n_days} дней, {time.perf_counter() - t0:.1f} с, офсеты 0..{end - 1}")
        tables[name] = (table, end)

    table, end = tables[TABLE]
    # 3. Полное чтение: сервер отдаёт все 12 колонок
    rows, batches, net, sec, _ = await read_all(table, end, table.new_scan())
    print(f"\n--- все 12 колонок:      {rows} строк, {batches} батчей, по сети {net / 2**20:6.2f} МиБ, {sec:.2f} с")
    full_net = net

    # 4. Проекция: просим две колонки, сервер вырезает их из колоночного Arrow-лога сам
    rows, batches, net, sec, _ = await read_all(table, end, table.new_scan().project_by_name(["user_id", "event_day"]))
    print(f"--- проекция 2 колонок:  {rows} строк, {batches} батчей, по сети {net / 2**20:6.2f} МиБ, {sec:.2f} с"
          f"  ({net / full_net:.1%} от полного чтения)")

    # 5. Фильтр по дню: сервер отбрасывает батчи, в которых по статистике нужного дня быть не может.
    # Отбор консервативный: в пришедших батчах могут быть и чужие строки, поэтому в рабочем коде
    # предикат повторяют на клиенте. Здесь печатаем, какие дни реально пришли.
    day = n_days // 2
    for name, (t, e) in tables.items():
        scan = t.new_scan().project_by_name(["user_id", "event_day"]).filter(fluss.col("event_day") == day)
        rows, batches, net, sec, seen = await read_all(t, e, scan)
        print(f"--- фильтр event_day={day}, {name:<12}: {rows} строк, {batches} батчей, по сети {net / 2**20:5.2f} МиБ,"
              f" дни в ответе {seen}")

    await conn.close()


if __name__ == "__main__":
    ap = argparse.ArgumentParser()
    ap.add_argument("--bootstrap", default="localhost:9123")
    ap.add_argument("--days", type=int, default=10)
    ap.add_argument("--rows-per-day", type=int, default=20000)
    a = ap.parse_args()
    asyncio.run(main(a.bootstrap, a.days, a.rows_per_day))
# run_output.txt, log_table_projection.py, Apache Fluss 1.0.0 и pyfluss 1.0.0, прогон 2026-11-14
таблица shop.clicks: колонок 12, первичный ключ нет, бакетов 1, свойства {'table.replication.factor': '1'}
  записано 200000 строк за 10 дней, 0.3 с, офсеты 0..199999
таблица shop.clicks_stats: колонок 12, первичный ключ нет, бакетов 1, свойства {'table.statistics.columns': 'event_day', 'table.replication.factor': '1'}
  записано 200000 строк за 10 дней, 0.3 с, офсеты 0..199999

--- все 12 колонок:      200000 строк, 10 батчей, по сети  11.26 МиБ, 0.17 с
--- проекция 2 колонок:  200000 строк, 10 батчей, по сети   0.46 МиБ, 0.06 с  (4.1% от полного чтения)
--- фильтр event_day=5, clicks      : 200000 строк, 10 батчей, по сети  0.46 МиБ, дни в ответе [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
--- фильтр event_day=5, clicks_stats: 20000 строк, 1 батчей, по сети  0.05 МиБ, дни в ответе [5]
Проекция двух колонок из двенадцати сократила трафик с 11.26 до 0.46 МиБ, это 4.1% от полного чтения, а время чтения с 0.17 до 0.06 с. Фильтр по event_day на таблице без статистики не отсёк ничего, сервер отдал все 10 батчей со всеми днями. На таблице со статистикой пришёл 1 батч из 10. Отбор идёт по батчам, а не по строкам, и точным он вышел только потому, что каждый день записан отдельным батчем, поэтому в рабочем коде предикат повторяют на клиенте.
Заключение
Apache Fluss занимает место между Kafka и Lakehouse. Он хранит поток как таблицы, превращает upsert в готовый changelog для Flink и сам переносит историю в озеро. Прогон подтвердил механизм и показал цену версии 1.0, а именно батчевый lookup в Python-клиенте, фильтр без статистики по умолчанию и молчаливый отказ в записи при заполненном диске. Пробовать Fluss стоит там, где Flink-конвейер держит рядом промежуточные топики, внешний KV и выгрузку в озеро.