
 13
Содержание
- Что такое Apache Cloudberry
- Архитектура Apache Cloudberry
- Координатор и standby-координатор
- Сегменты и зеркала
- Interconnect (сеть между сегментами)
- Как выполняется запрос, распределение данных и Motion
- Ключ распределения DISTRIBUTED BY, RANDOMLY, REPLICATED
- Срезы плана и операторы Redistribute, Broadcast и Gather Motion
- Чем Apache Cloudberry отличается от Greenplum
- Перекос данных и выбор ключа распределения
- Когда применять Apache Cloudberry, а когда не стоит
- Практика на демо-кластере gpdemo
- Подъём кластера и его состав
- Распределение строк и перекос
- План запроса с Motion
- Форматы хранения heap, ao_column и PAX
- Заключение
- Референсные ссылки
Apache Cloudberry это открытая аналитическая СУБД с архитектурой MPP (Massively Parallel Processing, массивно-параллельная обработка), которая выросла из Greenplum и работает на более новом ядре PostgreSQL. Строки каждой таблицы раскладываются по сегментам кластера по ключу распределения, запрос режется на срезы (slice), которые сегменты выполняют одновременно, а строки между сегментами пересылают операторы Motion. Проект развивается в Apache Incubator, версия 2.2.0-incubating вышла 5 ноября 2026 года и собрана на ядре PostgreSQL 14.10.
Что такое Apache Cloudberry
Apache Cloudberry начинался в 2022 году как проект компании HashData, выведенный из Greenplum 7, и сразу получил ядро PostgreSQL 14.4 вместо 12.x. Greenplum это MPP-СУБД на базе PostgreSQL, чей репозиторий в мае 2024 года архивировали, а сам продукт закрыли. В 2024 году Cloudberry приняли в Apache Incubator, инкубатор Apache Software Foundation для новых проектов, лицензия у проекта Apache 2.0. Прежние имена проекта Cloudberry Database и CloudberryDB ещё встречаются в старых материалах. Первым релизом под эгидой ASF стала версия 2.0.0 в 2025 году.
Снаружи Cloudberry выглядит как PostgreSQL. Подключение идёт через psql или любой драйвер PostgreSQL, работают тот же SQL, те же типы и функции, а сверху лежат расширения синтаксиса Greenplum вроде DISTRIBUTED BY в CREATE TABLE. Документация называет проект хорошо обратно совместимым с Greenplum (highly backward-compatible). Отсюда главный сценарий его появления в компании, а именно миграция с Greenplum, который, по формулировке той же документации, в итоге закрылся как проприетарный продукт. Под капотом же у Cloudberry не один сервер, а кластер из десятков экземпляров Postgres, и скорость запросов определяется тем, как данные разложены между ними.
Архитектура Apache Cloudberry
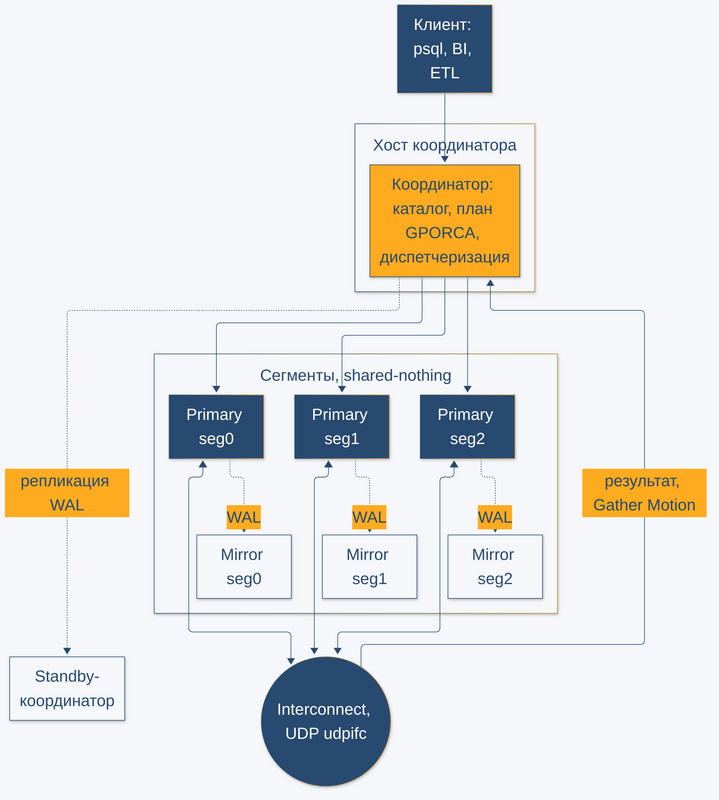
Архитектура Cloudberry унаследована от Greenplum, её устройство подробно разбирает статья блога как устроена MPP-СУБД Greenplum. Кластер построен по схеме shared-nothing (без разделяемых ресурсов). У каждого узла свои процессор, память и диск, и общий результат складывается из параллельной работы узлов над своими частями данных.
Координатор и standby-координатор
Координатор (coordinator, в ранних версиях Greenplum он назывался master) это точка входа в кластер, клиент подключается только к нему. Координатор хранит глобальный системный каталог, разбирает запрос, строит план и раздаёт его сегментам, но пользовательских данных не хранит. Standby-координатор держит копию координатора, которую поддерживает репликация WAL (Write-Ahead Log, журнал упреждающей записи), и при отказе основного узла становится на его место.
Сегменты и зеркала
Сегмент это отдельный процесс Postgres со своим каталогом данных, который хранит часть строк каждой распределённой таблицы. По документации на одном сегмент-хосте обычно работают от 2 до 8 сегментов. Primary-сегмент обслуживает запросы, а зеркало (mirror) получает его WAL и подменяет его при сбое. В рабочем кластере зеркало кладут на другой хост, чтобы падение одной машины не уносило обе копии. Раскладку зеркал, восстановление после сбоев и обслуживание кластера этого семейства разбирает курс Администрирование Arenadata DB / Greenplum.
Interconnect (сеть между сегментами)
Interconnect это сетевой слой, по которому сегменты пересылают друг другу строки во время выполнения запроса. По умолчанию он работает поверх UDP с собственным управлением потоком, режим называется UDPIFC (UDP with flow control), и по надёжности документация приравнивает его к TCP. Переключение interconnect на TCP ограничивает кластер тысячей сегментов. Сеть под него рекомендуют от 10 Гбит, потому что при тяжёлых JOIN через неё проходят миллионы строк.
Как выполняется запрос, распределение данных и Motion
Параллельность Cloudberry держится на решении, которое принимается при создании таблицы. Ключ распределения определяет, на каком сегменте окажется каждая строка, и тем самым решает, придётся ли сегментам гонять данные по сети во время запроса.
Ключ распределения DISTRIBUTED BY, RANDOMLY, REPLICATED
Политика распределения задаётся в CREATE TABLE одним из трёх способов:
- DISTRIBUTED BY (колонки). Cloudberry считает хеш от значения ключа и по нему выбирает сегмент, поэтому строки с одинаковым ключом всегда лежат на одном сегменте.
- DISTRIBUTED RANDOMLY. Строки раскладываются без ключа примерно поровну, но JOIN по любой колонке такой таблицы потребует пересылки.
- DISTRIBUTED REPLICATED. Полная копия таблицы хранится на каждом сегменте, это вариант для небольших справочников, которые соединяют с большими таблицами.
Таким образом, ключ выбирают сразу по двум критериям, по равномерности раскладки и по колонкам, по которым таблицу чаще всего соединяют.
Срезы плана и операторы Redistribute, Broadcast и Gather Motion
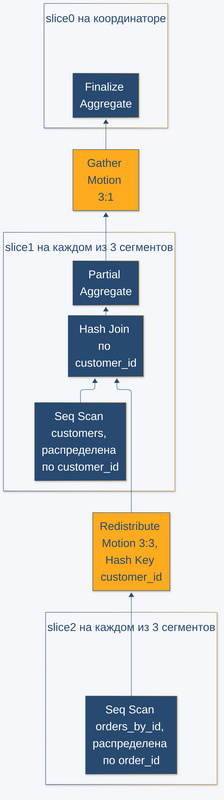
Координатор режет план запроса на срезы. Срез это часть плана, которую каждый сегмент выполняет у себя без обмена с соседями, а границы срезов проходят по операторам Motion, пересылающим строки по interconnect. Условие локального JOIN документация формулирует жёстко. Обе стороны соединения должны быть распределены по одним и тем же колонкам в том же порядке. Если условие не выполнено, планировщик вставляет Motion одного из видов:
- Redistribute Motion. Каждый сегмент считает хеш по колонке JOIN и отправляет строку тому сегменту, где лежат её пары. По сети едет одна из таблиц, но каждая её строка ровно один раз.
- Broadcast Motion. Каждый сегмент отправляет свои строки всем остальным, и таблица целиком оказывается на каждом сегменте. Это выгодно, когда рассылаемая таблица маленькая.
- Gather Motion. Сегменты отправляют результат на координатор. Этот оператор стоит в корне почти любого плана, а запись вида 3:1 в EXPLAIN значит «с трёх сегментов на один узел».
Выбор между Redistribute и Broadcast делает оптимизатор, по умолчанию GPORCA, унаследованный от Greenplum, а при optimizer = off классический планировщик Postgres. Результат запроса от вида Motion не зависит, меняется только объём строк в сети, и практика ниже показывает все три оператора на одном JOIN.
Greenplum для инженеров данных и аналитиков данных
Код курса
GPDE
Ближайшая дата курса
11 января, 2027
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Чем Apache Cloudberry отличается от Greenplum
Официальная страница What’s New in Apache Cloudberry перечисляет то, что появилось в Cloudberry поверх наследия Greenplum. Таблица собрана по ней, по странице истории проекта и по прогону версии 2.2.0.
| Область | Что есть в Apache Cloudberry | Что это даёт |
|---|---|---|
| Ядро PostgreSQL | Стабильная ветка 2.x на PostgreSQL 14 (в 2.2.0 это 14.10), ветка main уже переведена на PostgreSQL 16 | Против ядра 12.x у Greenplum 7 пришли multirange-типы, обращение к JSONB по индексу, сжатие TOAST через LZ4 и инкрементальная сортировка |
| Хранение | Гибридный формат PAX и Directory Table для неструктурированных файлов на локальном или объектном хранилище | PAX хранит строки группами, а внутри группы по колонкам, поддерживает MVCC (Multi-Version Concurrency Control, многоверсионное управление конкурентным доступом), сортировку z-order, bloom-фильтры и пропуск блоков по статистике |
| Ускорение запросов | Инкрементальные материализованные представления, автоматическая подстановка MV в запрос (AQUMV), Dynamic Tables, RuntimeFilter для JOIN, параллельное выполнение внутри сегмента, индексный доступ и уникальные индексы на AO-таблицах (append-optimized, оптимизированных под добавление строк) | По документации RuntimeFilter в подходящих сценариях ускоряет JOIN до двух раз |
| Безопасность | Прозрачное шифрование данных (TDE) с алгоритмами AES и SM4, политики доступа на уровне строк (Row-Level Security), профили паролей | Шифрование данных на диске и разграничение доступа без внешних надстроек |
| Развёртывание и утилиты | Одноузловой режим, полная поддержка ARM (AArch64), gpshrink для вывода сегментов из кластера, gpdemo для демо-кластера одной командой | Кластер можно не только расширять, но и сокращать, а стенд для экспериментов поднимается за секунды |
| Управление проектом | Проект Apache Software Foundation с открытым управлением по правилам ASF | Greenplum, по формулировке документации, остался проектом одного вендора и в итоге закрылся |
Для миграции важнее то, что осталось прежним. Синтаксис распределения, утилиты семейства gp, каталог gp_segment_configuration и схема gp_toolkit работают так же, как в Greenplum, и практика ниже это показывает. Из заметных мелочей с версии 2.1 файл окружения называется cloudberry-env.sh вместо greenplum_path.sh, и скрипты развёртывания придётся поправить.
Перекос данных и выбор ключа распределения
Перекос данных (data skew) возникает, когда ключ распределения раскладывает строки по сегментам неравномерно. Распределённый запрос заканчивается вместе с самым медленным сегментом, поэтому сегмент с тройной долей данных делает тройную работу, пока остальные простаивают. Документация называет главной причиной перекоса неправильный выбор ключа и требует проверять раскладку сразу после первой загрузки.
На прогоне это видно на миллионе заказов. С ключом order_id строки легли по сегментам как 333167, 332791 и 334042. С ключом status, у которого всего три значения, все 800000 заказов со статусом delivered ушли на сегмент 0, потому что одно значение ключа целиком попадает на один сегмент. Коэффициент перекоса из gp_toolkit.gp_skew_coefficients, то есть коэффициент вариации числа строк по сегментам в процентах, вырос с 0.19 до 121.24. Документация советует пересматривать политику распределения у таблиц, где перекос больше 10%.
Правила выбора ключа вытекают из механизма:
- Высокая кардинальность. Ключ с большим числом различных значений, например идентификатор сущности, раскладывает строки ровно, а статусы, флаги и даты с малым числом значений дают перекос.
- Колонка частых JOIN. Если большие таблицы соединяют по customer_id, их распределяют по нему же, и соединение обходится без Redistribute Motion.
- Мало NULL в ключе. Все строки с NULL в ключе ложатся на один сегмент так же, как строки с одинаковым значением.
- RANDOMLY как запасной вариант. Если хорошего ключа у таблицы нет, равномерность важнее экономии на пересылке.
Все четыре правила сводятся к одному требованию, ключ должен раскладывать строки ровно и по возможности совпадать с колонками соединений.
Кроме того, перекос бывает в обработке, когда данные лежат ровно, а промежуточный результат запроса собирается на одном сегменте. По документации такое почти всегда лечится переписыванием запроса, а не сменой ключа.
Когда применять Apache Cloudberry, а когда не стоит
Cloudberry рассчитан на аналитику, где запрос читает большие объёмы данных и агрегирует их. Типичные сценарии такие:
- Корпоративное хранилище данных. DWH на сотнях гигабайт и десятках терабайт с тяжёлыми JOIN и агрегатами, которые выигрывают от параллельного сканирования.
- Миграция с Greenplum. Совместимость синтаксиса и утилит позволяет сменить СУБД без переписывания модели данных и ETL.
- Аналитика для команды PostgreSQL. Привычные драйверы и SQL остаются, а работа уходит на кластер.
Общее у этих сценариев одно, запрос читает много строк и выигрывает от того, что сегменты сканируют свои части одновременно.
Однако есть сценарии, где MPP-архитектура мешает. OLTP с короткими транзакциями и точечными запросами не выигрывает от кластера, потому что каждый запрос проходит через координатор, а запись в несколько сегментов требует распределённой фиксации. Если данные помещаются на один сервер, обычный PostgreSQL проще в эксплуатации, ведь даже демо-кластер Cloudberry состоит из восьми экземпляров Postgres. Наконец, Cloudberry пока проект инкубатора, и у новых функций вроде PAX и Dynamic Tables меньше истории эксплуатации, чем у унаследованных из Greenplum.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика на демо-кластере gpdemo
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо прогнано на Apache Cloudberry 2.2.0-incubating из бинарного пакета под Ubuntu 24.04 со страницы релиза. Установка пакета, вход по ssh без пароля на свою же машину и остальная подготовка описаны в файле RUNBOOK.md рядом с кодом, и команды ниже повторяют его. На нашем стенде пакет не ставился в систему через apt, а был распакован из deb-файла в tmpfs, то есть в оперативную память, кластер gpdemo и демо-скрипты при этом те же. Официальная Docker-песочница из каталога devops/sandbox репозитория Apache Cloudberry годится как альтернатива для других ОС, но на нашем стенде она не прогонялась.
Подъём кластера и его состав
Утилита gpdemo создаёт кластер на одной машине одной командой. Это координатор на порту 7000, standby на 7001, три primary-сегмента на 7002-7004 и их зеркала на 7005-7007. На стенде с каталогами данных в tmpfs создание заняло 19 секунд, после чего демо-скрипты запускаются по очереди.
# Apache Cloudberry 2.2.0-incubating, пакет под Ubuntu 24.04, команды по RUNBOOK.md; на стенде 2026-11-15 те же gpdemo и psql из распакованного пакета
# Окружение пакета: пути к утилитам и GPHOME
source /usr/local/cloudberry-db/cloudberry-env.sh

# Демо-кластер в ~/cloudberry_demo: координатор, standby, 3 primary и 3 зеркала
mkdir -p ~/cloudberry_demo && cd ~/cloudberry_demo
gpdemo
# PGPORT=7000 и COORDINATOR_DATA_DIRECTORY для psql и утилит
source gpdemo-env.sh
gpstate -b

# Демо-скрипты статьи из репозитория articles_code
git clone https://github.com/BigDataSchoolRU/articles_code.git ~/articles_code
cd ~/articles_code/wiki/apache_cloudberry
psql -X -d postgres -e -v ON_ERROR_STOP=1 -f 01_cluster_info.sql
psql -X -d postgres -e -v ON_ERROR_STOP=1 -f 02_distribution_skew.sql
psql -X -d postgres -e -v ON_ERROR_STOP=1 -f 03_explain_motion.sql
psql -X -d postgres -e -v ON_ERROR_STOP=1 -f 04_storage_formats.sql
Первый скрипт показывает, из чего собран кластер.
-- Apache Cloudberry 2.2.0-incubating, демо-кластер gpdemo (координатор, standby, 3 primary, 3 mirror на одном хосте), прогнано на стенде 2026-11-15
-- Из чего собран кластер: версия ядра и список экземпляров Postgres.

-- Cloudberry сообщает и версию ядра PostgreSQL, и свою версию.
SELECT version();

-- Каждая строка gp_segment_configuration это отдельный экземпляр Postgres со своим портом и каталогом.
-- content = -1: координатор и standby-координатор; content 0..N-1: сегменты.
-- role p/m: primary или mirror сейчас; preferred_role: роль по замыслу; mode s: зеркало синхронизировано; status u: экземпляр работает.
SELECT content, role, preferred_role, mode, status, port
FROM gp_segment_configuration
ORDER BY content, role DESC;

-- Параллельность запроса определяют primary-сегменты: на каждом выполняется своя часть плана.
SELECT count(*) AS primary_segments
FROM gp_segment_configuration
WHERE content >= 0 AND role = 'p';

-- Оптимизатор по умолчанию (on = GPORCA) и транспорт interconnect между сегментами.
SHOW optimizer;
SHOW gp_interconnect_type;
Вывод на стенде.
 PostgreSQL 14.10 (Apache Cloudberry 2.2.0-incubating build 13d3c58eaa0) on x86_64-pc-linux-gnu, compiled by gcc (Ubuntu 13.3.0-6ubuntu2~24.04.1) 13.3.0, 64-bit compiled on Nov  3 2026 15:36:21

 content | role | preferred_role | mode | status | port
---------+------+----------------+------+--------+------
      -1 | p    | p              | n    | u      | 7000
      -1 | m    | m              | s    | u      | 7001
       0 | p    | p              | s    | u      | 7002
       0 | m    | m              | s    | u      | 7005
       1 | p    | p              | s    | u      | 7003
       1 | m    | m              | s    | u      | 7006
       2 | p    | p              | s    | u      | 7004
       2 | m    | m              | s    | u      | 7007
(8 rows)

 primary_segments
------------------
                3
(1 row)

 optimizer
-----------
 on
(1 row)

 gp_interconnect_type
----------------------
 udpifc
(1 row)
В gp_segment_configuration восемь строк, и каждая это отдельный экземпляр Postgres. Все они в статусе u (up), зеркала синхронизированы с primary, значения полей расшифрованы в комментариях скрипта. Оптимизатор по умолчанию GPORCA, interconnect работает в режиме udpifc.
Распределение строк и перекос
Второй скрипт создаёт три таблицы с одним и тем же миллионом заказов и разными ключами распределения, а также реплицированный справочник регионов.
-- Apache Cloudberry 2.2.0-incubating, демо-кластер gpdemo с 3 primary-сегментами, прогнано на стенде 2026-11-15
-- Как ключ распределения раскладывает строки по сегментам и откуда берётся перекос.

DROP TABLE IF EXISTS orders_by_id, orders_by_status, orders_random, regions;

-- Миллион заказов, ключ распределения order_id: хеш от уникального значения.
CREATE TABLE orders_by_id (
    order_id    bigint,
    customer_id int,
    status      text,
    amount      numeric(10,2)
) DISTRIBUTED BY (order_id);

-- 80% заказов delivered, 10% shipped, 10% cancelled.
INSERT INTO orders_by_id
SELECT g,
       (g % 100000) + 1,
       CASE WHEN g % 10 < 8 THEN 'delivered' WHEN g % 10 = 8 THEN 'shipped' ELSE 'cancelled' END,
       (g % 1000) / 10.0
FROM generate_series(1, 1000000) AS g;

-- Те же строки, но ключ распределения это низкокардинальный статус: три значения на весь миллион.
CREATE TABLE orders_by_status (LIKE orders_by_id) DISTRIBUTED BY (status);
INSERT INTO orders_by_status SELECT * FROM orders_by_id;

-- Без ключа: строки раскладываются случайно, примерно поровну, перекоса нет, но и JOIN по ключу не будет локальным.
CREATE TABLE orders_random (LIKE orders_by_id) DISTRIBUTED RANDOMLY;
INSERT INTO orders_random SELECT * FROM orders_by_id;

-- Политика распределения из каталога: p = по хешу ключа или случайно (distkey пустой), r = копия на каждом сегменте.
SELECT localoid::regclass AS table_name, policytype, distkey
FROM gp_distribution_policy
WHERE localoid IN ('orders_by_id'::regclass, 'orders_by_status'::regclass, 'orders_random'::regclass)
ORDER BY 1;

-- Сколько строк лежит на каждом сегменте: gp_segment_id это служебная колонка «на каком сегменте строка».
SELECT 'orders_by_id' AS table_name, gp_segment_id, count(*) AS row_count FROM orders_by_id GROUP BY gp_segment_id
UNION ALL
SELECT 'orders_by_status', gp_segment_id, count(*) FROM orders_by_status GROUP BY gp_segment_id
UNION ALL
SELECT 'orders_random', gp_segment_id, count(*) FROM orders_random GROUP BY gp_segment_id
ORDER BY 1, 2;

-- Где оказался каждый статус: одно значение ключа целиком уходит на один сегмент.
SELECT status, gp_segment_id, count(*) AS row_count
FROM orders_by_status
GROUP BY status, gp_segment_id
ORDER BY status;

-- Коэффициент перекоса из gp_toolkit: 0 означает ровное распределение, чем больше, тем хуже.
SELECT skcrelname AS table_name, round(skccoeff, 2) AS skew_coefficient
FROM gp_toolkit.gp_skew_coefficients
WHERE skcrelname IN ('orders_by_id', 'orders_by_status', 'orders_random')
ORDER BY 1;

-- Маленький справочник: DISTRIBUTED REPLICATED держит полную копию на каждом сегменте.
CREATE TABLE regions (
    region_id   int,
    region_name text
) DISTRIBUTED REPLICATED;
INSERT INTO regions VALUES (1, 'North'), (2, 'Center'), (3, 'South');

-- gp_dist_random() читает таблицу на каждом сегменте отдельно, gp_execution_segment() говорит, на каком.
-- Колонки gp_segment_id у реплицированной таблицы нет: строка не принадлежит одному сегменту.
SELECT gp_execution_segment() AS segment, count(*) AS row_count
FROM gp_dist_random('regions')
GROUP BY 1
ORDER BY 1;
Вывод на стенде.
    table_name    | policytype | distkey
------------------+------------+---------
 orders_by_id     | p          | 1
 orders_by_status | p          | 3
 orders_random    | p          |
(3 rows)

    table_name    | gp_segment_id | row_count
------------------+---------------+-----------
 orders_by_id     |             0 |    333167
 orders_by_id     |             1 |    332791
 orders_by_id     |             2 |    334042
 orders_by_status |             0 |    800000
 orders_by_status |             1 |    100000
 orders_by_status |             2 |    100000
 orders_random    |             0 |    333841
 orders_random    |             1 |    332479
 orders_random    |             2 |    333680
(9 rows)

  status   | gp_segment_id | row_count
-----------+---------------+-----------
 cancelled |             2 |    100000
 delivered |             0 |    800000
 shipped   |             1 |    100000
(3 rows)

    table_name    | skew_coefficient
------------------+------------------
 orders_by_id     |             0.19
 orders_by_status |           121.24
 orders_random    |             0.22
(3 rows)

 segment | row_count
---------+-----------
       0 |         3
       1 |         3
       2 |         3
(3 rows)
Разбор чисел дан в разделе про перекос выше. Справочник regions лежит на каждом сегменте целиком, по три строки. Строки orders_random при повторном прогоне ложатся немного иначе, раскладка у неё случайная.
План запроса с Motion
Третий скрипт добавляет клиентов, распределённых по customer_id, и копию заказов с тем же ключом, а затем сравнивает планы одного и того же JOIN.
-- Apache Cloudberry 2.2.0-incubating, демо-кластер gpdemo с 3 primary-сегментами, прогнано на стенде 2026-11-15
-- План распределённого запроса: когда JOIN локальный, а когда строки едут между сегментами через Motion.
-- Запускать после 02_distribution_skew.sql: нужны таблицы orders_by_id и regions.

DROP TABLE IF EXISTS customers, orders_by_customer;

-- Клиенты распределены по customer_id.
CREATE TABLE customers (
    customer_id int,
    region_id   int,
    name        text
) DISTRIBUTED BY (customer_id);
INSERT INTO customers
SELECT g, g % 3 + 1, 'customer_' || g
FROM generate_series(1, 100000) AS g;

-- Те же заказы, что в orders_by_id, но с ключом распределения customer_id, как у customers.
CREATE TABLE orders_by_customer (LIKE orders_by_id) DISTRIBUTED BY (customer_id);
INSERT INTO orders_by_customer SELECT * FROM orders_by_id;

ANALYZE customers;
ANALYZE orders_by_id;
ANALYZE orders_by_customer;
ANALYZE regions;

-- 1. JOIN по ключу распределения обеих таблиц: строки одного клиента уже лежат на одном сегменте.
--    Пересылка нужна только в конце, чтобы собрать частичные суммы на координаторе (Gather Motion).
EXPLAIN (COSTS OFF)
SELECT count(*), sum(o.amount)
FROM orders_by_customer o
JOIN customers c ON c.customer_id = o.customer_id;

-- 2. Заказы распределены по order_id, а JOIN идёт по customer_id: одну из сторон надо переслать.
EXPLAIN (COSTS OFF)
SELECT count(*), sum(o.amount)
FROM orders_by_id o
JOIN customers c ON c.customer_id = o.customer_id;

-- 3. Тот же запрос с классическим планировщиком Postgres вместо GPORCA.
SET optimizer = off;
EXPLAIN (COSTS OFF)
SELECT count(*), sum(o.amount)
FROM orders_by_id o
JOIN customers c ON c.customer_id = o.customer_id;
RESET optimizer;

-- 4. JOIN с реплицированным справочником: копия regions есть на каждом сегменте, пересылать нечего.
EXPLAIN (COSTS OFF)
SELECT r.region_name, count(*)
FROM customers c
JOIN regions r ON r.region_id = c.region_id
GROUP BY r.region_name;

-- 5. Точечный запрос по ключу распределения: координатор знает сегмент и шлёт запрос только ему (Gather Motion 1:1).
EXPLAIN (COSTS OFF)
SELECT * FROM orders_by_id WHERE order_id = 42;

-- 6. Реальное выполнение запроса 2: сколько строк прошло через каждый Motion.
EXPLAIN (ANALYZE, COSTS OFF, TIMING OFF)
SELECT count(*), sum(o.amount)
FROM orders_by_id o
JOIN customers c ON c.customer_id = o.customer_id;

-- Результат одинаков при любом ключе распределения: меняется только путь данных.
SELECT 'by customer_id' AS layout, count(*), sum(o.amount)
FROM orders_by_customer o JOIN customers c ON c.customer_id = o.customer_id
UNION ALL
SELECT 'by order_id', count(*), sum(o.amount)
FROM orders_by_id o JOIN customers c ON c.customer_id = o.customer_id;
JOIN по ключу распределения обеих таблиц выполняется на сегментах локально, пересылка нужна только для сбора частичных сумм.
 Finalize Aggregate
   ->  Gather Motion 3:1  (slice1; segments: 3)
         ->  Partial Aggregate
               ->  Hash Join
                     Hash Cond: (o.customer_id = c.customer_id)
                     ->  Seq Scan on orders_by_customer o
                     ->  Hash
                           ->  Seq Scan on customers c
 Optimizer: GPORCA
Заказы распределены по order_id, и GPORCA перераспределяет их по customer_id.
 Finalize Aggregate
   ->  Gather Motion 3:1  (slice1; segments: 3)
         ->  Partial Aggregate
               ->  Hash Join
                     Hash Cond: (o.customer_id = c.customer_id)
                     ->  Redistribute Motion 3:3  (slice2; segments: 3)
                           Hash Key: o.customer_id
                           ->  Seq Scan on orders_by_id o
                     ->  Hash
                           ->  Seq Scan on customers c
 Optimizer: GPORCA
Классический планировщик на том же запросе рассылает клиентов целиком на каждый сегмент.
 Finalize Aggregate
   ->  Gather Motion 3:1  (slice1; segments: 3)
         ->  Partial Aggregate
               ->  Hash Join
                     Hash Cond: (o.customer_id = c.customer_id)
                     ->  Seq Scan on orders_by_id o
                     ->  Hash
                           ->  Broadcast Motion 3:3  (slice2; segments: 3)
                                 ->  Seq Scan on customers c
 Optimizer: Postgres query optimizer
С реплицированным справочником сам JOIN обходится без пересылки. Redistribute Motion в этом плане относится уже к двухфазной агрегации, частичные группы по region_name собираются на сегменте-владельце группы.
 Gather Motion 3:1  (slice1; segments: 3)
   ->  Finalize HashAggregate
         Group Key: r.region_name
         ->  Redistribute Motion 3:3  (slice2; segments: 3)
               Hash Key: r.region_name
               ->  Streaming Partial HashAggregate
                     Group Key: r.region_name
                     ->  Hash Join
                           Hash Cond: (c.region_id = r.region_id)
                           ->  Seq Scan on customers c
                           ->  Hash
                                 ->  Seq Scan on regions r
 Optimizer: GPORCA
Точечный запрос по ключу распределения координатор отправляет только тому сегменту, где лежит строка, отсюда Gather Motion 1:1 и segments 1.
 Gather Motion 1:1  (slice1; segments: 1)
   ->  Seq Scan on orders_by_id
         Filter: (order_id = 42)
 Optimizer: GPORCA
EXPLAIN ANALYZE показывает цену пересылки.
 Finalize Aggregate (actual rows=1 loops=1)
   ->  Gather Motion 3:1  (slice1; segments: 3) (actual rows=3 loops=1)
         ->  Partial Aggregate (actual rows=1 loops=1)
               ->  Hash Join (actual rows=334620 loops=1)
                     Hash Cond: (o.customer_id = c.customer_id)
                     Extra Text: (seg0)   Hash chain length 1.0 avg, 3 max, using 32439 of 524288 buckets.
                     ->  Redistribute Motion 3:3  (slice2; segments: 3) (actual rows=334620 loops=1)
                           Hash Key: o.customer_id
                           ->  Seq Scan on orders_by_id o (actual rows=334042 loops=1)
                     ->  Hash (actual rows=33462 loops=1)
                           Buckets: 524288  Batches: 1  Memory Usage: 5273kB
                           ->  Seq Scan on customers c (actual rows=33462 loops=1)
 Planning Time: 6.199 ms
   (slice0)    Executor memory: 62K bytes.
   (slice1)    Executor memory: 5462K bytes avg x 3x(0) workers, 5462K bytes max (seg0).  Work_mem: 5273K bytes max.
   (slice2)    Executor memory: 111K bytes avg x 3x(0) workers, 111K bytes max (seg0).
 Memory used:  128000kB
 Optimizer: GPORCA
 Execution Time: 642.617 ms
Через Redistribute Motion на один сегмент пришло 334620 строк, а по трём сегментам это фактически весь миллион заказов, проехавший по сети. Время выполнения 642.617 мс снято на одном хосте с данными в оперативной памяти и годится только как порядок величины, а не как бенчмарк. Итог JOIN при обоих ключах одинаков.
     layout     |  count  |     sum
----------------+---------+-------------
 by customer_id | 1000000 | 49950000.00
 by order_id    | 1000000 | 49950000.00
(2 rows)
Форматы хранения heap, ao_column и PAX
Четвёртый скрипт кладёт тот же миллион заказов в строчную таблицу heap, колоночную append-optimized таблицу ao_column и таблицу формата PAX, обе последние со сжатием zstd.
-- Apache Cloudberry 2.2.0-incubating, демо-кластер gpdemo с 3 primary-сегментами, прогнано на стенде 2026-11-15
-- Три формата хранения одной таблицы: строчный heap, колоночный ao_column и гибридный PAX.
-- Запускать после 02_distribution_skew.sql: нужна таблица orders_by_id.

-- Какие методы доступа есть в сборке.
SELECT amname FROM pg_am WHERE amtype = 't' ORDER BY amname;

DROP TABLE IF EXISTS orders_heap, orders_aoco, orders_pax;

-- Строчный heap, как в обычном PostgreSQL.
CREATE TABLE orders_heap (LIKE orders_by_id) DISTRIBUTED BY (order_id);

-- Append-optimized колоночная таблица со сжатием zstd: каждая колонка лежит в своём файле.
CREATE TABLE orders_aoco (LIKE orders_by_id)
USING ao_column WITH (compresstype = zstd, compresslevel = 5)
DISTRIBUTED BY (order_id);

-- PAX: строки группами, внутри группы данные по колонкам, плюс статистика min/max для пропуска групп.
CREATE TABLE orders_pax (LIKE orders_by_id)
USING pax WITH (compresstype = zstd, compresslevel = 5)
DISTRIBUTED BY (order_id);

INSERT INTO orders_heap SELECT * FROM orders_by_id;
INSERT INTO orders_aoco SELECT * FROM orders_by_id;
INSERT INTO orders_pax  SELECT * FROM orders_by_id;

-- Размер на диске: на координаторе функция суммирует размер по всем сегментам.
SELECT c.relname AS table_name, a.amname AS access_method,
       pg_size_pretty(pg_total_relation_size(c.oid)) AS total_size
FROM pg_class c
JOIN pg_am a ON a.oid = c.relam
WHERE c.relname IN ('orders_heap', 'orders_aoco', 'orders_pax')
ORDER BY pg_total_relation_size(c.oid) DESC;
Вывод на стенде.
  amname
-----------
 ao_column
 ao_row
 heap
 pax
(4 rows)

 table_name  | access_method | total_size
-------------+---------------+------------
 orders_heap | heap          | 58 MB
 orders_aoco | ao_column     | 5849 kB
 orders_pax  | pax           | 5717 kB
(3 rows)
Колоночные форматы заняли 5849 kB и 5717 kB против 58 MB у heap. Данные синтетические и сильно повторяются, поэтому десятикратное сжатие на реальные таблицы переносить нельзя, сохраняется только направление разницы между строчным и колоночным хранением.
Заключение
Apache Cloudberry продолжает линию Greenplum как открытый проект Apache. Архитектура координатора, сегментов и interconnect осталась прежней, а поверх неё появились более новое ядро PostgreSQL, формат PAX, шифрование и инкрементальные материализованные представления. Прогон на 2.2.0 показал главное правило любой MPP-СУБД этого семейства. Ключ распределения решает и равномерность нагрузки, и то, поедут ли строки по сети при JOIN, поэтому его выбирают по кардинальности и по колонкам соединений, а раскладку проверяют сразу после первой загрузки.