
 3

Содержание
- Что такое WAL в PostgreSQL и какую задачу решает журнал предзаписи
- Архитектура WAL, записи, LSN и сегменты в pg_wal
- Записи журнала и LSN
- WAL-буферы, walwriter и сброс на диск при коммите
- Принцип работы, от изменения страницы до восстановления после сбоя
- Контрольная точка и точка REDO
- Полностраничные образы и full_page_writes
- Уровни wal_level и что строится из журнала
- Подводные камни WAL
- Когда настраивать WAL и когда оставить значения по умолчанию
- Практика, WAL изнутри на PostgreSQL 18
- Стенд и запуск
- LSN и объём журнала
- Полностраничный образ после контрольной точки
- Цена надёжного коммита
- Брошенный слот держит pg_wal
- Восстановление после сбоя
- Заключение
- Референсные ссылки
WAL (Write-Ahead Log, журнал предзаписи) это последовательный журнал, в который PostgreSQL записывает каждое изменение данных раньше, чем меняет сами страницы таблиц и индексов на диске. Транзакция считается зафиксированной, когда её запись в журнале сброшена на постоянный носитель, а страницы данных сервер допишет позже и в удобном для себя порядке. После сбоя PostgreSQL проигрывает журнал и возвращает базу в согласованное состояние, а из того же потока записей строятся потоковая репликация, восстановление на момент времени и CDC (Change Data Capture, захват изменений данных).
Что такое WAL в PostgreSQL и какую задачу решает журнал предзаписи
Таблица в PostgreSQL хранится страницами по 8 КБ, и одна транзакция может поменять десятки страниц в разных файлах. Сбрасывать их все на диск при каждом коммите дорого, а сбой посреди такого сброса оставит часть страниц новыми, часть старыми. Журнал предзаписи закрывает обе проблемы одним правилом, которое раздел документации PostgreSQL о Write-Ahead Logging называет центральной идеей механизма. Файлы данных разрешено менять только после того, как записи журнала с описанием этих изменений сброшены на постоянный носитель.
При коммите на диск уходит только журнал, а он пишется последовательно, поэтому его сброс намного дешевле записи разбросанных страниц. Всё, чего ещё нет на страницах данных, восстанавливается проигрыванием записей. В русской литературе встречается и перевод «журнал упреждающей записи», механизм тот же. Идея работает и за пределами PostgreSQL, например RocksDB и HBase пишут журнал раньше, чем изменение попадёт в структуру в памяти.
Архитектура WAL, записи, LSN и сегменты в pg_wal
Журнал устроен в три слоя, а именно записи, буферы в общей памяти и файлы-сегменты на диске.
Записи журнала и LSN
Запись журнала (WAL record) описывает одно низкоуровневое изменение, например новую версию строки на странице кучи или новый элемент индекса. Позицию в журнале задаёт LSN (Log Sequence Number), по документации это смещение в байтах, которое монотонно растёт с каждой записью. В SQL у LSN тип pg_lsn, выводится он двумя шестнадцатеричными половинами через косую черту, например 0/1BE3BF8, а разность двух LSN даёт объём журнала в байтах.
Физически журнал лежит в каталоге pg_wal внутри каталога данных и нарезан на сегменты, обычно по 16 МБ. Размер сегмента задаётся при создании кластера ключом initdb —wal-segsize. Сегменты получают возрастающие имена из 24 шестнадцатеричных цифр начиная с 000000010000000000000001, и первые восемь цифр это номер линии времени (timeline ID). Новая линия времени заводится после восстановления из архива, чтобы новый журнал не затёр записи старой линии. Функция pg_walfile_name() переводит LSN в имя сегмента.
WAL-буферы, walwriter и сброс на диск при коммите
Процесс сеанса (backend) меняет страницу в общем буферном кэше (shared buffers) и кладёт запись в WAL-буферы, область общей памяти размером wal_buffers, по умолчанию 1/32 от shared_buffers, но не больше сегмента. На COMMIT backend сбрасывает журнал до LSN своей записи и ждёт fsync, только потом клиент получает ответ. Фоновый walwriter раз в wal_writer_delay (200 мс по умолчанию) дописывает накопленное, а грязные страницы данных позже пишут checkpointer и фоновый процесс записи (background writer).
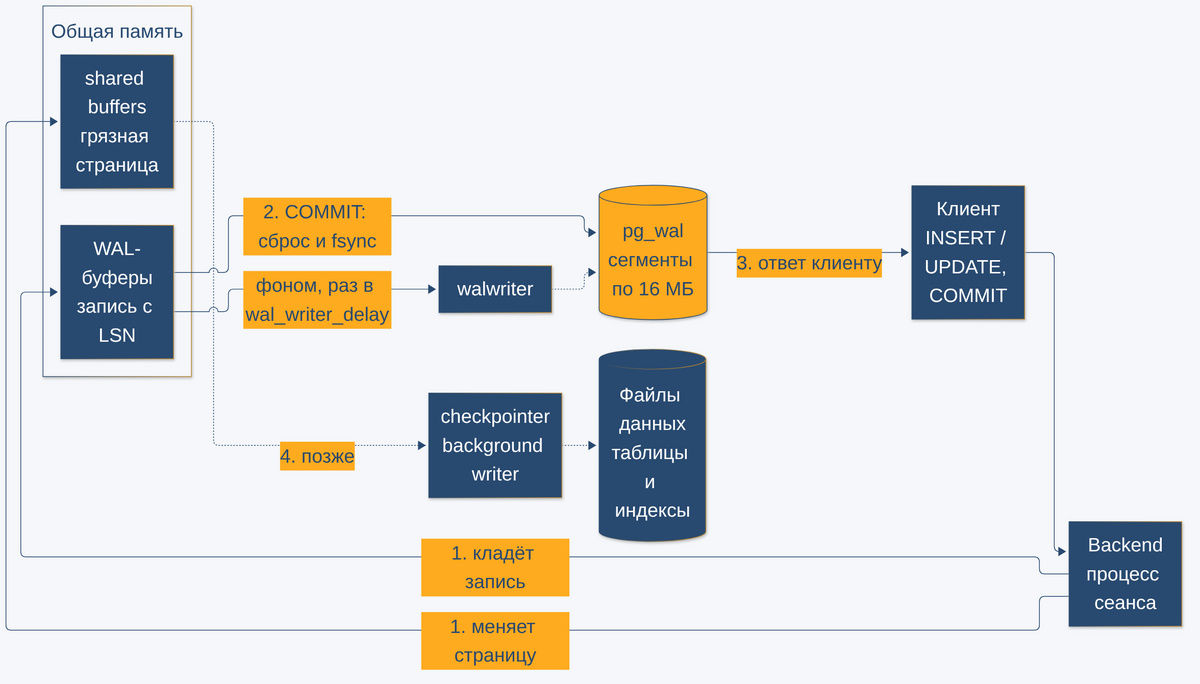
Надёжный коммит стоит одного fsync. Несколько транзакций, которые коммитятся одновременно, могут разделить один сброс (групповой коммит), а параметр commit_delay добавляет перед сбросом короткую задержку, чтобы при высокой нагрузке в него попало больше транзакций. Параметр synchronous_commit = off отпускает клиента до сброса ценой риска, о котором ниже.
Принцип работы, от изменения страницы до восстановления после сбоя
Журнал растёт непрерывно, поэтому PostgreSQL периодически выполняет контрольные точки, после которых старые сегменты для восстановления не нужны.
Контрольная точка и точка REDO
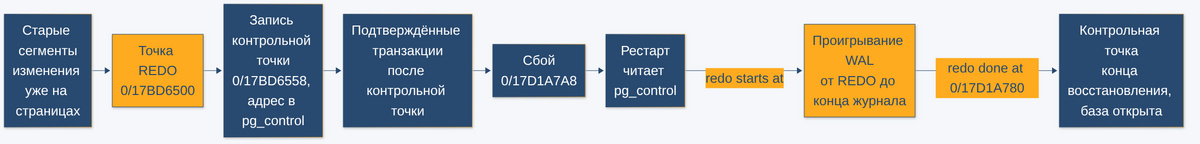
Контрольная точка (checkpoint) запоминает текущую позицию в журнале, точку REDO, сбрасывает на диск все грязные страницы и пишет запись контрольной точки, положение которой сохраняется в управляющем файле pg_control. После сбоя сервер читает pg_control, находит запись контрольной точки и проигрывает журнал от точки REDO до последней целой записи. Изменения до точки REDO уже лежат на страницах данных, поэтому более старые сегменты можно переиспользовать или удалить.
Контрольная точка запускается по времени, раз в checkpoint_timeout (5 минут по умолчанию), или по объёму, когда с прошлой точки накопилось около max_wal_size журнала (1 ГБ по умолчанию). Запись страниц растягивается на долю интервала checkpoint_completion_target (0.9). Редкие контрольные точки экономят запись, но удлиняют восстановление, этот компромисс разобран в разделе WAL Configuration документации PostgreSQL.
Полностраничные образы и full_page_writes
Страница PostgreSQL занимает 8 КБ, а операционная система и диск пишут блоками меньшего размера. Если питание пропадёт посреди записи, на диске окажется наполовину старая страница (torn page), и короткую запись журнала поверх неё не проиграть. Поэтому при включённом по умолчанию full_page_writes первое изменение каждой страницы после контрольной точки пишет в журнал её полный образ (full page image, FPI), а следующие изменения до новой контрольной точки пишут только саму запись.
Как следствие, чем чаще контрольные точки, тем больше образов в журнале. Параметр wal_compression со значениями pglz, lz4 и zstd сжимает именно полностраничные образы, обычные записи он не трогает.
Уровни wal_level и что строится из журнала
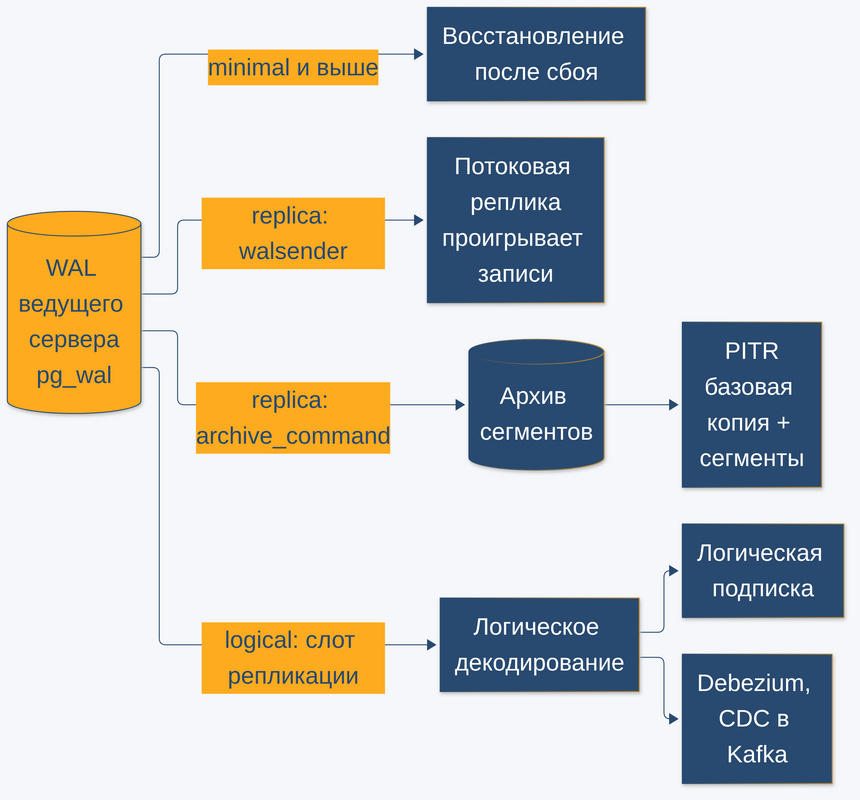
Параметр wal_level определяет, сколько информации попадает в журнал, а значит, кто сможет им пользоваться. Значений три, по умолчанию стоит replica.
| Уровень | Что пишется в журнал | Что доступно | Цена |
|---|---|---|---|
| minimal | только необходимое для восстановления после сбоя, часть массовых операций над таблицей, созданной в той же транзакции, журнал пропускает | восстановление после сбоя | наименьший объём, но нет архива и реплик, требует max_wal_senders = 0 |
| replica | всё, что нужно архиву и физической реплике | всё из minimal, потоковая реплика, архив сегментов, PITR | базовый уровень, значение по умолчанию |
| logical | плюс сведения для логического декодирования | всё из replica, логическая репликация, CDC через слоты | объём журнала растёт |
Потоковая реплика получает записи от процесса walsender и проигрывает их у себя, по сути это восстановление после сбоя, которое не заканчивается. Архив сегментов с базовой копией даёт восстановление на момент времени (PITR, Point-In-Time Recovery) по времени, номеру транзакции, LSN или именованной точке. На журнале держится и отказоустойчивость Greenplum, MPP-СУБД из множества экземпляров PostgreSQL, где зеркала сегментов получают изменения репликацией WAL. Устройство такого кластера разбирается на курсе по Greenplum для инженеров данных.
Логическое декодирование превращает физические записи обратно в построчные изменения таблиц, и через слот репликации их читает логическая подписка или коннектор Debezium, который публикует изменения в топики Apache Kafka. Как захват изменений строится поверх этого механизма, рассказывает статья блога о подходах к реализации CDC на примере Greenplum и PostgreSQL.
Подводные камни WAL
Проблемы с журналом в эксплуатации обычно сводятся к нескольким сценариям:
- Брошенный слот репликации. Слот удерживает сегменты от позиции restart_lsn, пока потребитель их не подтвердит, и выключенная реплика или упавший коннектор CDC раздувают pg_wal до заполнения диска. По умолчанию max_slot_wal_keep_size равен -1, то есть ограничения нет. Состояние показывает колонка wal_status в pg_replication_slots.
- max_wal_size это мягкий лимит. Журнал превышает его при пиковой нагрузке, падающей команде archive_command, большом wal_keep_size и отстающих слотах.
- synchronous_commit = off теряет подтверждённое. При сбое могут пропасть транзакции, подтверждённые за последние три интервала wal_writer_delay, то есть не более 600 мс по умолчанию. Согласованность при этом не страдает, по документации база окажется в таком состоянии, будто эти транзакции чисто откатились.
- wal_level = logical увеличивает объём. В журнал добавляются сведения для декодирования, а у таблиц с REPLICA IDENTITY FULL туда уходит ещё и полная старая версия строки при каждом UPDATE и DELETE.
- Всплеск записи после контрольной точки. Предупреждения checkpoints are occurring too frequently в логе говорят, что max_wal_size мал для нагрузки и журнал раздувают полностраничные образы.
Почти все эти сценарии видны заранее по размеру pg_wal и значению wal_status у слотов, поэтому оба числа стоит держать в мониторинге.
Когда настраивать WAL и когда оставить значения по умолчанию
Значения по умолчанию подходят большинству установок, где запись не упирается в диск. Настраивать журнал стоит в нескольких случаях:
- Тяжёлая запись. При частых контрольных точках поднимают max_wal_size, иногда и checkpoint_timeout.
- Крупные образы страниц. Сжатие wal_compression в режиме lz4 или zstd экономит журнал ценой процессора.
- Репликация и CDC. Перед подключением слотов задают max_slot_wal_keep_size, а в PostgreSQL 18 ещё и idle_replication_slot_timeout, который аннулирует слоты, простоявшие без подключения дольше заданного.
- Данные, которые не жалко потерять. Промежуточные таблицы ETL создают как UNLOGGED, они не пишут журнал и после сбоя очищаются, а synchronous_commit = off включают для отдельного сеанса, а не для всего сервера.
При этом fsync = off и full_page_writes = off выключают защиту от сбоя, и документация допускает их лишь там, где базу проще пересоздать из копии или файловая система сама исключает частичную запись страниц.
Практика, WAL изнутри на PostgreSQL 18
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Стенд это один контейнер PostgreSQL 18.6 в Docker Compose, прогон шёл 2026-11-05 на облачной машине с Ubuntu 24.04 и 4 vCPU. Утилиты pgbench и pg_waldump берутся из того же образа.
Стенд и запуск
Весь стенд описан одним файлом docker-compose.yml.
# postgres 18.6 в Docker, прогнано на стенде 2026-11-05: один сервер для демо WAL
services:
  pg:
    image: postgres:18.6
    container_name: wal-pg
    mem_limit: 1g
    environment:
      POSTGRES_USER: demo
      POSTGRES_PASSWORD: demo
      POSTGRES_DB: waldemo
    # маленький max_wal_size, чтобы контрольные точки по объёму журнала случались на демо-нагрузке;
    # checkpoint_timeout побольше, чтобы плановая контрольная точка не вмешалась в сценарий сбоя
    command: >
      postgres
      -c max_wal_size=64MB
      -c min_wal_size=32MB
      -c checkpoint_timeout=30min
      -c log_checkpoints=on
    ports:
      - "127.0.0.1:55434:5432"
    volumes:
      - pgdata:/var/lib/postgresql
      # SQL-сценарии и скрипт pgbench видны внутри контейнера в /demo
      - ./sql:/demo/sql:ro
      - ./insert.sql:/demo/insert.sql:ro
    healthcheck:
      # -h 127.0.0.1: на время initdb временный сервер слушает только сокет, по TCP готов уже рабочий
      test: ["CMD-SHELL", "pg_isready -h 127.0.0.1 -U demo -d waldemo"]
      interval: 2s
      timeout: 3s
      retries: 30

volumes:
  pgdata:
Скрипт wal_demo.sh запускает пять сценариев через psql внутри контейнера, сценарий коммита гоняет pgbench со скриптом insert.sql.
#!/usr/bin/env bash
# postgres 18.6 в Docker, pgbench и pg_waldump из того же образа, прогнано на стенде 2026-11-05
# Пять сценариев WAL по очереди: ./wal_demo.sh all  или  ./wal_demo.sh lsn|fpw|commit|slot|crash
set -uo pipefail
cd "$(dirname "$0")" || exit 1

PSQL="docker compose exec -T pg psql -U demo -d waldemo -v ON_ERROR_STOP=1 -X"
PGBENCH_SECONDS=${PGBENCH_SECONDS:-10}

lsn() {
  # 1. LSN, сегменты и объём журнала
  $PSQL -f /demo/sql/01_lsn_volume.sql
}

fpw() {
  # 2. полностраничные образы после контрольной точки
  $PSQL -f /demo/sql/02_full_page_writes.sql
}

commit() {
  # 3. цена надёжного коммита: synchronous_commit on против off на одном клиенте
  $PSQL -c "DROP TABLE IF EXISTS bench_commits" \
        -c "CREATE TABLE bench_commits (id bigint GENERATED ALWAYS AS IDENTITY, payload text)"
  for mode in on off; do
    echo "--- synchronous_commit = $mode, ${PGBENCH_SECONDS} с, 1 клиент"
    $PSQL -qc "SELECT pg_stat_reset_shared('io')" >/dev/null
    # PGOPTIONS задаёт параметр для сеансов pgbench, сервер не перезапускается
    docker compose exec -T -e PGOPTIONS="-c synchronous_commit=$mode" pg \
      pgbench -U demo -d waldemo -n -c 1 -T "$PGBENCH_SECONDS" -f /demo/insert.sql \
      | grep -E "transactions actually processed|latency average|tps ="
    $PSQL -f /demo/sql/03_commit_io.sql
  done
}

slot() {
  # 4. брошенный слот репликации и рост pg_wal
  $PSQL -f /demo/sql/04_slot_retention.sql
}

crash() {
  # 5. аварийная остановка без контрольной точки и восстановление по журналу
  $PSQL -f /demo/sql/05_before_crash.sql
  local since
  since=$(date -u '+%Y-%m-%dT%H:%M:%SZ')
  echo "--- docker kill -s KILL wal-pg: postmaster убит без shutdown checkpoint"
  docker kill -s KILL wal-pg >/dev/null
  docker compose up -d --wait 2>&1 | tail -n 1
  echo "--- лог сервера после рестарта"
  docker logs --since "$since" wal-pg 2>&1 \
    | grep -E "interrupted|not properly shut down|redo starts|redo done|checkpoint complete|ready to accept" \
    | sed -E 's/^[0-9-]+ [0-9:.]+ UTC \[[0-9]+\] //'
  $PSQL -f /demo/sql/05_after_crash.sql
}

case ${1:-all} in
  lsn|fpw|commit|slot|crash) "$1" ;;
  all)
    echo "=== 1. LSN и объём журнала ===";            lsn
    echo; echo "=== 2. Full-page writes ===";          fpw
    echo; echo "=== 3. Цена надёжного коммита ===";    commit
    echo; echo "=== 4. Слот держит WAL ===";           slot
    echo; echo "=== 5. Восстановление после сбоя ==="; crash ;;
  *) echo "использование: $0 all|lsn|fpw|commit|slot|crash" >&2; exit 2 ;;
esac
-- скрипт pgbench, postgres 18.6, прогнано на стенде 2026-11-05: одна короткая транзакция на коммит
INSERT INTO bench_commits (payload) VALUES (md5(random()::text));
Прогон занимает около минуты.
# PostgreSQL 18.6, Docker Compose 2.40.3, проверено на стенде 2026-11-05
docker compose up -d --wait
./wal_demo.sh all
LSN и объём журнала
Первый сценарий запоминает LSN до и после вставки 100 тыс. строк в обычную таблицу с первичным ключом и повторяет ту же вставку в UNLOGGED-таблицу.
-- postgres 18.6, прогнано на стенде 2026-11-05: LSN, сегменты и объём журнала от вставки 100 тыс. строк
\pset footer off
SHOW wal_level;
SHOW wal_segment_size;

DROP TABLE IF EXISTS orders_logged, orders_unlogged;
CREATE TABLE orders_logged (id int PRIMARY KEY, amount numeric, note text);
CREATE UNLOGGED TABLE orders_unlogged (id int PRIMARY KEY, amount numeric, note text);

-- обнуляем счётчики журнала и запоминаем позицию в нём до вставки
SELECT pg_stat_reset_shared('wal') \g /dev/null
SELECT pg_current_wal_lsn() AS lsn_before,
       pg_walfile_name(pg_current_wal_lsn()) AS segment_before \gset
\echo lsn_before = :lsn_before, сегмент :segment_before

INSERT INTO orders_logged
SELECT g, round((random() * 1000)::numeric, 2), 'order ' || g
FROM generate_series(1, 100000) g;

SELECT pg_current_wal_lsn() AS lsn_after,
       pg_walfile_name(pg_current_wal_lsn()) AS segment_after \gset
\echo lsn_after  = :lsn_after, сегмент :segment_after

-- сколько байт журнала дала вставка: разность двух LSN
SELECT pg_size_pretty(pg_wal_lsn_diff(:'lsn_after', :'lsn_before')) AS wal_written,
       pg_size_pretty(pg_total_relation_size('orders_logged')) AS table_with_index;

-- та же вставка в UNLOGGED-таблицу: данные в журнал не пишутся
SELECT pg_current_wal_lsn() AS lsn_u0 \gset
INSERT INTO orders_unlogged
SELECT g, round((random() * 1000)::numeric, 2), 'order ' || g
FROM generate_series(1, 100000) g;
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), :'lsn_u0')) AS wal_written_unlogged;

-- накопительная статистика журнала; счётчики backend сбрасываются в общую память не сразу
SELECT pg_stat_force_next_flush() \g /dev/null
SELECT wal_records, wal_fpi, pg_size_pretty(wal_bytes) AS wal_bytes, wal_buffers_full
FROM pg_stat_wal;
# вывод прогона на стенде 2026-11-05, PostgreSQL 18.6, фрагмент run_output.txt
lsn_before = 0/1BE3BF8, сегмент 000000010000000000000001
INSERT 0 100000
lsn_after = 0/29DC8F8, сегмент 000000010000000000000002
 wal_written | table_with_index
-------------+------------------
 14 MB       | 7336 kB

INSERT 0 100000
 wal_written_unlogged
----------------------
 0 bytes

 wal_records | wal_fpi | wal_bytes | wal_buffers_full
-------------+---------+-----------+------------------
      200544 |      45 | 14 MB     |              753
Журнал вышел почти вдвое тяжелее данных, 14 MB против 7336 kB у таблицы с индексом, потому что каждая строка дала две записи, в кучу и в индекс, отсюда 200544 записи в pg_stat_wal. Счётчик wal_buffers_full показал 753 случая, когда WAL-буферы заполнились и backend сам сбрасывал журнал. Вставка в UNLOGGED-таблицу не сдвинула LSN ни на байт.
Полностраничный образ после контрольной точки
Второй сценарий дважды меняет одну строку после CHECKPOINT и меряет журнал через EXPLAIN с опцией WAL.
-- postgres 18.6, прогнано на стенде 2026-11-05: полностраничный образ после контрольной точки
\pset footer off
SHOW full_page_writes;
-- с PostgreSQL 18 initdb включает контрольные суммы по умолчанию, и hint-биты тоже попадают в журнал
SHOW data_checksums;

DROP TABLE IF EXISTS accounts;
-- fillfactor 50 оставляет место на странице, и UPDATE остаётся на ней же (HOT)
CREATE TABLE accounts (id int PRIMARY KEY, balance numeric) WITH (fillfactor = 50);
INSERT INTO accounts SELECT g, 1000 FROM generate_series(1, 1000) g;
-- VACUUM проставляет hint-биты заранее, чтобы в замер попал только сам UPDATE
VACUUM accounts;

-- первое изменение страницы после CHECKPOINT пишет в журнал её полный образ (8 КБ)
CHECKPOINT;
SELECT pg_current_wal_lsn() AS fpw_start \gset
EXPLAIN (ANALYZE, WAL, COSTS OFF, TIMING OFF, SUMMARY OFF)
UPDATE accounts SET balance = balance + 1 WHERE id = 1;

-- повторное изменение той же страницы до следующей контрольной точки: только сама запись
EXPLAIN (ANALYZE, WAL, COSTS OFF, TIMING OFF, SUMMARY OFF)
UPDATE accounts SET balance = balance + 1 WHERE id = 1;
SELECT pg_current_wal_lsn() AS fpw_end \gset

-- те же два UPDATE глазами pg_waldump: у первой записи блок помечен FPW
\setenv FPW_START :fpw_start
\setenv FPW_END :fpw_end
\! pg_waldump -p "$PGDATA/pg_wal" -s "$FPW_START" -e "$FPW_END" -r Heap

-- то же самое со сжатием образов lz4: VACUUM возвращает страницу в исходное состояние,
-- и первый UPDATE после CHECKPOINT снова пишет два образа, но сжатых
SET wal_compression = lz4;
VACUUM accounts;
CHECKPOINT;
EXPLAIN (ANALYZE, WAL, COSTS OFF, TIMING OFF, SUMMARY OFF)
UPDATE accounts SET balance = balance + 1 WHERE id = 1;
RESET wal_compression;
# вывод прогона на стенде 2026-11-05, PostgreSQL 18.6, фрагмент run_output.txt
 Update on accounts (actual rows=0.00 loops=1)
   Buffers: shared hit=6 dirtied=2
   WAL: records=1 fpi=2 bytes=12386

 Update on accounts (actual rows=0.00 loops=1)
   Buffers: shared hit=5
   WAL: records=2 bytes=128
   ->  Index Scan using accounts_pkey on accounts (actual rows=1.00 loops=1)
         WAL: records=1 bytes=58

rmgr: Heap        len (rec/tot):     78/ 12386, tx:        760, lsn: 0/02A0CF28, prev 0/02A0CEB0, desc: HOT_UPDATE old_xmax: 760, old_off: 1, old_infobits: [], flags: 0x21, new_xmax: 0, new_off: 93, blkref #0: rel 1663/16384/16401 blk 0 FPW, blkref #3: rel 1663/16384/16401 fork vm blk 0 FPW
rmgr: Heap        len (rec/tot):     70/    70, tx:        761, lsn: 0/02A10028, prev 0/02A0FFD0, desc: HOT_UPDATE old_xmax: 761, old_off: 93, old_infobits: [], flags: 0x20, new_xmax: 0, new_off: 94, blkref #0: rel 1663/16384/16401 blk 0

SET
VACUUM
CHECKPOINT
 Update on accounts (actual rows=0.00 loops=1)
   WAL: records=1 fpi=2 bytes=1446
Первый UPDATE записал 12386 байт, хотя сама запись HOT_UPDATE занимает 78 байт. HOT (heap-only tuple) означает, что новая версия строки легла на ту же страницу и индекс не менялся. Образов два, потому что кроме страницы кучи в журнал попала страница карты видимости (fork vm). VACUUM пометил страницу как all-visible, а UPDATE эту пометку снимает. Повтор стоил 128 байт, из них 70 на запись HOT_UPDATE без образа и 58 на запись узла Index Scan, а pg_waldump показывает разницу пометкой FPW у блоков первой записи. Со сжатием lz4 первый UPDATE записал 1446 байт, в 8.6 раза меньше.
VACUUM перед замером стоит намеренно. В PostgreSQL 18 initdb по умолчанию включает контрольные суммы (data_checksums = on), и тогда установка hint-битов (флагов в версии строки, которые запоминают, зафиксирована или откачена её транзакция) при первом чтении страницы тоже порождает полностраничный образ, который смешался бы с замером.
Цена надёжного коммита
Третий сценарий 10 секунд гоняет однострочные INSERT на одном клиенте при synchronous_commit = on и off и читает запись и fsync журнала из pg_stat_io, куда эти счётчики переехали в PostgreSQL 18 из pg_stat_wal.
-- postgres 18.6, прогнано на стенде 2026-11-05: запись и fsync журнала по типам процессов (pg_stat_io, с PostgreSQL 18)
\pset footer off
SELECT pg_stat_force_next_flush() \g /dev/null
SELECT backend_type, context, writes, fsyncs
FROM pg_stat_io
WHERE object = 'wal' AND (writes > 0 OR fsyncs > 0)
ORDER BY backend_type, context;
# вывод прогона на стенде 2026-11-05, PostgreSQL 18.6, pgbench 18.6, фрагмент run_output.txt
--- synchronous_commit = on, 10 с, 1 клиент
number of transactions actually processed: 1497
latency average = 6.678 ms
tps = 149.739516 (without initial connection time)
  backend_type  | context | writes | fsyncs
----------------+---------+--------+--------
 client backend | normal  |   1497 |   1497

--- synchronous_commit = off, 10 с, 1 клиент
number of transactions actually processed: 41578
latency average = 0.240 ms
tps = 4163.800036 (without initial connection time)
 backend_type | context | writes | fsyncs
--------------+---------+--------+--------
 walwriter    | normal  |     55 |     52
При synchronous_commit = on каждая из 1497 транзакций стоила backend одной записи и одного fsync журнала, и средняя задержка составила 6.678 ms. При off прошло 41578 транзакций, почти в 28 раз больше, потому что сеанс перестал ждать диск, а журнал сбрасывал walwriter, всего 52 fsync. Задержка около 6.7 мс принадлежит сетевому диску облачной машины, на локальном NVMe разрыв меньше, так что цифры описывают этот стенд.
Брошенный слот держит pg_wal
Четвёртый сценарий дважды генерирует одинаковый объём журнала, без слота и с брошенным физическим слотом, а затем ставит потолок max_slot_wal_keep_size.
-- postgres 18.6, прогнано на стенде 2026-11-05: брошенный слот репликации держит сегменты pg_wal
\pset footer off
SHOW max_wal_size;
SHOW max_slot_wal_keep_size;

CREATE TEMP VIEW wal_dir AS
SELECT count(*) AS segments, pg_size_pretty(sum(size)) AS pg_wal_size FROM pg_ls_waldir();

DROP TABLE IF EXISTS wal_filler;
CREATE TABLE wal_filler (id int, pad text);

\echo '--- 1. без слота: нагрузка на журнал, контрольная точка, сегменты переиспользуются'
SELECT pg_current_wal_lsn() AS gen_start \gset
INSERT INTO wal_filler SELECT g, repeat('x', 500) FROM generate_series(1, 300000) g;
TRUNCATE wal_filler;
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), :'gen_start')) AS wal_generated;
CHECKPOINT;
SELECT * FROM wal_dir;

\echo '--- 2. физический слот, к которому никто не подключился'
SELECT slot_name, lsn FROM pg_create_physical_replication_slot('lagging_replica', true);
SELECT pg_current_wal_lsn() AS gen_start \gset
INSERT INTO wal_filler SELECT g, repeat('x', 500) FROM generate_series(1, 300000) g;
TRUNCATE wal_filler;
SELECT pg_size_pretty(pg_wal_lsn_diff(pg_current_wal_lsn(), :'gen_start')) AS wal_generated;
CHECKPOINT;
SELECT * FROM wal_dir;
SELECT slot_name, active, restart_lsn, wal_status, safe_wal_size
FROM pg_replication_slots;

\echo '--- 3. потолок для слотов: max_slot_wal_keep_size = 32MB'
ALTER SYSTEM SET max_slot_wal_keep_size = '32MB';
SELECT pg_reload_conf();
SELECT pg_sleep(1) \g /dev/null
CHECKPOINT;
SELECT * FROM wal_dir;
SELECT slot_name, active, restart_lsn, wal_status, invalidation_reason
FROM pg_replication_slots;

-- уборка: слот и настройка возвращаются в исходное
SELECT pg_drop_replication_slot('lagging_replica');
ALTER SYSTEM RESET max_slot_wal_keep_size;
SELECT pg_reload_conf();
DROP TABLE wal_filler;
# вывод прогона на стенде 2026-11-05, PostgreSQL 18.6, фрагмент run_output.txt
--- 1. без слота: нагрузка на журнал, контрольная точка, сегменты переиспользуются
 wal_generated
---------------
 163 MB
 segments | pg_wal_size
----------+-------------
        4 | 64 MB

--- 2. физический слот, к которому никто не подключился
 wal_generated
---------------
 163 MB
 segments | pg_wal_size
----------+-------------
       11 | 176 MB
    slot_name    | active | restart_lsn | wal_status | safe_wal_size
-----------------+--------+-------------+------------+---------------
 lagging_replica | f      | 0/D8965A8   | extended   |

--- 3. потолок для слотов: max_slot_wal_keep_size = 32MB
 segments | pg_wal_size
----------+-------------
        4 | 64 MB
    slot_name    | active | restart_lsn | wal_status | invalidation_reason
-----------------+--------+-------------+------------+---------------------
 lagging_replica | f      |             | lost       | wal_removed
Без слота нагрузка породила 163 MB журнала, и после CHECKPOINT в pg_wal осталось 4 сегмента на 64 MB, остальные сервер переработал. С брошенным слотом lagging_replica тот же объём оставил 11 сегментов на 176 MB при max_wal_size 64MB. Статус extended означает, что лимит превышен, но слот удерживает файлы, а safe_wal_size пуст, потому что при max_slot_wal_keep_size = -1 запас не считается. С потолком 32MB контрольная точка удалила лишние сегменты, а слот перешёл в lost с причиной wal_removed, и реплику за ним придётся пересоздавать из базовой копии.
Восстановление после сбоя
Пятый сценарий ставит контрольную точку, подтверждает пять транзакций по 2000 строк и вставку в UNLOGGED-таблицу, затем убивает сервер сигналом KILL.
-- postgres 18.6, прогнано на стенде 2026-11-05: подтверждённые транзакции перед аварийной остановкой
\pset footer off
DROP TABLE IF EXISTS payments, payments_unlogged;
CREATE TABLE payments (id int PRIMARY KEY, amount numeric);
CREATE UNLOGGED TABLE payments_unlogged (id int PRIMARY KEY, amount numeric);

-- контрольная точка, от её точки REDO сервер начнёт проигрывать журнал после сбоя
CHECKPOINT;
SELECT checkpoint_lsn, redo_lsn FROM pg_control_checkpoint();

-- пять отдельных транзакций, каждая подтверждена COMMIT; контрольных точек после них нет
INSERT INTO payments SELECT g, 10 FROM generate_series(1, 2000) g;
INSERT INTO payments SELECT g, 10 FROM generate_series(2001, 4000) g;
INSERT INTO payments SELECT g, 10 FROM generate_series(4001, 6000) g;
INSERT INTO payments SELECT g, 10 FROM generate_series(6001, 8000) g;
INSERT INTO payments SELECT g, 10 FROM generate_series(8001, 10000) g;
INSERT INTO payments_unlogged SELECT g, 10 FROM generate_series(1, 10000) g;

SELECT (SELECT count(*) FROM payments) AS payments,
       (SELECT count(*) FROM payments_unlogged) AS payments_unlogged,
       pg_current_wal_lsn() AS lsn_at_crash;
-- postgres 18.6, прогнано на стенде 2026-11-05: что пережило сбой после проигрывания журнала
\pset footer off
SELECT (SELECT count(*) FROM payments) AS payments,
       (SELECT count(*) FROM payments_unlogged) AS payments_unlogged,
       (SELECT sum(amount) FROM payments) AS payments_sum;
SELECT checkpoint_lsn, redo_lsn FROM pg_control_checkpoint();
# вывод прогона на стенде 2026-11-05, PostgreSQL 18.6, фрагмент run_output.txt
 checkpoint_lsn |  redo_lsn
----------------+------------
 0/17BD6558     | 0/17BD6500

 payments | payments_unlogged | lsn_at_crash
----------+-------------------+--------------
    10000 |             10000 | 0/17D1A7A8

--- docker kill -s KILL wal-pg: postmaster убит без shutdown checkpoint
--- лог сервера после рестарта
LOG:  database system was interrupted; last known up at 2026-11-05 13:47:23 UTC
LOG:  database system was not properly shut down; automatic recovery in progress
LOG:  redo starts at 0/17BD6500
LOG:  redo done at 0/17D1A780 system usage: CPU: user: 0.02 s, system: 0.00 s, elapsed: 0.02 s
LOG:  checkpoint complete: wrote 90 buffers (0.5%), wrote 3 SLRU buffers; 0 WAL file(s) added, 0 removed, 0 recycled; write=0.024 s, sync=0.025 s, total=0.114 s; sync files=9, longest=0.012 s, average=0.003 s; distance=1296 kB, estimate=1296 kB; lsn=0/17D1A7A8, redo lsn=0/17D1A7A8
LOG:  database system is ready to accept connections
 payments | payments_unlogged | payments_sum
----------+-------------------+--------------
    10000 |                 0 |       100000
Сервер начал проигрывание ровно с точки REDO, redo starts at 0/17BD6500 совпадает с redo_lsn до сбоя, закончил на 0/17D1A780 за 0.02 с и записал контрольную точку конца восстановления. Все 10000 строк payments на месте с суммой 100000, а UNLOGGED-таблица пуста, её изменений в журнале не было. При собственном прогоне перед этими строками в логе окажутся ещё две строки checkpoint complete от контрольных точек до сбоя, их захватывает фильтр лога по времени.
Заключение
WAL это правило «сначала журнал, потом данные», и на нём держится почти вся надёжность PostgreSQL. Коммит ждёт только последовательный сброс журнала, контрольная точка ограничивает объём проигрывания после сбоя, а полностраничные образы защищают от разорванных страниц. Из того же журнала строятся реплики, PITR и CDC, и платят за это объёмом и дисциплиной со слотами. На стенде проигрывание журнала после аварийной остановки заняло 0.02 с и вернуло все подтверждённые строки, а брошенный слот без потолка удерживал почти втрое больше журнала, чем разрешал max_wal_size.