
 4

Содержание
- Что такое Reverse ETL и какую задачу решает
- Архитектура Reverse ETL, источник, модель, назначение и синхронизация
- Модель как SQL-запрос с первичным ключом
- Назначение и маппинг полей
- Принцип работы, diff результатов запроса между прогонами
- Снимок прошлого прогона и вычисление изменений
- Режимы синхронизации insert, update, upsert, mirror
- Батчи и лимиты API приёмника
- Reverse ETL против ETL, ELT и CDC
- Подводные камни синхронизаций
- Инструменты, SaaS и своя реализация
- Сценарии использования и когда Reverse ETL не нужен
- Практика, синхронизация витрины PostgreSQL с имитацией CRM
- Хранилище и витрина
- Имитация CRM
- Движок синхронизации
- Запуск сценария
- Результат прогона
- Заключение
- Референсные ссылки
Reverse ETL (обратный ETL) это регулярная выгрузка готовых данных из корпоративного хранилища в операционные системы компании, а именно в CRM, рекламные кабинеты, сервисы рассылок и службы поддержки. Классические конвейеры везут данные из источников в хранилище, а reverse ETL идёт в обратную сторону и отдаёт наружу то, что аналитики там уже посчитали, например риск оттока или пожизненную ценность клиента. Технически это синхронизация результата SQL-запроса с API приёмника, в которой на каждом прогоне уходят только изменившиеся строки.
Что такое Reverse ETL и какую задачу решает
В хранилище данных (data warehouse, DWH) стекаются заказы, события продукта, платежи и обращения в поддержку, а SQL-модели сводят их в витрины с готовыми признаками клиента. Однако менеджер по продажам работает в CRM (Customer Relationship Management), маркетолог в рекламном кабинете, и до хранилища эти люди не доходят. Посчитанная оценка клиента остаётся в дашборде, который они не открывают.
Reverse ETL закрывает этот разрыв. Витрина становится источником, поле объекта в CRM приёмником, и синхронизация по расписанию держит их согласованными. В пресс-релизах вендоров рядом с reverse ETL стоит выражение data activation (активация данных), то есть использование данных хранилища в повседневных процессах. Место reverse ETL в ряду подходов разобрано в статье блога об эволюции архитектуры данных от ETL до EtLT.
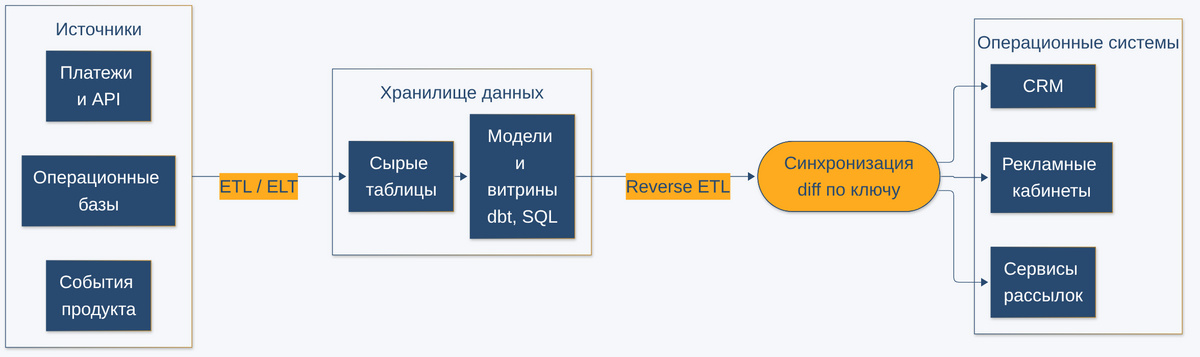
Архитектура Reverse ETL, источник, модель, назначение и синхронизация
В документации Hightouch, SaaS-платформы для reverse ETL, конвейер разложен на четыре сущности. Источник это хранилище или лейкхаус (lakehouse, хранилище поверх озера данных), к которому сервис подключается с правами на чтение. Модель описывает, какие строки отправлять. Назначение (destination) это внешний сервис со своим API, а синхронизация (sync) связывает модель с назначением и задаёт маппинг полей, режим и расписание. Демо в конце статьи повторяет эту разбивку, только без расписания, запуски там ручные.
Модель как SQL-запрос с первичным ключом
Модель это обычный SELECT к хранилищу с первичным ключом, то есть колонкой с уникальным значением в каждой строке. По ключу синхронизация узнаёт строку на следующем прогоне и находит её запись в приёмнике, поэтому ключ обязан быть стабильным. Идентификатор клиента годится, номер строки после сортировки нет. Чаще всего модель выбирает колонки из витрины, которую уже собрал аналитический конвейер на dbt (data build tool, SQL-трансформации внутри хранилища), и этот инструмент разбирается на курсе по dbt для инженеров данных.
Назначение и маппинг полей
У приёмника своя схема. Колонка plan витрины в CRM может называться plan_tier, а ltv превращается в lifetime_value. Маппинг полей (field mapping) задаёт это соответствие явно, и Hightouch при сравнении прогонов учитывает только замапленные колонки. Как следствие, правка колонки, которая в CRM не уходит, лишнего запроса к API не вызывает. Вторая забота маппинга это типы. JSON не знает numeric(10,2), и в демо значение 9999.00 приезжает в CRM числом 9999.0.
Принцип работы, diff результатов запроса между прогонами
Наивная синхронизация отправляла бы всю модель на каждом запуске, и на витрине в миллион клиентов лимиты API кончились бы раньше прогона. Поэтому reverse ETL отправляет только разницу. Hightouch называет свой механизм CDC (Change Data Capture, захват изменений данных), хотя смысл у него иной, чем у классического захвата изменений из журнала базы. Сравниваются не журналы базы и не записи в приёмнике, а результаты запроса модели в текущем и прошлом прогоне, как описано в документации Hightouch о Change Data Capture.
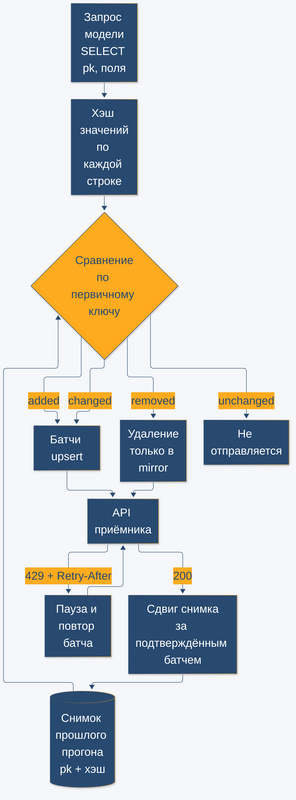
Снимок прошлого прогона и вычисление изменений
После прогона синхронизация сохраняет снимок результата модели, в Hightouch он называется diff file. На следующем прогоне каждая строка сопоставляется со снимком по первичному ключу и попадает в одну из четырёх групп:
- added. Ключа в снимке не было, строка новая.
- changed. Ключ в снимке есть, но значения замапленных полей отличаются.
- removed. Ключ есть в снимке, а в новом результате пропал.
- unchanged. Всё совпало, строка никуда не отправляется.
Какие из первых трёх групп уходят в приёмник, решает режим, после отправки снимок перезаписывается, а отклонённые приёмником строки Hightouch добавляет к следующему прогону. Хранится только последнее состояние. В базовом движке Hightouch снимки живут 30 дней в бакете сервиса, движок Lightning держит их в хранилище клиента. Демо ниже тоже хранит состояние в хранилище, причём не сами строки, а пары из ключа и хэша значений.
Режимы синхронизации insert, update, upsert, mirror
Режим решает, какие группы diff превращаются в запросы к приёмнику. В описании режимов Hightouch для табличных объектов перечислены такие варианты:
- Insert. Только строки с новым ключом, существующие записи не трогаются.
- Update. Только обновление записей, которые в приёмнике уже есть.
- Upsert. Обновление существующих записей и создание новых, обычный выбор для CRM.
- All, он же Mirror. Приёмник каждый раз перезаписывается полным результатом модели, без diff.
Первые три режима работают на diff, и нагрузка на API у них растёт с числом изменений, а не с размером модели. Удаление выпавших из модели записей Hightouch настраивает отдельно от режима. В демо mirror собран именно так, как upsert плюс удаление группы removed, иначе пропала бы экономия от diff. Синхронизации событий (event syncs) работают только на вставку, и отправленное событие уже не обновить.
Батчи и лимиты API приёмника
Изменения уходят пакетами (batch), потому что запрос на каждую запись упирается в лимит частоты, а запрос на весь diff в лимит размера тела. Превышение частоты HTTP API отмечает кодом 429 Too Many Requests (RFC 6585) и может добавить заголовок Retry-After, где по RFC 9110 стоит число секунд или дата, до которой ждать. Правильная реакция это пауза и повтор того же батча, а не падение синхронизации. Снимок стоит сдвигать только за батчем, который приёмник подтвердил, тогда после сбоя следующий прогон переотправит лишь недошедшее.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Reverse ETL против ETL, ELT и CDC
Все четыре подхода перемещают данные между системами, но различаются направлением и тем, что считается изменением. ETL (Extract, Transform, Load) трансформирует данные до загрузки в хранилище, ELT (Extract, Load, Transform) после неё силами самого хранилища. CDC в классическом понимании читает журнал транзакций базы и превращает каждую правку в событие.
| Критерий | ETL | ELT | CDC по журналу | Reverse ETL |
|---|---|---|---|---|
| Направление | Из источников в хранилище | Из источников в хранилище | Из базы-источника в брокер, реплику или хранилище | Из хранилища в операционные системы |
| Источник | Операционные базы, файлы, API | Операционные базы, файлы, API | Журнал транзакций базы, в PostgreSQL это WAL (write-ahead log), в MySQL binlog | Модель, то есть SQL-запрос к витрине |
| Приёмник | Хранилище, данные уже очищены | Хранилище, данные сырые, трансформация там же | Брокер сообщений, реплика, хранилище | CRM, рекламные кабинеты, сервисы рассылок |
| Единица изменения | Пакет выгрузки, полной или инкрементальной | Пакет выгрузки, полной или инкрементальной | Событие INSERT, UPDATE или DELETE из журнала | Строка результата модели с новым хэшем значений |
| Кто инициирует | Расписание конвейера | Расписание конвейера | Запись в журнал базы, поток почти непрерывный | Расписание синхронизации или оркестратор |
Главное отличие reverse ETL от CDC по журналу видно на единице изменения. В PostgreSQL UPDATE по умолчанию физически переписывает строку, даже если значения не поменялись, и такая операция попадает в WAL, а diff результатов запроса её не замечает. Обратная сторона в том, что reverse ETL не видит промежуточных состояний. Если поле изменилось дважды за час, а синхронизация идёт раз в час, приёмник получит только последнее значение.
Подводные камни синхронизаций
Сломанная синхронизация редко падает с ошибкой. Чаще хранилище и приёмник тихо расходятся, а замечают это пользователи CRM. Типовых причин четыре:
- Удаления в режиме upsert. Строка, выпавшая из модели, уходит из снимка, а в приёмнике остаётся навсегда, и синхронизация о ней больше не знает.
- Смена первичного ключа. Новая колонка ключа ломает сопоставление со снимком. Hightouch требует в этом случае сбросить состояние (reset CDC) для всех синхронизаций модели, и следующий прогон снимает свежий снимок, ничего не отправляя.
- Лимиты API. Сильнее всего в них упирается первая синхронизация, которая отправляет всю модель. В демо 25 записей при лимите 2 запроса в секунду шли 2.3 с, и почти всё это время ушло на ожидание Retry-After.
- События только на вставку. Ошибочно отправленное событие повторная синхронизация не исправит.
Поэтому синхронизацию мониторят по счётчикам added, changed, removed и по числу отказов приёмника, а не только по факту завершения задачи.
Инструменты, SaaS и своя реализация
Рынок reverse ETL сложился вокруг SaaS-сервисов с каталогом готовых приёмников. Hightouch описывает механизм открыто, и разделы выше опираются на его документацию. 1 мая 2025 года Fivetran, вендор управляемых коннекторов для загрузки данных в хранилище, объявил о соглашении купить Census, второй заметный сервис этого класса, и подал сделку как шаг к платформе перемещения данных полного цикла (end-to-end data movement platform).
Свою реализацию пишут, когда приёмников один-два, либо когда данные нельзя выпускать в сторонний SaaS. Каркас для этого даёт dlt (data load tool), открытая Python-библиотека компании dltHub. Декоратор @dlt.destination превращает обычную функцию в назначение, которое получает данные пакетами заданного размера. Упавший вызов dlt повторяет до пяти раз, а следующий запуск конвейера продолжает с пакета, на котором случился сбой. Атомарность пакета документация оставляет на авторе функции. Батчи и повторы dlt берёт на себя, а демо ниже нужно показать их явно, поэтому оно обходится без dlt.
Сценарии использования и когда Reverse ETL не нужен
Reverse ETL оправдан там, где посчитанное в хранилище должно попасть к людям в их рабочие инструменты:
- Продажи и поддержка. Риск оттока, тариф и пожизненная ценность клиента ложатся в карточку контакта в CRM.
- Маркетинг. Сегменты аудитории из хранилища уходят в рекламные кабинеты и сервисы рассылок.
- Продукт и финансы. Лимиты тарифа и статус оплаты возвращаются в операционные сервисы по расписанию.
Однако инструмент лишний, когда записей мало и меняются они раз в квартал, тогда хватает ручной выгрузки. Синхронизация по расписанию не подходит и для реакции за секунды, её интервалы измеряются минутами и часами, а события в реальном времени обычно возят через брокер сообщений. Если же данные рождаются в одной операционной системе и нужны в другой, прямая интеграция проще, чем круг через хранилище.
Apache Airflow для инженеров данных
Код курса
AIRF
Ближайшая дата курса
18 января, 2027
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Практика, синхронизация витрины PostgreSQL с имитацией CRM
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Хранилище в демо играет PostgreSQL 18.6 в Docker, приёмник играет имитация API на стандартной библиотеке Python, а движок синхронизации написан на Python с psycopg 3.3.8, драйвером PostgreSQL. Прогон шёл на Ubuntu 24.04 с Python 3.12.3 в три запуска, а именно полная отправка, отправка разницы и пустой прогон. Запуски здесь ручные, в проде ту же команду по расписанию ставит оркестратор, например Apache Airflow, и он же повторяет упавшую синхронизацию.
Хранилище и витрина
Файл docker-compose.yml поднимает PostgreSQL на порту 55433. Healthcheck идёт по TCP с ключом -h 127.0.0.1, потому что во время initdb временный сервер слушает только сокет, и docker compose up —wait иначе вернётся раньше времени.
# postgres 18.6 в Docker, прогнано на стенде 2026-11-05: хранилище с витриной для статьи про Reverse ETL
services:
  dwh:
    image: postgres:18.6
    container_name: reverse-etl-dwh
    mem_limit: 1g
    environment:
      POSTGRES_USER: demo
      POSTGRES_PASSWORD: demo
      POSTGRES_DB: dwh
    ports:
      - "127.0.0.1:55433:5432"
    volumes:
      # init.sql выполняется один раз, при первом старте с пустым томом
      - ./init.sql:/docker-entrypoint-initdb.d/init.sql:ro
    healthcheck:
      # -h 127.0.0.1: на время initdb временный сервер слушает только сокет, по TCP готов уже рабочий
      test: ["CMD-SHELL", "pg_isready -h 127.0.0.1 -U demo -d dwh"]
      interval: 2s
      timeout: 3s
      retries: 30
Файл init.sql создаёт витрину analytics.customer_scores на 25 клиентов и таблицу состояния reverse_etl.sync_snapshot с ключом и хэшем строки.
-- postgres 18.6, прогнано на стенде 2026-11-05: витрина и таблица состояния синхронизаций

-- Витрина, которую собрал аналитик (в жизни это модель dbt): по строке на клиента
CREATE SCHEMA analytics;
CREATE TABLE analytics.customer_scores (
    customer_id integer PRIMARY KEY,
    email       text          NOT NULL,
    plan        text          NOT NULL,
    ltv         numeric(10,2) NOT NULL,
    churn_risk  text          NOT NULL
);

-- 25 детерминированных клиентов, чтобы прогон повторялся строка в строку
INSERT INTO analytics.customer_scores
SELECT i,
       'client' || i || '@example.com',
       (ARRAY['free', 'pro', 'team'])[i % 3 + 1],
       (i * 137 % 5000) + 0.50,
       CASE WHEN i % 5 = 0 THEN 'high' WHEN i % 2 = 0 THEN 'medium' ELSE 'low' END
FROM generate_series(1, 25) AS i;

-- Состояние движка Reverse ETL: снимок прошлого успешного прогона.
-- По каждой синхронизации хранится первичный ключ и хэш строки, а не сами данные.
CREATE SCHEMA reverse_etl;
CREATE TABLE reverse_etl.sync_snapshot (
    sync_name text        NOT NULL,
    pk        text        NOT NULL,
    row_hash  text        NOT NULL,
    synced_at timestamptz NOT NULL DEFAULT now(),
    PRIMARY KEY (sync_name, pk)
);
Имитация CRM
Файл mock_crm.py принимает upsert и удаление записей по внешнему ключу external_id. Сверх лимита в 2 запроса в секунду он отвечает 429 с заголовком Retry-After, а батч больше 10 записей получает 413.
# Python 3.12.3, только стандартная библиотека, прогнано на стенде 2026-11-05
"""Имитация API CRM: upsert и удаление контактов по внешнему ключу, лимит запросов с 429.

Эндпоинты:
  POST /objects/<объект>/upsert  {"records": [{"external_id": "...", ...}]}
  POST /objects/<объект>/delete  {"external_ids": ["...", ...]}
  GET  /objects/<объект>         записи и счётчики объекта
  GET  /health
"""
import json
import math
import os
import threading
import time
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

HOST = os.environ.get("CRM_HOST", "127.0.0.1")
PORT = int(os.environ.get("CRM_PORT", "18080"))
RATE_LIMIT = int(os.environ.get("CRM_RATE_LIMIT", "2"))   # запросов на запись в окно
WINDOW_S = float(os.environ.get("CRM_WINDOW_S", "1.0"))   # длина окна, секунды
MAX_BATCH = int(os.environ.get("CRM_MAX_BATCH", "10"))    # записей в одном запросе

lock = threading.Lock()
objects = {}  # объект -> {"records": {external_id: поля}, "stats": {...}}
window = {"start": time.monotonic(), "count": 0}


def get_object(name):
    return objects.setdefault(name, {
        "records": {},
        "stats": {"write_requests": 0, "throttled": 0, "upserted": 0, "deleted": 0},
    })


def take_slot():
    """Фиксированное окно: RATE_LIMIT запросов на WINDOW_S секунд. Возвращает 0 или Retry-After."""
    now = time.monotonic()
    if now - window["start"] >= WINDOW_S:
        window["start"], window["count"] = now, 0
    if window["count"] < RATE_LIMIT:
        window["count"] += 1
        return 0
    return max(1, math.ceil(WINDOW_S - (now - window["start"])))


class Handler(BaseHTTPRequestHandler):
    def reply(self, code, body, headers=None):
        data = json.dumps(body, ensure_ascii=False).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(data)))
        for key, value in (headers or {}).items():
            self.send_header(key, value)
        self.end_headers()
        self.wfile.write(data)

    def do_GET(self):
        parts = self.path.strip("/").split("/")
        if parts == ["health"]:
            return self.reply(200, {"status": "ok"})
        if len(parts) == 2 and parts[0] == "objects":
            with lock:
                obj = get_object(parts[1])
                return self.reply(200, {"count": len(obj["records"]),
                                        "stats": obj["stats"], "records": obj["records"]})
        self.reply(404, {"error": "not found"})

    def do_POST(self):
        parts = self.path.strip("/").split("/")
        if len(parts) != 3 or parts[0] != "objects" or parts[2] not in ("upsert", "delete"):
            return self.reply(404, {"error": "not found"})
        length = int(self.headers.get("Content-Length", 0))
        body = json.loads(self.rfile.read(length) or b"{}")
        with lock:
            obj = get_object(parts[1])
            # лимит проверяется до применения записей: отказ 429 ничего не меняет в данных
            retry_after = take_slot()
            if retry_after:
                obj["stats"]["throttled"] += 1
                return self.reply(429, {"error": "rate limit exceeded"},
                                  {"Retry-After": str(retry_after)})
            obj["stats"]["write_requests"] += 1
            if parts[2] == "upsert":
                records = body.get("records", [])
                if len(records) > MAX_BATCH:
                    return self.reply(413, {"error": f"batch > {MAX_BATCH} records"})
                for rec in records:
                    if not rec.get("external_id") or not rec.get("email"):
                        return self.reply(400, {"error": "external_id and email required"})
                for rec in records:
                    # upsert по внешнему ключу: есть запись — обновить, нет — создать
                    obj["records"][rec["external_id"]] = {k: v for k, v in rec.items()
                                                          if k != "external_id"}
                obj["stats"]["upserted"] += len(records)
                return self.reply(200, {"upserted": len(records)})
            ids = body.get("external_ids", [])
            removed = sum(1 for i in ids if obj["records"].pop(i, None) is not None)
            obj["stats"]["deleted"] += removed
            return self.reply(200, {"deleted": removed, "not_found": len(ids) - removed})

    def log_message(self, fmt, *args):
        pass  # без access-лога, вывод прогона читается по строкам sync.py


if __name__ == "__main__":
    print(f"mock CRM на http://{HOST}:{PORT}, лимит {RATE_LIMIT} запросов/{WINDOW_S} с, "
          f"батч до {MAX_BATCH} записей", flush=True)
    ThreadingHTTPServer((HOST, PORT), Handler).serve_forever()
Движок синхронизации
Файл sync.py задаёт модель строкой SQL с колонкой pk и считает хэш строки функцией md5 по JSON из всех полей, кроме ключа. Diff со снимком даёт один запрос с FULL OUTER JOIN. Группы added и changed уходят батчами по 5 записей с повтором по 429, снимок сдвигается за каждым подтверждённым батчем, а removed в режиме mirror превращается в запрос на удаление.
# psycopg 3.3.8, PostgreSQL 18.6, Python 3.12.3, прогнано на стенде 2026-11-05
"""Минимальный движок Reverse ETL: модель -> diff со снимком прошлого прогона -> батчи в API CRM.

Запуск: python sync.py --sync contacts_mirror --mode mirror
"""
import argparse
import json
import os
import time
import urllib.error
import urllib.request

import psycopg

DSN = os.environ.get("DWH_DSN", "postgresql://demo:demo@127.0.0.1:55433/dwh")
CRM_URL = os.environ.get("CRM_URL", "http://127.0.0.1:18080")

# Модель: обычный SQL-запрос к хранилищу. Обязателен уникальный ключ pk,
# по нему строки сопоставляются между прогонами и с записями в CRM.
MODEL_SQL = """
SELECT customer_id::text AS pk, email, plan, ltv, churn_risk
FROM analytics.customer_scores
"""

# Маппинг полей: колонка модели -> поле объекта в CRM
FIELD_MAP = {"email": "email", "plan": "plan_tier", "ltv": "lifetime_value",
             "churn_risk": "churn_risk"}

# Diff результатов запроса со снимком: FULL OUTER JOIN по первичному ключу.
# Хэш считается по значениям полей, поэтому UPDATE без смены значений изменением не считается.
DIFF_SQL = f"""
WITH model AS (
    SELECT m.pk, md5((to_jsonb(m) - 'pk')::text) AS row_hash, to_jsonb(m) - 'pk' AS payload
    FROM ({MODEL_SQL}) AS m
),
snap AS (
    SELECT pk, row_hash FROM reverse_etl.sync_snapshot WHERE sync_name = %(sync)s
)
SELECT CASE
           WHEN snap.pk IS NULL THEN 'added'
           WHEN model.pk IS NULL THEN 'removed'
           WHEN model.row_hash <> snap.row_hash THEN 'changed'
           ELSE 'unchanged'
       END AS op,
       coalesce(model.pk, snap.pk) AS pk, model.row_hash, model.payload
FROM model FULL OUTER JOIN snap ON snap.pk = model.pk
ORDER BY length(coalesce(model.pk, snap.pk)), coalesce(model.pk, snap.pk)
"""

stats = {"requests": 0, "throttled": 0}


def post(path, body, max_retries=5):
    """POST в CRM с повтором по 429 и паузой из заголовка Retry-After."""
    data = json.dumps(body).encode()
    for attempt in range(max_retries + 1):
        req = urllib.request.Request(f"{CRM_URL}{path}", data=data, method="POST",
                                     headers={"Content-Type": "application/json"})
        stats["requests"] += 1
        try:
            with urllib.request.urlopen(req, timeout=10) as resp:
                return resp.status, attempt
        except urllib.error.HTTPError as err:
            if err.code != 429 or attempt == max_retries:
                raise
            stats["throttled"] += 1
            wait = int(err.headers.get("Retry-After", "1"))
            print(f"    429 Too Many Requests, Retry-After={wait} с, ждём", flush=True)
            time.sleep(wait)


def to_crm(pk, payload):
    record = {"external_id": pk}
    record.update({FIELD_MAP[col]: val for col, val in payload.items()})
    return record


def batches(items, size):
    for i in range(0, len(items), size):
        yield items[i:i + size]


def main():
    ap = argparse.ArgumentParser()
    ap.add_argument("--sync", required=True, help="имя синхронизации и объекта в CRM")
    ap.add_argument("--mode", choices=["upsert", "mirror"], default="upsert")
    ap.add_argument("--batch-size", type=int, default=5)
    args = ap.parse_args()
    started = time.monotonic()
    stats.update(requests=0, throttled=0)

    with psycopg.connect(DSN) as conn:
        rows = conn.execute(DIFF_SQL, {"sync": args.sync}).fetchall()
        conn.commit()
        diff = {"added": [], "changed": [], "removed": [], "unchanged": []}
        for op, pk, row_hash, payload in rows:
            diff[op].append((pk, row_hash, payload))
        print(f"[{args.sync}, mode={args.mode}] "
              + " ".join(f"{op}={len(v)}" for op, v in diff.items()))
        for op in ("added", "changed", "removed"):
            if diff[op]:
                print(f"  {op}: pk " + ", ".join(pk for pk, _, _ in diff[op]))

        # added и changed уходят одним потоком upsert: CRM сам решит, создать или обновить
        to_send = diff["added"] + diff["changed"]
        total = (len(to_send) + args.batch_size - 1) // args.batch_size
        for n, batch in enumerate(batches(to_send, args.batch_size), 1):
            status, retries = post(f"/objects/{args.sync}/upsert",
                                   {"records": [to_crm(pk, p) for pk, _, p in batch]})
            print(f"  batch {n}/{total} upsert {len(batch)} записей -> {status}"
                  + (f" после {retries} повтора" if retries else ""), flush=True)
            # снимок двигается только за подтверждённым батчем: при падении
            # следующий прогон переотправит лишь то, что не дошло
            with conn.transaction():
                conn.cursor().executemany(
                    """INSERT INTO reverse_etl.sync_snapshot (sync_name, pk, row_hash)
                       VALUES (%s, %s, %s)
                       ON CONFLICT (sync_name, pk)
                       DO UPDATE SET row_hash = EXCLUDED.row_hash, synced_at = now()""",
                    [(args.sync, pk, h) for pk, h, _ in batch])

        removed = [pk for pk, _, _ in diff["removed"]]
        if removed and args.mode == "mirror":
            status, _ = post(f"/objects/{args.sync}/delete", {"external_ids": removed})
            print(f"  delete {len(removed)} записей -> {status}")
        elif removed:
            print(f"  removed={len(removed)}: режим upsert удаления не отправляет, "
                  "записи остаются в CRM")
        if removed:
            with conn.transaction():
                conn.execute("DELETE FROM reverse_etl.sync_snapshot "
                             "WHERE sync_name = %s AND pk = ANY(%s)", (args.sync, removed))

    print(f"  итог: отправлено записей {len(to_send)}, HTTP-запросов {stats['requests']}, "
          f"из них 429: {stats['throttled']}, время {time.monotonic() - started:.1f} с")


if __name__ == "__main__":
    main()
Запуск сценария
Между прогонами файл changes.sql вносит в витрину пять правок. Две реальные, один UPDATE значений не меняет, один клиент добавляется и один удаляется.
-- postgres 18.6, прогнано на стенде 2026-11-05: изменения витрины между двумя прогонами синхронизации

-- два реальных изменения
UPDATE analytics.customer_scores SET ltv = 9999.00     WHERE customer_id = 7;
UPDATE analytics.customer_scores SET churn_risk = 'high' WHERE customer_id = 12;
-- UPDATE без смены значений: журнал БД его увидит, а diff результатов запроса нет
UPDATE analytics.customer_scores SET plan = plan        WHERE customer_id = 5;
-- новый клиент и ушедший клиент
INSERT INTO analytics.customer_scores VALUES (26, 'client26@example.com', 'team', 4200.50, 'low');
DELETE FROM analytics.customer_scores WHERE customer_id = 3;
Одна модель синхронизируется под двумя именами, contacts_mirror и contacts_upsert, чтобы сравнить режимы на удалении.
# Python 3.12.3, PostgreSQL 18.6, Docker Compose 2.40.3, проверено на стенде 2026-11-05
# хранилище, окружение Python и имитация CRM
docker compose up -d --wait
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/python mock_crm.py &

# прогон 1: снимка ещё нет, уходит вся модель
.venv/bin/python sync.py --sync contacts_mirror --mode mirror
.venv/bin/python sync.py --sync contacts_upsert --mode upsert

# правки витрины между прогонами
docker compose exec -T dwh psql -U demo -d dwh < changes.sql

# прогон 2: уходит только разница
.venv/bin/python sync.py --sync contacts_mirror --mode mirror
.venv/bin/python sync.py --sync contacts_upsert --mode upsert

# сколько записей осталось в каждом объекте CRM
curl -s http://127.0.0.1:18080/objects/contacts_mirror | python3 -c "import json,sys; print(json.load(sys.stdin)['count'])"
curl -s http://127.0.0.1:18080/objects/contacts_upsert | python3 -c "import json,sys; print(json.load(sys.stdin)['count'])"

# прогон 3: витрина не менялась
.venv/bin/python sync.py --sync contacts_mirror --mode mirror

# погасить стенд
kill %1
docker compose down -v
Результат прогона
# вывод прогона на стенде 2026-11-05, PostgreSQL 18.6, psycopg 3.3.8, Python 3.12.3, фрагменты run_output.txt
server_version: PostgreSQL 18.6 (Debian 18.6-1.pgdg13+2) on x86_64-pc-linux-gnu
витрина: 25 строк
mock CRM на http://127.0.0.1:18080, лимит 2 запросов/1.0 с, батч до 10 записей

=== ПРОГОН 1: первая синхронизация, снимка ещё нет ===
[contacts_mirror, mode=mirror] added=25 changed=0 removed=0 unchanged=0
  added: pk 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25
  batch 1/5 upsert 5 записей -> 200
  batch 2/5 upsert 5 записей -> 200
    429 Too Many Requests, Retry-After=1 с, ждём
  batch 3/5 upsert 5 записей -> 200 после 1 повтора
  batch 4/5 upsert 5 записей -> 200
    429 Too Many Requests, Retry-After=1 с, ждём
  batch 5/5 upsert 5 записей -> 200 после 1 повтора
  итог: отправлено записей 25, HTTP-запросов 7, из них 429: 2, время 2.3 с
[contacts_upsert, mode=upsert] added=25 changed=0 removed=0 unchanged=0
  added: pk 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, 16, 17, 18, 19, 20, 21, 22, 23, 24, 25
  batch 1/5 upsert 5 записей -> 200
    429 Too Many Requests, Retry-After=1 с, ждём
  batch 2/5 upsert 5 записей -> 200 после 1 повтора
  batch 3/5 upsert 5 записей -> 200
    429 Too Many Requests, Retry-After=1 с, ждём
  batch 4/5 upsert 5 записей -> 200 после 1 повтора
  batch 5/5 upsert 5 записей -> 200
  итог: отправлено записей 25, HTTP-запросов 7, из них 429: 2, время 2.2 с

=== ИЗМЕНЕНИЯ ВИТРИНЫ: changes.sql ===
UPDATE 1
UPDATE 1
UPDATE 1
INSERT 0 1
DELETE 1

=== ПРОГОН 2: уходит только разница ===
[contacts_mirror, mode=mirror] added=1 changed=2 removed=1 unchanged=22
  added: pk 26
  changed: pk 7, 12
  removed: pk 3
  batch 1/1 upsert 3 записей -> 200
  delete 1 записей -> 200
  итог: отправлено записей 3, HTTP-запросов 2, из них 429: 0, время 0.1 с
[contacts_upsert, mode=upsert] added=1 changed=2 removed=1 unchanged=22
  added: pk 26
  changed: pk 7, 12
  removed: pk 3
    429 Too Many Requests, Retry-After=1 с, ждём
  batch 1/1 upsert 3 записей -> 200 после 1 повтора
  removed=1: режим upsert удаления не отправляет, записи остаются в CRM
  итог: отправлено записей 3, HTTP-запросов 2, из них 429: 1, время 1.2 с

=== СОСТОЯНИЕ CRM после прогона 2 ===
contacts_mirror: записей=25 stats={'write_requests': 7, 'throttled': 2, 'upserted': 28, 'deleted': 1}
  3: нет записи
  7: {'lifetime_value': 9999.0, 'plan_tier': 'pro', 'email': 'client7@example.com', 'churn_risk': 'low'}
contacts_upsert: записей=26 stats={'write_requests': 6, 'throttled': 3, 'upserted': 28, 'deleted': 0}
  3: {'lifetime_value': 411.5, 'plan_tier': 'free', 'email': 'client3@example.com', 'churn_risk': 'low'}
  7: {'lifetime_value': 9999.0, 'plan_tier': 'pro', 'email': 'client7@example.com', 'churn_risk': 'low'}

=== ПРОГОН 3: витрина не менялась ===
[contacts_mirror, mode=mirror] added=0 changed=0 removed=0 unchanged=25
  итог: отправлено записей 0, HTTP-запросов 0, из них 429: 0, время 0.0 с

=== СНИМОК В ХРАНИЛИЩЕ ===
    sync_name    | rows
-----------------+------
 contacts_mirror |   25
 contacts_upsert |   25
Первый прогон отправил все 25 строк как added. Пять батчей при лимите 2 запроса в секунду дали 7 HTTP-запросов, из них два ответа 429, и синхронизация заняла 2.3 с. Номер батча с отказом зависит от того, куда пришлось начало окна лимита. У contacts_upsert 429 пришли на батчах 2 и 4, а не 3 и 5, так что это пример одного запуска, а не константа.
Второй прогон нашёл три строки для отправки, а именно клиента 26 в added, клиентов 7 и 12 в changed и клиента 3 в removed. Клиента 5 в выводе нет. Его UPDATE не поменял значений, и хэш строки остался прежним. Синхронизация contacts_mirror отправила 3 записи вместо 25 за два HTTP-запроса и 0.1 с.
Разница режимов видна на клиенте 3. Синхронизация contacts_mirror его удалила, и в объекте 25 записей. Синхронизация contacts_upsert удаление пропустила, в объекте 26 записей, и запись клиента 3 со старыми значениями лежит в CRM. При этом в обоих снимках по 25 строк, то есть upsert-синхронизация о клиенте 3 уже не помнит. Третий прогон не отправил ничего, все 25 строк попали в unchanged.
Заключение
Reverse ETL замыкает контур данных компании. ETL и ELT собирают данные в хранилище, аналитики превращают их в модели, а синхронизация возвращает результат в CRM и сервисы, где с ним работают люди. Под капотом это diff результатов SQL-запроса по первичному ключу, батчи под лимиты приёмника и аккуратная работа со снимком. Прогон на PostgreSQL показал обе стороны механизма. Второй прогон отправил 3 записи вместо 25 и не заметил пустой UPDATE, зато в режиме upsert удалённый клиент тихо остался в CRM. Поэтому поведение при удалении выбирают до первого запуска.