
 69
Содержание
- Что такое LLM Evaluation и какую задачу решает
- Архитектура контура оценки
- Тестовый датасет и критерии (ground truth vs reference-free)
- Роль LLM-as-a-judge
- Принцип работы цикла оценки
- Виды метрик и когда какую применять
- Ограничения LLM-as-a-judge (self-preference bias, нестабильность, стоимость)
- Сценарии использования и когда evaluation избыточен
- Практика
- Заключение
- Референсные ссылки
LLM Evaluation (Оценка качества LLM) это систематическая проверка ответов большой языковой модели (large language model, LLM) по заранее заданным критериям вместо разового просмотра результатов на глаз. Задача возникает из самой природы генеративной модели, потому что один и тот же промпт может дать разные по формулировке, но одинаково верные ответы, строгое сравнение строкой тут не работает, а ручная проверка каждого ответа не масштабируется дальше пары десятков примеров. Документация Ragas формулирует это как переход «от вайб-чеков (субъективной проверки на глаз) до систематических циклов оценки» AI-приложений.
У термина нет единого вендора и версии — это методология, а не продукт с релиз-циклом.
Что такое LLM Evaluation и какую задачу решает
Вокруг методологии выросло множество инструментов, среди них OpenAI Evals, Ragas, коммерческий LangSmith и lm-evaluation-harness. Пример движения — судьба платформы OpenAI Evals, которая по документации переходит в read-only 31 октября 2026 года и отключается 30 ноября 2026 года.
Архитектура контура оценки
Независимо от фреймворка контур оценки состоит из трёх частей, которые работают вместе, а именно тестовый датасет с эталонами и критериями, модель или система, которую проверяют, и слой грейдинга, который выносит вердикт по каждому ответу.
Тестовый датасет и критерии (ground truth vs reference-free)
Датасет оценки похож на тест-кейсы юнит-тестов, только вместо ожидаемого значения на выходе программы в нём лежит эталонный ответ модели и критерий соответствия ему. В OpenAI Evals это описывается двумя полями, data_source_config задаёт схему входных данных, а testing_criteria задаёт правила грейдинга поверх неё. Здесь же проходит разделение на два подхода к критерию. Ground truth-оценка сравнивает ответ с заранее известным эталоном, а reference-free оценка обходится без эталона вообще и проверяет свойства самого ответа, например связность, там, где единственно верного ответа не существует. Харнесс статьи построен на ground truth-подходе, потому что у четырёх тестовых вопросов есть однозначный правильный ответ.
Роль LLM-as-a-judge
Третий, самый гибкий слой грейдинга это LLM-as-a-judge, отдельная языковая модель, которой отдают вопрос, эталон и проверяемый ответ, а взамен получают оценку по рубрике вместо жёсткого правила. В харнессе статьи кандидатская модель qwen2.5:7b генерирует ответ, а роль судьи играет отдельная модель llama3.1:8b, специально не совпадающая с кандидатом. Судья, оценивающий ответы той же модели, которой сам является, предрасположен ставить более высокую оценку собственному стилю формулировок, это явление называется self-preference bias и разобрано в разделе об ограничениях ниже.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Принцип работы цикла оценки
OpenAI Evals и Ragas документируют один и тот же процесс разными словами, а обобщение по обоим источникам даёт четыре шага. Схема ниже показывает их как замкнутый цикл, а не разовый прогон.
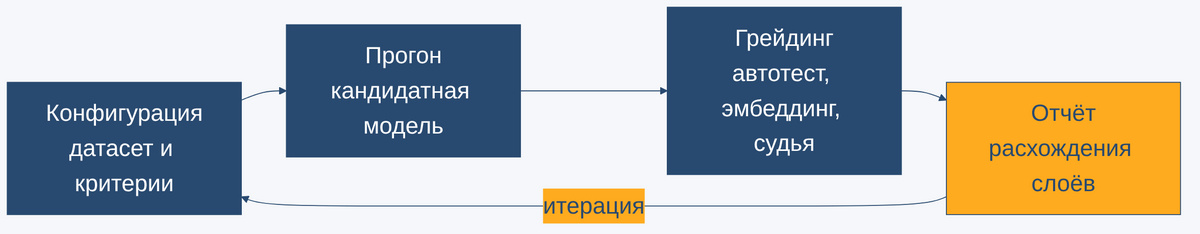
Конфигурация фиксирует тестовый датасет и критерии ещё до генерации первого ответа, в демо статьи это файл dataset.jsonl с вопросом, эталонным ответом и критериями по отдельной строке на кейс. Прогон это генерация ответа кандидатной моделью на каждый вопрос. Грейдинг применяет к ответу один или несколько слоёв оценки, их виды разобраны в следующем разделе. Отчёт сводит результаты по всем кейсам и явно указывает, где слои разошлись между собой, а не только средний балл. Расхождение слоёв здесь не сбой харнесса, а именно то, ради чего слоёв несколько, потому что одна метрика всегда слепа к какому-то классу ошибок, и цикл замыкается итерацией промпта, модели или критерия по итогам отчёта.
Виды метрик и когда какую применять
Слой грейдинга не единственен, обычно их совмещают, потому что у каждого свой профиль ошибок и своя цена вызова. В материале блога о метриках мониторинга LLM разбираются шире смежные показатели, такие как relevance, fairness, hallucinations и perplexity, а харнесс статьи фокусируется на трёх слоях цикла оценки.
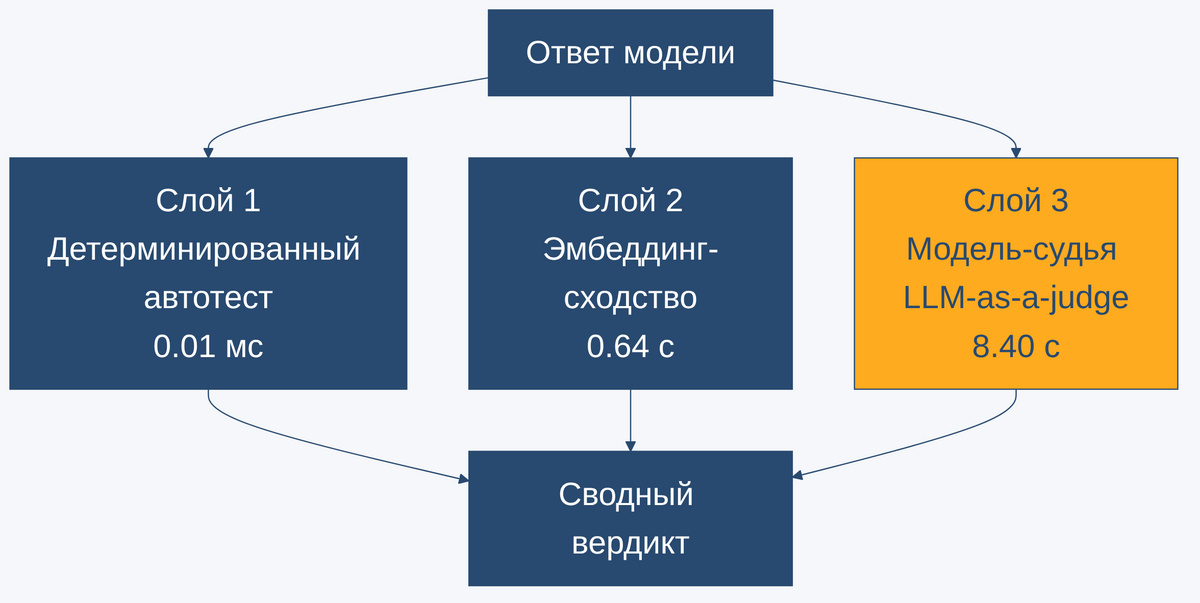
Детерминированный автотест, первый и самый дешёвый слой, проверяет формальные свойства ответа без обращения к модели и стоит 0.01 миллисекунды на кейс в демо статьи, но ловит только точное написание, а не смысл, что подтвердил прогон харнесса ниже. Эмбеддинг-сходство, второй слой, переводит ответ и эталон в векторное представление и считает косинусное сходство между ними, вызов эмбеддера nomic-embed-text занял 0.64 секунды. Слой ловит смысловую близость независимо от формулировки, но не фактические ошибки, потому что развёрнутый неверный ответ на ту же тему может лечь в векторном пространстве рядом с верным. Модель-судья (LLM-as-a-judge), третий и самый дорогой слой, читает вопрос, эталон и ответ целиком и выносит оценку по рубрике с текстовым обоснованием, вызов llama3.1:8b занял 8.40 секунды на том же кейсе, в 13.1 раза дороже эмбеддинга. Таблица ниже сводит слои по тому, что они проверяют, чего не видят и во сколько обходятся по замеру статьи.
| Слой | Что проверяет | Слепая зона | Время на кейс (замер статьи) |
|---|---|---|---|
| Детерминированный автотест | Ключевые слова, длина ответа | Смысл при другой словоформе или формулировке | 0.01 мс |
| Эмбеддинг-сходство | Смысловая близость к эталону | Фактические ошибки внутри похожего текста | 0.64 с |
| Модель-судья (LLM-as-a-judge) | Фактическую точность и полноту по рубрике | Собственная нестабильность и self-preference bias | 8.40 с |
На практике слои применяют вместе, потому что расхождение между ними и есть сигнал. В прогоне харнесса статьи автотест не прошёл ни один из четырёх кейсов, а эмбеддинг-сходство и судья независимо оценили те же ответы как качественные, средний similarity 0.8929 и средний балл судьи 5.00 из 5, разбор причины в разделе «Практика».
Ограничения LLM-as-a-judge (self-preference bias, нестабильность, стоимость)
Судья решает задачу смыслового сравнения лучше формального правила, но платит за гибкость тремя ограничениями, которые видны уже на простом прогоне. Разделение кандидата и судьи на разные модели, qwen2.5:7b против llama3.1:8b, снижает риск self-preference bias из раздела про архитектуру, но не убирает его полностью, потому что смещение может проявляться и между семействами моделей.
Второе ограничение это нестабильность оценки при одном и том же входе. Отдельный демо-файл статьи отправил судье один и тот же вопрос, ответ и эталон пять раз подряд, сначала при temperature=0, затем при temperature=0.7. В обоих случаях баллы легли в ряд [5, 5, 5, 5, 5], разброс между максимумом и минимумом составил 0. Такой результат ожидаем именно на простом, однозначном кейсе, где правильность ответа не вызывает сомнений, а не означает, что нестабильности не существует, на пограничных, спорных ответах разброс проявляется заметнее, потому что судье там есть между чем выбирать.
Третье ограничение это стоимость. Судья читает длинный промпт с рубрикой и генерирует текстовое обоснование, а не одну оценку, поэтому вызов ощутимо дороже эмбеддинга, 8.40 секунды против 0.64 секунды на одном кейсе, в 13.1 раза. При росте датасета до сотен кейсов эта разница переходит из статьи расходов в ограничение архитектуры, потому что прогонять судью на каждый ответ каждой итерации становится дорого.
Сценарии использования и когда evaluation избыточен
Оценка качества LLM оправдана там, где ответ модели уходит дальше разработческого чата, а именно в промпт, который регулярно меняют, в сравнение нескольких моделей перед выбором и в регрессионное тестирование перед каждым релизом системы на LLM. OpenAI Evals перечисляет ровно эти три случая как основные. Есть и более крупный класс задач, сравнение модели с эталонными академическими бенчмарками, а не с датасетом команды. Проект lm-evaluation-harness от лаборатории EleutherAI собирает свыше 60 стандартных бенчмарков и служил движком архивированного в 2025 году Open LLM Leaderboard на Hugging Face, это иной масштаб задачи, чем харнесс статьи ниже, где сравнивают не модели между собой, а конкретный промпт конкретного приложения.
Evaluation избыточен там, где у ответа модели нет получателя, кроме автора промпта, который тут же видит результат своими глазами, и там, где система меняется настолько редко, что цена регрессии невысока. По трактовке документации Ragas, это как раз ситуации, где не стоит выстраивать полноценный контур. Как только промпт или модель встраивают в продукт с реальными пользователями, разовая проверка на глаз перестаёт покрывать риск, и наступает момент, ради которого разбирается курс «ИИ-агенты для оптимизации бизнес-процессов», где базовые метрики и мониторинг качества агентских систем даны в связке с архитектурой агента.
Практика
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо статьи прогнано на локальном стенде без внешних облачных API через python-клиент ollama версии 0.6.2. Первый файл, dataset.jsonl, задаёт четыре тестовых вопроса с эталонными ответами и критериями формального слоя.
# конфигурация оценки: подготовлено вручную автором статьи 2026-08-30, без внешнего источника
# один тест-кейс на строку: вопрос, эталонный ответ и критерии для детерминированного слоя.
# "must_include" - подстроки-основы слов (без окончаний), допускающие разные словоформы модели.
# "max_words" - верхняя граница длины ответа в словах, проверяет лаконичность, а не факты.
{"id": "overfitting", "question": "Что такое переобучение (overfitting) в машинном обучении?", "reference_answer": "Переобучение - ситуация, когда модель слишком точно подстраивается под обучающие данные, запоминая шум и частности вместо общих закономерностей, и поэтому плохо работает на новых данных.", "must_include": ["обучающ", "новых данных"], "max_words": 60}
{"id": "db_index", "question": "Зачем нужен индекс в базе данных?", "reference_answer": "Индекс - это дополнительная структура данных, которая ускоряет поиск и выборку строк по значению столбца, избавляя от полного сканирования таблицы, но замедляет операции записи и занимает место на диске.", "must_include": ["ускоря", "запис"], "max_words": 60}
{"id": "batch_vs_stream", "question": "В чём разница между batch- и stream-обработкой данных?", "reference_answer": "Batch-обработка накапливает данные и обрабатывает их порциями через интервалы времени, а stream-обработка обрабатывает каждое событие сразу по мере поступления, обеспечивая минимальную задержку ценой большей сложности инфраструктуры.", "must_include": ["порци", "событ"], "max_words": 70}
{"id": "rag", "question": "Что такое RAG (Retrieval-Augmented Generation)?", "reference_answer": "RAG - архитектурный подход, при котором модель перед генерацией ответа сначала находит релевантные фрагменты во внешней базе знаний через поиск, а затем формирует ответ, опираясь на найденный контекст, а не только на веса модели.", "must_include": ["поиск", "контекст"], "max_words": 70}
Второй файл, eval_harness.py, генерирует ответ кандидата на каждый вопрос датасета и оценивает его тремя независимыми слоями, после чего строит сводный отчёт с перечислением кейсов, где слои разошлись.
# ollama 0.6.2, модели qwen2.5:7b (кандидат), llama3.1:8b (судья), nomic-embed-text (эмбеддинги), прогнано на стенде 2026-08-30
"""
Минимальный харнесс оценки LLM: три независимых слоя метрик на одном наборе вопросов.

Цикл конфигурация -> прогон -> грейдинг -> отчёт:
  1. конфигурация - dataset.jsonl: вопрос, эталонный ответ, критерии
  2. прогон - кандидатная модель генерирует ответ на каждый вопрос
  3. грейдинг - три слоя оценивают один и тот же ответ независимо друг от друга:
       a) детерминированный автотест (подстроки, длина) - быстро и без модели, но грубо
       b) эмбеддинг-сходство с эталоном - ловит смысловую близость, не ловит фактические ошибки
       c) модель-судья (отдельная от кандидата, чтобы не проверять модель её же собственным
          мнением о себе - self-preference bias разобран отдельно в статье про LLM-as-a-Judge)
  4. отчёт - таблица по всем кейсам и слоям, плюс явное перечисление кейсов, где слои разошлись

Расхождение слоёв - не баг харнесса, а ровно то, ради чего слоёв три: единственная метрика
всегда слепа к какому-то классу ошибок.
"""
import json
import math
import re
import time
from pathlib import Path

import ollama

CANDIDATE_MODEL = "qwen2.5:7b"
JUDGE_MODEL = "llama3.1:8b"
EMBED_MODEL = "nomic-embed-text"

JUDGE_PROMPT = """Ты - технический рецензент. Сравни ответ ассистента с эталонным ответом
на тот же вопрос и оцени фактическую точность и полноту ответа ассистента по шкале от 1 до 5,
где 5 - ответ полностью соответствует эталону по смыслу, 1 - противоречит эталону или не по теме.
Не снижай оценку за другую формулировку, если смысл совпадает.

Первая строка ответа должна быть РОВНО в формате "SCORE: <1-5>", без пояснений в этой строке.
Затем с новой строки одно предложение обоснования.

Вопрос: {question}

Эталонный ответ:
{reference}

Ответ ассистента для оценки:
{answer}
"""


def load_dataset(path: Path) -> list[dict]:
    cases = []
    for line in path.read_text(encoding="utf-8").splitlines():
        line = line.strip()
        if not line or line.startswith("#"):
            continue
        cases.append(json.loads(line))
    return cases


def generate_answer(question: str) -> str:
    response = ollama.chat(model=CANDIDATE_MODEL, messages=[{"role": "user", "content": question}])
    return response["message"]["content"]


def deterministic_check(answer: str, must_include: list[str], max_words: int) -> dict:
    lowered = answer.lower()
    missing = [kw for kw in must_include if kw.lower() not in lowered]
    word_count = len(answer.split())
    return {
        "keywords_missing": missing,
        "word_count": word_count,
        "within_limit": word_count <= max_words,
        "passed": not missing and word_count  float:
    dot = sum(x * y for x, y in zip(a, b))
    norm_a = math.sqrt(sum(x * x for x in a))
    norm_b = math.sqrt(sum(y * y for y in b))
    return dot / (norm_a * norm_b)


def embedding_similarity(answer: str, reference: str) -> float:
    # "clustering: " - префикс nomic-embed-text для симметричного сравнения "текст к тексту".
    # search_query/search_document тут не подходят: ни один из двух текстов не запрос к другому.
    embeddings = ollama.embed(
        model=EMBED_MODEL,
        input=[f"clustering: {answer}", f"clustering: {reference}"],
    )["embeddings"]
    return cosine_similarity(embeddings[0], embeddings[1])


def judge_score(question: str, answer: str, reference: str) -> dict:
    prompt = JUDGE_PROMPT.format(question=question, reference=reference, answer=answer)
    response = ollama.chat(
        model=JUDGE_MODEL,
        messages=[{"role": "user", "content": prompt}],
        options={"temperature": 0},
    )
    raw = response["message"]["content"]
    match = re.search(r"^SCORE:\s*([1-5])\s*$", raw, re.IGNORECASE | re.MULTILINE)
    if not match:
        return {"score": None, "raw": raw}
    return {"score": int(match.group(1)), "raw": raw}


def main() -> None:
    dataset = load_dataset(Path(__file__).parent / "dataset.jsonl")
    results = []

    for case in dataset:
        print(f"=== {case['id']} ===")
        print(f"Вопрос: {case['question']}")

        t0 = time.time()
        answer = generate_answer(case["question"])
        gen_time = time.time() - t0
        print(f"Ответ кандидата ({CANDIDATE_MODEL}, {gen_time:.1f} с): {answer}")

        det = deterministic_check(answer, case["must_include"], case["max_words"])
        sim = embedding_similarity(answer, case["reference_answer"])
        judge = judge_score(case["question"], answer, case["reference_answer"])

        print(f"  Слой 1 (автотест):    {'ПРОЙДЕН' if det['passed'] else 'НЕ ПРОЙДЕН'} "
              f"(слов: {det['word_count']}, не найдены: {det['keywords_missing'] or '-'})")
        print(f"  Слой 2 (эмбеддинг):   cosine similarity = {sim:.4f}")
        print(f"  Слой 3 (судья {JUDGE_MODEL}): score = {judge['score']}")
        print()

        results.append({"id": case["id"], "det_passed": det["passed"], "similarity": sim, "judge_score": judge["score"]})

    print("=== Итоговый отчёт ===")
    header = f"{'кейс':<16} {'автотест':<10} {'similarity':<12} {'судья 1-5':<10}"
    print(header)
    print("-" * len(header))
    disagreements = []
    for r in results:
        print(f"{r['id']:<16} {'да' if r['det_passed'] else 'нет':<10} {r['similarity']:<12.4f} {str(r['judge_score']):<10}")
        # расхождение слоёв: автотест не прошёл, а два содержательных слоя оценивают ответ высоко -
        # значит формальный критерий (например, набор ключевых слов) был слишком узким
        if not r["det_passed"] and r["similarity"] > 0.7 and (r["judge_score"] or 0) >= 4:
            disagreements.append(r["id"])

    avg_similarity = sum(r["similarity"] for r in results) / len(results)
    avg_judge = sum(r["judge_score"] for r in results if r["judge_score"] is not None) / len(results)
    print(f"\nСредний similarity: {avg_similarity:.4f}, средний балл судьи: {avg_judge:.2f}")

    if disagreements:
        print(f"Расхождение слоёв на кейсах {disagreements}: автотест забраковал ответ, "
              f"который эмбеддинг и судья считают качественным - узкий формальный критерий, а не плохой ответ.")
    else:
        print("Слои согласны на всех кейсах в этом прогоне.")


if __name__ == "__main__":
    main()
Ниже кейс db_index целиком и итоговая сводная таблица по всем четырём кейсам.
=== db_index ===
Вопрос: Зачем нужен индекс в базе данных?
Ответ кандидата (qwen2.5:7b, 35.7 с): Индекс в базе данных используется для ускорения процесса поиска и извлечения данных. Вот несколько ключевых причин, почему индексы так важны:

1. **Ускорение поиска**: Индексы позволяют БД быстро находить нужные строки без необходимости просмотра всего таблицы. Это особенно полезно при больших объемах данных.

2. **Повышение производительности**: Без индексов БД может затратить значительное время на выполнение запросов, особенно если они содержат условия WHERE с большим количеством данных.

3. **Контроль использования памяти**: Индексы занимают место в памяти БД, но их использование часто окупается благодаря ускорению выполнения запросов.

4. **Параллельное выполнение запросов**: Индексы могут способствовать параллельному выполнению запросов, особенно в системах с распределенной архитектурой.

5. **Минимизация нагрузки на таблицы**: Использование индексов может уменьшить количество операций чтения и записи в таблицах, что важно для оптимизации работы БД.

6. **Поддержка операций сортировки и группировки**: Индексы могут значительно ускорить операции ORDER BY и GROUP BY.

Однако стоит помнить, что использование индексов тоже имеет свои минусы, такие как увеличение времени на вставку и обновление данных в таблице, так как при каждом изменении индекса также требуется обновить его структуру. Поэтому оптимальное использование индексов требует тщательного планирования и регулярного анализа производительности базы данных.
  Слой 1 (автотест):    НЕ ПРОЙДЕН (слов: 183, не найдены: ['ускоря'])
  Слой 2 (эмбеддинг):   cosine similarity = 0.9177
  Слой 3 (судья llama3.1:8b): score = 5

=== Итоговый отчёт ===
кейс             автотест   similarity   судья 1-5
---------------------------------------------------
overfitting      нет        0.8703       5
db_index         нет        0.9177       5
batch_vs_stream  нет        0.9259       5
rag              нет        0.8577       5

Средний similarity: 0.8929, средний балл судьи: 5.00
Расхождение слоёв на кейсах ['overfitting', 'db_index', 'batch_vs_stream', 'rag']: автотест забраковал ответ, который эмбеддинг и судья считают качественным - узкий формальный критерий, а не плохой ответ.
Причина видна в кейсе db_index: критерий искал подстроку «ускоря» из глагола «ускорять», а модель ответила словом «ускорения» — тот же корень, другая словоформа. На overfitting и batch_vs_stream та же проблема: критерий искал точную фразу, а ответ передавал тот же смысл другими словами. Кейс rag не потерял ни одного ключевого слова и провалился только по длине. Во всех четырёх случаях причина в узости критерия, а не в качестве ответа модели. Вторая закономерность в длине ответов, все четыре вышли за рамки критерия max_words, 182, 183, 255 и 181 слово при лимите 60-70, и легли маркированным списком, хотя в вопросе не было ни слова про формат. Модель выбирает список по умолчанию, если её не ограничить прямо в тексте промпта, а не только в постпроверке, и это претензия к промпту, а не к содержанию ответа.
Третий файл, judge_stability_cost.py, воспроизводит на реальном вызове нестабильность судьи на пяти повторах при двух значениях temperature и относительную стоимость трёх слоёв на одном кейсе.
# ollama 0.6.2, модель llama3.1:8b (судья), прогнано на стенде 2026-08-30
"""
Два ограничения модели-судьи, которые не видны на одном прогоне: нестабильность и стоимость.

Нестабильность: один и тот же вопрос/ответ/эталон отправляется судье N раз подряд без
изменений во входе. temperature=0 должна давать одинаковый балл на каждом повторе - это и
проверяем. Затем то же самое с temperature=0.7, где разброс ожидаем по конструкции модели.

Стоимость: одна и та же пара "ответ + эталон" оценивается тремя слоями харнесса
(eval_harness.py), и меряется время каждого слоя. Детерминированный автотест не ходит в
модель вообще, эмбеддинг - один короткий вызов, судья - самый тяжёлый: длинный промпт с
рубрикой плюс генерация обоснования, а не одного числа.
"""
import re
import statistics
import time

import ollama

JUDGE_MODEL = "llama3.1:8b"
REPEATS = 5

QUESTION = "Зачем нужен индекс в базе данных?"
REFERENCE = (
    "Индекс - это дополнительная структура данных, которая ускоряет поиск и выборку строк "
    "по значению столбца, избавляя от полного сканирования таблицы, но замедляет операции "
    "записи и занимает место на диске."
)
# фиксированный ответ кандидата, не эталонный дословно, но верный по сути - типичный кейс
# для судьи, а не для точного строкового сравнения
ANSWER = (
    "Индекс ускоряет поиск нужных строк в таблице, потому что базе не нужно просматривать "
    "все записи подряд. Платить за это приходится местом на диске и более медленной записью, "
    "так как индекс тоже нужно обновлять."
)

JUDGE_PROMPT = """Ты - технический рецензент. Сравни ответ ассистента с эталонным ответом
на тот же вопрос и оцени фактическую точность и полноту ответа ассистента по шкале от 1 до 5,
где 5 - ответ полностью соответствует эталону по смыслу, 1 - противоречит эталону или не по теме.

Первая строка ответа должна быть РОВНО в формате "SCORE: <1-5>", без пояснений в этой строке.
Затем с новой строки одно предложение обоснования.

Вопрос: {question}

Эталонный ответ:
{reference}

Ответ ассистента для оценки:
{answer}
"""


def judge_once(temperature: float) -> tuple[int | None, float]:
    t0 = time.time()
    response = ollama.chat(
        model=JUDGE_MODEL,
        messages=[{"role": "user", "content": JUDGE_PROMPT.format(question=QUESTION, reference=REFERENCE, answer=ANSWER)}],
        options={"temperature": temperature},
    )
    elapsed = time.time() - t0
    raw = response["message"]["content"]
    match = re.search(r"^SCORE:\s*([1-5])\s*$", raw, re.IGNORECASE | re.MULTILINE)
    return (int(match.group(1)) if match else None, elapsed)


def measure_stability(temperature: float) -> None:
    scores = []
    times = []
    for i in range(REPEATS):
        score, elapsed = judge_once(temperature)
        scores.append(score)
        times.append(elapsed)
        print(f"  прогон {i + 1}: score={score}, {elapsed:.1f} с")
    valid = [s for s in scores if s is not None]
    spread = max(valid) - min(valid) if valid else None
    print(f"  баллы: {scores}, разброс (max-min): {spread}, среднее время: {statistics.mean(times):.1f} с")


def measure_layer_cost() -> None:
    # слой 1: детерминированный автотест - без сети и без модели
    t0 = time.time()
    missing = [kw for kw in ["ускоря", "запис"] if kw not in ANSWER.lower()]
    det_time = time.time() - t0
    print(f"  слой 1 (автотест):  {det_time * 1000:.2f} мс, не найдено ключевых слов: {missing or '-'}")

    # слой 2: эмбеддинг-сходство - один короткий вызов модели
    t0 = time.time()
    ollama.embed(model="nomic-embed-text", input=[f"clustering: {ANSWER}", f"clustering: {REFERENCE}"])
    embed_time = time.time() - t0
    print(f"  слой 2 (эмбеддинг): {embed_time:.2f} с")

    # слой 3: судья - длинный промпт с рубрикой, генерация обоснования, а не одного числа
    _, judge_time = judge_once(temperature=0)
    print(f"  слой 3 (судья):     {judge_time:.2f} с")
    print(f"  судья дороже эмбеддинга в {judge_time / embed_time:.1f} раза")


def main() -> None:
    print("=== Нестабильность: temperature=0, 5 повторов одного и того же входа ===")
    measure_stability(temperature=0)

    print("\n=== Нестабильность: temperature=0.7, 5 повторов ===")
    measure_stability(temperature=0.7)

    print("\n=== Стоимость трёх слоёв на одном кейсе ===")
    measure_layer_cost()


if __name__ == "__main__":
    main()
Реальный вывод подтверждает цифры раздела об ограничениях побуквенно.
=== Нестабильность: temperature=0, 5 повторов одного и того же входа ===
  прогон 1: score=5, 10.1 с
  прогон 2: score=5, 8.3 с
  прогон 3: score=5, 8.2 с
  прогон 4: score=5, 8.1 с
  прогон 5: score=5, 8.4 с
  баллы: [5, 5, 5, 5, 5], разброс (max-min): 0, среднее время: 8.6 с

=== Нестабильность: temperature=0.7, 5 повторов ===
  прогон 1: score=5, 4.2 с
  прогон 2: score=5, 4.5 с
  прогон 3: score=5, 6.0 с
  прогон 4: score=5, 6.8 с
  прогон 5: score=5, 5.0 с
  баллы: [5, 5, 5, 5, 5], разброс (max-min): 0, среднее время: 5.3 с

=== Стоимость трёх слоёв на одном кейсе ===
  слой 1 (автотест):  0.01 мс, не найдено ключевых слов: -
  слой 2 (эмбеддинг): 0.64 с
  слой 3 (судья):     8.40 с
  судья дороже эмбеддинга в 13.1 раза
Ноль разброса ожидаем именно потому, что вопрос про индекс однозначен, нестабильность LLM-as-a-judge стоит искать на спорных ответах, а не на явно правильных.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Заключение
Оценка качества LLM разбирает один ответ модели с трёх сторон, формально, семантически и содержательно, потому что ни один из слоёв не покрывает слепые зоны двух других в одиночку. Прогон харнесса статьи показал это на реальных числах, а не в теории. Автотест провалил все четыре кейса из-за узкого критерия по подстрокам, эмбеддинг-сходство держалось в диапазоне 0.8577-0.9259, а судья поставил высший балл на каждом кейсе, но стоил на порядок дороже эмбеддинга и остаётся подвержен self-preference bias и нестабильности, которую на однозначных ответах не всегда получается увидеть. Слои надёжнее считать не конкурентами, а взаимной проверкой, где расхождение между ними значит больше, чем итоговый средний балл.
Референсные ссылки
- developers.openai.com/api/docs/guides/evals, официальная документация OpenAI Evals, архитектура конфигурации и прогонов, а также объявление о переходе платформы в read-only 31 октября 2026 года и полном отключении 30 ноября 2026 года.
- docs.ragas.io/en/stable/, официальная документация Ragas, определение термина, компоненты Experiments, Metrics и Dataset Management, интеграции с LangChain и LlamaIndex.
- github.com/EleutherAI/lm-evaluation-harness, официальный репозиторий lm-evaluation-harness от EleutherAI, свыше 60 стандартных академических бенчмарков, движок архивированного в 2025 году Open LLM Leaderboard на Hugging Face.