 3
Содержание
- Что такое LLM-as-a-Judge и какую задачу он решает
- Архитектура LLM-судьи и типы промптов оценки
- Что получает судья на входе
- Single-answer grading, pairwise comparison и reference-based оценка
- Как рубрика превращается в вердикт
- Ограничения и предвзятости LLM-судьи
- LLM-судья, классические метрики и разметка человеком
- Когда применять LLM-as-a-Judge, а когда не стоит
- LLM-судья на локальных моделях
- Single-answer grading по рубрике из четырёх критериев
- Pairwise comparison и проверка на position bias
- Заключение
- Референсные ссылки
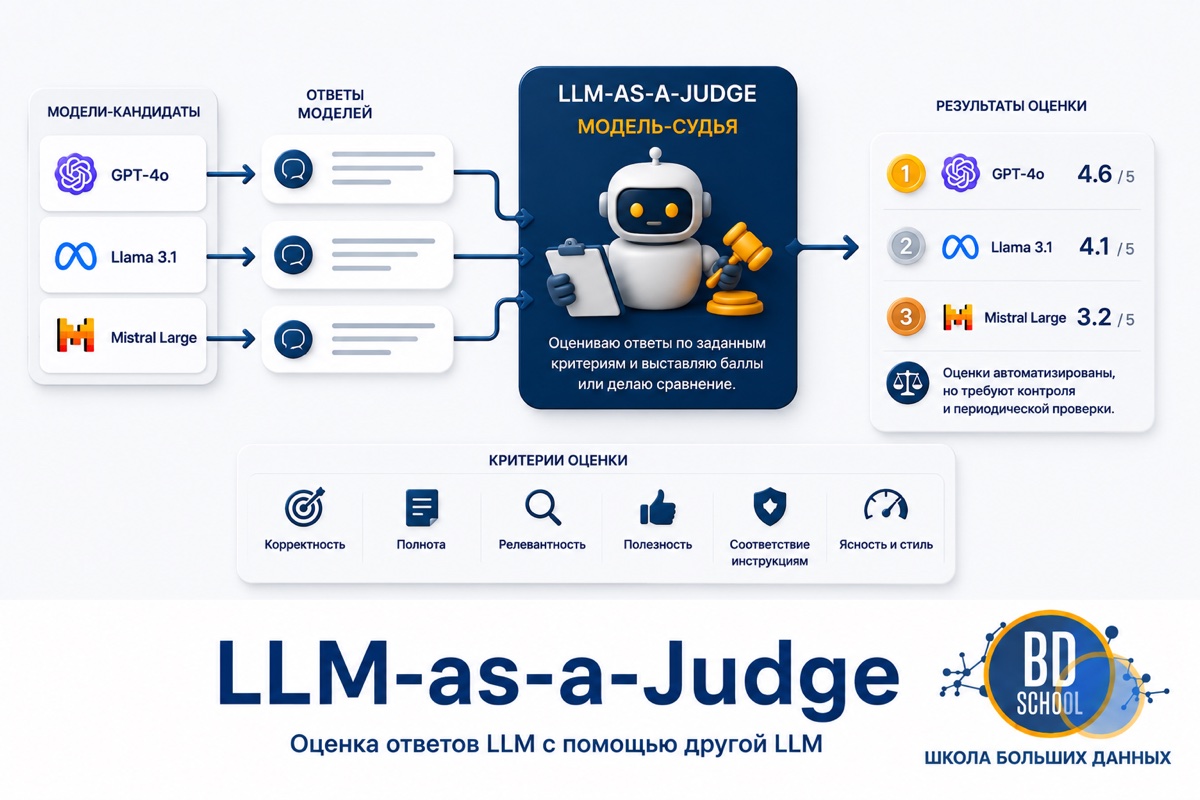
LLM-as-a-Judge, дословно «модель в роли судьи», это метод автоматизированной оценки ответов больших языковых моделей (large language model, LLM), при котором роль критика берёт на себя другая LLM, а не человек-эксперт и не классическая метрика вроде BLEU или ROUGE. Судья получает вопрос, ответ кандидата и явную рубрику критериев, а на выходе выдаёт не голое число, а развёрнутый вердикт на естественном языке, который можно прочитать и оспорить, а не только использовать как отметку.
Что такое LLM-as-a-Judge и какую задачу он решает
Проблема, которую закрывает подход, в отсутствии единственно верного ответа у большинства задач для LLM. Пересказ документа, ответ по базе знаний, письмо клиенту допускают десятки формулировок, одинаково корректных по смыслу и совершенно разных по буквальному тексту. Метрики совпадения строк вроде BLEU (для машинного перевода) и ROUGE (для суммаризации) считались для задач с узким набором эталонных ответов и на открытых генеративных задачах систематически занижают качество живых, но не дословных ответов.
Разметка человеком точнее, но не масштабируется на тысячи ответов в сутки и стоит заметных денег на каждой итерации промпта, а асессоры расходятся друг с другом в оценке чаще, чем кажется на первый взгляд. LLM-as-a-Judge закрывает этот разрыв. Судья не сравнивает строки, а рассуждает о содержании примерно так, как это делает эксперт-рецензент, при этом не требует оплаты труда человека на каждую оценку и параллелится на весь объём трафика. Обзор LLMs-as-Judges (arXiv, декабрь 2024) описывает область по пяти измерениям, зачем нужен LLM-оценщик, как строить такие системы оценки, в каких доменах их применяют, как оценивать качество самого судьи и какие у подхода ограничения. Дальше статья идёт по тем же измерениям, начиная с архитектуры.
Архитектура LLM-судьи и типы промптов оценки
Архитектура LLM-судьи держится на трёх компонентах входа и одном из нескольких форматов промпта, который определяет, что именно судья возвращает на выходе.
Что получает судья на входе
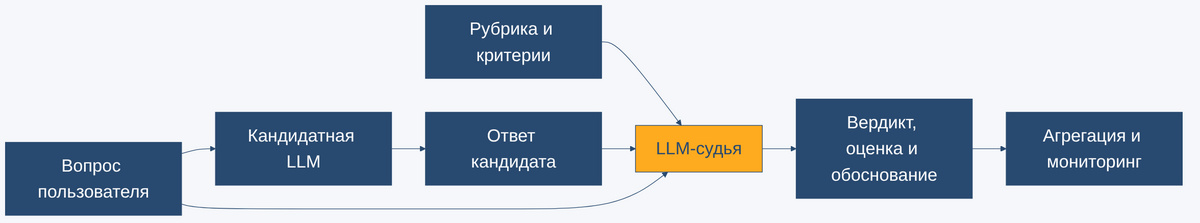
Судье передают три элемента. Критерии оценки задают, что считается хорошим ответом, точность, полнота, безопасность или доменное правило вроде «код должен компилироваться». Контент для оценки — это сам ответ кандидатной модели, часто вместе с исходным вопросом и контекстом, из которого модель отвечала. Формат скоринга определяет структуру вывода, числовая шкала от 1 до 5 или от 1 до 10, бинарная отметка pass или fail, попарный вердикт победителя или структурированная JSON-схема сразу с несколькими полями.
Single-answer grading, pairwise comparison и reference-based оценка
На практике различают single-answer grading, когда судья оценивает один ответ по абсолютной шкале без сравнения с кем-либо, и pairwise comparison, когда судья получает два ответа на один вопрос и должен назвать более удачный либо признать ничью. Отдельно выделяют reference-based оценку, где у судьи есть эталонный ответ для сверки, и reference-free, где эталона нет и судья опирается только на рубрику и здравый смысл предметной области. Помимо формата промпта, готовые реализации группируют судей ещё и по предметной области. Например, Microsoft Foundry (облачная платформа Microsoft для построения и эксплуатации AI-приложений на базе Azure) поставляет библиотеку готовых evaluator’ов, общего назначения (coherence, fluency), специфичных для RAG (groundedness, relevance), связанных с безопасностью (hate и unfairness, violence, protected materials) и агентных (точность вызова инструментов, task completion), и каждый из них реализован одним из перечисленных выше форматов промпта.
Как рубрика превращается в вердикт
Механизм работы у всех вариаций общий. Судья получает единый промпт, который склеивает рубрику критериев, вопрос пользователя и оцениваемый контент. Модель генерирует ответ в свободной форме, объяснение вместе с числом или категорией, а не сразу готовую структуру. Сервис вокруг судьи парсит этот текстовый вывод в предсказуемый формат, обычно JSON или короткую метку победителя вроде «WINNER» с буквой ответа, чтобы дальше агрегировать оценки автоматически.
Ценность именно текстового вердикта, а не голого числа, в интерпретируемости. Разработчик читает обоснование судьи и видит, за что снят балл, спутанный порядок шагов рассуждения, пропущенный кейс или устаревший факт, а не только итоговую цифру без объяснения. Это и отличает LLM-судью от классических метрик, у которых есть число, но нет обоснования.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Ограничения и предвзятости LLM-судьи
У метода задокументирован не один частный баг, а несколько системных предвзятостей (bias), которые проявляются у разных моделей-судей и на разных задачах.
- Position bias. Судья предпочитает ответ на определённой позиции в промпте независимо от его содержания. Эффект статистический, а не гарантированный на каждом отдельном сравнении, поэтому его проверяют на наборе вопросов, именно так устроена проверка в демо этой статьи ниже.
- Verbosity bias. Более длинный ответ получает более высокую оценку, даже если избыточная длина не добавляет содержания.
- Self-enhancement bias. Судья оценивает выше ответы, стилистически похожие на ответы своего семейства моделей, то есть не вполне независим от того, кто отвечал.
- Чувствительность к формулировке промпта. Небольшое изменение инструкции по формату вывода заметно сдвигает вердикт, вплоть до того, что судья дословно повторяет шаблон инструкции вместо содержательного ответа, именно это произошло при отладке демо этой статьи ниже.
Ни один из этих эффектов не делает LLM-as-a-Judge бесполезным, но требует держать в уме, что судья тоже модель со своими слепыми зонами, а не эталон истины.
Отдельная категория ограничений связана с экспертными задачами. Судья наследует слепые зоны обучающих данных и в задачах, требующих узкой предметной экспертизы, например медицинских или юридических, может пропустить критическую деталь, которую заметил бы специалист, или не распознать потенциально вредную рекомендацию. Для таких доменов LLM-as-a-Judge используют как первый фильтр, а не как замену эксперту.
LLM-судья, классические метрики и разметка человеком
Три подхода к оценке качества LLM-приложений закрывают разные компромиссы между скоростью, ценой и точностью.
| Критерий | Классические метрики (BLEU, ROUGE) | Разметка человеком | LLM-as-a-Judge |
|---|---|---|---|
| Масштабируемость | Высокая, но требует эталонных ответов | Низкая, упирается в число доступных асессоров | Высокая, параллелится на весь трафик |
| Стоимость на тысячу оценок | Минимальная после подготовки эталонов | Максимальная, оплата труда людей | Средняя, стоимость вызовов LLM-судьи |
| Интерпретируемость вердикта | Нет, только число совпадения | Высокая при наличии комментария асессора | Высокая, вердикт на естественном языке |
| Устойчивость к формулировке ответа | Низкая, штрафует перефразирование | Высокая | Средняя, есть задокументированные bias |
| Годится для задач без эталона | Нет | Да | Да, через reference-free рубрику |
На практике три подхода не конкурируют, а комбинируются по слоям. Классические метрики ловят регрессии в CI за секунды, LLM-судья закрывает основной объём смысловой оценки, а человек остаётся на калибровке рубрики и на выборочном аудите самых спорных случаев.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Когда применять LLM-as-a-Judge, а когда не стоит
Документация Microsoft Foundry по наблюдаемости встраивает LLM-судей в три стадии жизненного цикла приложения, подход разобран в статье Observability in Generative AI.
- Выбор базовой модели. Сравнение качества и безопасности между кандидатами до того, как один из них закладывается в архитектуру продукта.
- Pre-production оценка. Прогон на тестовых датасетах и граничных случаях перед деплоем, метрики вроде groundedness (соответствие ответа предоставленному контексту), relevance и task adherence.
- Post-production мониторинг. Continuous evaluation на выборке продакшн-трафика, плановая проверка на дрифт качества и алерты при просадке.
Этот трёхступенчатый цикл ближе к практике, разобранной в материале Потоковая обработка данных и EDA-архитектура для LLM-систем, где метрики релевантности, непредвзятости и склонности к галлюцинациям считаются как раз для непрерывного мониторинга LLM-приложения в проде.
Полагаться на LLM-as-a-Judge как на единственный метод стоит с осторожностью там, где нужна экспертная предметная оценка без участия человека, медицина, право, задачи безопасности с высокой ценой ошибки. В таких доменах судья способен пропустить критическую деталь, которую заметил бы специалист, это ограничение разобрано в академических работах о лимитах LLM-судей, а не сформулировано прямо в документации какого-либо вендора. Microsoft Foundry со своей стороны отдельно рекомендует использовать red teaming (состязательное тестирование на уязвимости и вредные ответы) с человеком в контуре, а не полагаться только на автоматизированную оценку.
Если оценка встроена в конвейер AI-агентов, а не в единичный вызов модели, полезен практический курс ИИ-агенты для оптимизации бизнес-процессов, где разбирается мониторинг и отладка агентных систем целиком, включая точку, где в конвейер встраивается LLM-судья.
LLM-судья на локальных моделях
Демо строится на локальных моделях через Ollama (сервер для запуска LLM без обращения к внешнему API), без ключей и облачных провайдеров. Первый скрипт показывает single-answer grading, второй — pairwise comparison с проверкой на position bias.
Single-answer grading по рубрике из четырёх критериев
Кандидатная модель qwen2.5:7b отвечает на вопрос про переобучение, а судья llama3.1:8b оценивает ответ по рубрике accuracy, completeness, clarity и safety, каждый критерий по шкале от 1 до 5, и возвращает JSON с итоговым баллом и текстовым обоснованием.
# ollama 0.6.2, модели qwen2.5:7b (кандидат) и llama3.1:8b (судья), прогнано на стенде 2026-08-27
"""
LLM-as-a-Judge: single-answer grading (reference-free).

Кандидатная модель отвечает на технический вопрос. Модель-судья не знает "эталонного"
ответа - она оценивает кандидатный ответ по явной рубрике (критерии + шкала) и возвращает
структурированный вердикт: оценку по каждому критерию, итоговый балл и обоснование словами.
Это и есть механизм LLM-as-a-Judge: рубрика + контент -> вердикт на естественном языке ->
парсинг в структуру.
"""
import json
import re

import ollama

CANDIDATE_MODEL = "qwen2.5:7b"
JUDGE_MODEL = "llama3.1:8b"

QUESTION = (
    "Объясни, что такое переобучение (overfitting) в машинном обучении "
    "и как с ним бороться. Дай 2-3 практических способа."
)

RUBRIC = """Ты - строгий технический рецензент. Оцени ответ ассистента на вопрос пользователя
по четырём критериям, каждый по шкале от 1 до 5:
- accuracy: фактическая точность (нет ошибок и вымышленных утверждений)
- completeness: полнота (вопрос раскрыт, даны практические способы, если просили)
- clarity: ясность изложения
- safety: нет вредных или вводящих в заблуждение рекомендаций

Верни СТРОГО JSON без пояснений вне JSON, в формате:
{{"accuracy": , "completeness": , "clarity": , "safety": ,
 "total": , "verdict": ""}}

Вопрос пользователя:
{question}

Ответ ассистента для оценки:
{answer}
"""


def get_candidate_answer(question: str) -> str:
    response = ollama.chat(
        model=CANDIDATE_MODEL,
        messages=[{"role": "user", "content": question}],
    )
    return response["message"]["content"]


def judge_answer(question: str, answer: str) -> dict:
    prompt = RUBRIC.format(question=question, answer=answer)
    response = ollama.chat(
        model=JUDGE_MODEL,
        messages=[{"role": "user", "content": prompt}],
        options={"temperature": 0},
    )
    raw = response["message"]["content"]
    # судья иногда оборачивает JSON в текст или markdown-блок - вытаскиваем первую {...}
    match = re.search(r"\{.*\}", raw, re.DOTALL)
    if not match:
        return {"parse_error": True, "raw": raw}
    try:
        return json.loads(match.group(0))
    except json.JSONDecodeError:
        return {"parse_error": True, "raw": raw}


def main() -> None:
    print(f"Вопрос: {QUESTION}\n")

    answer = get_candidate_answer(QUESTION)
    print(f"--- Ответ кандидата ({CANDIDATE_MODEL}) ---")
    print(answer)
    print()

    verdict = judge_answer(QUESTION, answer)
    print(f"--- Вердикт судьи ({JUDGE_MODEL}) ---")
    print(json.dumps(verdict, ensure_ascii=False, indent=2))


if __name__ == "__main__":
    main()
Pairwise comparison и проверка на position bias
Второй скрипт сравнивает ответы сильной модели qwen2.5:7b и заметно более слабой квантованной qwen2.5:0.5b-instruct-q4_0 на один и тот же вопрос про индексы в базе данных. Судья сравнивает пару дважды, сначала в исходном порядке, затем с переставленными позициями ответов, и если победитель меняется вместе с позицией, а не с содержанием, скрипт сообщает об обнаруженном position bias.
# ollama 0.6.2, модели qwen2.5:7b и qwen2.5:0.5b-instruct-q4_0 (кандидаты),
# llama3.1:8b (судья), прогнано на стенде 2026-08-27
"""
LLM-as-a-Judge: pairwise comparison и демонстрация position bias.

Два кандидата разного размера (сильная модель 7B и слабая квантованная 0.5B) отвечают
на один вопрос. Судья сравнивает пару ответов и называет победителя. Затем сравнение
прогоняется ПОВТОРНО с переставленным порядком ответов в промпте (A и B меняются
местами) - если победитель меняется вместе с порядком, а не с содержанием, это и есть
задокументированный position bias LLM-судей.
"""
import re

import ollama

STRONG_MODEL = "qwen2.5:7b"
WEAK_MODEL = "qwen2.5:0.5b-instruct-q4_0"
JUDGE_MODEL = "llama3.1:8b"

QUESTION = "Что такое индекс в базе данных и зачем он нужен?"

PAIRWISE_PROMPT = """Ты - судья, сравнивающий два ответа на один вопрос пользователя.
Определи, какой ответ лучше по точности, полноте и ясности.

Первая строка ответа должна содержать РОВНО ОДНО из трёх слов после "WINNER: " -
либо A, либо B, либо tie (без кавычек, без вертикальных черт, без перечисления
вариантов). Пример правильной первой строки: "WINNER: A".
Затем с новой строки одно предложение обоснования.

Вопрос: {question}

Ответ A:
{answer_a}

Ответ B:
{answer_b}
"""


def get_answer(model: str, question: str) -> str:
    response = ollama.chat(model=model, messages=[{"role": "user", "content": question}])
    return response["message"]["content"]


def judge_pair(question: str, answer_a: str, answer_b: str) -> str:
    prompt = PAIRWISE_PROMPT.format(question=question, answer_a=answer_a, answer_b=answer_b)
    response = ollama.chat(
        model=JUDGE_MODEL,
        messages=[{"role": "user", "content": prompt}],
        options={"temperature": 0},
    )
    return response["message"]["content"]


def extract_winner(verdict_text: str) -> str:
    # ищем строку вида "WINNER: A" целиком - если судья дословно повторил шаблон
    # с вариантами через "|", это не валидный вердикт, а сбой формата
    match = re.search(r"^WINNER:\s*(A|B|tie)\s*$", verdict_text, re.IGNORECASE | re.MULTILINE)
    return match.group(1).upper() if match else "не распознано (сбой формата у судьи)"


def main() -> None:
    print(f"Вопрос: {QUESTION}\n")

    strong_answer = get_answer(STRONG_MODEL, QUESTION)
    weak_answer = get_answer(WEAK_MODEL, QUESTION)
    print(f"--- Ответ сильной модели ({STRONG_MODEL}) ---\n{strong_answer}\n")
    print(f"--- Ответ слабой модели ({WEAK_MODEL}) ---\n{weak_answer}\n")

    # прогон 1: сильная модель на позиции A, слабая на позиции B
    verdict_1 = judge_pair(QUESTION, strong_answer, weak_answer)
    winner_1 = extract_winner(verdict_1)
    print("--- Сравнение 1: A=сильная, B=слабая ---")
    print(verdict_1)
    print(f"Победитель по позиции: {winner_1}")
    print()

    # прогон 2: те же ответы, позиции переставлены
    verdict_2 = judge_pair(QUESTION, weak_answer, strong_answer)
    winner_2 = extract_winner(verdict_2)
    print("--- Сравнение 2: A=слабая, B=сильная (позиции переставлены) ---")
    print(verdict_2)
    print(f"Победитель по позиции: {winner_2}")
    print()

    # приводим оба вердикта к "какая модель победила" независимо от позиции в промпте
    model_winner_1 = {"A": "сильная", "B": "слабая", "TIE": "tie"}.get(winner_1, winner_1)
    model_winner_2 = {"A": "слабая", "B": "сильная", "TIE": "tie"}.get(winner_2, winner_2)
    print(f"Итог: прогон 1 -> {model_winner_1} модель, прогон 2 -> {model_winner_2} модель")
    if model_winner_1 != model_winner_2:
        print("POSITION BIAS ОБНАРУЖЕН: вердикт сменился вместе с позицией, а не с содержанием.")
    else:
        print("Position bias не проявился: вердикт устойчив к перестановке позиций.")


if __name__ == "__main__":
    main()
Ключевые строки реального вывода собраны здесь, числа взяты из run_output.txt побуквенно.
# ключевые строки run_output.txt, прогон на стенде 2026-08-27
--- Вердикт судьи (llama3.1:8b) ---
{
  "accuracy": 5,
  "completeness": 5,
  "clarity": 5,
  "safety": 5,
  "total": 20,
  "verdict": "Ответ точно и полно описывает переобучение в машинном обучении, включая его
  причины и способы борьбы. Предложенные методы (увеличение объема данных, регуляризация и
  кросс-валидация) являются практическими и эффективными способами предотвращения переобучения."
}

--- Сравнение 1: A=сильная, B=слабая ---
WINNER: A
Победитель по позиции: A

--- Сравнение 2: A=слабая, B=сильная (позиции переставлены) ---
WINNER: B
Победитель по позиции: B

Итог: прогон 1 -> сильная модель, прогон 2 -> сильная модель
Position bias не проявился: вердикт устойчив к перестановке позиций.
На этой конкретной паре вопрос-ответы position bias не проявился, оба прогона отдали победу сильной модели независимо от порядка. Это тоже честный результат: bias систематический и статистический, а не гарантированный на каждом отдельном запросе, поэтому проверку на нём проводят на наборе вопросов, а не на одном примере. Отдельно всплыла чувствительность к формату инструкции, упомянутая в разделе про ограничения выше. Первая версия промпта задавала формат ответа судьи через вертикальные черты, и llama3.1:8b в части прогонов дословно копировала шаблон вместо того, чтобы выбрать вариант, помогла явная инструкция без спецсимволов и пример правильной строки. Полный прогон обоих скриптов на стенде занял 2 минуты 19 секунд, включая холодную загрузку моделей.
Заключение
LLM-as-a-Judge не заменяет ни классические метрики, ни экспертную разметку, а закрывает средний слой между ними, оценку открытых задач без единственно верного ответа, в масштабе, недоступном человеку, но с обоснованием, недоступным голому числу. Работающая система оценки держит рубрику зафиксированной, проверяет судью на position bias и verbosity bias хотя бы один раз перед продакшном и оставляет человека на калибровке критериев и на выборочном аудите. Судья, которому доверяют вслепую, рано или поздно подтвердит собственную ошибку с той же уверенностью, с какой хвалит хороший ответ.
Референсные ссылки
- arXiv, LLMs-as-Judges: A Comprehensive Survey on LLM-based Evaluation Methods, определение метода, структура области, общий механизм.
- Microsoft Learn, Evaluation approach for generative AI, архитектура evaluator’ов, сценарии по стадиям жизненного цикла.
- arXiv, Justice or Prejudice? Quantifying Biases in LLM-as-a-Judge, систематические предвзятости судей.
- ACM, Limitations of the LLM-as-a-Judge Approach for Evaluating LLM Outputs in Expert Knowledge Tasks, ограничения в задачах, требующих экспертизы.