
 11
Содержание
- Что такое HNSW и какую задачу решает
- Архитектура многослойного графа
- Слои и вложенные подмножества
- Связи и параметр M
- Принцип работы поиска и вставки
- Параметры M, efConstruction и efSearch
- Слабые места HNSW
- Фильтрация после обхода графа
- Удаления, память и перестройка
- HNSW против IVF и полного перебора
- Когда применять HNSW и когда нет
- Практика на hnswlib и FAISS
- Стенд и данные
- Уровни графа на 100 тысячах векторов
- Recall и латентность при росте efSearch
- Цена параметра M
- Фильтр после поиска против фильтра внутри обхода
- Удаление пометкой
- Заключение
- Референсные ссылки
HNSW (Hierarchical Navigable Small World, иерархический навигируемый малый мир) это графовый алгоритм приближённого поиска ближайших соседей (Approximate Nearest Neighbor, ANN), который раскладывает векторы по вложенным слоям графа близости и ищет k ближайших к запросу, спускаясь по слоям сверху вниз и вычисляя расстояния лишь до малой доли базы. Алгоритм описали Yury Malkov (Юрий Мальков) и Dmitry Yashunin (Дмитрий Яшунин), авторы статьи Efficient and robust approximate nearest neighbor search using Hierarchical Navigable Small World graphs на arXiv 2016 года и эталонной библиотеки hnswlib. Сегодня HNSW реализован в расширении PostgreSQL pgvector, векторных базах данных Qdrant и Milvus и в библиотеке FAISS от Meta.
Практика ниже воспроизведена на hnswlib 0.8.0 и faiss-cpu 1.15.1, поведение pgvector 0.8.7 и Qdrant описано по официальной документации.
Что такое HNSW и какую задачу решает
Задача поиска k ближайших соседей (k-nearest neighbors, kNN) звучит просто. Есть миллион эмбеддингов и вектор запроса, нужно вернуть десять самых близких. Точный перебор (brute force) считает расстояние до каждого вектора базы, и его цена растёт линейно с её размером. В прогоне к статье перебор по 100 000 векторов размерности 128 занял 5.872 мс на запрос, и на десятках миллионов векторов такой бюджет уже не сходится.
ANN-индексы меняют часть точности на скорость. Мерой точности служит recall@k, доля настоящих k ближайших соседей, которые нашёл индекс. HNSW относится к графовым ANN-индексам. Каждый вектор становится вершиной, рёбра соединяют близкие векторы, а поиск идёт по рёбрам в сторону запроса и не трогает основную массу базы. В аннотации статьи авторы называют главным свойством логарифмический рост сложности поиска с ростом данных, и его дают слои графа с разным масштабом связей.
Архитектура многослойного графа
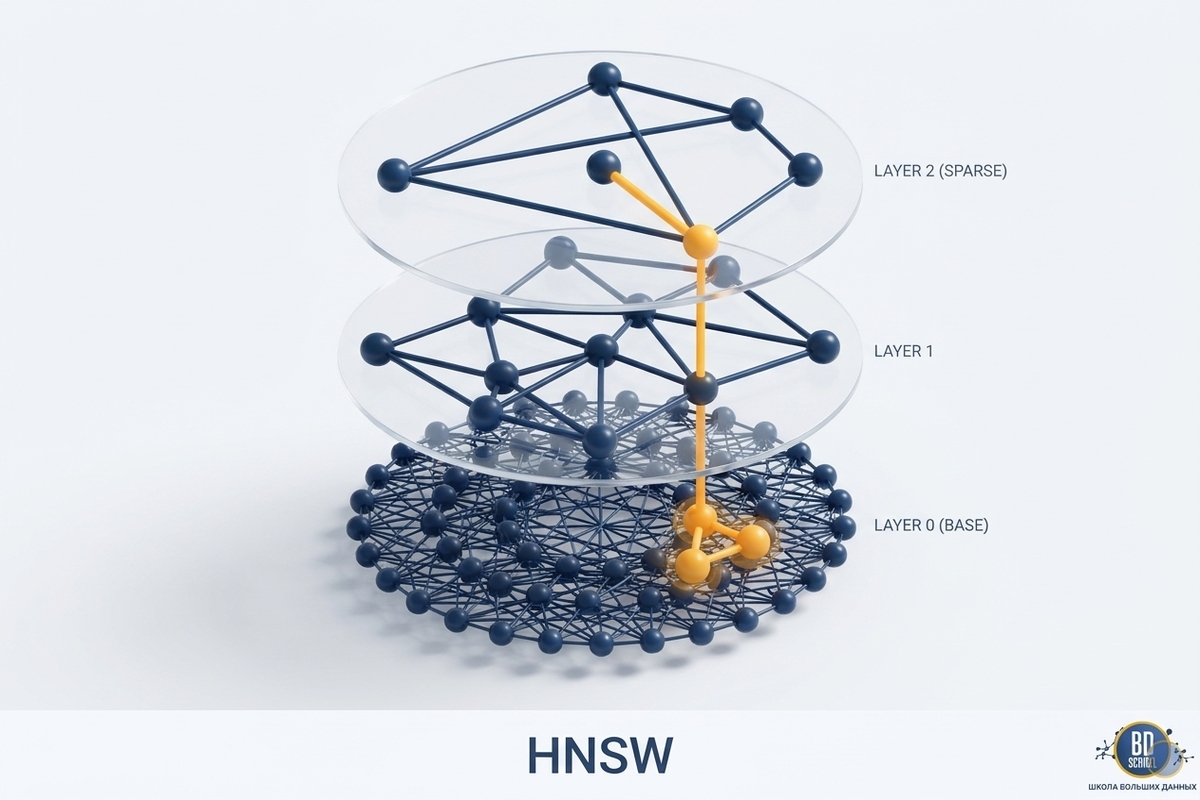
Граф HNSW устроен как стопка слоёв. Нулевой слой содержит все векторы, каждый следующий содержит подмножество предыдущего, а самый верхний обычно состоит из одного вектора, точки входа для любого поиска.
Слои и вложенные подмножества
Верхний слой для каждого нового вектора выбирается случайно, и вероятность попасть выше убывает экспоненциально. Поэтому большинство векторов живёт только на нулевом слое, а до верхнего слоя добираются единицы. Yury Malkov и Dmitry Yashunin сравнивают структуру со списком с пропусками (skip list), где верхние уровни дают длинные прыжки через данные, а нижние уточняют положение.
FAISS отдаёт это распределение в поле assign_probas. При M = 16 вероятность того, что верхним слоем вектора станет слой l, равна (1 — 1/M)·M^-l, то есть нормирующий множитель распределения уровней, в статье он обозначен mL, равен 1/ln(M). Именно это значение статья называет оптимальным, и каждый слой выходит примерно в 16 раз меньше предыдущего. В прогоне на 100 000 векторов на слоях 0-2 фактические числа совпали с ожиданием с точностью до нескольких процентов, а на верхних слоях, где векторов десятки и единицы, разброс больше, 19 против ожидаемых 22.9 и 1 против 1.4.
Связи и параметр M
Параметр M задаёт максимальное число соседей вершины на слое. В README hnswlib он описан как максимальное число исходящих связей, которое сильно влияет на расход памяти. На нулевом слое связей разрешено больше, потому что там лежат все векторы и от связности этого слоя зависит, найдёт ли поиск настоящих соседей. В FAISS 1.15.1 при M = 16 метод nb_neighbors вернул 32 соседа для нулевого слоя и 16 для слоёв выше.
Таблица индексов FAISS складывает размер вектора в HNSW из координат float32, 4·d байт, и слагаемого, пропорционального M. Иначе говоря, граф всегда занимает память сверх самих векторов.
Принцип работы поиска и вставки
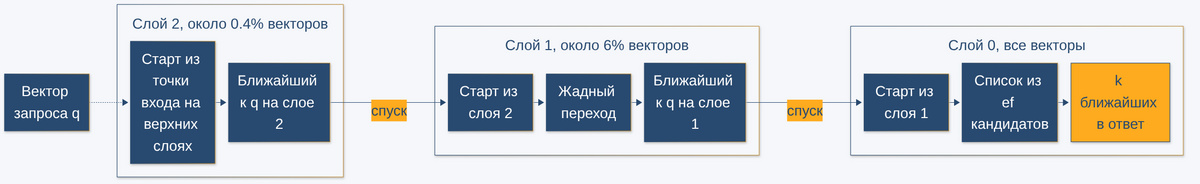
Поиск начинается в точке входа на верхнем слое. На каждом слое выше нулевого алгоритм идёт жадно, а именно переходит к соседу, который ближе к запросу, пока такой находится, и держит одного кандидата. Найденный локальный минимум становится стартом на слое ниже. На нулевом слое поиск ведёт динамический список из ef кандидатов, раз за разом раскрывает ближайшего непросмотренного и останавливается, когда тот оказывается дальше самого дальнего в списке. Наружу уходят k лучших, поэтому README hnswlib требует, чтобы ef был больше k. При efSearch = 40 поиск FAISS в прогоне вычислил расстояния в среднем до 854 векторов из 100 000, меньше 1% базы.
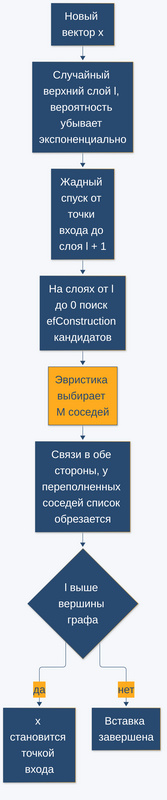
Вставка нового вектора повторяет поиск. Вектору случайно выбирается верхний слой l, затем от точки входа идёт жадный спуск до слоя l + 1. Со слоя l до нулевого на каждом слое ищутся efConstruction кандидатов, из них выбираются M соседей, и связи добавляются в обе стороны. Если у соседа связей стало больше лимита, его список обрезается той же эвристикой. На нулевом слое лимит выше, в статье он задан отдельным параметром, а в FAISS 1.15.1 равен 2M. Когда l выше текущего верхнего слоя графа, новый вектор становится точкой входа.
Соседи выбираются не просто как M ближайших. Эвристика берёт кандидата, только если он ближе к новому вектору, чем к любому уже выбранному соседу. Так у вершины остаются связи в разные стороны, в том числе мосты к соседним кластерам. По аннотации статьи именно эта эвристика улучшает результат на кластеризованных данных и при высоком recall.
Параметры M, efConstruction и efSearch
Все три параметра торгуют точностью против времени или памяти. В pgvector они называются m, ef_construction и hnsw.ef_search, в hnswlib M, ef_construction и set_ef, в FAISS efConstruction и efSearch.
| Параметр | На что влияет | Цена роста | Когда задаётся | Умолчание pgvector 0.8.7 | Умолчание hnswlib 0.8.0 и FAISS 1.15.1 |
|---|---|---|---|---|---|
| M | Связность графа и recall | Память графа и время сборки | При сборке индекса | 16 | hnswlib 16, в FAISS задаётся в конструкторе |
| efConstruction | Качество найденных при вставке соседей | Время сборки | При сборке индекса | 64 | hnswlib 200, FAISS 40 |
| efSearch | Recall запроса | Латентность запроса | На каждый запрос, без перестройки | 40 | FAISS 16, в hnswlib задаётся set_ef |
В прогоне рост ef с 10 до 320 поднял recall@10 с 0.7906 до 1.0000, а латентность с 0.055 до 0.825 мс. Рост M с 16 до 64 добавил к recall меньше трёх сотых, зато граф вырос в 3.6 раза. Поэтому M и efConstruction ставят один раз с запасом, а точность подбирают через efSearch, который меняется без перестройки индекса.
Такой компромисс между точностью, латентностью и памятью это архитектурное решение, и его место среди компонентов ML-системы разбирают на курсе Архитектура ML систем.
Архитектура ML-систем
Код курса
ARML
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24/32 ак.часов
Стоимость обучения
76 800
Слабые места HNSW
У графа проблемы начинаются, когда к поиску по близости добавляется условие на атрибуты, когда данные удаляются и когда граф перестаёт помещаться в память.
Фильтрация после обхода графа
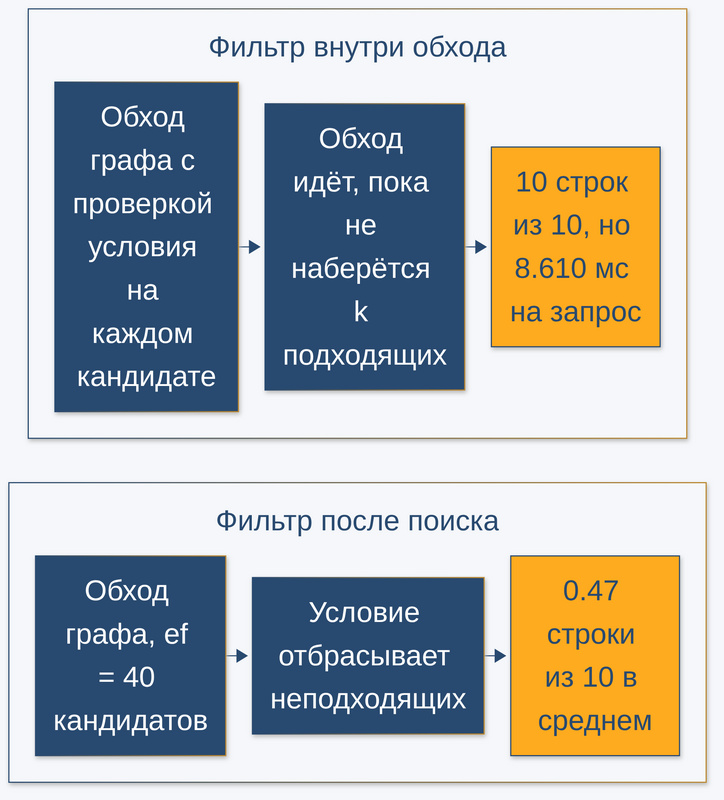
Граф ничего не знает об атрибутах строк. В простейшем случае индекс отдаёт ef ближайших кандидатов, и только потом условие WHERE выкидывает неподходящих. README pgvector приводит пример, где условию соответствует 10% строк, а при hnsw.ef_search = 40 в среднем остаётся около четырёх строк. В прогоне фильтр пропускал 1.08% векторов, и из десяти строк в среднем вернулось 0.47.
В pgvector с версии 0.8.0 параметр hnsw.iterative_scan со значениями strict_order или relaxed_order заставляет индекс продолжать обход, пока не наберётся достаточно строк или пока не будет просмотрено hnsw.max_scan_tuples кортежей, по умолчанию 20 000. Для очень избирательных условий README советует обычный индекс по колонке фильтра или частичные индексы. Qdrant строит фильтро-осведомлённый HNSW (filterable HNSW) с дополнительными рёбрами по значениям payload-индекса (payload в Qdrant это атрибуты точки, которые хранятся рядом с вектором), но они появляются, только если payload-индекс создан до построения графа.
В hnswlib условие можно передать внутрь обхода параметром filter у knn_query. Ответ тогда полный, но при 1% подходящих поиск оказался медленнее полного перебора, потому что граф долго бродит по неподходящим вершинам.
Удаления, память и перестройка
Удалить вершину из графа честно нельзя, через неё проходят пути к другим вершинам. Поэтому hnswlib помечает удалённое методом mark_deleted, элемент исчезает из выдачи, но место в индексе остаётся занятым, пока его не займёт новый вектор через add_items с replace_deleted=True. FAISS в документации прямо пишет, что HNSW не поддерживает удаление векторов, потому что это разрушило бы структуру графа.
README pgvector предупреждает, что VACUUM по HNSW-индексу может идти долго, и советует сначала выполнить REINDEX INDEX CONCURRENTLY. Сборка идёт заметно быстрее, когда граф помещается в maintenance_work_mem. Тип vector индексируется до 2000 измерений, halfvec до 4000.
HNSW против IVF и полного перебора
Главный соперник HNSW это IVF (Inverted File Index), в pgvector он называется IVFFlat. IVF кластеризует векторы методом k-means на списки (lists) и при поиске просматривает несколько ближайших списков целиком. Сравнение собрано по README pgvector и прогону.
| Критерий | Полный перебор | IVFFlat | HNSW |
|---|---|---|---|
| Фаза обучения | Нет | Есть, k-means по данным, индекс строят после загрузки хотя бы части таблицы | Нет, индекс можно создать на пустой таблице |
| Время сборки | Нет сборки | Быстрее, чем у HNSW | Дольше, 20.4 с на 100 000 векторов при M = 16 в 4 потока |
| Память сверх векторов | Нет | Меньше, чем у HNSW | 14.2 МБ при M = 16 и 50.7 МБ при M = 64 на 48.8 МБ векторов |
| Скорость и recall | Recall 1.0, 5.872 мс на запрос | Хуже соотношение скорости и recall, чем у HNSW | Recall@10 0.9644 за 0.136 мс при ef = 40 |
Таким образом, HNSW выигрывает по скорости при высоком recall и не требует обучения, а платит временем сборки и памятью графа.
Когда применять HNSW и когда нет
Выбор индекса сводится к профилю нагрузки и бюджету памяти:
- Онлайн-поиск с низкой латентностью. Семантический поиск, рекомендации и retrieval в RAG, где на запрос есть миллисекунды, а recall около 0.95-0.99 устраивает продукт.
- Данные дописываются постоянно. Вставка в граф инкрементальная и не требует обучать кластеры заново.
- Маленькая коллекция. На тысячах векторов точный перебор даёт recall 1.0 за приемлемое время, а граф только добавляет память.
- Жёсткий бюджет памяти. При M = 64 граф в прогоне занял больше самих векторов, 50.7 МБ против 48.8 МБ.
- Очень избирательные фильтры. Фильтр после обхода графа теряет строки, а фильтр внутри обхода в прогоне проиграл даже полному перебору.
Первые два пункта говорят за HNSW, остальные три за то, чтобы сначала померить точный перебор. Как выбор выглядит на конкретных системах, разобрано в материале Выбор векторной базы без лишней сложности.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Практика на hnswlib и FAISS
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Стенд это Ubuntu 24.04.4 LTS на 4 vCPU, Python 3.12.3, hnswlib 0.8.0, faiss-cpu 1.15.1 и numpy 2.5.4 без GPU. Прогон пяти сценариев идёт около 4.5 минут, пик памяти 418 МБ. Индекс строится в 4 потока, поиск идёт в один.
Стенд и данные
Под Python 3.12 у hnswlib 0.8.0 нет готового колеса, pip собирает его из исходников, поэтому нужен компилятор C++.
# requirements.txt, пины по факту установки на стенде 2026-11-06
hnswlib==0.8.0
faiss-cpu==1.15.1
numpy==2.5.4
# Python 3.12.3, Ubuntu 24.04.4 LTS, прогнано на стенде 2026-11-06
python3 -m venv .venv
.venv/bin/pip install -r requirements.txt
.venv/bin/python data.py            # данные и эталон, кэшируются в data_cache.npz
.venv/bin/python hnsw_demo.py all   # или один сценарий: levels, ef_sweep, m_sweep, filter, delete
Файл data.py генерирует смесь 200 гауссовых кластеров во внутреннем пространстве из 32 измерений и разворачивает её в 128 случайной проекцией с шумом. Равномерный шум в 128 измерениях это худший случай для графа и на эмбеддинги не похож. Атрибут category от 0 до 99 случаен и нужен для фильтрации, эталон top-10 считается точным перебором. На реальных эмбеддингах цифры recall будут другими.
# numpy 2.5.4, Python 3.12.3, прогнано на стенде 2026-11-06
"""Синтетические данные и эталон для демо HNSW.

Векторы берутся из смеси гауссовых кластеров, а не из равномерного шума: равномерный шум в
128 измерениях это худший случай для любого графового индекса и на эмбеддинги не похож.
Кластеры живут в пространстве из LATENT измерений и линейно разворачиваются в DIM с небольшим
шумом: у реальных эмбеддингов внутренняя размерность тоже заметно меньше номинальной.
Эталон считается точным перебором, по нему меряется recall приближённого поиска.
Результат кэшируется в data_cache.npz рядом с файлом, повторный запуск берёт кэш.
"""
from pathlib import Path
import time

import numpy as np

N = 100_000          # векторов в индексе
DIM = 128            # размерность
N_QUERIES = 1_000    # запросов
N_CLUSTERS = 200     # кластеров в смеси
LATENT = 32          # внутренняя размерность данных
N_CATEGORIES = 100   # значения атрибута для фильтра: одна категория это около 1% векторов
K = 10               # сколько соседей ищем
SEED = 42
CACHE = Path(__file__).resolve().parent / "data_cache.npz"


def _mixture(rng, centers, proj, n):
    """n точек: случайный центр плюс шум в латентном пространстве, проекция в DIM и шум сверху."""
    labels = rng.integers(0, len(centers), size=n)
    latent = centers[labels] + rng.normal(0.0, 1.0, size=(n, LATENT))
    points = latent @ proj + rng.normal(0.0, 0.1, size=(n, DIM))
    return points.astype(np.float32)


def exact_knn(base, queries, k, subset=None, chunk=100):
    """Точный kNN полным перебором по квадрату L2. subset ограничивает поиск номерами векторов."""
    ids = np.arange(len(base)) if subset is None else np.asarray(subset)
    vectors = base[ids]
    norms = (vectors ** 2).sum(axis=1)
    result = np.empty((len(queries), k), dtype=np.int64)
    for start in range(0, len(queries), chunk):
        q = queries[start:start + chunk]
        # |q - x|^2 = |q|^2 - 2 q·x + |x|^2, слагаемое |q|^2 на порядок не влияет
        dist = norms[None, :] - 2.0 * q @ vectors.T
        top = np.argpartition(dist, k, axis=1)[:, :k]
        order = np.take_along_axis(dist, top, axis=1).argsort(axis=1)
        result[start:start + chunk] = ids[np.take_along_axis(top, order, axis=1)]
    return result


def load():
    """Возвращает словарь: base, queries, category, gt (эталон top-K на всей базе)."""
    if CACHE.exists():
        data = np.load(CACHE)
        return {name: data[name] for name in data.files}
    rng = np.random.default_rng(SEED)
    # центры разнесены так, что соседние кластеры частично перекрываются
    centers = rng.normal(0.0, 1.0, size=(N_CLUSTERS, LATENT))
    proj = rng.normal(0.0, 1.0 / np.sqrt(LATENT), size=(LATENT, DIM))
    base = _mixture(rng, centers, proj, N)
    queries = _mixture(rng, centers, proj, N_QUERIES)
    # атрибут для фильтра не связан с геометрией: соседи по вектору не обязаны совпадать по категории
    category = rng.integers(0, N_CATEGORIES, size=N).astype(np.int32)
    t0 = time.perf_counter()
    gt = exact_knn(base, queries, K)
    print(f"эталон точным перебором numpy: {N_QUERIES} запросов по {N} векторов "
          f"за {time.perf_counter() - t0:.1f} с")
    np.savez(CACHE, base=base, queries=queries, category=category, gt=gt)
    return {"base": base, "queries": queries, "category": category, "gt": gt}


def recall_at_k(found, truth):
    """Средняя доля истинных K соседей, которые нашёл приближённый поиск."""
    hits = [len(set(f) & set(t)) / len(t) for f, t in zip(found, truth)]
    return float(np.mean(hits))


if __name__ == "__main__":
    d = load()
    print({name: arr.shape for name, arr in d.items()})
# вывод прогона на стенде 2026-11-06, hnswlib 0.8.0, faiss-cpu 1.15.1, фрагмент run_output.txt
$ .venv/bin/python data.py
эталон точным перебором numpy: 1000 запросов по 100000 векторов за 1.1 с
{'base': (100000, 128), 'queries': (1000, 128), 'category': (100000,), 'gt': (1000, 10)}
Файл hnsw_demo.py собирает все пять сценариев, их выбирает аргумент командной строки.
# hnswlib 0.8.0, faiss-cpu 1.15.1, numpy 2.5.4, Python 3.12.3, прогнано на стенде 2026-11-06
"""Демо HNSW: уровни графа, компромисс efSearch, цена M, фильтрация и удаления.

Запуск: python hnsw_demo.py all|levels|ef_sweep|m_sweep|filter|delete
Сборка индекса идёт в BUILD_THREADS потоков, поиск всегда в один поток,
чтобы латентность запроса не зависела от числа ядер.
"""
import os
import sys
import tempfile
import time
from collections import Counter

import faiss
import hnswlib
import numpy as np

import data

BUILD_THREADS = 4
K = data.K


def build_hnswlib(base, M=16, ef_construction=200, allow_replace_deleted=False):
    """Строит индекс hnswlib и возвращает его вместе со временем сборки в секундах."""
    index = hnswlib.Index(space="l2", dim=base.shape[1])
    index.init_index(max_elements=len(base), M=M, ef_construction=ef_construction,
                     random_seed=100, allow_replace_deleted=allow_replace_deleted)
    t0 = time.perf_counter()
    index.add_items(base, np.arange(len(base)), num_threads=BUILD_THREADS)
    return index, time.perf_counter() - t0


def timed_query(index, queries, k=K, **kwargs):
    """Поиск в один поток: метки и средняя латентность одного запроса в миллисекундах."""
    t0 = time.perf_counter()
    labels, _ = index.knn_query(queries, k=k, num_threads=1, **kwargs)
    return labels, (time.perf_counter() - t0) / len(queries) * 1e3


def file_size_mb(index):
    """Размер индекса на диске после save_index, в мегабайтах."""
    with tempfile.TemporaryDirectory() as tmp:
        path = os.path.join(tmp, "index.bin")
        index.save_index(path)
        return os.path.getsize(path) / 2**20


def levels(d):
    """FAISS IndexHNSWFlat: сколько векторов живёт на каждом слое и сколько расстояний считает поиск."""
    M = 16
    base, queries, gt = d["base"], d["queries"], d["gt"]
    index = faiss.IndexHNSWFlat(data.DIM, M)
    index.hnsw.efConstruction = 200
    faiss.omp_set_num_threads(BUILD_THREADS)
    t0 = time.perf_counter()
    index.add(base)
    print(f"IndexHNSWFlat M={M}, efConstruction=200: {index.ntotal} векторов за "
          f"{time.perf_counter() - t0:.1f} с")
    hnsw = index.hnsw
    print(f"соседей на слое 0: {hnsw.nb_neighbors(0)}, на слоях выше: {hnsw.nb_neighbors(1)}")

    # levels хранит для каждого вектора число слоёв, в которых он есть: верхний слой плюс один
    top_layer = faiss.vector_to_array(hnsw.levels) - 1
    counts = Counter(top_layer.tolist())
    probas = faiss.vector_to_array(hnsw.assign_probas)
    print(f"верхний слой графа max_level = {hnsw.max_level}, "
          f"точка входа: вектор {hnsw.entry_point}, его верхний слой {top_layer[hnsw.entry_point]}")
    print("верхний слой | векторов | доля     | ожидание (1-1/M)*M^-l | есть на слое (снизу вверх)")
    present = len(top_layer)
    for layer in range(hnsw.max_level + 1):
        n = counts.get(layer, 0)
        expected = probas[layer] * len(top_layer) if layer < len(probas) else 0.0
        print(f"{layer:12d} | {n:8d} | {n / len(top_layer):8.5f} | {expected:21.1f} | {present}")
        present -= n

    # сколько расстояний реально считает поиск: счётчик FAISS по всем запросам
    faiss.omp_set_num_threads(1)
    print("efSearch | recall@10 | расстояний на запрос | доля базы | мс/запрос")
    for ef in (16, 40, 160):
        hnsw.efSearch = ef
        faiss.cvar.hnsw_stats.reset()
        t0 = time.perf_counter()
        _, found = index.search(queries, K)
        ms = (time.perf_counter() - t0) / len(queries) * 1e3
        ndis = faiss.cvar.hnsw_stats.ndis / len(queries)
        print(f"{ef:8d} | {data.recall_at_k(found, gt):9.4f} | {ndis:20.0f} | "
              f"{ndis / len(base):9.4f} | {ms:.3f}")


def ef_sweep(d):
    """hnswlib M=16: recall@10 и латентность при росте ef, рядом точный перебор."""
    base, queries, gt = d["base"], d["queries"], d["gt"]
    index, build_s = build_hnswlib(base, M=16, ef_construction=200)
    print(f"hnswlib M=16, ef_construction=200: сборка {build_s:.1f} с в {BUILD_THREADS} потока")

    # эталон скорости: точный перебор FAISS IndexFlatL2, по одному запросу в один поток
    faiss.omp_set_num_threads(1)
    flat = faiss.IndexFlatL2(data.DIM)
    flat.add(base)
    t0 = time.perf_counter()
    for q in queries:
        flat.search(q[None, :], K)
    flat_ms = (time.perf_counter() - t0) / len(queries) * 1e3
    print(f"точный перебор IndexFlatL2: recall@10 = 1.0000, {flat_ms:.3f} мс/запрос")

    print("ef  | recall@10 | мс/запрос | быстрее перебора")
    for ef in (10, 20, 40, 80, 160, 320):
        index.set_ef(ef)
        labels, ms = timed_query(index, queries)
        print(f"{ef:3d} | {data.recall_at_k(labels, gt):9.4f} | {ms:9.3f} | {flat_ms / ms:6.1f}x")


def m_sweep(d):
    """Цена M: время сборки, размер индекса и recall при фиксированных ef_construction и ef."""
    base, queries, gt = d["base"], d["queries"], d["gt"]
    raw_mb = base.nbytes / 2**20
    print(f"сырые векторы float32: {raw_mb:.1f} МБ; ef_construction=200, ef=40")
    print("M  | сборка, с | индекс, МБ | сверх векторов, МБ | recall@10 | мс/запрос")
    for M in (4, 8, 16, 32, 64):
        index, build_s = build_hnswlib(base, M=M, ef_construction=200)
        index.set_ef(40)
        labels, ms = timed_query(index, queries)
        size = file_size_mb(index)
        print(f"{M:2d} | {build_s:9.1f} | {size:10.1f} | {size - raw_mb:18.1f} | "
              f"{data.recall_at_k(labels, gt):9.4f} | {ms:.3f}")
        del index


def filter_demo(d):
    """Фильтр около 1%: отбор после поиска против фильтра внутри обхода графа."""
    base, queries, category = d["base"], d["queries"], d["category"]
    allowed_ids = np.flatnonzero(category == 0)
    allowed = set(allowed_ids.tolist())
    print(f"фильтр category == 0: подходит {len(allowed_ids)} из {len(base)} "
          f"({len(allowed_ids) / len(base):.2%})")
    # эталон для фильтра: точный перебор только среди подходящих векторов
    gt_f = data.exact_knn(base, queries, K, subset=allowed_ids)
    index, _ = build_hnswlib(base, M=16, ef_construction=200)

    print("стратегия                         | ef   | строк из 10, среднее | запросов с 10 | recall@10 | мс/запрос")
    # отбор после поиска: индекс отдаёт ef кандидатов, фильтр выкидывает неподходящие
    for ef in (40, 400, 2000):
        index.set_ef(ef)
        labels, ms = timed_query(index, queries, k=ef)
        rows = [[i for i in row if i in allowed][:K] for row in labels]
        got = np.array([len(r) for r in rows])
        rec = np.mean([len(set(r) & set(t)) / K for r, t in zip(rows, gt_f)])
        print(f"после поиска, взять ef кандидатов  | {ef:4d} | {got.mean():20.2f} | "
              f"{(got == K).sum():13d} | {rec:9.4f} | {ms:.3f}")
    # фильтр внутри обхода: hnswlib проверяет условие на каждом кандидате и идёт дальше
    for ef in (40, 400):
        index.set_ef(ef)
        labels, ms = timed_query(index, queries, filter=allowed.__contains__)
        got = np.array([len(row) for row in labels])
        print(f"внутри обхода (filter=)           | {ef:4d} | {got.mean():20.2f} | "
              f"{(got == K).sum():13d} | {data.recall_at_k(labels, gt_f):9.4f} | {ms:.3f}")
    # предфильтр: точный перебор только по подходящим векторам, без графа
    faiss.omp_set_num_threads(1)
    flat = faiss.IndexFlatL2(data.DIM)
    flat.add(base[allowed_ids])
    t0 = time.perf_counter()
    found = [allowed_ids[flat.search(q[None, :], K)[1][0]] for q in queries]
    ms = (time.perf_counter() - t0) / len(queries) * 1e3
    print(f"предфильтр: перебор {len(allowed_ids)} подходящих | —    | {K:20.2f} | "
          f"{len(queries):13d} | {data.recall_at_k(found, gt_f):9.4f} | {ms:.3f}")

    # сколько стоит сам колбэк Python: фильтр, который пропускает всё, против поиска без фильтра
    index.set_ef(40)
    _, plain_ms = timed_query(index, queries)
    _, cb_ms = timed_query(index, queries, filter=lambda label: True)
    print(f"цена колбэка при ef=40: без фильтра {plain_ms:.3f} мс, "
          f"filter=lambda: True {cb_ms:.3f} мс на запрос")


def delete_demo(d):
    """Удаление пометкой: помеченные не возвращаются, место в индексе не освобождается."""
    base, queries = d["base"], d["queries"]
    index, _ = build_hnswlib(base, M=16, ef_construction=200, allow_replace_deleted=True)
    index.set_ef(40)
    size_before = file_size_mb(index)
    deleted = np.arange(0, len(base), 10)          # каждый десятый вектор, 10%
    for label in deleted:
        index.mark_deleted(int(label))
    deleted_set = set(deleted.tolist())
    labels, _ = timed_query(index, queries)
    leaked = sum(1 for row in labels for i in row if i in deleted_set)
    alive = np.setdiff1d(np.arange(len(base)), deleted)
    gt_alive = data.exact_knn(base, queries, K, subset=alive)
    print(f"помечено удалёнными: {len(deleted)}; удалённых в выдаче: {leaked} из {labels.size}")
    print(f"recall@10 по живым векторам: {data.recall_at_k(labels, gt_alive):.4f}")
    print(f"элементов в индексе: {index.get_current_count()}, размер {size_before:.1f} -> "
          f"{file_size_mb(index):.1f} МБ")
    # новые векторы занимают слоты помеченных, индекс не растёт
    rng = np.random.default_rng(7)
    fresh = base[rng.choice(alive, size=len(deleted))] + 0.01
    index.add_items(fresh, np.arange(len(base), len(base) + len(fresh)), num_threads=BUILD_THREADS,
                    replace_deleted=True)
    print(f"после add_items(replace_deleted=True) на {len(fresh)} новых: элементов "
          f"{index.get_current_count()}, max_elements {index.get_max_elements()}, "
          f"размер {file_size_mb(index):.1f} МБ")


SCENARIOS = {"levels": levels, "ef_sweep": ef_sweep, "m_sweep": m_sweep,
             "filter": filter_demo, "delete": delete_demo}

if __name__ == "__main__":
    mode = sys.argv[1] if len(sys.argv) > 1 else "all"
    if mode != "all" and mode not in SCENARIOS:
        sys.exit(f"режим: all|{'|'.join(SCENARIOS)}")
    dataset = data.load()
    print(f"данные: {data.N} векторов, {data.DIM} измерений, {data.N_QUERIES} запросов, seed {data.SEED}")
    for name, func in SCENARIOS.items():
        if mode in ("all", name):
            print(f"\n===== {name} =====")
            t0 = time.perf_counter()
            func(dataset)
            print(f"--- {name}: {time.perf_counter() - t0:.1f} с")
Уровни графа на 100 тысячах векторов
FAISS IndexHNSWFlat открывает уровни каждого вектора и счётчик вычисленных расстояний.
# вывод прогона на стенде 2026-11-06, hnswlib 0.8.0, faiss-cpu 1.15.1, фрагмент run_output.txt
$ .venv/bin/python hnsw_demo.py levels
===== levels =====
IndexHNSWFlat M=16, efConstruction=200: 100000 векторов за 19.6 с
соседей на слое 0: 32, на слоях выше: 16
верхний слой графа max_level = 4, точка входа: вектор 20288, его верхний слой 4
верхний слой | векторов | доля     | ожидание (1-1/M)*M^-l | есть на слое (снизу вверх)
           0 |    93626 |  0.93626 |               93750.0 | 100000
           1 |     6003 |  0.06003 |                5859.4 | 6374
           2 |      351 |  0.00351 |                 366.2 | 371
           3 |       19 |  0.00019 |                  22.9 | 20
           4 |        1 |  0.00001 |                   1.4 | 1
efSearch | recall@10 | расстояний на запрос | доля базы | мс/запрос
      16 |    0.8810 |                  480 |    0.0048 | 0.081
      40 |    0.9678 |                  854 |    0.0085 | 0.154
     160 |    0.9992 |                 2460 |    0.0246 | 0.488
--- levels: 20.3 с
Точкой входа стал единственный вектор четвёртого слоя. При efSearch = 160 и recall 0.9992 поиск считает расстояния меньше чем до 2.5% базы.
Recall и латентность при росте efSearch
Индекс hnswlib с M = 16 против точного перебора FAISS IndexFlatL2 на тех же 1000 запросах.
# вывод прогона на стенде 2026-11-06, hnswlib 0.8.0, faiss-cpu 1.15.1, фрагмент run_output.txt
$ .venv/bin/python hnsw_demo.py ef_sweep
===== ef_sweep =====
hnswlib M=16, ef_construction=200: сборка 20.4 с в 4 потока
точный перебор IndexFlatL2: recall@10 = 1.0000, 5.872 мс/запрос
ef  | recall@10 | мс/запрос | быстрее перебора
 10 |    0.7906 |     0.055 |  106.4x
 20 |    0.9045 |     0.083 |   70.5x
 40 |    0.9644 |     0.136 |   43.1x
 80 |    0.9921 |     0.234 |   25.1x
160 |    0.9982 |     0.428 |   13.7x
320 |    1.0000 |     0.825 |    7.1x
--- ef_sweep: 28.2 с
Первые удвоения ef дают большой прирост recall почти даром, дальше каждая сотая стоит удвоения латентности. Кратности между двумя прогонами заметно плавали, их стоит читать как порядок величины.
Цена параметра M
Пять сборок при ef_construction = 200 и ef = 40, размер берётся с диска.
# вывод прогона на стенде 2026-11-06, hnswlib 0.8.0, faiss-cpu 1.15.1, фрагмент run_output.txt
$ .venv/bin/python hnsw_demo.py m_sweep
===== m_sweep =====
сырые векторы float32: 48.8 МБ; ef_construction=200, ef=40
M  | сборка, с | индекс, МБ | сверх векторов, МБ | recall@10 | мс/запрос
 4 |       9.7 |       54.0 |                5.2 |    0.7395 | 0.065
 8 |      13.7 |       56.9 |                8.1 |    0.9085 | 0.089
16 |      20.4 |       63.0 |               14.2 |    0.9644 | 0.133
32 |      27.4 |       75.2 |               26.3 |    0.9860 | 0.198
64 |      31.9 |       99.6 |               50.7 |    0.9907 | 0.267
--- m_sweep: 104.1 с
При M = 4 граф слишком разреженный. От M = 16 recall растёт медленно, а граф быстро, к M = 64 он вырос в 3.6 раза при сборке в 1.6 раза дольше. Латентность у M = 4 между прогонами разошлась почти вдвое, 0.104 и 0.065 мс, выводов по ней делать не стоит.
Фильтр после поиска против фильтра внутри обхода
Поиск только среди векторов с category = 0, это 1.08% базы.
# вывод прогона на стенде 2026-11-06, hnswlib 0.8.0, faiss-cpu 1.15.1, фрагмент run_output.txt
$ .venv/bin/python hnsw_demo.py filter
===== filter =====
фильтр category == 0: подходит 1078 из 100000 (1.08%)
стратегия                         | ef   | строк из 10, среднее | запросов с 10 | recall@10 | мс/запрос
после поиска, взять ef кандидатов  |   40 |                 0.47 |             0 |    0.0470 | 0.137
после поиска, взять ef кандидатов  |  400 |                 4.36 |            12 |    0.4355 | 1.058
после поиска, взять ef кандидатов  | 2000 |                10.00 |           998 |    0.9990 | 5.034
внутри обхода (filter=)           |   40 |                10.00 |          1000 |    1.0000 | 8.610
внутри обхода (filter=)           |  400 |                10.00 |          1000 |    1.0000 | 49.495
предфильтр: перебор 1078 подходящих | —    |                10.00 |          1000 |    1.0000 | 0.029
цена колбэка при ef=40: без фильтра 0.144 мс, filter=lambda: True 0.180 мс на запрос
--- filter: 85.2 с
Отбор после поиска набирает полный ответ только при ef = 2000, почти со скоростью перебора. Фильтр внутри обхода даёт recall 1.0, но медленнее перебора всей базы, и колбэк Python добавляет к этому лишь 0.036 мс. Предфильтр по 1078 векторам обгоняет обе стратегии с полным ответом больше чем на два порядка, поэтому README pgvector для таких условий и советует обычный индекс по колонке фильтра.
Удаление пометкой
Каждый десятый вектор помечается удалённым, затем слоты занимают новые векторы.
# вывод прогона на стенде 2026-11-06, hnswlib 0.8.0, faiss-cpu 1.15.1, фрагмент run_output.txt
$ .venv/bin/python hnsw_demo.py delete
===== delete =====
помечено удалёнными: 10000; удалённых в выдаче: 0 из 10000
recall@10 по живым векторам: 0.9686
элементов в индексе: 100000, размер 63.0 -> 63.0 МБ
после add_items(replace_deleted=True) на 10000 новых: элементов 100000, max_elements 100000, размер 63.0 МБ
--- delete: 30.1 с
Помеченные из выдачи исчезли, файл индекса не уменьшился, а 10 000 новых векторов встали на их место без роста индекса.
Заключение
HNSW это многослойный граф близости, по которому поиск спускается от разреженного верхнего слоя к плотному нижнему и находит соседей, просмотрев меньше процента базы. В работе обычно крутят только efSearch, а M и efConstruction задают при сборке. Слабые места известны, это фильтрация, удаления и память графа. Перед выбором HNSW стоит померить точный перебор, потому что на маленькой коллекции или при узком фильтре он может оказаться и точнее, и быстрее.