 44
Содержание
- Что такое семантический поиск и какую задачу он решает
- Архитектура и ключевые компоненты
- Эмбеддинги и векторное представление
- Векторный индекс и поиск по сходству
- Принцип работы
- Два значения термина у разных вендоров
- Ограничения и подводные камни
- Сценарии использования и когда семантический поиск не подходит
- Практика с примерами кода
- Заключение
- Референсные ссылки
Семантический поиск (semantic search) — это техника поиска, при которой релевантность результата определяется смыслом запроса, а не буквальным совпадением слов с текстом документа. Запрос и документы превращаются в векторные представления (embeddings), и система ищет ближайшие по смыслу векторы вместо точных совпадений строк. Термин активно используется в связке с большими языковыми моделями, потому что именно он лежит в основе retrieval-augmented generation (RAG) и баз знаний для чат-ботов.
Что такое семантический поиск и какую задачу он решает
Классический полнотекстовый поиск, например на основе алгоритма BM25, ищет документы по пересечению слов запроса и текста. Он отлично справляется с точными терминами, кодами и идентификаторами, но проваливается там, где запрос и документ говорят об одном и том же разными словами. Пользователь пишет «забыла кодовую фразу от профиля на сайте», а нужный документ в базе знаний называется «как сбросить пароль от личного кабинета». Ни одно слово не совпадает, и классический поиск такую пару не свяжет.
Семантический поиск решает именно эту проблему. Модель эмбеддингов переводит и запрос, и документы в числовые векторы так, что близкие по смыслу тексты оказываются рядом в векторном пространстве, даже если ни одно слово в них не совпадает. По документации OpenSearch основные сценарии применения — это RAG, conversational search и AI-чатботы, то есть инфраструктура для приложений поверх больших языковых моделей.
Архитектура и ключевые компоненты
Практическая реализация семантического поиска у разных вендоров различается в деталях, но опирается на общий набор компонентов — модель эмбеддингов, векторное хранилище и механизм поиска по сходству.
Эмбеддинги и векторное представление
Эмбеддинг это числовой вектор фиксированной размерности, который модель строит из текста так, чтобы расстояние между векторами отражало смысловую близость исходных текстов. OpenSearch поддерживает подключение моделей OpenAI, Cohere Embed, Amazon Bedrock и Amazon SageMaker через ingest-пайплайны с процессорами text embedding, text chunking и sparse encoding. Модель эмбеддингов может быть симметричной, когда запрос и документ обрабатываются одинаково, или асимметричной, как локальная модель nomic-embed-text, которой для корректного поиска нужен явный префикс задачи — «search_query» для запроса и «search_document» для текста в индексе. Программа курса «NLP с Python» разбирает построение таких векторных представлений слов и текста на алгоритмах word2vec и GloVe, а также векторизацию текста целиком через doc2vec.
Векторный индекс и поиск по сходству
Перебирать все документы и считать расстояние до каждого при миллионах записей нецелесообразно, поэтому векторные хранилища строят приближённый индекс ближайших соседей (approximate nearest neighbor, ANN). OpenSearch хранит эмбеддинги в отдельном типе поля k-NN vector, а Elastic использует тип поля semantic_text поверх модели ELSER (Elastic Learned Sparse EncodeR), которая автоматически разбивает длинный текст на пассажи перед индексацией. Точные параметры конкретного алгоритма ANN у каждого вендора не унифицированы и зависят от версии платформы, поэтому их стоит сверять с актуальной документацией перед внедрением. Устройство самих векторных баз данных, где чаще всего живёт такой индекс, подробно разобрано в статье «ИИ и векторные базы данных: как это работает?».
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Принцип работы
Механизм семантического поиска складывается из одного и того же пайплайна независимо от платформы. На этапе индексации документы проходят через модель эмбеддингов и сохраняются в векторном хранилище вместе с исходным текстом. На этапе запроса пользовательский текст точно так же превращается в вектор, и хранилище возвращает ближайшие по сходству документы, отсортированные по убыванию релевантности. Опциональный шаг реранжирования может дополнительно пересчитать порядок уже найденных результатов более тяжёлой моделью.
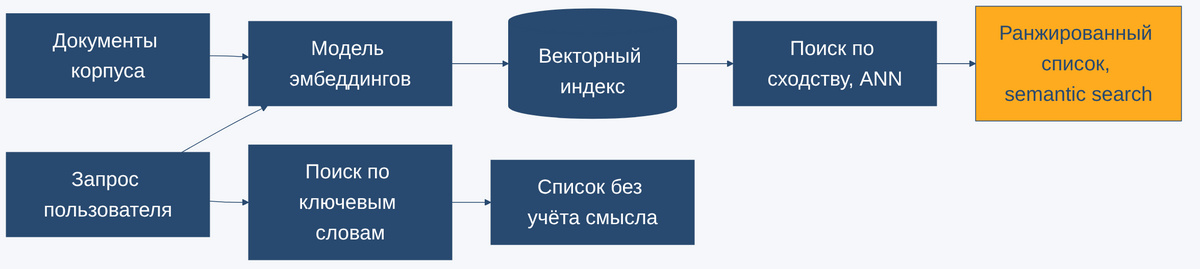
Демонстрация этого пайплайна на маленьком корпусе обращений в техподдержку разобрана в практическом разделе ниже.
Два значения термина у разных вендоров
У термина «семантический поиск» в индустрии закрепились два разных значения, и путать их опасно. У OpenSearch, Elastic и большинства платформ векторного поиска семантический поиск это основной механизм извлечения документов через эмбеддинги, полностью заменяющий или дополняющий классический полнотекстовый поиск. У Azure AI Search «semantic ranker» это вторичный слой переранжирования уже найденных результатов лексического поиска BM25 или гибридного поиска через RRF (reciprocal rank fusion, объединение нескольких ранжирований в одно). Документация Microsoft прямо предупреждает, что ранкер не может заново пройтись по всему корпусу в поисках семантически релевантных документов, он лишь переупорядочивает то, что уже нашёл первичный поиск.
| Параметр | OpenSearch / Elastic (retrieval) | Azure AI Search (reranking) |
|---|---|---|
| Роль в пайплайне | Первичный поиск по всему индексу | Переранжирование топ-50 результатов BM25 или RRF |
| Что на входе | Векторы запроса и всех документов | Уже отранжированный список кандидатов |
| Лимиты полей | 512 токенов на поле у ELSER | Сводная строка до 2048 токенов (лимит вырос с 256 в ноябре 2024) |
| Итоговый результат | Ранжированный список по векторному сходству | Скор от 0.0 до 4.0 плюс дословные captions и answers |
Azure строит финальную сводную строку из полей «title» и «keywords» с лимитом по 128 токенов каждое, остаток бюджета уходит на поле «content», а captions и answers это дословные извлечения из текста без генерации нового контента языковой моделью.
Ограничения и подводные камни
Семантический поиск не заменяет точный поиск везде. Он плохо подходит для запросов с идентификаторами, кодами ошибок, номерами версий и редкими техническими терминами, потому что модель эмбеддингов обучена на естественном языке и может не различить два разных артикула товара как несовпадающие сущности. По этой причине на практике почти всегда строят гибридный поиск, который комбинирует векторное сходство с классическим лексическим поиском и берёт лучшее из обоих подходов.
У каждой платформы есть жёсткие технические лимиты, о которых легко забыть при проектировании.
- Лимит токенов на чанк. ELSER у Elastic учитывает только первые 512 токенов каждого поля, более длинный текст нужно заранее разбивать на пассажи.
- Лимит числа чанков. Число фрагментов в поле semantic_text у Elastic ограничено настройкой index.mapping.nested_objects.limit, по умолчанию 10000.
- Лимит топ-N у реранкера. Azure переранжирует не более 50 документов из первичной выдачи, остальные результаты порядок не меняют.
- Только текст. Поле semantic_text у Elastic принимает исключительно текст, для изображений, аудио и видео нужен отдельный мультимодальный тип поля.
Ни один из этих лимитов не критичен сам по себе, но их совместное игнорирование превращает демо в продакшене в источник тихих потерь релевантности.
Сценарии использования и когда семантический поиск не подходит
Официальная документация Azure формулирует это прямо — языковые модели в semantic ranker лучше всего работают с насыщенным информацией, изложенным в виде прозы контентом, а база знаний, онлайн документация или описательные материалы получают наибольший выигрыш от такого поиска. Из документации OpenSearch и практики применения складывается схожий список сценариев.
- RAG для чат-ботов и ассистентов. Векторный поиск подтягивает релевантные фрагменты документации перед генерацией ответа языковой моделью.
- Поиск по базе знаний и тикетам поддержки. Пользователь формулирует проблему своими словами, а не терминами из документации.
- Поиск похожих обращений и дублей. Разные формулировки одной и той же проблемы группируются по смыслу.
Во всех трёх сценариях запрос и документ описывают одну и ту же проблему разными словами, и именно эту смысловую связь ищет семантический поиск.
Семантический поиск слабее там, где важна точность буквального совпадения, а не смысла. Поиск по артикулам, серийным номерам, точным датам или коротким keyword-подобным запросам лучше доверить обычному индексу или фильтру по точному значению, а не векторному сходству.
Практика с примерами кода
Ниже сравниваются два подхода на маленьком корпусе из восьми обращений в техподдержку. Запрос «Забыла свою кодовую фразу, попасть в свой профиль на сайте не получается» намеренно не делит ни одного слова с целевым документом «Не могу зайти в личный кабинет, забыл пароль». Эмбеддинги считает локальная модель nomic-embed-text через Ollama, 768 измерений, и здесь важен префикс задачи, потому что модель асимметричная.
# ollama 0.6.2, модель nomic-embed-text (768 измерений), numpy 2.5.2, прогнано на стенде 2026-08-26
"""
Semantic search против поиска по ключевым словам на маленьком корпусе обращений
в техподдержку. Демонстрирует главное отличие техники: запрос без общих слов
с нужным документом находится через эмбеддинги, но не находится через
пересечение слов.
"""
import ollama
import numpy as np

EMBED_MODEL = "nomic-embed-text"

# Корпус - короткие обращения в техподдержку, как они выглядели бы в базе знаний
CORPUS = [
    "Не могу зайти в личный кабинет, забыл пароль",
    "Принтер на третьем этаже не печатает цветные документы",
    "Как получить доступ к общей папке проекта X",
    "Ноутбук зависает при подключении к Wi-Fi в переговорной",
    "Хочу настроить пересылку почты на личный ящик",
    "Не приходят push-уведомления в мобильном приложении",
    "Как продлить лицензию на антивирус",
    "VPN не подключается с домашнего компьютера",
]

# Запрос намеренно не пересекается по словам с целевым документом (#0):
# ни "пароль", ни "кабинет" в запросе нет, но смысл - тот же самый.
QUERY = "Забыла свою кодовую фразу, попасть в свой профиль на сайте не получается"


def embed(text: str, task_prefix: str) -> np.ndarray:
    # nomic-embed-text - асимметричная модель: без префикса задачи
    # (search_query / search_document) similarity между запросом и документом
    # считается некорректно, векторы почти неразличимы по косинусу.
    r = ollama.embeddings(model=EMBED_MODEL, prompt=f"{task_prefix}: {text}")
    return np.array(r["embedding"], dtype=np.float32)


def cosine_similarity(a: np.ndarray, b: np.ndarray) -> float:
    return float(np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b)))


def keyword_overlap(query: str, doc: str) -> int:
    # Наивный поиск по ключевым словам: пересечение множеств слов без стоп-слов
    stop = {"не", "на", "в", "с", "и", "к", "под", "для", "мой", "моим", "новый"}
    q_words = {w.strip(",.").lower() for w in query.split()} - stop
    d_words = {w.strip(",.").lower() for w in doc.split()} - stop
    return len(q_words & d_words)


def main():
    print(f"Запрос: {QUERY!r}\n")

    query_vec = embed(QUERY, "search_query")
    corpus_vecs =
    semantic_ranked = sorted(
        zip(CORPUS, corpus_vecs),
        key=lambda item: cosine_similarity(query_vec, item[1]),
        reverse=True,
    )

    overlaps = [(doc, keyword_overlap(QUERY, doc)) for doc in CORPUS]
    keyword_ranked = sorted(overlaps, key=lambda item: item[1], reverse=True)
    max_overlap = keyword_ranked[0][1]

    print("Semantic search (cosine similarity по эмбеддингам), топ-3:")
    for doc, vec in semantic_ranked[:3]:
        print(f"  {cosine_similarity(query_vec, vec):.4f}  {doc}")

    print("\nПоиск по ключевым словам (пересечение множеств слов), топ-3:")
    for doc, overlap in keyword_ranked[:3]:
        print(f"  overlap={overlap}  {doc}")

    top_semantic = semantic_ranked[0][0]
    print(f"\nЦелевой документ: {CORPUS[0]!r}")
    print(f"Semantic search нашёл его первым: {top_semantic == CORPUS[0]}")
    if max_overlap == 0:
        print("Keyword search: пересечений слов нет ни с одним документом - "
              "ранжировать нечем, результат недостоверен")
    else:
        print(f"Keyword search нашёл его первым: {keyword_ranked[0][0] == CORPUS[0]}")


if __name__ == "__main__":
    main()
Реальный прогон на стенде дал следующий вывод.
# вывод прогона на стенде 2026-08-26, сервер Ollama 0.32.13 (не путать с python-пакетом ollama 0.6.2 из кода выше), модель nomic-embed-text
Semantic search (cosine similarity по эмбеддингам), топ-3:
  0.7660  Не могу зайти в личный кабинет, забыл пароль
  0.7339  Как продлить лицензию на антивирус
  0.7211  Ноутбук зависает при подключении к Wi-Fi в переговорной

Поиск по ключевым словам (пересечение множеств слов), топ-3:
  overlap=0  Не могу зайти в личный кабинет, забыл пароль
  overlap=0  Принтер на третьем этаже не печатает цветные документы
  overlap=0  Как получить доступ к общей папке проекта X

Semantic search нашёл его первым: True
Keyword search: пересечений слов нет ни с одним документом - ранжировать нечем, результат недостоверен
Semantic search уверенно ставит нужный документ на первое место с отрывом от второго кандидата более чем на три сотых балла cosine similarity. Поиск по ключевым словам не нашёл ни одного пересечения слов ни с одним документом корпуса, поэтому его «результат» это просто исходный порядок списка, а не осмысленное ранжирование. Первый черновой прогон без префиксов search_query и search_document дал вырожденную картину, где все similarity стянулись в узкий диапазон и выигрывал случайный документ — это задокументированное требование асимметричных моделей эмбеддингов, а не случайность данных.
Нейронные сети на Python
Код курса
PYNN
Ближайшая дата курса
12 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Заключение
Семантический поиск переводит запрос и документы в общее векторное пространство и ищет по смысловой близости вместо буквального совпадения слов, что делает его основой RAG-приложений и современных баз знаний. При этом термин используется в индустрии неоднозначно, поэтому перед выбором платформы стоит уточнить, идёт ли речь о первичном извлечении через эмбеддинги или о надстройке-реранкере поверх лексического поиска. На практике семантический поиск почти всегда работает в паре с классическим полнотекстовым поиском, а не вместо него, и у каждой конкретной платформы есть свои лимиты на длину текста и число фрагментов, которые стоит сверять с документацией перед внедрением.
Референсные ссылки
- OpenSearch, Semantic search — архитектура, ingest-пайплайны, рекомендуемые сценарии
- Microsoft Learn, Semantic ranking overview (Azure AI Search) — механизм реранжирования, лимиты, скоринг
- Elastic, NLP limitations — лимит 512 токенов у ELSER, лимит числа чанков semantic_text
- Supabase, Semantic search — гайд по семантическому поиску на эмбеддингах
- ИИ и векторные базы данных: как это работает? — блог Школы Больших Данных о векторных базах и эмбеддингах