 3
Содержание
- Что такое Milvus
- Архитектура и ключевые особенности
- Компоненты кластера
- Слои хранения
- Принцип работы Milvus, от вставки до поиска
- Жизненный цикл сегмента
- Механизм ANN-поиска
- Milvus и альтернативы - когда распределённая архитектура оправдана
- Куда движется архитектура Milvus - 2.x против 3.0
- Ограничения и подводные камни
- Сценарии использования и отличительные черты
- Практика Milvus Lite через pymilvus
- Заключение
- Референсные ссылки
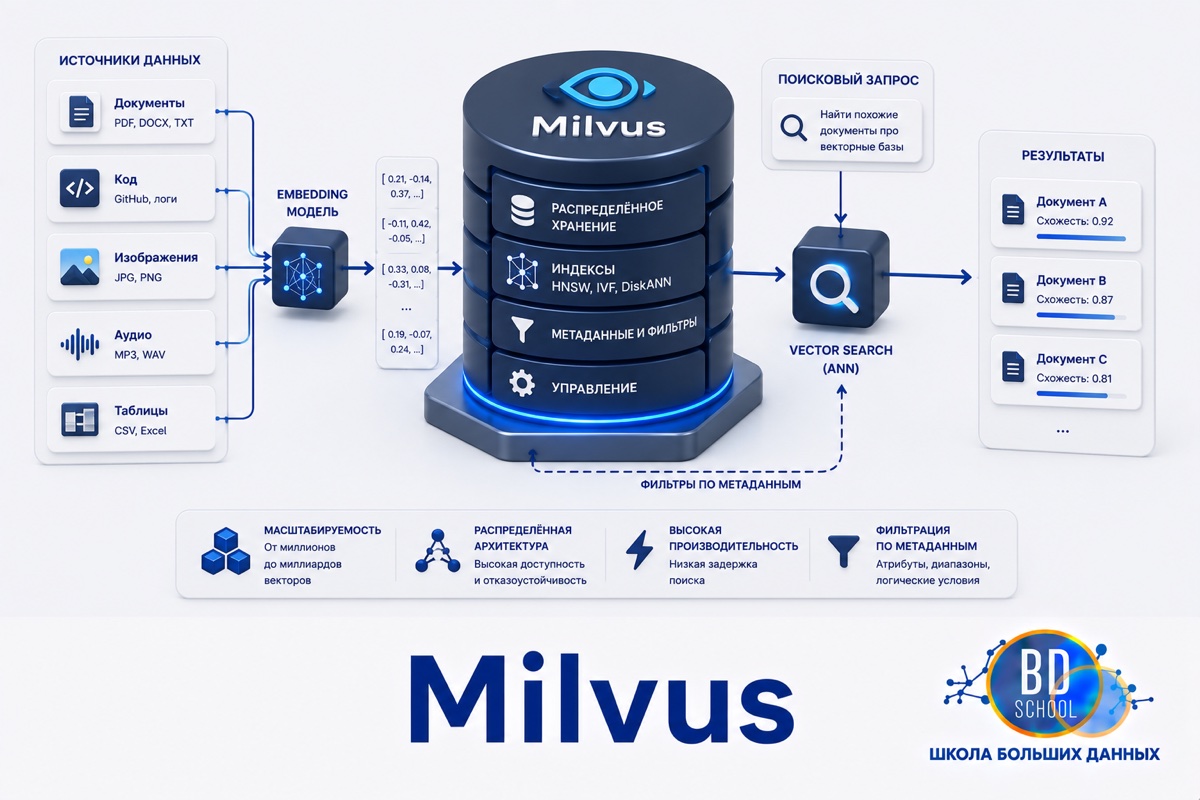
Milvus (vector database) — это открытая распределённая база данных, которая хранит векторные представления (embeddings) текста, изображений и другого контента и находит среди них ближайшие по смыслу. Проект курирует компания Zilliz, стабильная ветка на момент написания статьи — v2.6.16, вышедшая 13 мая 2026 года. Читатель, который уже пробовал Qdrant, ChromaDB или расширение pgvector для PostgreSQL, найдёт в Milvus знакомую задачу приближённого поиска ближайших соседей (ANN, Approximate Nearest Neighbor), но решённую через распределённую архитектуру с отдельными узлами под запись, хранение и вычисления.
Что такое Milvus
Milvus — открытая распределённая база данных, которая хранит векторные представления (embeddings) и решает задачу приближённого поиска ближайших соседей (ANN, Approximate Nearest Neighbor) в масштабе, для которого однопроцессные альтернативы уже не годятся. Разработан компанией Zilliz, которая передала проект фонду LF AI & Data при Linux Foundation, и распространяется по лицензии Apache 2.0. С ростом популярности RAG-архитектур (Retrieval-Augmented Generation) продукт стал одним из стандартных компонентов ИИ-инфраструктуры наравне с более простыми альтернативами. Общий принцип устройства систем такого рода разобран в статье «ИИ и векторные базы данных: как это работает?», здесь же в фокусе именно архитектурные решения Milvus и то, когда они реально нужны.
Архитектура и ключевые особенности
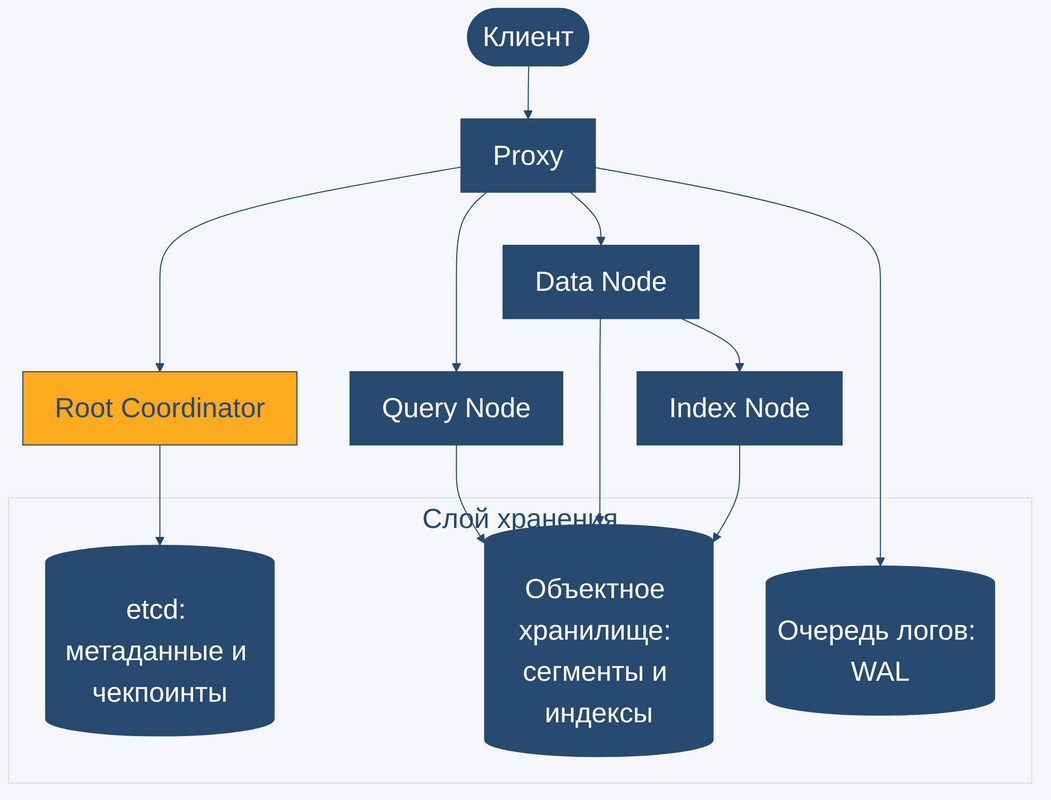
Ключевая архитектурная идея Milvus в ветке 2.x, к которой относится и разбираемая здесь версия v2.6.16, — разделение вычислений и хранения. Клиент обращается не напрямую к данным, а к Proxy, прослойке без состояния, которая балансирует нагрузку и маршрутизирует запросы дальше. Управляющую логику берёт на себя Root Coordinator, который отвечает за DDL-операции вроде создания коллекций, партиций и индексов и следит за топологией кластера. Собственно вычисления выполняют три типа рабочих узлов. Query Node обслуживает поисковые запросы по уже проиндексированным данным, Data Node занимается офлайн-обработкой и компакцией сегментов, а Index Node строит индексы отдельно от узлов чтения, чтобы тяжёлая индексация не мешала обслуживать текущий поиск.
Компоненты кластера
Proxy, Root Coordinator и три типа рабочих узлов вместе образуют вычислительный слой Milvus. Каждый из них можно масштабировать независимо, например добавить дополнительные Query Node под растущую нагрузку поиска, не трогая узлы индексации и не переразвёртывая кластер целиком. Общий обзор архитектуры доступен в официальной документации Milvus, хотя актуальная версия этой страницы уже описывает более новую модель 3.0 с единым Coordinator, о которой ниже отдельный раздел.
Слои хранения
Слой хранения устроен по тому же принципу разделения ответственности. etcd хранит метаданные, схемы коллекций и чекпоинты потребления. Объектное хранилище, совместимое с S3 (например MinIO), держит сами сегменты данных и построенные индексы. Очередь логов на базе Pulsar или Kafka работает журналом предзаписи (WAL, Write-Ahead Log) и гарантирует, что вставленные данные не потеряются до того, как физически попадут на диск.
Принцип работы Milvus, от вставки до поиска
Каждая вставка проходит несколько стадий. Данные сначала фиксируются в очереди логов, то есть в WAL, и тут же становятся доступны для чтения через growing-сегмент — ещё не оптимизированную структуру в памяти. Когда growing-сегмент набирает достаточный объём, он запечатывается (sealed segment), после чего Index Node строит по нему постоянный индекс и сохраняет результат в объектное хранилище.
Жизненный цикл сегмента
Переход growing в sealed это не разовое событие для всей коллекции, а процесс, который идёт параллельно по множеству сегментов. Пока один сегмент ещё принимает записи и обслуживается напрямую из памяти, соседний уже может быть запечатан и проиндексирован. Такая гранулярность позволяет Milvus не блокировать запись ради построения индекса.

Механизм ANN-поиска
Milvus поддерживает несколько алгоритмов приближённого поиска ближайших соседей. HNSW (Hierarchical Navigable Small World) строит многоуровневый граф соседства и хорошо балансирует скорость с точностью, IVF (Inverted File Index) кластеризует векторы и ищет только внутри ближайших кластеров, а гибридный поиск объединяет плотные (dense) векторные и разреженные (sparse) текстовые сигналы, например BM25-скор, в одном запросе. Отдельный нюанс, который легко упустить на практике — sealed-сегмент с готовым индексом на диске и коллекция, загруженная в память для поиска, это два разных состояния. В полноценном кластере состояние load хранится на стороне Query Node и переживает переподключение клиента, а вот во встраиваемом режиме Milvus Lite сервер живёт внутри процесса клиента, поэтому каждый новый процесс, подключившийся к тому же файлу базы, обязан вызвать load заново, иначе поиск упадёт с ошибкой о том, что коллекция released, даже когда индекс давно построен и лежит на диске.
Milvus и альтернативы — когда распределённая архитектура оправдана
У Milvus три режима развёртывания под разный масштаб задачи. Milvus Lite — встраиваемый режим, коллекция живёт в локальном файле без отдельного сервера, а работа идёт через тот же пакет pymilvus и тот же API, что и с полноценным кластером, только без распределённости и без отдельного процесса сервера. Standalone поднимает полный стек компонентов на одной машине, обычно через Docker. Cluster разворачивает Milvus на Kubernetes с независимым масштабированием каждого типа узлов и рассчитан на нагрузку в сотни миллионов и миллиарды векторов. Такая гибкость и отличает Milvus от более простых движков.
Сравнение с соседними инструментами удобно свести в таблицу ниже.
| Технология | Модель развёртывания | Когда предпочтительнее |
|---|---|---|
| Milvus | Embedded (Lite), Standalone, распределённый кластер на Kubernetes | Нагрузка растёт за пределы одной машины, нужна отдельная инфраструктура под векторный поиск |
| Qdrant | Один процесс на Rust, поддерживает кластерный режим | Нужен компактный сервер с REST/gRPC API без внешних зависимостей вроде etcd или очереди сообщений |
| ChromaDB | Встраиваемая Python-библиотека | Локальная разработка и небольшие RAG-прототипы, где распределённость не нужна вовсе |
| pgvector | Расширение PostgreSQL | Векторный поиск нужен внутри уже существующей реляционной базы, без отдельного сервиса |
Куда движется архитектура Milvus — 2.x против 3.0
Описанная выше архитектура (Proxy, Root Coordinator, отдельные Query/Data/Index Node) относится к стабильной ветке 2.x, на которой построена и эта статья, и демо ниже. Milvus 3.0 переходит на дизагрегированную модель, где единственный активный Coordinator управляет топологией и планированием, а вместо трёх типов рабочих узлов с закреплёнными ролями появляется Streaming Node, который обрабатывает запись и запросы к growing-данным в реальном времени поверх журнала Woodpecker. Отдельная новая возможность — External Collection, то есть запрос к внешним lake-таблицам без копирования данных внутрь Milvus.
Согласно доступным данным, Milvus 3.0 получил статус General Availability 16 июля 2026 года, но эта дата встречается пока только в одном источнике и не подтверждена второй независимой публикацией, поэтому в статье она приведена с оговоркой. Демо и все числа ниже относятся к проверенной ветке 2.6.16, а не к 3.0.
Ограничения и подводные камни
Официальная документация Milvus фиксирует ряд числовых лимитов, с которыми стоит свериться до проектирования схемы:
- Коллекции и партиции. До 65 536 коллекций на кластер и до 1 024 партиций на одну коллекцию.
- Размерность вектора. Максимум 32 768 измерений на поле типа vector.
- Память при загрузке. Данные, которые загружаются для поиска, не должны занимать больше 90% суммарной памяти всех Query Node, иначе движку выполнения запросов не хватит ресурсов.
- Downgrade не поддерживается. Путь миграции только вперёд, откат кластера на более старую версию официально не гарантирован.
Есть и менее формальное ограничение, которое видно только на практике. ANN-поиск неплохо находит документы из одного смыслового кластера, но плохо различает точность темы внутри него. В демо этой статьи запрос про мультиагентные системы для ИИ-агентов на первое место поставил документ про RAG, а не более тематически точный про LangGraph (фреймворк для построения мультиагентных систем как графа состояний) — оба текста лежат в одном кластере «инфраструктура LLM», и на небольшой коллекции embedding-модель не разводит их по степени релевантности. Смягчить это можно гибридным поиском или ranking-моделью поверх top-k результатов, но сам по себе ANN такую точность не даёт.
Разработка и внедрение ML-решений
Код курса
MLOPS
Ближайшая дата курса
9 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Сценарии использования и отличительные черты
Основной сценарий для Milvus — RAG-приложения, где база хранит embeddings базы знаний, а языковая модель дополняет ответ найденными фрагментами. Здесь же уместен гибридный поиск, когда плотный векторный сигнал комбинируется с классическим полнотекстовым BM25, а также кросс-модальный поиск, например текст по изображению. Отдельный подход к встраиванию векторного поиска в RAG-конвейер, построенный на графовой базе данных, разобран в статье «RAG-приложения и Neo4j: поддержка векторного индекса для LLM» — полезно сравнить два разных пути к одной задаче.
Milvus официально интегрируется с LangChain, LlamaIndex, DSPy, Haystack и другими фреймворками для агентных систем, поэтому подключение к уже существующему ИИ-агенту обычно сводится к смене клиента векторного хранилища, а не к переписыванию пайплайна. Тема встраивания таких инструментов в производственные ИИ-агенты подробно раскрыта на курсе «ИИ агенты для оптимизации бизнес-процессов», где Milvus и Zilliz упоминаются напрямую в программе.
Milvus избыточен, когда коллекция помещается на одну машину, а нагрузка не растёт, и в этом случае разумнее взять один из встраиваемых или однопроцессных вариантов из таблицы выше и не тащить в проект etcd, объектное хранилище и очередь сообщений ради задачи, которая с ними не связана по масштабу.
ИИ-агенты для оптимизации бизнес-процессов
Код курса
AGENT
Ближайшая дата курса
26 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
66 000
Практика Milvus Lite через pymilvus
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Ниже коллекция создаётся без Docker и без отдельного сервера. Пакет pymilvus с экстрой milvus_lite хранит данные в локальном файле, а embeddings считает локальная модель Ollama nomic-embed-text (768 измерений). Сначала собирается коллекция из восьми коротких текстов о разных технологиях с рубрикой в отдельном поле, строится HNSW-индекс, и коллекция загружается в память.
# pymilvus 2.6.16 (milvus-lite 3.2.1), эмбеддинги Ollama nomic-embed-text (768 измерений), прогнано на стенде 2026-08-30
# Создание коллекции в Milvus Lite: схема, вставка embeddings, построение HNSW-индекса.

import ollama
from pymilvus import MilvusClient, DataType

DB_PATH = "milvus_demo.db"
COLLECTION = "tech_articles"

# Короткие тексты про разные технологии из мира данных и ML, с рубрикой для скалярного фильтра.
DOCUMENTS = [
    ("streaming", "Apache Kafka передаёт события между сервисами через партиционированный лог с гарантией порядка внутри партиции."),
    ("orchestration", "Apache Airflow описывает пайплайны данных как DAG и по расписанию запускает задачи с отслеживанием зависимостей."),
    ("database", "PostgreSQL — реляционная СУБД с поддержкой транзакций ACID и богатым набором индексов, включая GiST и GIN."),
    ("database", "Milvus — распределённая векторная база данных для приближённого поиска ближайших соседей по embedding-векторам."),
    ("ml", "Fine-tuning дообучает предобученную языковую модель на узком датасете, чтобы адаптировать её под конкретную задачу."),
    ("ml", "RAG комбинирует поиск релевантных документов через векторную базу с генерацией ответа языковой моделью."),
    ("orchestration", "LangGraph описывает мультиагентные системы как граф состояний с узлами-исполнителями и условной маршрутизацией."),
    ("streaming", "Debezium через Change Data Capture публикует изменения строк PostgreSQL в топики Kafka в реальном времени."),
]


def embed_document(text: str) -> list[float]:
    # nomic-embed-text асимметричная модель: документы и запросы кодируются с разными префиксами задачи.
    response = ollama.embed(model="nomic-embed-text", input=f"search_document: {text}")
    return response["embeddings"][0]


def main() -> None:
    client = MilvusClient(uri=DB_PATH)

    if client.has_collection(COLLECTION):
        client.drop_collection(COLLECTION)

    # auto_id=False: id проставляем сами, порядковый номер документа в списке DOCUMENTS.
    schema = client.create_schema(auto_id=False, enable_dynamic_field=False)
    schema.add_field(field_name="id", datatype=DataType.INT64, is_primary=True)
    schema.add_field(field_name="vector", datatype=DataType.FLOAT_VECTOR, dim=768)
    schema.add_field(field_name="category", datatype=DataType.VARCHAR, max_length=32)
    schema.add_field(field_name="text", datatype=DataType.VARCHAR, max_length=500)

    client.create_collection(collection_name=COLLECTION, schema=schema)

    rows = []
    for doc_id, (category, text) in enumerate(DOCUMENTS):
        rows.append({
            "id": doc_id,
            "vector": embed_document(text),
            "category": category,
            "text": text,
        })
    client.insert(COLLECTION, rows)
    print(f"вставлено документов: {len(rows)}")

    # HNSW строит граф ближайших соседей поверх embedding-векторов, COSINE — метрика близости.
    index_params = client.prepare_index_params()
    index_params.add_index(
        field_name="vector",
        index_type="HNSW",
        metric_type="COSINE",
        params={"M": 16, "efConstruction": 200},
    )
    client.create_index(COLLECTION, index_params)

    # Сегмент переходит из growing в sealed и становится доступен для ANN-поиска только после load.
    client.load_collection(COLLECTION)
    print("индекс построен, коллекция загружена для поиска")


if __name__ == "__main__":
    main()
Второй файл переподключается к тому же файлу базы отдельным процессом и выполняет два поиска, обычный по всей коллекции и с фильтром по полю category. Обратите внимание на явный повторный load_collection в начале — без него поиск упадёт с ошибкой released, о которой шла речь в разделе про принцип работы.
# pymilvus 2.6.16 (milvus-lite 3.2.1), эмбеддинги Ollama nomic-embed-text (768 измерений), прогнано на стенде 2026-08-30
# ANN-поиск и поиск с фильтром по скалярному полю в уже наполненной коллекции Milvus Lite.
# Запускать после collection_setup.py — коллекция читается из того же файла базы.

import ollama
from pymilvus import MilvusClient

DB_PATH = "milvus_demo.db"
COLLECTION = "tech_articles"


def embed_query(text: str) -> list[float]:
    # Для запроса используется префикс задачи "search_query: ", для документов был "search_document: ".
    response = ollama.embed(model="nomic-embed-text", input=f"search_query: {text}")
    return response["embeddings"][0]


def main() -> None:
    client = MilvusClient(uri=DB_PATH)
    # Milvus Lite не хранит состояние загрузки между процессами: новое подключение к тому же
    # файлу базы видит коллекцию released, и без повторного load() поиск падает с ошибкой.
    client.load_collection(COLLECTION)

    query_text = "как построить мультиагентную систему для ИИ-агентов"
    query_vector = embed_query(query_text)

    print(f"запрос: {query_text!r}\n")

    print("-- обычный ANN-поиск (топ-3 по всей коллекции) --")
    plain_results = client.search(
        COLLECTION,
        data=[query_vector],
        limit=3,
        output_fields=["category", "text"],
    )
    for hit in plain_results[0]:
        entity = hit["entity"]
        print(f"distance={hit['distance']:.4f}  [{entity['category']}]  {entity['text']}")

    print("\n-- поиск с фильтром по скалярному полю (category == 'orchestration') --")
    filtered_results = client.search(
        COLLECTION,
        data=[query_vector],
        limit=3,
        filter="category == 'orchestration'",
        output_fields=["category", "text"],
    )
    for hit in filtered_results[0]:
        entity = hit["entity"]
        print(f"distance={hit['distance']:.4f}  [{entity['category']}]  {entity['text']}")


if __name__ == "__main__":
    main()
Реальный прогон на стенде даёт такой вывод.
вставлено документов: 8
индекс построен, коллекция загружена для поиска

запрос: 'как построить мультиагентную систему для ИИ-агентов'

-- обычный ANN-поиск (топ-3 по всей коллекции) --
distance=0.6818  [ml]  RAG комбинирует поиск релевантных документов через векторную базу с генерацией ответа языковой моделью.
distance=0.6552  [orchestration]  LangGraph описывает мультиагентные системы как граф состояний с узлами-исполнителями и условной маршрутизацией.
distance=0.6522  [streaming]  Apache Kafka передаёт события между сервисами через партиционированный лог с гарантией порядка внутри партиции.

-- поиск с фильтром по скалярному полю (category == 'orchestration') --
distance=0.6552  [orchestration]  LangGraph описывает мультиагентные системы как граф состояний с узлами-исполнителями и условной маршрутизацией.
distance=0.6159  [orchestration]  Apache Airflow описывает пайплайны данных как DAG и по расписанию запускает задачи с отслеживанием зависимостей.
Фильтр по category отработал ожидаемо, отсекая всё, кроме документов про orchestration. А вот порядок в обычном поиске — как раз пример ограничения из раздела выше, ведь RAG обошёл более уместный LangGraph просто потому, что оба документа лежат в одном смысловом кластере.
Заключение
Milvus решает задачу приближённого поиска ближайших соседей через распределённую архитектуру, где Proxy, Root Coordinator и специализированные рабочие узлы масштабируются независимо друг от друга. Это оправданный выбор, когда объём embeddings и нагрузка поиска растут за пределы одной машины, а Milvus Lite позволяет опробовать тот же клиент и тот же API локально, без кластера и Docker. Для задач меньшего масштаба разумнее начать с более простого движка вроде Qdrant, ChromaDB или pgvector и переходить на распределённый Milvus только тогда, когда для этого появится измеримая причина.
Референсные ссылки
- Milvus Architecture Overview — официальное описание компонентов системы и потока данных при записи и поиске.
- Milvus Limitations — числовые лимиты по коллекциям, партициям, полям и размерности векторов.
- Milvus Release Notes — история релизов с версиями и датами.
- Milvus Blog — Introducing Milvus 2.6 — контекст и позиционирование релиза 2.6.