
 1
Содержание
- Что такое Data Catalog и какую задачу он закрывает
- Архитектура каталога метаданных
- Какие метаданные собирает каталог
- Как каталог собирает метаданные под капотом
- Data lineage и его глубина
- Чего каталог данных не делает
- Каталоги данных с открытым кодом и чем они отличаются
- Каталоги для lakehouse
- Российские каталоги данных
- Когда каталог нужен, а когда нет
- Как выглядит описание сущности в каталоге
- Заключение
- Референсные ссылки
Data Catalog (каталог данных) это централизованный реестр метаданных, который отвечает на четыре вопроса про данные организации, а именно какие они есть, где лежат, кто за них отвечает и можно ли им доверять. Каталог собирает описания таблиц, файлов, витрин, дашбордов и пайплайнов, связывает их между собой и отдаёт через поиск, понятный не только инженеру. Это один из основных рабочих инструментов Data Governance, потому что без него политики управления данными остаются документом, который никто не открывает.
Что такое Data Catalog и какую задачу он закрывает
Формально каталог данных относится к классу платформ управления метаданными (metadata management). Он не хранит сами данные. Он хранит информацию о них: структуру таблицы, типы колонок, бизнес-смысл поля, владельца, дату последнего обновления, результаты проверок качества и цепочку происхождения.
Задача, которую каталог решает, звучит скучно, но стоит дорого. В компании с сотней источников аналитик тратит недели на выяснение, какая из трёх таблиц с похожим названием считается правильной. Он идёт в мессенджер, спрашивает коллег, получает три разных ответа. Каталог превращает это племенное знание в запись, которую видно всем. Побочный эффект не менее важен. Когда у каждой таблицы появляется явный владелец, становится с кого спросить за поле, которое молча поменяло тип.
Разграничим три близких понятия, которые часто путают. Metadata management это дисциплина, каталог данных это её инструмент, а data discovery это сценарий использования каталога, то есть поиск нужного набора данных.
Архитектура каталога метаданных
Практически любой современный каталог, от Apache Atlas до OpenMetadata, собран из одних и тех же трёх слоёв. Отличаются реализации, но не устройство.
- Слой сбора (ingestion). Коннекторы к источникам, то есть к СУБД, объектным хранилищам, BI-инструментам и оркестраторам. Именно здесь снимаются схемы, статистика и связи между объектами.
- Слой хранения метаданных. Модель сущностей и связей плюс поисковый индекс. Обычно это реляционная база под сами сущности и Elasticsearch либо OpenSearch под поиск.
- Слой доступа. Веб-интерфейс с поиском, а также REST или GraphQL API, через который каталог встраивается в чужие процессы вроде CI-проверок, ботов и внутренних порталов.
Ключевой архитектурный вопрос это не выбор базы, а модель сущностей, то есть то, насколько богато каталог описывает мир. Плоская модель «таблица со списком колонок» упирается в потолок ровно в тот момент, когда бизнесу нужно связать таблицу с термином глоссария, а термин с ответственным подразделением.
Какие метаданные собирает каталог
Метаданные принято делить на три группы, и здоровый каталог наполнен всеми тремя.
- Технические. Схема, типы, размер, партиции, индексы, формат файлов. Собираются автоматически и почти бесплатно.
- Бизнесовые. Что означает поле, к какому термину глоссария относится, кто владелец, какой уровень конфиденциальности. Собираются людьми и стоят дорого.
- Операционные. Когда объект обновлялся последний раз, кто и как часто к нему обращается, прошли ли тесты качества. Снимаются из логов и оркестратора.
Каталог, в котором есть только технические метаданные, это просто список таблиц. Ценность появляется на стыке, где техническая схема плюс бизнес-смысл плюс свежесть данных дают ответ на вопрос «можно ли брать эту витрину в отчёт для правления».
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Как каталог собирает метаданные под капотом
Есть два механизма наполнения, и разница между ними определяет, насколько актуальным будет каталог.
Pull-модель. Каталог по расписанию ходит в источники и снимает метаданные сам. Так работает OpenMetadata. Его фреймворк ingestion запускается заданием, чаще всего через Apache Airflow, и обходит подключённые сервисы. Плюс в простоте, потому что источник ничего не знает о каталоге. Минус в задержке, потому что между изменением схемы и появлением его в каталоге лежит интервал расписания.
Push-модель. Источники и пайплайны сами отправляют события об изменении метаданных. DataHub построен вокруг этого подхода и принимает события через Kafka, поэтому изменения видны почти сразу. Плата за скорость это встраивание эмиттеров в чужие процессы, то есть работа не только на стороне каталога.
На практике зрелые внедрения комбинируют оба режима, сканируя источники массово через pull, а критичные пайплайны подключая через push.
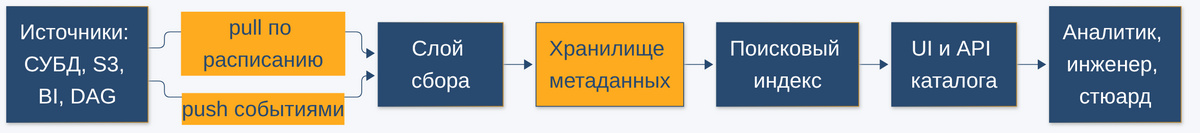
Схема объясняет и типовую точку отказа. Если слой сбора встал, каталог продолжает бодро отвечать на запросы, но показывает вчерашнюю картину мира. Мониторинг заданий ingestion обязателен ровно так же, как мониторинг продуктовых пайплайнов.
Data lineage и его глубина
Происхождение данных (data lineage) это граф, показывающий, из каких объектов получен текущий. Именно lineage отличает каталог от таблицы в вики, и именно он тяжелее всего даётся на внедрении.
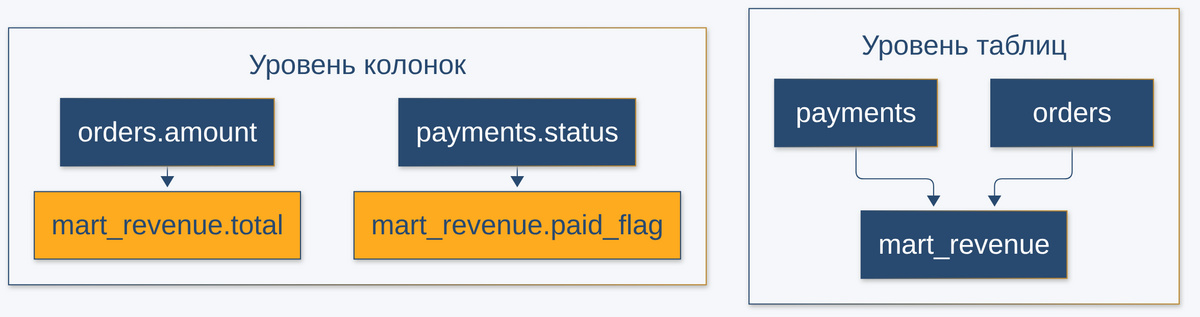
Различают два уровня детализации. Lineage уровня таблиц говорит, что витрина построена из трёх источников. Lineage уровня колонок (column-level lineage) говорит, что конкретное поле отчёта считается из двух конкретных колонок конкретных таблиц. Разница видна в момент инцидента. Например, при табличном lineage анализ влияния может выдать десятки отчётов, а при колоночном только те несколько, что реально читают изменённое поле.
Column-level lineage поддерживают и OpenMetadata, и DataHub, но строится он парсингом SQL, а значит имеет предсказуемые слепые зоны.
- Динамический SQL. Запрос, собранный строками в Python во время выполнения, парсеру недоступен.
- Логика внутри кода. Трансформации в Spark-джобе на DataFrame API восстанавливаются хуже, чем чистый SQL.
- Внешние процессы. Выгрузка в файл, ручная обработка и загрузка обратно рвут граф без следа.
Отсюда практический вывод, что полнота lineage это не свойство каталога, а свойство дисциплины в пайплайнах. Чем больше логики выражено декларативно, тем честнее граф. Как строится и на чём ломается граф происхождения, подробно разобрано в отдельной статье энциклопедии про data lineage.
Чего каталог данных не делает
Вокруг каталогов много ожиданий, которые они не оправдывают, и лучше знать об этом до закупки.
Каталог не улучшает качество данных. Он показывает результаты проверок и делает проблему видимой, но чинить пайплайн всё равно людям. Каталог не заменяет владельцев. Поле «ответственный» заполняется руками, и если никто не назначен, каталог честно покажет пустоту. Каталог не поддерживает себя сам, потому что бизнес-описания устаревают быстрее схем, поэтому без регулярной работы стюардов данных через год он превращается в кладбище неточных подписей.
Отдельная ловушка это внедрение «снизу», силами одной команды инженеров. Технически такой каталог поднимается за неделю. Организационно он умирает, потому что бизнес-метаданные вносить некому, а без них поиск остаётся техническим.
Каталоги данных с открытым кодом и чем они отличаются
Классическую тройку открытых каталогов составляют OpenMetadata, DataHub и Apache Atlas. Все три выросли из внутренних платформ крупных компаний и закрывают поиск, глоссарий, lineage и управление данными.
| Критерий | OpenMetadata | DataHub | Apache Atlas |
|---|---|---|---|
| Модель сбора | преимущественно pull | pull и push через Kafka | хуки и push из Hadoop |
| Column-level lineage | есть | есть | ограниченно |
| Качество данных | встроенные тесты и профайлер | интеграции и assertions | нет из коробки |
| API | REST | GraphQL и REST | REST |
| Типичная ниша | универсальный каталог платформы | крупный масштаб, событийная модель | экосистема Hadoop |
Практический ориентир простой. OpenMetadata берут, когда нужен готовый каталог с качеством данных в одной коробке, DataHub когда важна событийная модель и глубокая интеграция через API, Apache Atlas когда платформа уже живёт в Hadoop-контуре и менять стек никто не собирается. Подробнее про сами метаданные и их жизненный цикл разобрано в статье Metadata Management. Данные о данных как ключ к их ценности.
Каталоги для lakehouse
Технические каталоги вроде Hive Metastore и AWS Glue существовали и раньше, но в последние годы вокруг lakehouse выросло их новое поколение с открытым кодом. Их задача не поиск для аналитика, а единая точка доступа к таблицам и правам для вычислительных движков. Unity Catalog компания Databricks открыла в июне 2024 года и передала в фонд LF AI & Data при Linux Foundation. По анонсу, открытая версия поддерживает стандарты Iceberg REST Catalog и интерфейс Hive Metastore. Apache Gravitino в июне 2025 года стал проектом верхнего уровня Apache и объединяет метаданные хранилищ, озёр, стриминга и ИИ-систем. Apache Polaris реализует REST-каталог для таблиц Apache Iceberg.
Такие каталоги не заменяют OpenMetadata или DataHub, а лежат слоем ниже. Бизнес-каталог часто читает технические метаданные именно из них и добавляет сверху глоссарий, владельцев и lineage.
Российские каталоги данных
Отечественный рынок каталогов растёт вместе с импортозамещением стека управления данными. В сентябре 2026 года исследовательский центр «Круги Громова» опубликовал, по данным отраслевой прессы, сравнение семи российских платформ по 325 критериям. В него вошли продукты отечественных разработчиков, в том числе Arenadata Catalog от группы Arenadata, SBF DataManagement, RT.DataGovernance, Data Ocean Governance, Q.DataCatalog, Data Catalog от VK Tech и платформа компании Юнидата, а OpenMetadata служил референсом вне зачёта.
Главный вывод исследования в том, что каталогизация, бизнес-глоссарий, lineage и качество данных есть почти у всех. Конкуренция сместилась в глубину, то есть в автоматизацию lineage, качество коннекторов, ролевую модель и зрелость эксплуатации. Сильнее всего платформы расходятся в функциях ИИ, оценки по ним разбросаны от 23 до 94 баллов из 100.
Показательный пример здесь Arenadata Catalog. В апреле 2026 года вышла его версия 1.0.0, и в ней появились доменная модель с дата-продуктами, сертификация объектов каталога, переработанный lineage и ИИ-помощник, который генерирует описания таблиц и колонок и оформляет их как заявки на изменение. Открытые проекты при этом остаются вариантом для команд, готовых собирать и поддерживать каталог своими силами.
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Когда каталог нужен, а когда нет
Каталог оправдан не всегда, и это нормально. Ориентируйтесь на признаки, а не на моду.
- Нужен. Источников больше нескольких десятков, потребителей данных больше одной команды, есть регуляторные требования по персональным данным, регулярно ломаются отчёты из-за изменений выше по потоку.
- Скорее не нужен. Одна база, одна команда, полсотни таблиц и общая память о том, как всё устроено. Здесь каталог добавит поддержки больше, чем пользы.
- Спорно. Данных много, но нет ни одного человека с ролью стюарда. Сначала роль, потом инструмент, иначе внедрение упрётся в пустые поля владельцев.
Место каталога в общей системе управления данными подробно разобрано в статье энциклопедии про Data Governance, а проектирование платформы вокруг него разбирается на курсе Архитектура данных.
Как выглядит описание сущности в каталоге
Чтобы понятие перестало быть абстрактным, посмотрим на минимальное описание таблицы, которое попадает в каталог при регистрации источника.
# структура по документации OpenMetadata 1.13, не прогонялось на стенде
{
  "name": "mart_revenue",
  "fullyQualifiedName": "prod_dwh.analytics.mart_revenue",
  "description": "Витрина выручки по заказам, гранулярность день и канал продаж",
  "owners": [ { "type": "team", "name": "analytics-platform" } ],
  "tags": [
    { "tagFQN": "Tier.Tier1" },
    { "tagFQN": "PII.Sensitive" }
  ],
  "columns": [
    { "name": "report_date", "dataType": "DATE" },
    { "name": "channel", "dataType": "VARCHAR", "dataLength": 64 },
    { "name": "total", "dataType": "DECIMAL",
      "description": "Сумма выручки без НДС" }
  ]
}
Обратите внимание на пропорцию. Технические поля здесь заполняет коннектор автоматически, а поля description, owners и tags это ровно та часть, ради которой каталог и заводят, и ровно та часть, которую придётся наполнять людям.
Заключение
Data Catalog это индекс организации по её собственным данным. Он собирает метаданные из источников, связывает объекты через lineage и делает знание о данных доступным по поиску, а не по знакомству. Технически такой каталог поднимается быстро, и именно это вводит в заблуждение. Работать он начинает тогда, когда у объектов появляются реальные владельцы, а задания сбора метаданных мониторятся наравне с продуктовыми пайплайнами.