 13
Содержание
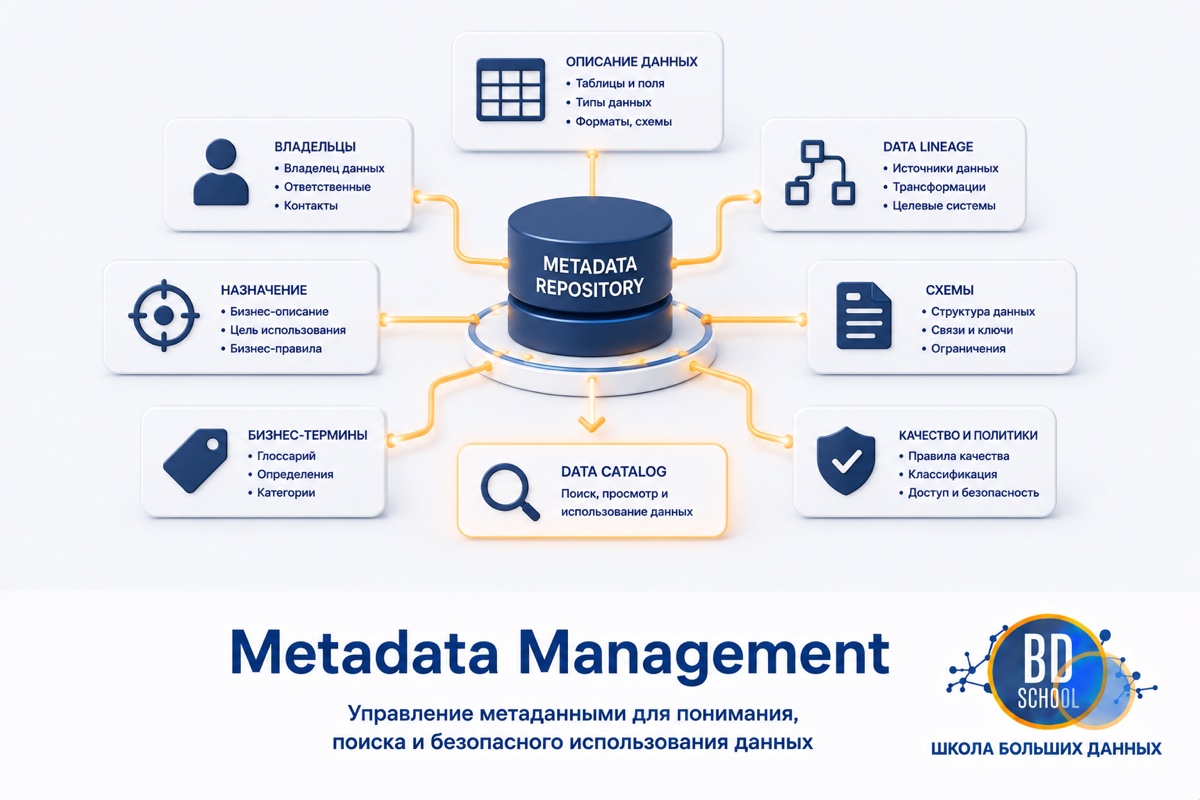
Metadata management (управление метаданными) это дисциплина сбора, каталогизации и распространения «данных о данных», то есть сведений о том, что за данные существуют в организации, откуда они взялись, как устроены и как их можно использовать. Практика опирается на центральный каталог метаданных и делает данные находимыми, понятными и заслуживающими доверия. Metadata management это не продукт и не библиотека, а процесс и набор ролей, поэтому у него нет номера версии, зато есть отраслевой свод знаний, который его описывает. Ключевой сдвиг 2025-2026 годов это переход от пассивного управления метаданными, которое фиксирует изменения задним числом, к активному, где каталог сам реагирует на события в data-стеке и распространяет их дальше.
Определение Metadata Management
Управление метаданными охватывает четыре действия над «данными о данных», а именно сбор, организацию, governance (нормативный контроль и надзор) и активацию, то есть превращение накопленных сведений в конкретную пользу для аналитика, инженера или приложения. Подробнее о том, зачем это нужно и какую ценность метаданные дают бизнесу, читатель найдёт в материале «Metadata Management. Данные о данных как ключ к их ценности».
Метаданные делятся на типы. По классификации DataGalaxy метаданные делятся на семь узких категорий, а именно описательные (имена, бизнес-определения), структурные (схемы, связи сущностей), административные (владение, права доступа, жизненный цикл), метаданные безопасности и комплаенса (классификации чувствительности, GDPR- и HIPAA-метки, где HIPAA это американский закон о защите медицинских данных), технические (форматы, ETL-правила, lineage, то есть происхождение данных), метаданные использования (частота обращений, связанные дашборды) и метаданные governance (бизнес-правила, термины глоссария). Другая, более грубая классификация сворачивает то же самое в четыре группы, а именно технические, бизнес-метаданные, операционные и метаданные комплаенса. Расхождение не противоречие, а разная степень детализации одного и того же набора.
Дисциплину регулирует свод знаний DAMA-DMBOK (Data Management Body of Knowledge), который поддерживает DAMA International (глобальная профессиональная ассоциация специалистов по управлению данными). Действующая версия DMBOK перечисляет управление метаданными как одну из областей знаний свода, а data governance ставит в центр модели как практику, которая координирует эту и остальные области между собой. Следующая крупная версия, DMBOK 3.0, разрабатывается сообществом с 2025 года с прицелом на AI governance и облачно-нативные среды, публикация запланирована на 2027 год. Статус обновления описан на официальной странице DAMA. Полный текст DMBOK это платное издание, поэтому в статье он не пересказывается построчно, только общедоступные тезисы о его структуре и статусе.
Metadata management не стоит путать с master data management (управлением основными данными). Master data management создаёт единую версию правды для ключевых бизнес-сущностей, например клиентов или товаров, а metadata management описывает сами наборы данных целиком, а не только основные сущности среди них.
Архитектура и ключевые особенности
По описанию DataGalaxy современная стратегия управления метаданными строится на четырёх типовых блоках.
- Центральный каталог данных. Репозиторий, где метаданные хранятся, ищутся и проходят governance.
- Непрерывный сбор. Автоматическое извлечение метаданных из баз данных, хранилищ и SaaS-платформ вместо ручного заполнения таблиц.
- Governance-каркас. Стандарты, политики и роли, а именно Chief Data Officer (CDO, директор по данным) и data steward (ответственный за качество и корректность конкретного набора данных). Подробнее о том, как каталоги встраиваются в общую практику governance, в материале про работу data governance.
- Активация. Превращение накопленных метаданных в действие, а именно поиск, контроль доступа и визуализацию lineage (происхождения данных).
Схема ниже собирает архитектуру целиком, от источников до governance-ролей.
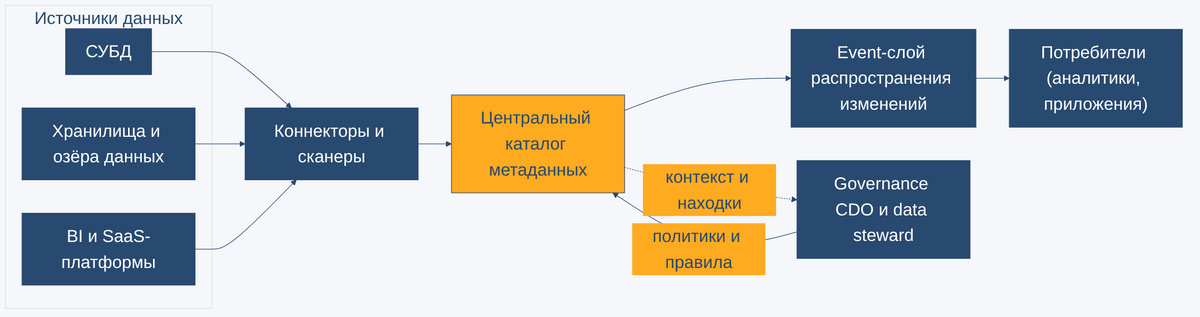
Поверх этих четырёх блоков вендоры активных платформ (например, Atlan) описывают более узкий архитектурный слой из четырёх компонентов, а именно масштабируемое хранилище метаданных на открытых стандартах, двунаправленные API-коннекторы к хранилищам и BI-инструментам, событийный слой распространения изменений и слой автоматической классификации данных на базе ML. Это описание конкретного класса продукта, а не универсальный стандарт архитектуры.
Архитектура Данных
Код курса
ARMG
Ближайшая дата курса
21 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы сбора, каталогизации, распространения и потребления
По описанию вендора Atlan активная система управления метаданными работает как непрерывный цикл, а не как разовая настройка.
- Сбор. Логи запросов, события lineage и паттерны использования захватываются в реальном времени, без задержки на batch-обновление по расписанию.
- Каталогизация. Модель машинного обучения связывает потоки метаданных между собой, классифицирует чувствительные колонки и выводит бизнес-смысл данных из паттернов обращения к ним.
- Распространение. При изменении вышестоящей таблицы система оповещает затронутых стейкхолдеров, открывает тикет на исправление и может остановить нижестоящий пайплайн до того, как некорректные данные разойдутся дальше по системам.
- Потребление. Метаданные текут двунаправленно, lineage появляется прямо в BI-инструменте, оценки качества данных в редакторе запросов, бизнес-определения в мессенджере команды.
У классического пассивного подхода тот же каркас работает иначе. Сбор идёт периодическим сканированием источников по расписанию, каталогизация сводится к записи снятого снимка в репозиторий, а распространение и оповещение об изменениях ручные или вовсе отсутствуют.
Активные vs пассивные метаданные
Отрасль всё резче разделяет два режима работы одного и того же каталога, и разница видна на каждом этапе цикла.
| Критерий | Пассивные метаданные | Активные метаданные |
|---|---|---|
| Момент обновления | Периодическое сканирование по расписанию | Непрерывно, в ответ на события в data-стеке |
| Реакция на изменение | После инцидента, задним числом | До того, как проблема распространится по зависимым системам |
| Механизм | Batch-скан источников, запись снимка в каталог | Event-driven propagation через lineage |
| Срок внедрения | Базовая настройка быстрее и дешевле | По оценке Atlan, базовые интеграции 4-8 недель, полная отдача 3-6 месяцев |
| Требования к инфраструктуре | Минимальные | Глубокие API-интеграции со всем data-стеком |
Срок внедрения в таблице это оценка вендора активных платформ, а не задокументированный технический норматив, и подходит только организациям с достаточно сложным data-стеком, чтобы окупить его.
Ограничения и подводные камни
Прежде чем закладывать управление метаданными в архитектуру, стоит честно учесть границы подхода.
- PII не определяется автоматически. Активные платформы не умеют сами находить персональные данные (PII), для этого нужны отдельные инструменты качества данных и правило-ориентированная настройка. Это задокументированное ограничение, а не маркетинговая оговорка.
- Эффект зависит от глубины интеграций. Организации без API-подключений ко всему data-стеку получают ограниченную автоматизацию, сколько бы ни стоил сам каталог.
- DMBOK 3.0 ещё не опубликован. До 2027 года официального обновлённого свода знаний с рекомендациями по AI governance не существует, есть только рабочая версия и текущий DMBOK.
- Числовые эффекты внедрения не перепроверены независимо. Оценки вендоров (Atlan и DataGalaxy, разработчиков платформ каталогизации метаданных) взяты из материалов одного класса поставщиков и не сверены со сторонним независимым источником вроде Gartner или Forrester. Среди них потери 30-40% времени на поиск информации без каталога, экономия 15-30% на хранилище за счёт автоархивации неиспользуемых данных, ускорение расследования инцидентов на 50-70%, снижение обращений бизнес-пользователей к инженерам на 30-50% и рост успешности SQL-запросов AI-агента с 16,1% до 22,2% на governed-метаданных.
Ни одно из этих ограничений не отменяет пользу дисциплины, но каждое стоит закладывать в план внедрения заранее, а не обнаруживать по факту после запуска каталога.
Сценарии использования
Управление метаданными закрывает широкий круг задач, но не универсально полезно в любой организации.
- Регуляторный комплаенс. Аудит-трейлы и классификация по GDPR или HIPAA.
- Self-service аналитика. Бизнес-пользователи находят нужные данные сами, без очереди к инженерам.
- Governance AI и ML-моделей. Управление признаками (feature governance) и контекстом для агентов.
- Миграция данных и disaster recovery. Каталог показывает, что переносить и от чего это зависит.
- Мониторинг качества и lineage. Отслеживание происхождения данных до источника.
- Оптимизация затрат. Выявление неиспользуемых активов для архивации или удаления.
- Разрешение инцидентов. Трассировка от симптома к первопричине через lineage.
По оценке вендора Atlan активная система управления метаданными избыточна для простых статичных сред без частых изменений схемы, для организаций с приоритетом на минимальную стоимость решения, для полностью ручных табличных процессов и для legacy-систем с минимальной поддержкой API. Это позиция одного вендора о своём классе продукта, а не нейтральная рекомендация отраслевого стандарта, но она честно очерчивает границу применимости именно активного подхода.
Практика на примере API каталога метаданных
Каталоги метаданных обычно предоставляют REST API для поиска актива и чтения его lineage. Ниже иллюстративный синтаксис такого обращения по общепринятому паттерну REST, не взятый из документации конкретного продукта и не привязанный к его версии. Прежде чем строить интеграцию, синтаксис нужно сверить с документацией выбранного каталога.
# Иллюстративный синтаксис по общепринятому паттерну REST, не из документации конкретного каталога и не привязан к версии продукта
# Поиск актива по имени таблицы
curl -s -X GET "https://catalog.example.com/api/v1/assets/search?q=orders" \
  -H "Authorization: Bearer $CATALOG_TOKEN" | jq '.results[] | {id, name, owner}'

# Чтение lineage конкретного актива по его идентификатору
curl -s -X GET "https://catalog.example.com/api/v1/assets/$ASSET_ID/lineage?depth=2" \
  -H "Authorization: Bearer $CATALOG_TOKEN" | jq '.upstream, .downstream'
Первый вызов находит идентификатор нужной таблицы по её имени, второй по этому идентификатору поднимает её origin и зависимые объекты на глубину два узла. На таком же принципе построены типовые сценарии активации из раздела архитектуры, где оповещение стейкхолдеров и остановка нижестоящего пайплайна опираются именно на граф lineage, который возвращает второй вызов. Разбор построения такой архитектуры целиком входит в программу курса «Архитектура данных».
Практическая архитектура данных
Код курса
PRAR
Ближайшая дата курса
30 ноября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Заключение
Metadata management остаётся дисциплиной, а не софтом, и её главный ориентир сегодня это сдвиг от пассивного каталога, который фиксирует факты задним числом, к активному, который реагирует на события в реальном времени и распространяет их по зависимым системам сам. DAMA-DMBOK продолжает служить общим языком для описания этой дисциплины, а его следующая версия должна закрыть пробел с AI governance к 2027 году. Числа про экономию времени и ускорение расследований у вендоров выглядят убедительно, но пока это маркетинговые оценки одного класса поставщиков, а не независимо подтверждённый стандарт, поэтому решение о переходе на активное управление метаданными стоит принимать по глубине собственных API-интеграций, а не по чужим процентам.