 8
Содержание
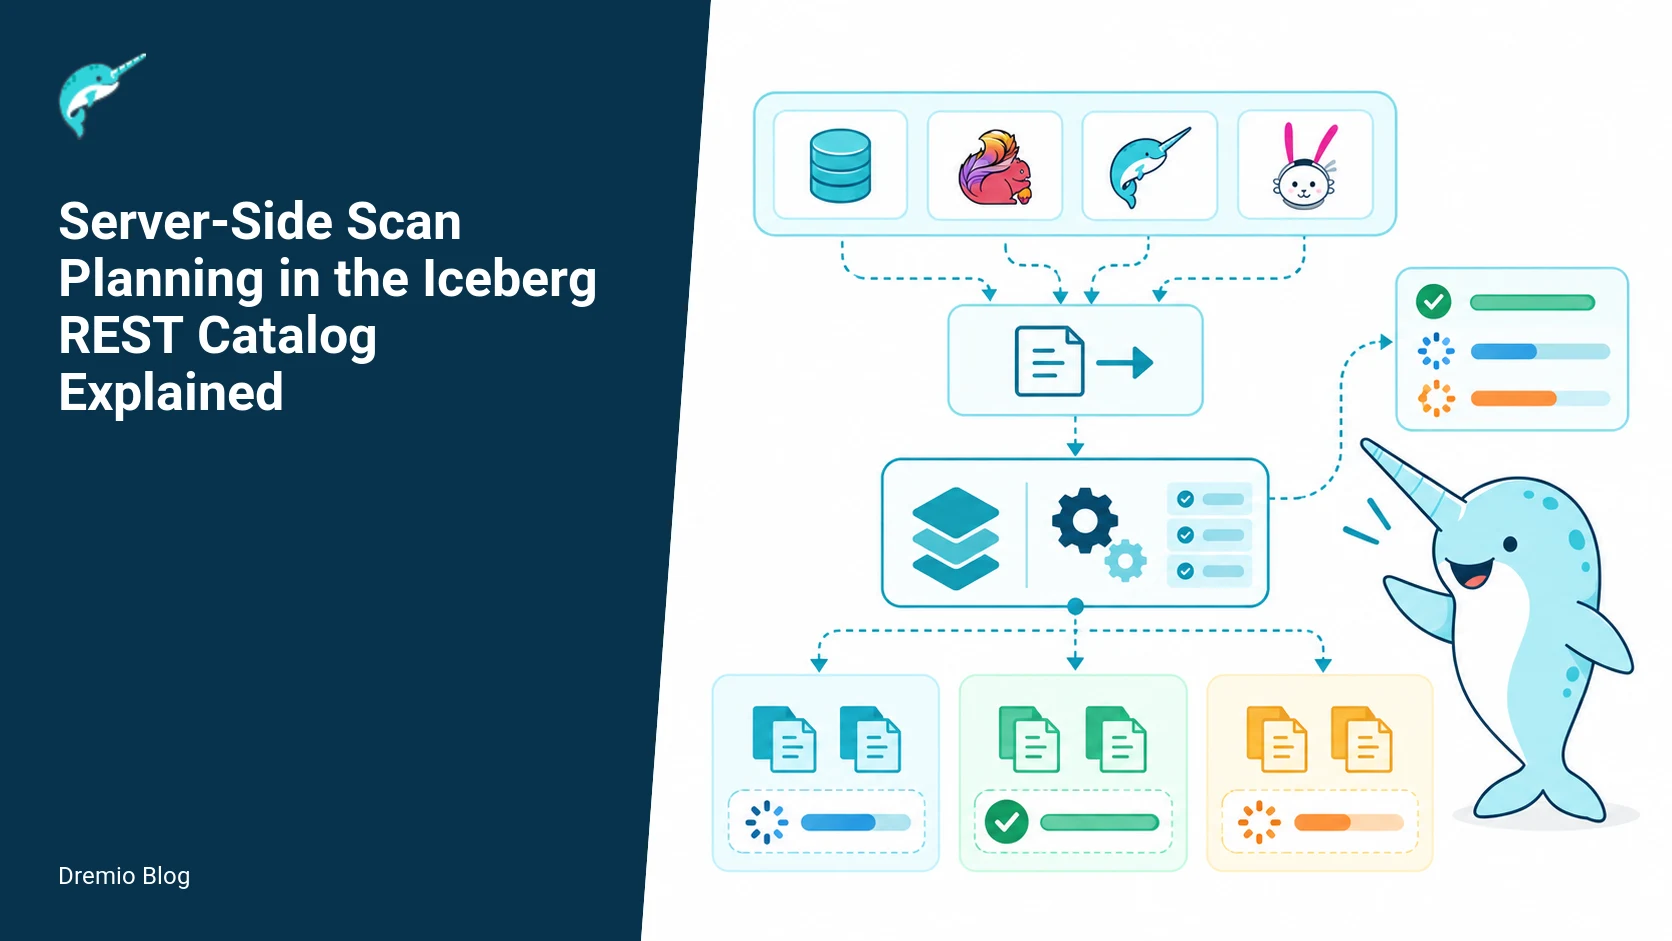
Серверное планирование сканирований переносит основную работу по разбору метаданных и формированию плана запроса с клиента на каталог. Это снижает сетевой трафик и нагрузку на аналитические движки при работе с большими таблицами Iceberg. Подход особенно полезен в распределённых средах, где клиенты не должны держать в памяти полные снимки метаданных. Iceberg представляет собой формат таблиц для озёр данных, позволяющий отслеживать версии и обеспечивать атомарность операций. REST Catalog в свою очередь выступает интерфейсом, через который клиенты взаимодействуют с метаданными таблиц по протоколу HTTP. Перенос планирования помогает избежать передачи больших объёмов информации при каждом запросе, что критично при росте числа файлов в таблице.
Механизм планирования на стороне сервера
Сервер принимает запрос на сканирование и самостоятельно анализирует манифесты, файлы данных и статистики. Манифесты здесь — это файлы метаданных, которые описывают расположение и свойства отдельных файлов данных внутри таблицы. Вместо передачи всех метаданных клиенту он возвращает уже готовый план с перечнем файлов и диапазонами. Такой подход уменьшает объём данных, которые нужно пересылать по сети, и сокращает время инициализации запроса у клиента. В результате движки вроде Spark или Trino тратят меньше ресурсов на подготовку и быстрее переходят к чтению данных. Spark и Trino — это распределённые аналитические платформы, которые выполняют запросы к большим наборам информации.
Важно, что сервер хранит актуальное состояние каталога и может учитывать изменения схемы или партиционирования без дополнительного опроса со стороны клиента. Схема таблицы определяет структуру столбцов, а партиционирование задаёт способ разделения данных на части для ускорения доступа. Это особенно заметно при частых обновлениях таблиц, когда клиенты раньше вынуждены были заново загружать большие объёмы метаданных при каждом новом запросе. При принятии решения о внедрении стоит оценить, насколько часто происходят такие обновления и какой объём метаданных приходится передавать в текущей архитектуре.
Асинхронные планы, опросы и отмена
Планирование выполняется асинхронно: клиент отправляет задачу и получает идентификатор плана, после чего периодически опрашивает сервер о готовности. Асинхронный режим означает, что клиент не ждёт завершения операции в одном потоке, а продолжает работу и проверяет статус позже. Такой режим позволяет запускать тяжёлые операции без блокировки клиентского потока. При необходимости клиент может отменить задачу по идентификатору, что освобождает ресурсы сервера и предотвращает накопление бесполезных вычислений. Идентификатор плана служит уникальным ключом для отслеживания и управления конкретной задачей.
Поддерживается батчевая обработка нескольких планов в одном запросе. Батчевая обработка объединяет несколько операций в единый сетевой вызов, снижая накладные расходы на сетевые вызовы при одновременной работе с несколькими таблицами. Однако при высокой частоте опросов растёт нагрузка на каталог, поэтому важно настроить интервалы опроса с учётом типичной длительности планирования в конкретной инфраструктуре. При выборе решения нужно учитывать, способна ли текущая сеть выдерживать периодические проверки статуса без создания узких мест.
Ограничения и практические соображения
Серверное планирование требует от каталога достаточных вычислительных ресурсов и оперативной памяти для хранения промежуточных результатов. В средах с ограниченным доступом к внешним сервисам это может привести к необходимости масштабировать сам каталог, а не только аналитические кластеры. Кроме того, при потере связи с сервером клиент теряет возможность продолжить работу до восстановления соединения. Это делает отказоустойчивость каталога ключевым фактором при оценке пригодности подхода для производственных нагрузок.
В российских контурах с изолированными сетями и собственными хранилищами S3-совместимого типа подход даёт преимущество за счёт уменьшения количества обращений к внешним метаданным. S3-совместимые хранилища — это объектные системы, совместимые с интерфейсом Amazon S3, часто используемые для хранения данных. Однако нужно учитывать, что сервер каталога становится критической точкой отказа, поэтому его развёртывание требует репликации и мониторинга доступности. Репликация обеспечивает копирование состояния на несколько узлов для повышения надёжности. При выборе решения стоит оценить, насколько текущая нагрузка на планирование сканирований оправдывает перенос этой логики на отдельный компонент. Дополнительно следует проанализировать затраты на поддержку высокой доступности каталога и сравнить их с выигрышем от снижения нагрузки на клиентские движки.
Подробнее о возможностях и ограничениях
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Серверное планирование сканирований в Iceberg REST Catalog.
Курс по теме — Каталог курсов Школы Больших Данных