 4
Содержание
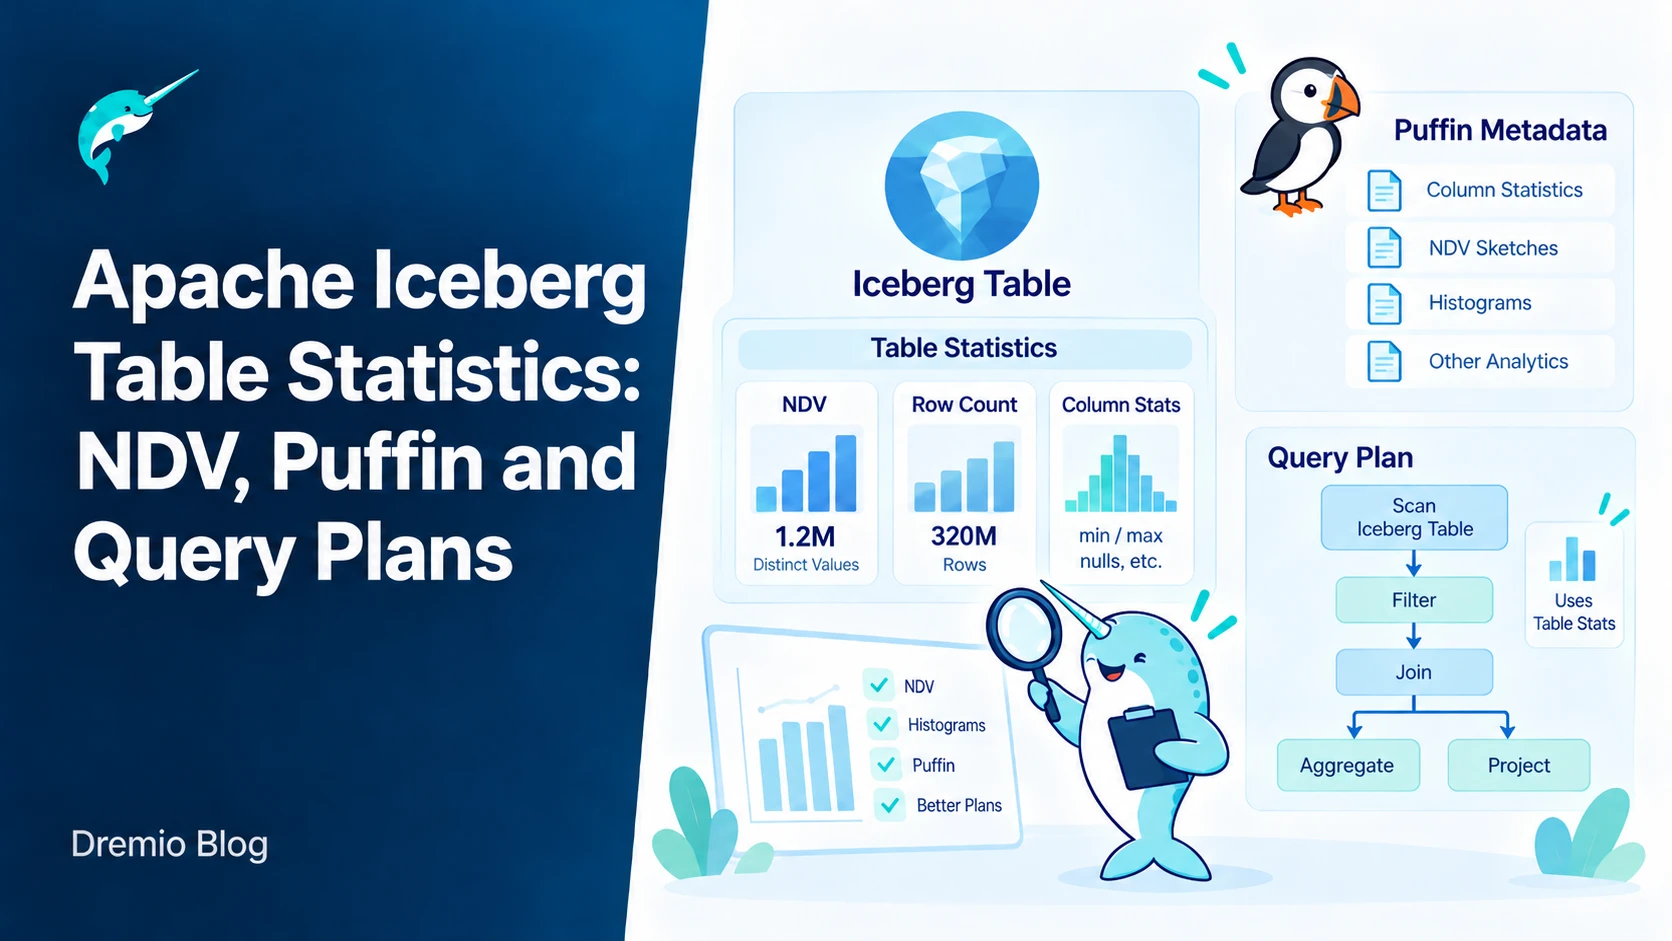
Dremio описала, как Apache Iceberg хранит границы значений на уровне файлов автоматически, но точные NDV-статистики на уровне таблицы требуют отдельного вычисления. Без них планировщик запросов часто выбирает неоптимальный порядок соединений и сканирования, особенно в больших озёрах данных. Это напрямую влияет на время выполнения аналитических запросов и расход ресурсов кластера. Разберём, когда стоит тратить ресурсы на сбор статистики и как это устроено в текущей реализации. Решение о сборе статистики зависит от того, насколько критична скорость запросов и есть ли возможность выделить вычислительные мощности без ущерба для основной нагрузки.
Границы файлов и их ограничения
Iceberg по умолчанию записывает минимальные и максимальные значения для каждого файла данных. Эти метаданные позволяют движку быстро отбрасывать файлы, которые точно не содержат нужные строки при фильтрации. Однако для сложных запросов с соединениями таких сведений недостаточно. Планировщик не знает распределение уникальных значений внутри всей таблицы и поэтому вынужден опираться на грубые оценки кардинальности.
В результате часто выбирается не лучший порядок соединений. Например, таблица с миллионами уникальных ключей может обрабатываться позже, чем следовало, что приводит к большому объёму промежуточных данных. Автоматические границы файлов не решают эту задачу, потому что они не агрегируют информацию по всем файлам. При оценке необходимости статистики важно понять, преобладают ли в workload простые фильтры или сложные join, и как часто растёт число файлов: если соединения редки, границ может хватить, но при регулярных аналитических отчётах с несколькими таблицами отсутствие агрегированных данных ведёт к перерасходу памяти и времени.
Вычисление NDV и формат Puffin
Чтобы получить NDV (number of distinct values), нужно явно запустить сбор статистики. Iceberg сохраняет эти данные в формате Puffin — отдельном файле, который хранит сжатые гистограммы и оценки уникальности. Планировщик запросов затем читает Puffin вместе с метаданными таблицы и использует точные цифры при построении плана.
Без свежего Puffin статистика быстро устаревает после массовых вставок или обновлений. Движок снова начинает работать по приблизительным оценкам, и выигрыш от собранных NDV пропадает. Поэтому важно понимать частоту обновления данных в своей таблице и планировать перерасчёт статистики соответственно. При решении о внедрении стоит взвесить затраты на запуск сбора: если таблица меняется редко, однократный расчёт даёт долгосрочный эффект, а при активных ежедневных загрузках нужно оценивать, окупятся ли регулярные запуски снижением времени запросов и экономией кластерных ресурсов.
Влияние на порядок соединений
Планировщик опирается на NDV при выборе, какая таблица станет driving side в join. Если статистика занижена или отсутствует, он может выбрать меньшую таблицу неправильно и получить декартово произведение на промежуточном этапе. В кластерах с сотнями терабайт это приводит к заметному росту времени выполнения и потребления памяти.
Dremio показывает, что даже простые запросы с двумя-тремя соединениями выигрывают от актуальных NDV, потому что оптимизатор получает реальную картину селективности. Без них приходится добавлять хинты вручную или переписывать запросы, что усложняет поддержку. Для решения брать или не брать статистику ключевой фактор — доля join в типичных запросах и чувствительность SLA к задержкам: если бизнес требует стабильного времени ответа, актуальные NDV снижают риск случайных всплесков нагрузки, тогда как при tolerant к задержкам сценариях можно обойтись без дополнительной обработки.
Особенности применения в российских контурах
В изолированных средах без постоянного доступа к внешним каталогам важно контролировать, где и как часто запускается сбор статистики. Puffin-файлы можно хранить в том же S3-совместимом хранилище, что и данные, поэтому не требуется дополнительная инфраструктура. Командам стоит оценивать, насколько часто меняются таблицы: при ежедневных инкрементальных загрузках перерасчёт NDV раз в сутки или двое обычно достаточен.
Если таблицы обновляются реже, можно запускать сбор по расписанию через Spark или Trino с минимальной нагрузкой на кластер. Главное — отслеживать размер Puffin и не допускать его неограниченного роста, потому что устаревшие оценки вредят планам сильнее, чем их полное отсутствие. Это позволяет получить предсказуемое ускорение запросов без изменения архитектуры озера данных. В российских изолированных контурах решение зависит от доступного окна для фоновых задач и политики хранения: если хранилище ограничено по объёму, нужно следить за балансом между частотой обновления статистики и её точностью, чтобы избежать как лишних затрат, так и деградации планов.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Статистика таблиц Iceberg для планов запросов.
Курс по теме — Каталог курсов Школы Больших Данных