
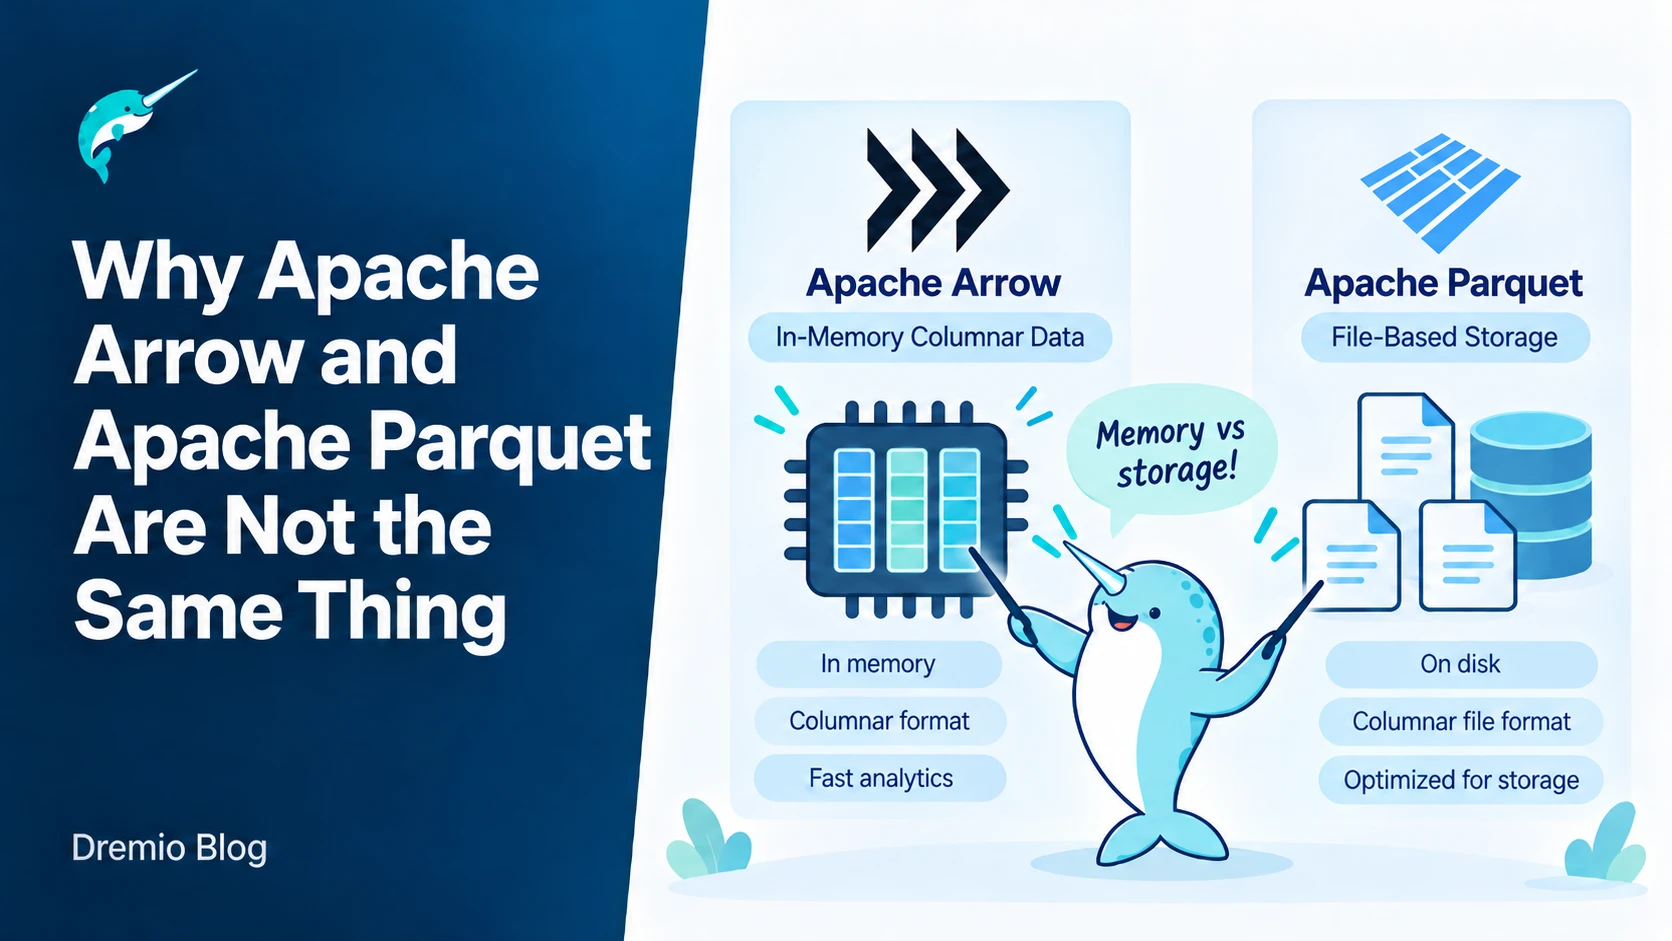
Dremio напомнила, что Parquet отвечает за хранение колонок на диске, а Arrow - за представление тех же колонок в оперативной памяти. Parquet - это колоночный формат для файлов, который сжимает данные и хранит статистику, чтобы сократить объём и ускорить выборку. Arrow - это колон
Delta Lake предлагает отказаться от Hive-стильного сегментирования в облачных хранилищах и перейти к кластеризации данных. Hive-стильное сегментирование подразумевает создание отдельных папок для значений ключевых колонок, например по дате или региону, что приводит к большому чис
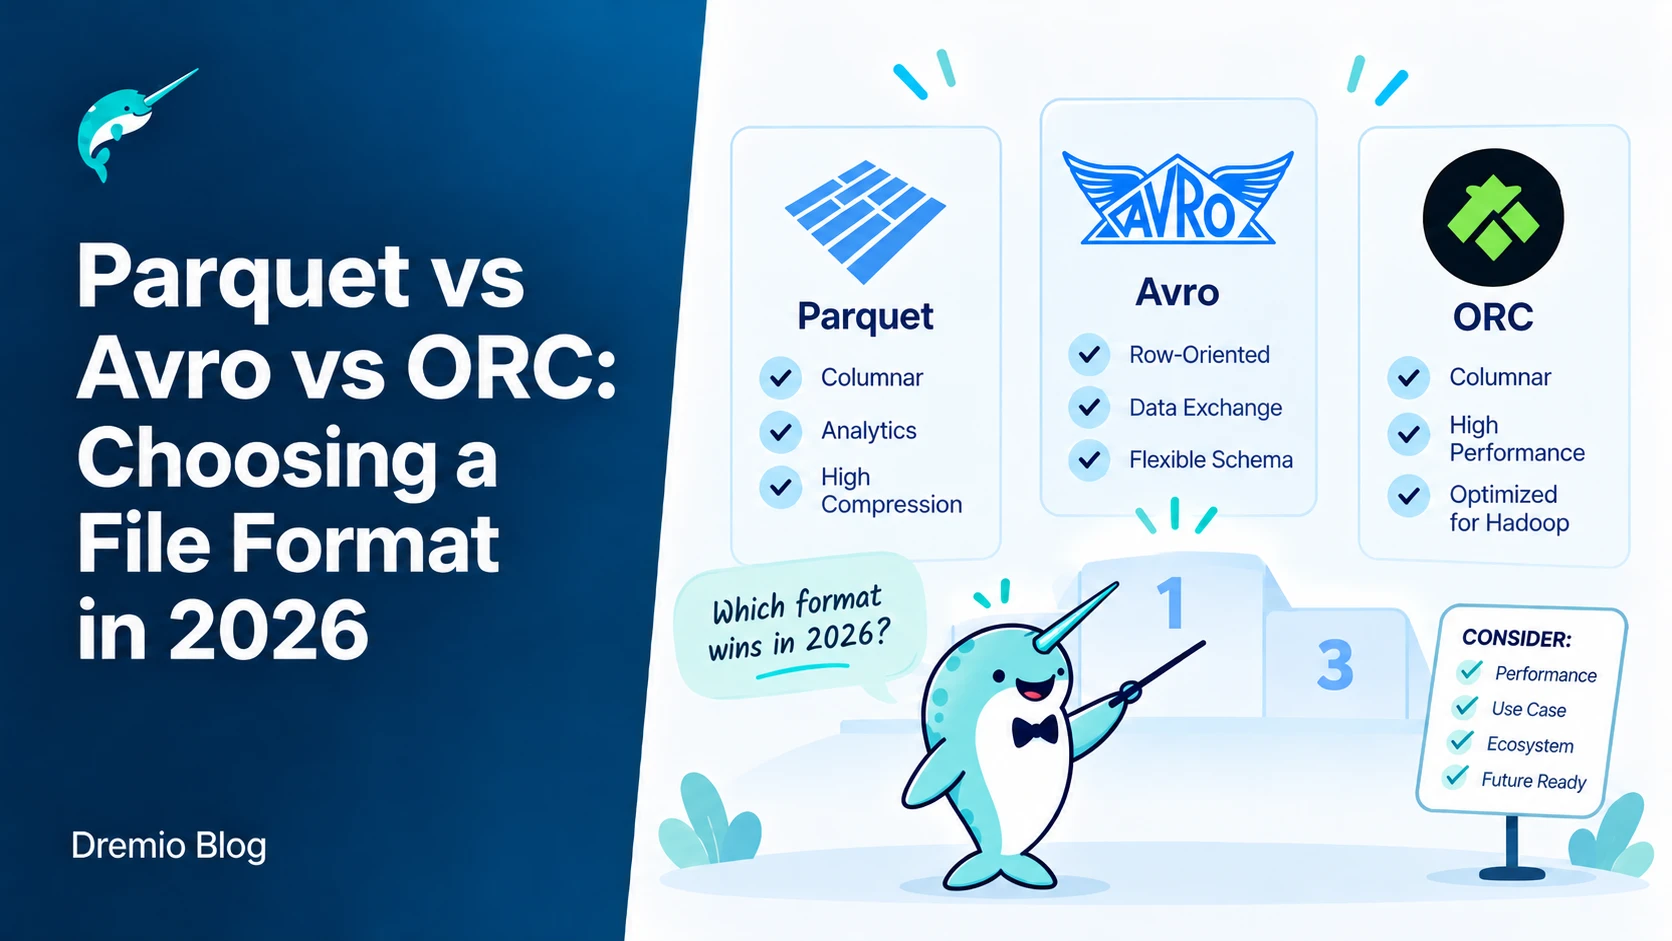
Сравнение Parquet, Avro и ORC помогает инженерам DWH подобрать формат под конкретные нагрузки чтения и записи. Parquet и ORC оптимизированы для аналитических запросов за счёт колоночной организации, Avro лучше справляется с частыми изменениями схемы при потоковой записи. Apache I
Zabbix 8 добавил встроенную поддержку отправки истории измерений в ClickHouse. Это позволяет разгрузить основную PostgreSQL или MySQL от потока сырых значений, сохранив сбор данных, обработку и срабатывание триггеров на сервере. Решение закрывает задачу долгосрочного хранения мет
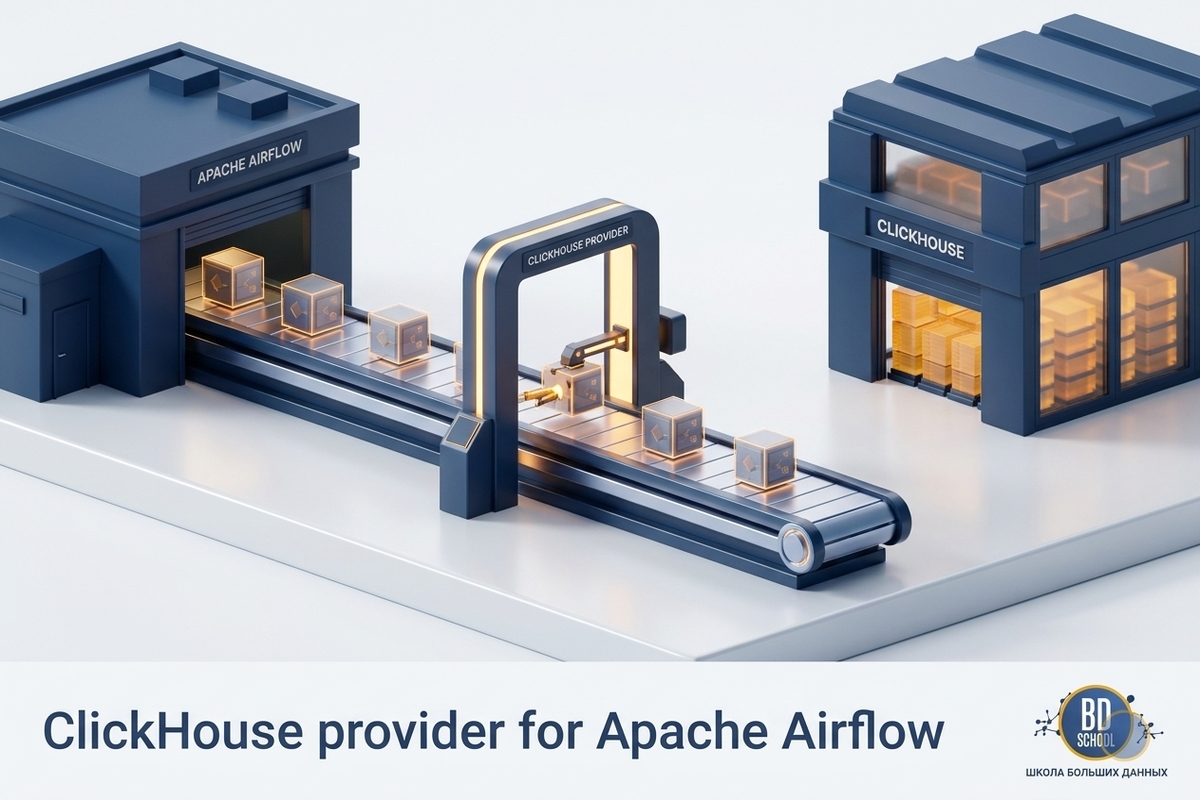
В сентябре 2026 года ClickHouse выпустила ClickHouse provider for Apache Airflow (провайдер ClickHouse для Airflow), официальный пакет apache-airflow-providers-clickhousedb, и интеграция двух популярных инструментов дата-инженера впервые получила поддержку от самих разработчиков СУБД и сообщества Airflow. Новость короткая, а вопросы за ней длинные. Чем провайдер отличается от того, чем DAG ходили...
Apache Beam получил встроенный коннектор DebeziumIO, который позволяет захватывать изменения из баз данных прямо внутри пайплайна. Теперь не требуется запускать Kafka или Kafka Connect для доставки событий CDC. Это упрощает архитектуру, когда нужно обрабатывать вставки, обновлени
OpenReplay заменил Postgres на ClickHouse, чтобы обрабатывать миллиарды событий и до 6 ТБ данных в сутки на одной вертикально масштабируемой машине. Sub-second запросы и автоматическое удаление старых данных через TTL избавили команду от ручных скриптов и блокировок таблиц. Решен
Приложение начинает тормозить, а понять причину сложно, потому что Valkey не даёт прямого доступа к метрикам. Prometheus решает задачу, собирая данные через экспортеры и сохраняя их как временные ряды для запросов PromQL. Это позволяет увидеть давление памяти, отставание реплик и
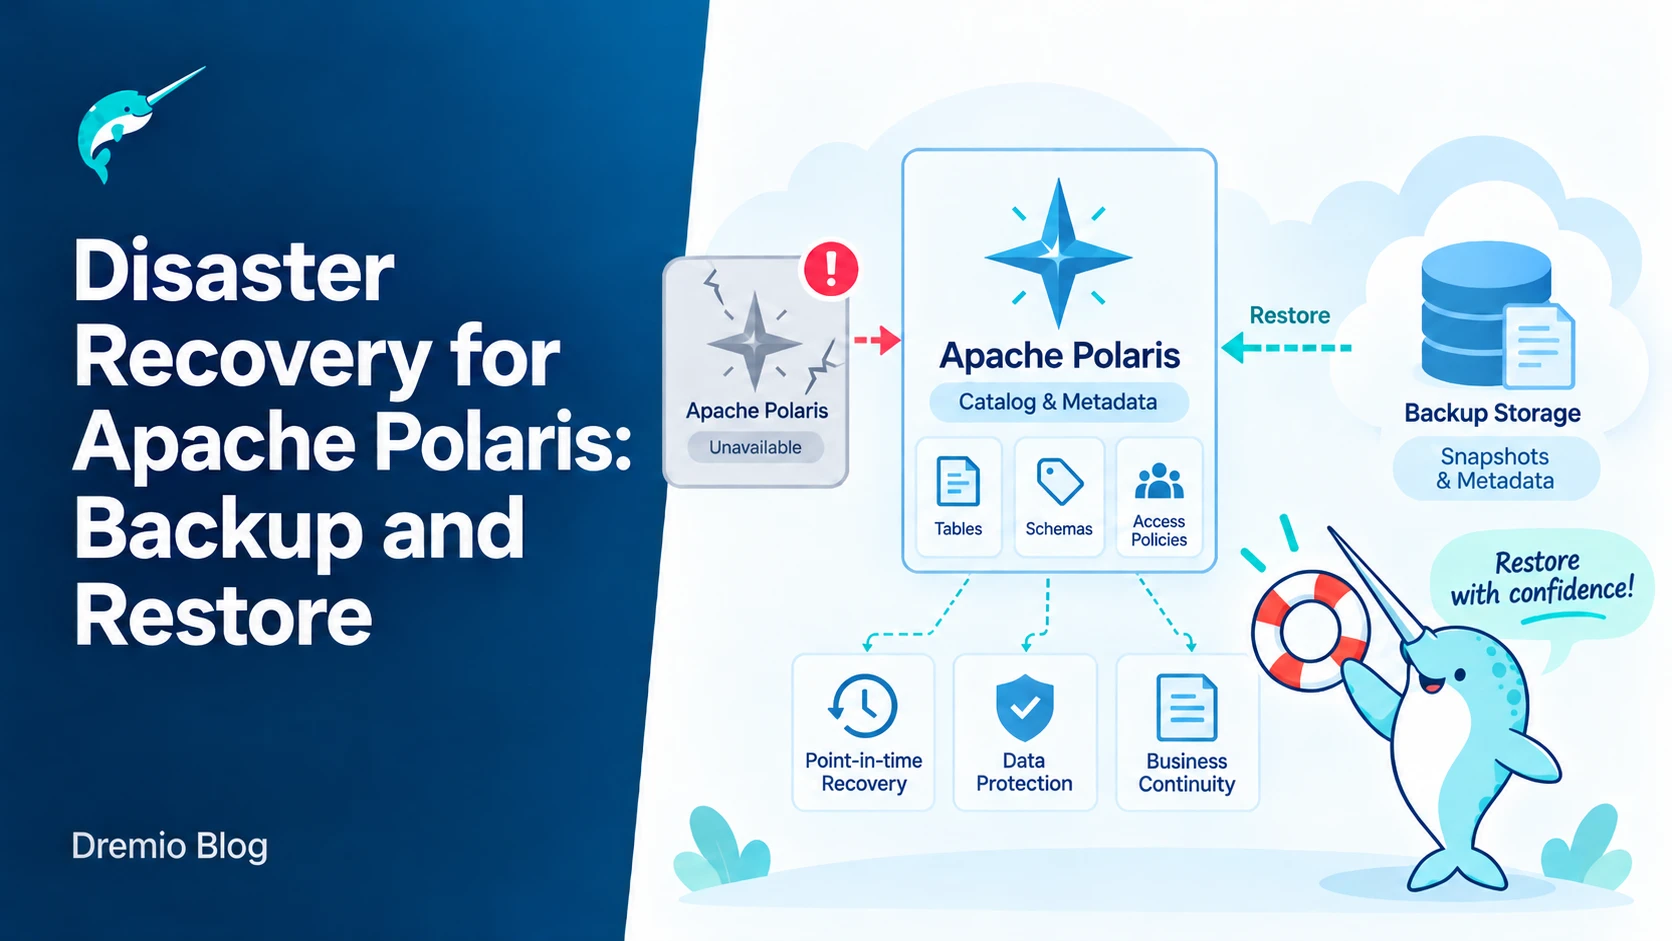
Dremio опубликовала материал о резервном копировании и восстановлении Apache Polaris. Инструмент выступает каталогом для таблиц Iceberg, поэтому отказ затрагивает сразу два независимых слоя: метахранилище на Postgres и файлы в S3. Восстановление требует точной последовательности
ClickHouse выпустил официальный провайдер apache-airflow-providers-clickhousedb. Он позволяет подключать ClickHouse к Airflow через стандартные механизмы без сторонних плагинов и самописного кода. Интеграция построена на ClickHouse Connect и HTTP-интерфейсе, поэтому команды получ
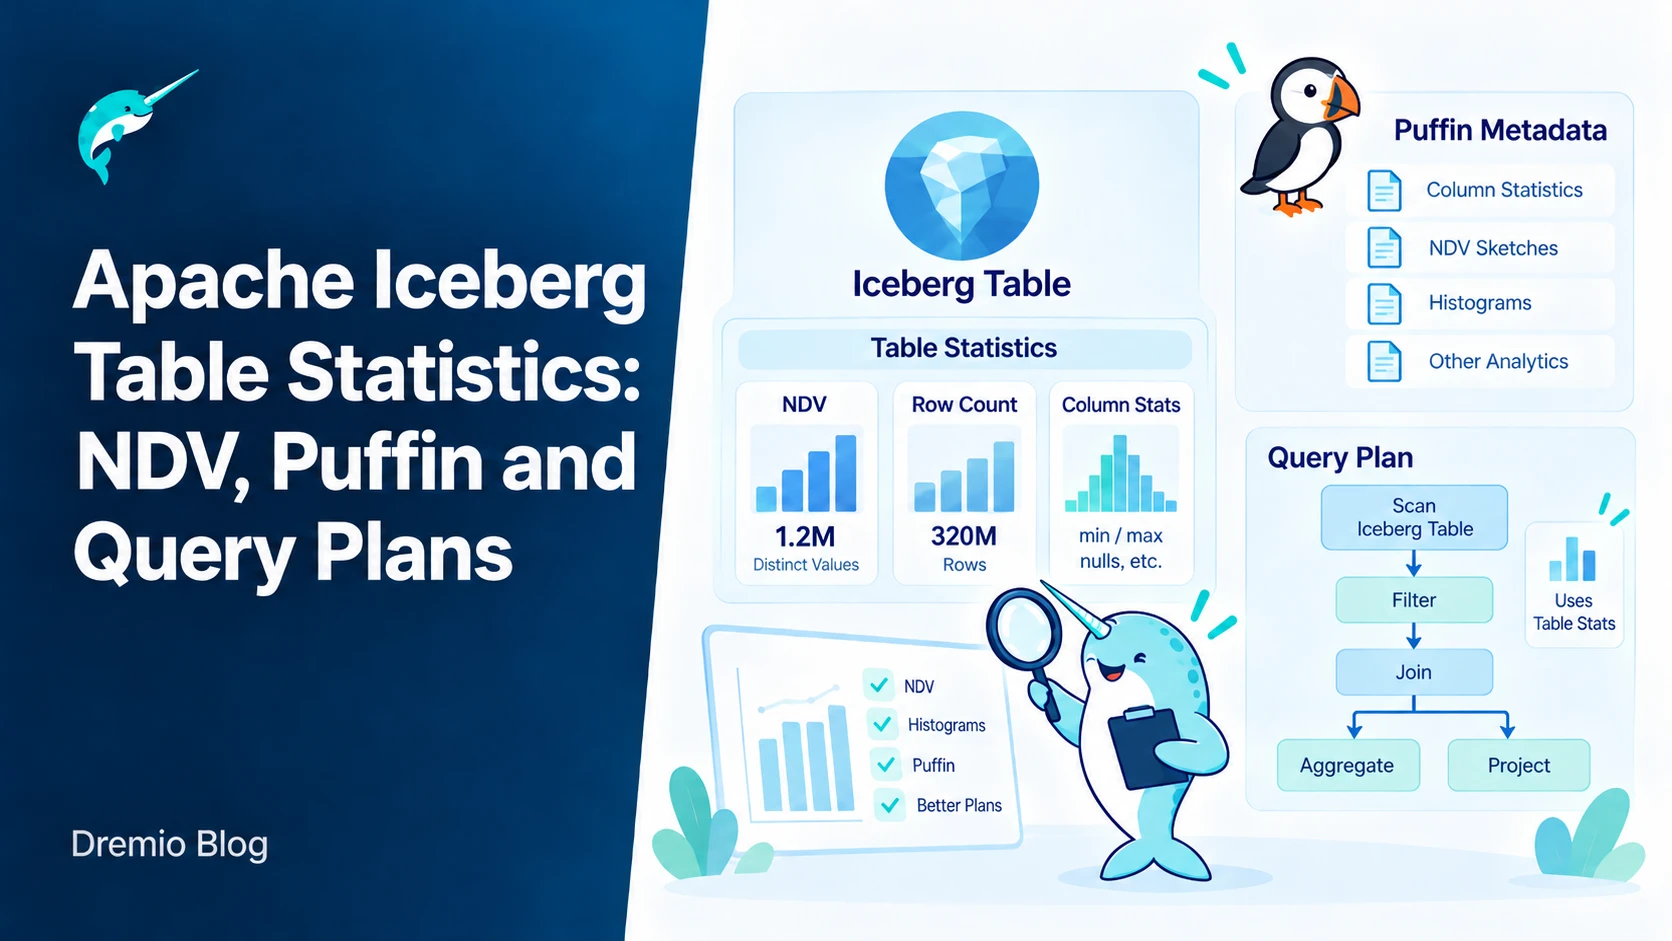
Dremio описала, как Apache Iceberg хранит границы значений на уровне файлов автоматически, но точные NDV-статистики на уровне таблицы требуют отдельного вычисления. Без них планировщик запросов часто выбирает неоптимальный порядок соединений и сканирования, особенно в больших озё
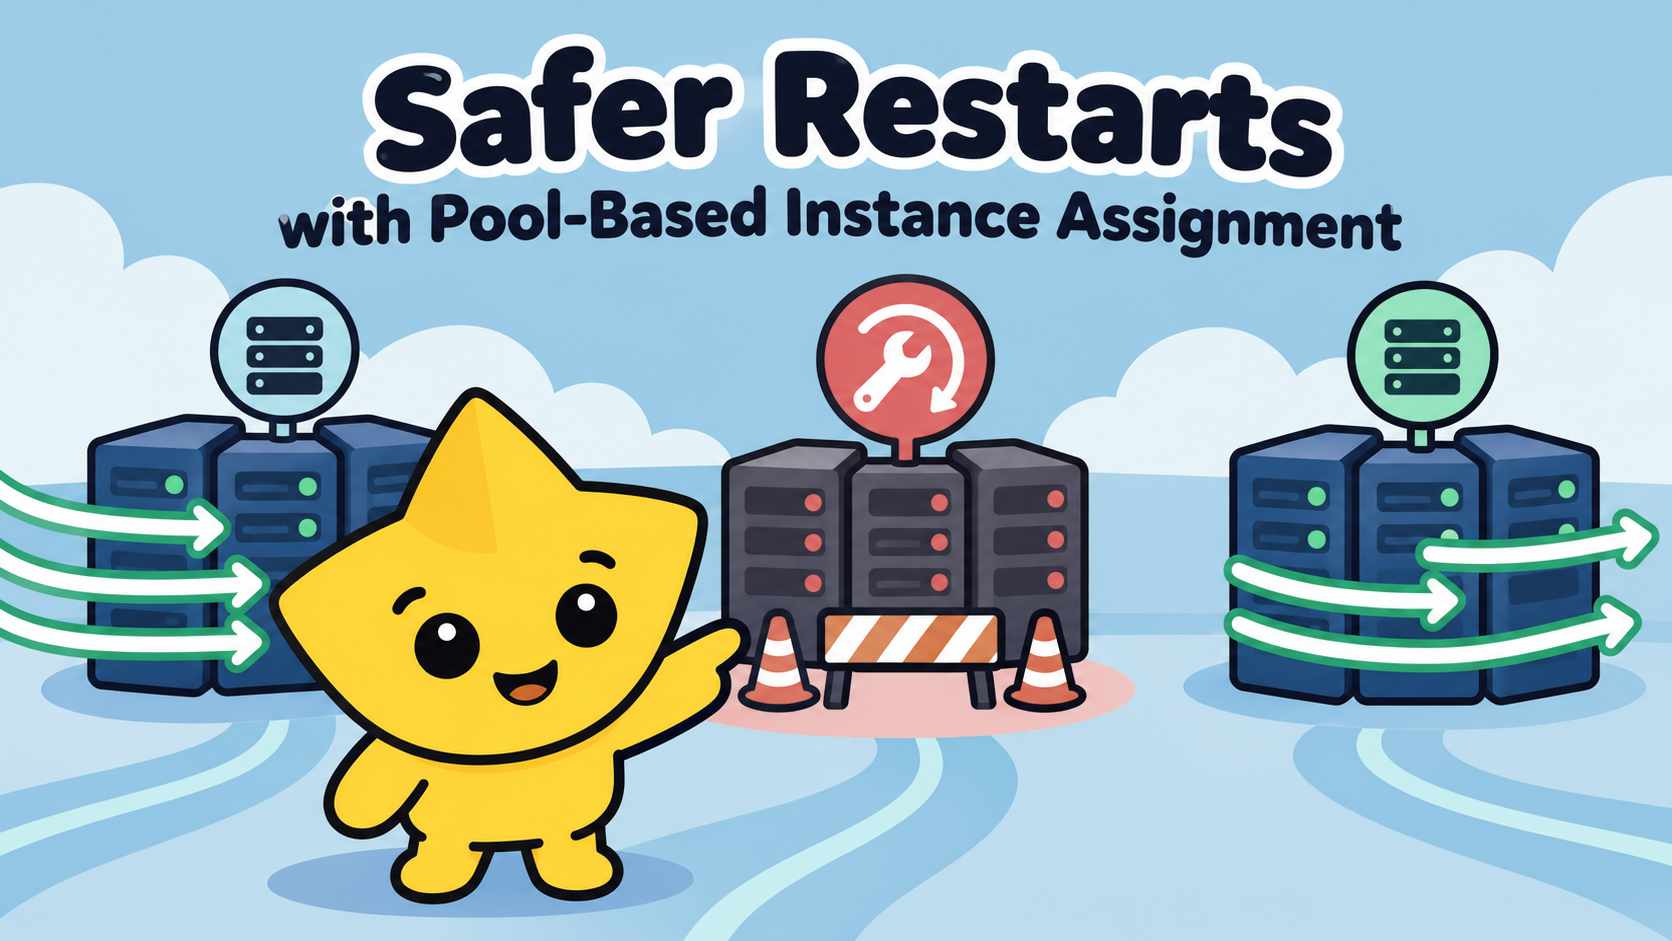
В крупных кластерах Apache Pinot рутинные обновления и перезапуски серверов превращаются в долгую и рискованную процедуру. Pool-based instance assignment решает задачу, позволяя явно группировать серверы в пулы и размещать replica groups так, чтобы отключение целого пула не лишал
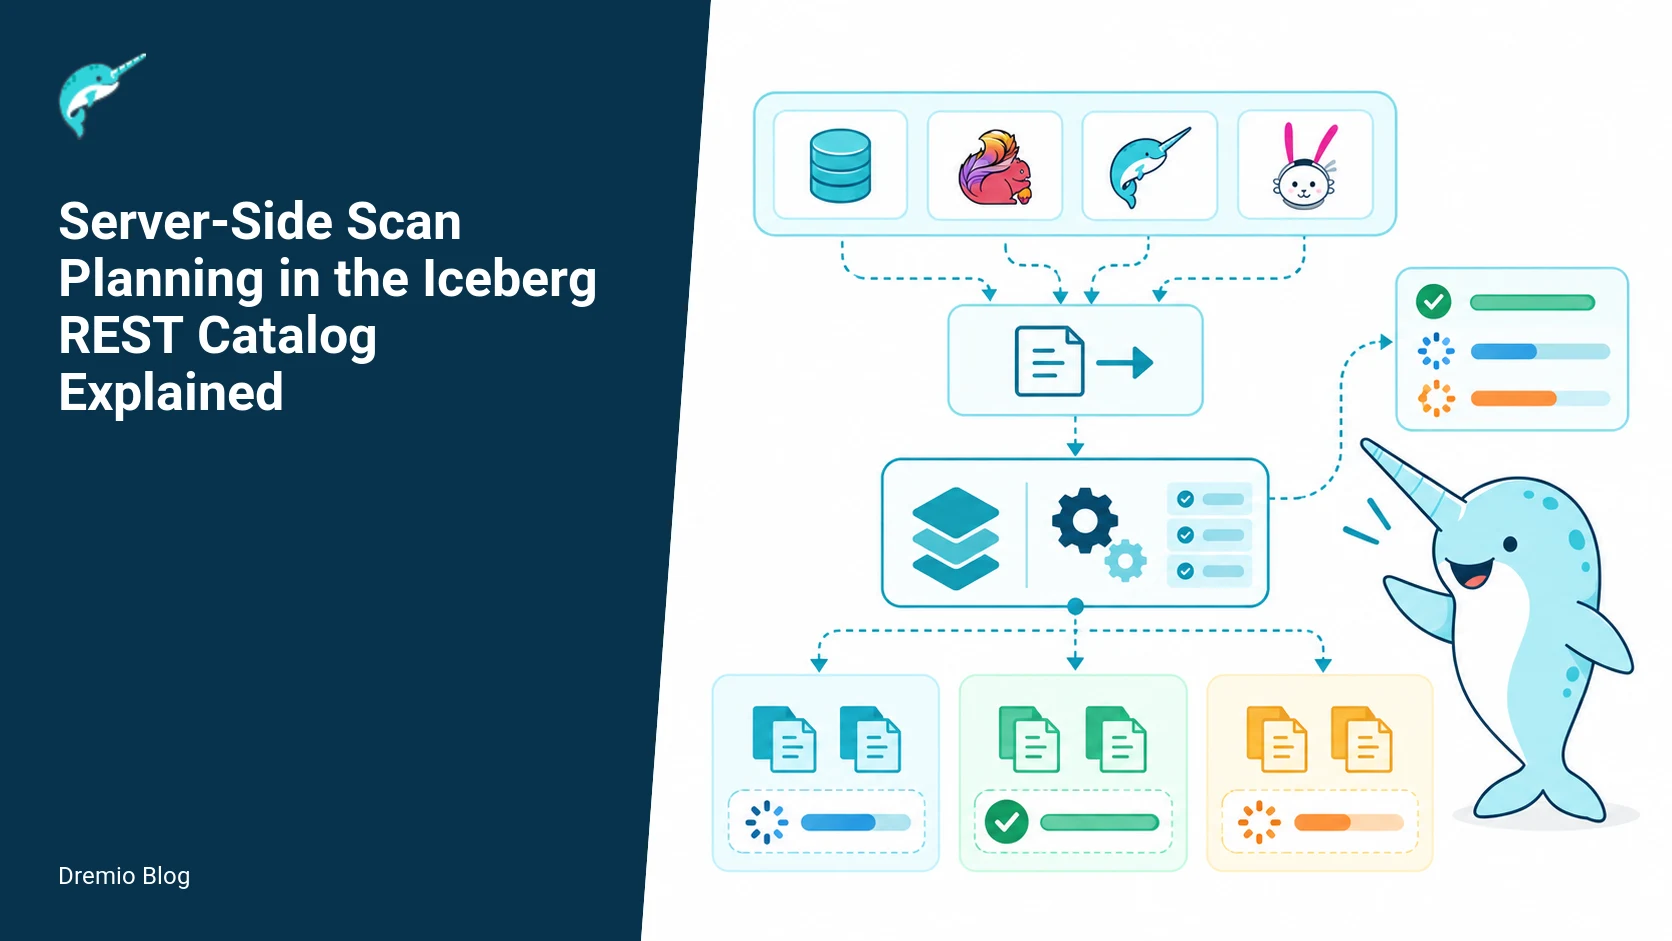
Серверное планирование сканирований переносит основную работу по разбору метаданных и формированию плана запроса с клиента на каталог. Это снижает сетевой трафик и нагрузку на аналитические движки при работе с большими таблицами Iceberg. Подход особенно полезен в распределённых с
ClickHouse исправил причину лишней задержки в 32 мс на простых SELECT-запросах через Native-протокол. После простоя соединения больше двух секунд окно перегрузки TCP сбрасывалось, а несколько мелких пакетов метаданных не помещались в него сразу. Это вызывало дополнительный круг о
VK Tech опубликовала детали реализации своей Data Lakehouse-платформы. Это помогает оценить, как именно отечественное решение справляется с хранением разнородных данных, потоковой обработкой и одновременной работой нескольких вычислительных движков без дублирования информации. Дл
Бенчмарк на машине с двумя ядрами и 5,8 ГБ памяти показал, что для типичных аналитических задач переход на Spark часто избыточен. Вместо кластера можно обойтись DuckDB или Polars, которые справляются с файлами до 5 ГБ без падений по памяти и без настройки JVM. Тест охватил загруз
DuckDB научился хранить в файле базы только определения представлений, которые указывают на Parquet-файлы в объектном хранилище. Такой файл остаётся размером в сотни килобайт независимо от объёма данных и позволяет любому потребителю подключаться к готовым именованным отношениям.
DuckDB предлагает переносить повторяющиеся длинные строки в отдельную таблицу измерений с узкими целочисленными ключами. Агрегация выполняется только по этим ключам, а строки подставляются уже на финальном этапе. Такой приём снижает объём работы хеш-таблицы и уменьшает расход пам
Статья показывает, как компании теряют доверие к дата-агентам после пилота: модель, промпт и метрики меняются, а никто не проверяет, остались ли ответы верными. Решение - создать фиксированный набор «золотых вопросов» с известными ответами и прогонять его при каждом изменении. Та
Pinterest представил механизм partition finalization, который даёт downstream-потребителям явный сигнал о том, что данные за часовой интервал полностью загружены и больше не изменятся. Решение построено на связке Kafka, Flink и Iceberg и решает проблему, которая возникает при пер