 1
Содержание
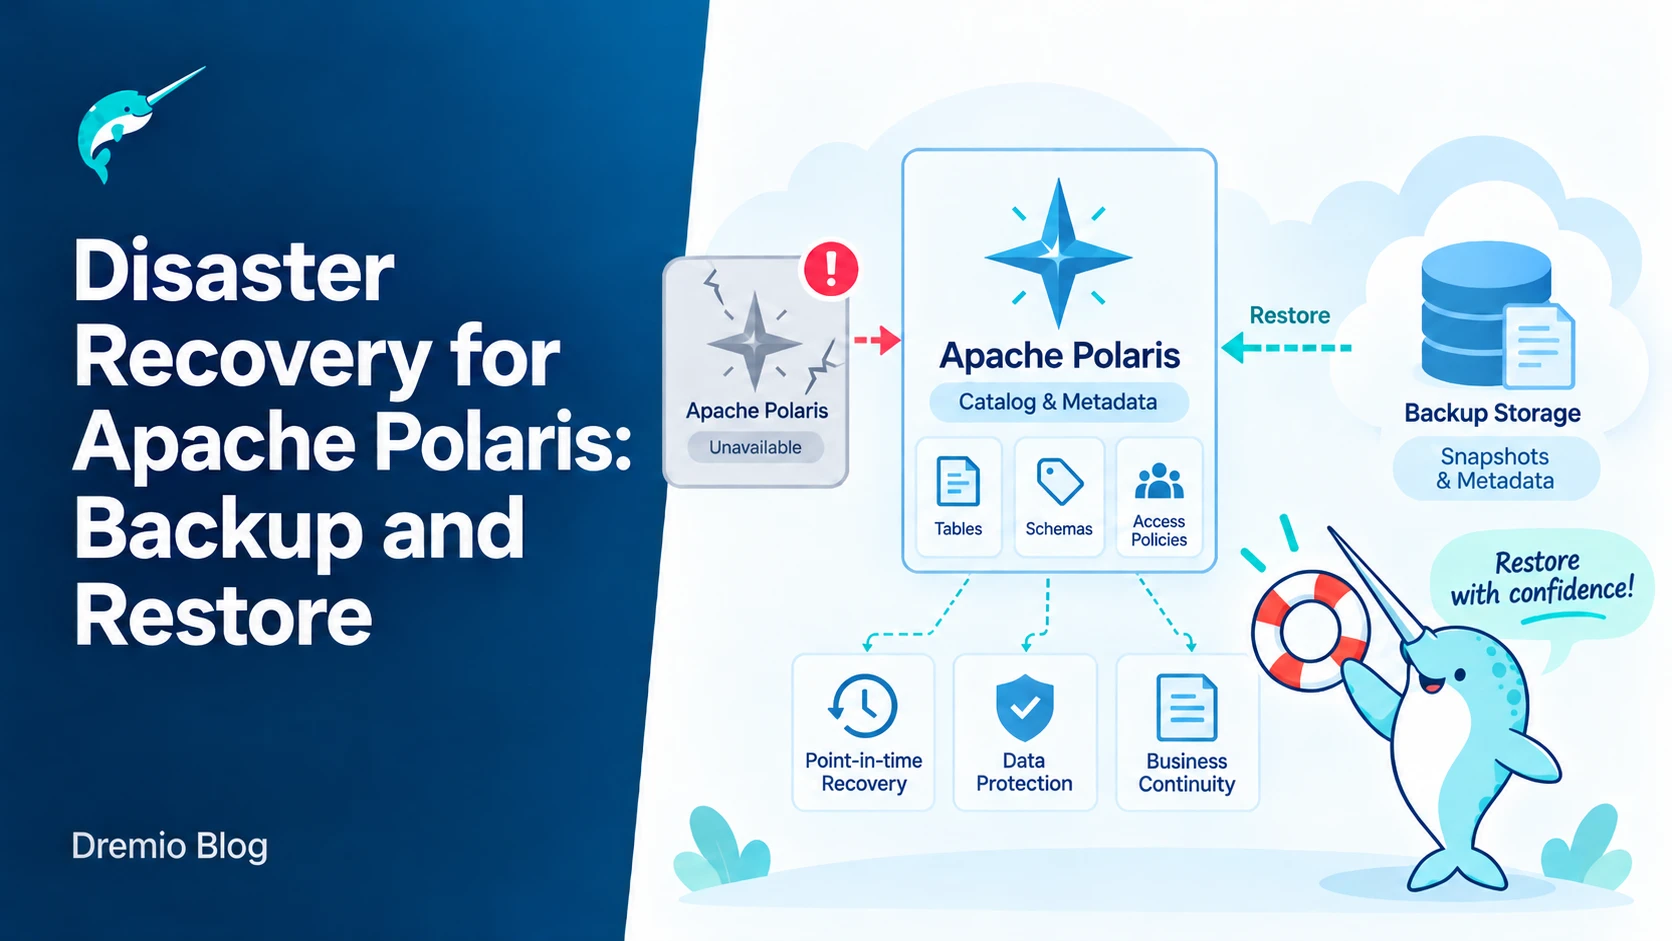
Dremio опубликовала материал о резервном копировании и восстановлении Apache Polaris. Инструмент выступает каталогом для таблиц Iceberg, поэтому отказ затрагивает сразу два независимых слоя: метахранилище на Postgres и файлы в S3. Восстановление требует точной последовательности действий, иначе ссылки на данные потеряются или появятся дубликаты. Статья полезна инженерам, которые уже используют Polaris в продакшене и хотят понять реальные риски. Перед внедрением в бой важно оценить, насколько компания готова к таким отказам и есть ли ресурсы на регулярное тестирование процедур. Без этого выбор Polaris может привести к неожиданным простоям и потере доверия к данным.
Метахранилище и объектное хранилище
Polaris хранит метаданные таблиц Iceberg в Postgres, а сами parquet-файлы и манифесты лежат в S3. При сбое нужно восстанавливать оба компонента по отдельности, потому что они не связаны транзакциями. Метахранилище отвечает за описание структуры таблиц, версий и прав, а объектное хранилище — только за сами файлы. Резервная копия Postgres содержит описания таблиц, схемы партиционирования и ссылки на файлы, но не сами данные. Объектное хранилище, напротив, хранит только файлы без контекста каталога. Если восстановить только один слой, запросы Iceberg либо не найдут таблицы, либо увидят устаревшие версии. Это разделение важно учитывать при выборе стратегии: оно упрощает масштабирование, но усложняет обеспечение согласованности. Размер метаданных обычно невелик, поэтому дамп Postgres можно делать чаще, чем снапшоты S3. При этом важно сохранять не только таблицы, но и права доступа и настройки каталога. В S3 достаточно версионирования бакетов и периодических снапшотов, однако нужно учитывать, что удалённые файлы могут остаться в старых версиях. Разделение слоёв упрощает планирование, но требует отдельного мониторинга целостности каждого из них. Инженерам стоит заранее решить, какой уровень RPO приемлем, чтобы не тратить лишние ресурсы на избыточное копирование.
Последовательность восстановления
Сначала поднимают Postgres и заливают последнюю резервную копию метаданных. Только после этого проверяют, что все ссылки на файлы в S3 актуальны. Если начать с объектного хранилища, Polaris может указывать на несуществующие объекты, и клиенты получат ошибки при сканировании таблиц. После восстановления Postgres запускают проверку каталога, чтобы убедиться в отсутствии битых ссылок. Затем восстанавливают файлы из снапшотов S3, если они были повреждены или удалены. Критично соблюдать порядок: метаданные всегда первыми, потому что они определяют, какие файлы нужны. Обратная последовательность приводит к появлению «осиротевших» данных, которые занимают место, но не видны в каталоге. Восстановление также требует остановки всех клиентов на время заливки метаданных, иначе возможны конфликты версий. Такой подход помогает оценить реальное время восстановления и понять, стоит ли Polaris в текущей инфраструктуре или лучше рассмотреть альтернативы с более тесной интеграцией слоёв. Без чёткого плана компания рискует получить длительные простои при каждом серьёзном сбое.
Скрытые риски и российский контекст
Одна из проблем, которую редко планируют заранее, — рассинхронизация версий между Postgres и S3 при частичном отказе. Если дамп метаданных сделан на час раньше последнего снапшота бакета, в каталоге могут появиться ссылки на файлы, которых ещё нет. В российском контуре эту ситуацию усугубляет использование S3-совместимых хранилищ вроде VK Cloud или self-hosted MinIO. Их снапшоты и политики версионирования работают иначе, чем в AWS, поэтому нужно дополнительно тестировать совместимость дампов. Ещё один момент — задержки репликации Postgres в распределённых кластерах. При восстановлении на резервном сайте разница в данных может достигать нескольких минут, и это нужно учитывать при выборе точки восстановления. Инженерам стоит регулярно проверять процедуру на тестовых стендах, потому что автоматические скрипты часто пропускают проверку целостности ссылок Iceberg. Эти риски напрямую влияют на решение о внедрении: если в компании нет практики сквозного тестирования и мониторинга двух слоёв, Polaris может оказаться слишком сложным для поддержки. В противном случае понимание этих нюансов позволяет построить надёжную стратегию и снизить вероятность потери данных.
Источник
Это краткий разбор материала Dremio. Полная версия с примерами кода, схемами и деталями реализации — в оригинале: Восстановление Apache Polaris после сбоев.
Курс по теме — Каталог курсов Школы Больших Данных