
 112
Содержание
- Что такое Stream Processing и какую задачу решает
- Архитектура потоковой обработки, источники, состояние и приёмники
- Принцип работы под капотом
- Checkpointing и барьеры потока
- Event time, processing time и watermark для опоздавших событий
- Эволюция подхода, от разделения stream и batch к унификации
- Сценарии использования и где не подходит
- Практика, минимальный процессор на Python поверх Kafka
- Заключение
- Референсные ссылки
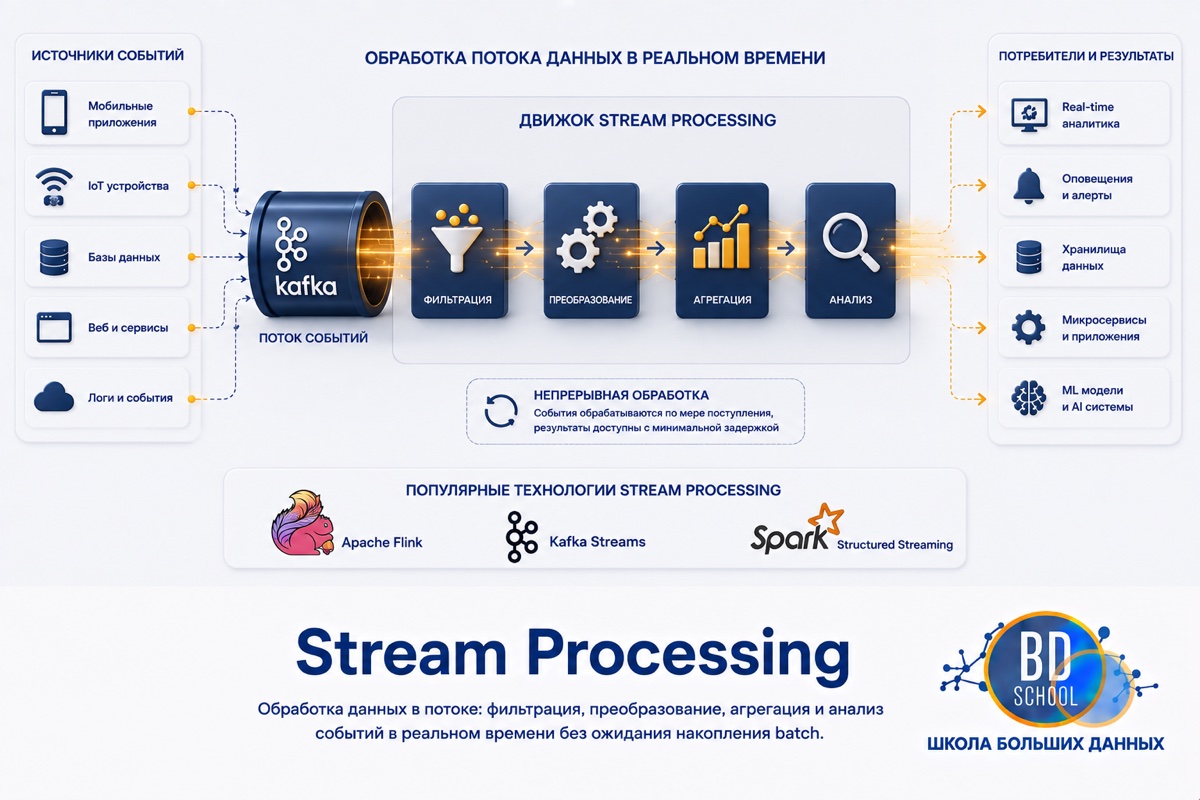
Потоковая обработка (stream processing) это вычисления над непрерывным, в принципе бесконечным (unbounded) потоком событий. Результат обновляется по мере поступления данных, а не после того, как весь массив целиком собран и лёг на диск. Термин описывает архитектурную парадигму, а не продукт с версией и датой релиза: эталонной open-source реализацией здесь выступает Apache Flink, схожие идеи реализуют Kafka Streams, Spark Structured Streaming и Apache Samza. Разбор здесь смещён на state, watermark и checkpointing, три механизма, без которых потоковая обработка выродилась бы в построчную обработку без памяти и без гарантий.
Что такое Stream Processing и какую задачу решает
Граница между потоковой и пакетной обработкой (batch processing) проходит не по скорости, а по завершённости входа. Пакетное задание запускается над данными, которые уже собраны и никуда не денутся, поэтому его можно перезапустить с тем же результатом. Потоковая обработка работает над входом, у которого формально нет конца, поток событий продолжает поступать, пока система жива, и ждать «пока всё соберётся» бессмысленно.
Отсюда практическая задача парадигмы. Вычисление должно давать корректный промежуточный результат в любой момент, переживать падение узла без потери и без двойного счёта и учитывать, что события приходят не в том порядке, в котором произошли. Вопрос «сколько заказов оформлено за последний час» в batch решается перечитыванием таблицы, а в stream processing требует хранить состояние счётчика между событиями и знать, когда час можно считать закрытым.
Сравнение конкретных движков уже разобрано в статье «Сходства и различия Kafka Streams, Spark Streaming, Flink, Storm, Samza». Здесь внимание направлено на общий для них механизм под капотом, который в обзорах отдельных API обычно упоминается вскользь.
Архитектура потоковой обработки, источники, состояние и приёмники
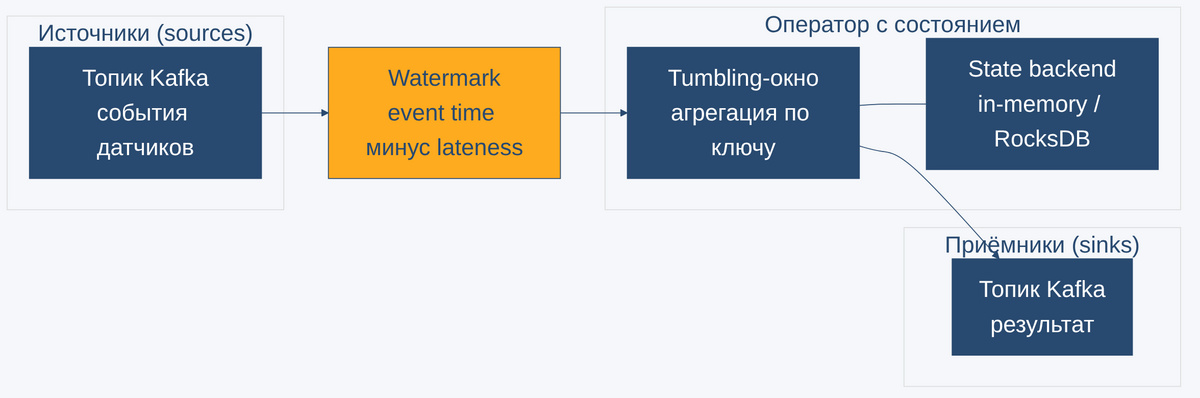
Каркас потоковой системы держится на трёх ролях. Источники (sources) принимают события в поток, например из топика Kafka. Операторы (operators, transformations) выполняют вычисления над потоком, от фильтрации до оконных агрегаций и джойнов. Приёмники (sinks) выводят результат наружу, в базу, в другой топик или во внешний API.
Стейтлес-операторы, фильтрация, проекция полей, простое преобразование записи, обрабатывают каждое событие независимо и не хранят ничего между вызовами. Операторам с памятью, join, агрегация, дедупликация, требуется состояние (state), хранящее результат между событиями одного ключа. В документации Flink о stateful stream processing состояние партиционируется вместе с данными по ключу (keyed state), это даёт локальность вычислений и консистентность без накладных расходов транзакционного протокола.
Хранит состояние state backend, конфигурируемый механизм, а не жёстко зашитая часть движка. Простой вариант это хеш-таблица в памяти процесса, быстрая, но ограниченная объёмом RAM и живущая до перезапуска. Промышленный вариант это встраиваемое хранилище ключ-значение вроде RocksDB на диске, которое переживает перезапуск и отдаёт консистентные снапшоты состояния, на этом снапшоте строится отказоустойчивость из следующего раздела.
Apache Kafka для инженеров данных
Код курса
DEVKI
Ближайшая дата курса
7 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Принцип работы под капотом
Дальше разобрано, как система переживает сбой узла, не теряя и не задваивая события, и как она решает, когда очередное окно агрегации можно закрыть, если события идут не по порядку.
Checkpointing и барьеры потока
Отказоустойчивость в Flink построена на непрерывных распределённых снапшотах состояния в сочетании с возможностью переиграть (replay) часть потока. Чекпоинт фиксирует конкретную позицию в каждом входном потоке вместе с состоянием всех операторов на этот момент. Снимок запускают барьеры (stream barriers), маркеры, которые движутся вместе с записями, разделяя поток на снапшот-батчи без остановки обработки. Барьеры никогда не обгоняют записи, они текут строго в том же порядке.
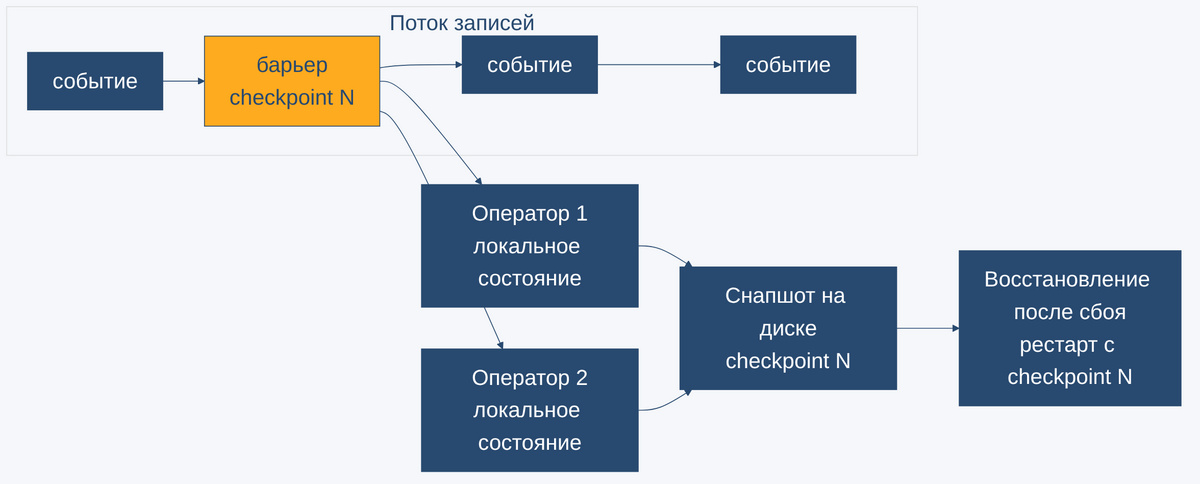
Оператор с несколькими входами обязан выровнять (align) барьеры от всех входящих потоков, прежде чем сделать собственный снимок, это и даёт согласованный чекпоинт на всём графе вычислений, а не разрозненные снимки отдельных операторов. Выравнивание стоит задержки, потому что оператор ждёт самый медленный вход. Unaligned checkpointing снимает это ограничение, барьер обгоняет данные в полёте, а они сохраняются как часть состояния оператора, задержка снижается ценой роста нагрузки на диск.
При падении узла Flink перезапускает граф вычислений с последнего успешного чекпоинта, восстанавливает состояние операторов и сбрасывает входные потоки на сохранённую позицию. Уже зачекпоинченное состояние переигранные записи не трогают, это и источник гарантии exactly-once. У операторов с одним входом, где нечего выравнивать, exactly-once получается даже в режиме at-least-once, а многовходовым операторам без выравнивания при восстановлении грозят дубликаты. Savepoints, те же чекпоинты, но запускаемые вручную, используют тот же механизм для планового обновления приложения или миграции кластера и, в отличие от обычных чекпоинтов, не истекают автоматически.
Apache Kafka: администрирование кластера
Код курса
KAFKA
Ближайшая дата курса
14 декабря, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Event time, processing time и watermark для опоздавших событий
У каждого события есть два времени. Processing time это момент, когда запись физически обрабатывается на конкретной машине, по её системным часам, простой, но недетерминированный в распределённой системе вариант, потому что зависит от загрузки узла и сетевых задержек. Event time встроено в само событие, например поле времени измерения датчика, и не меняется от того, как долго запись добиралась до процессора. Оно даёт воспроизводимый результат независимо от порядка доставки, но требует координации через watermark.
Watermark(t) это утверждение системы, что событийное время в потоке достигло t и новых записей с меткой не позже t уже не ожидается. Оконная агрегация с привязкой к event time копит записи по фактическому времени события независимо от порядка прихода, а закрывается только тогда, когда watermark проходит конец окна. Часовое окно в итоге содержит все записи с меткой внутри этого часа, независимо от того, в каком порядке они физически пришли.
Событие, добравшееся после того, как watermark уже прошёл его метку, считается опоздавшим (late event). У оконных операторов есть настройка допустимого опоздания (allowed lateness), она даёт запаздывающим записям шанс попасть в уже закрытое окно вместо безусловного отбрасывания. Чем шире допуск, тем дольше окно остаётся открытым и тем позже приходит результат, здесь всегда выбор между полнотой данных и задержкой ответа.
Эволюция подхода, от разделения stream и batch к унификации
Долгое время потоковая и пакетная обработка считались разными мирами со своими движками и своим API. Пакетный конвейер писался под конечный, полностью собранный набор данных, а потоковый под принципиально бесконечный вход, и код одного было трудно превратить в код другого без переписывания.
Современные движки, в том числе Flink, унифицируют эту границу иначе. Ограниченный (bounded) набор данных рассматривается как частный случай неограниченного (unbounded) потока, у которого просто есть конец. Один и тот же API и одни и те же операторы работают в обоих режимах, разница сводится к тому, знает ли движок заранее момент завершения входа.
| Критерий | Batch processing | Stream processing |
|---|---|---|
| Вход | Ограниченный (bounded), набор данных заранее собран целиком | Неограниченный (unbounded), новые события поступают непрерывно |
| Момент запуска | По расписанию или вручную, после того как данные собраны | Постоянно работающий процесс, реагирует на каждое новое событие |
| Модель состояния | Вычисляется заново при каждом запуске | Инкрементальное состояние копится между событиями одного ключа |
| Опоздавшие данные | Не существует как понятие, весь набор уже на месте | Обрабатываются через watermark и допустимое опоздание окна |
| Отказоустойчивость | Перезапуск задания с нуля над тем же набором | Восстановление из чекпоинта без пересчёта всей истории |
Табличное сравнение показывает разницу подходов, а не превосходство одного над другим. Инкрементальное состояние и watermark нужны там, где вход бесконечен и результат нужен без задержки на полный пересчёт, для конечного набора это неоправданная сложность.
Сценарии использования и где не подходит
Область, где потоковая обработка раскрывается полностью, это задачи с состоянием (stateful). Оконные агрегации, джойны нескольких потоков, дедупликация записей и обнаружение паттернов в последовательности событий, например цепочки мошеннических транзакций, требуют помнить контекст между отдельными событиями, и без state и checkpointing такую логику пришлось бы городить руками поверх внешней базы. Туда же относится обучение ML-моделей на потоке признаков, когда модель дообучается по мере поступления новых данных, а не батчем раз в сутки.
Простые запросы с фильтрацией или проекцией полей обычно stateless, каждое событие обрабатывается независимо от соседей, и полноценный движок с состоянием и чекпоинтами для такой задачи избыточен, роутер сообщений справится дешевле.
Официальных формулировок вида «здесь stream processing не годится» документация Flink не даёт, граница проводится по требованиям задачи. Держать постоянно работающий кластер с состоянием ради отчёта, который нужен раз в сутки и допускает часовую задержку, не окупается, тот же результат посчитает batch-джоба за минуты.
Практика, минимальный процессор на Python поверх Kafka
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо не оборачивает Kafka Streams или Flink, а собирает минимальный процессор с нуля, чтобы показать голый механизм tumbling-окна, watermark и восстановления из чекпоинта. Стенд переиспользован из статьи про event streaming, брокер apache/kafka 4.3.0 в режиме KRaft, топик демо создаётся явно командой kafka-topics.sh —create, клиент confluent-kafka 2.15.0.
Продюсер шлёт 14 событий трёх датчиков не по порядку event time, включая два события, которые придут уже после того, как их окно закроется по watermark.
# confluent-kafka 2.15.0, Kafka 4.3.0 (образ apache/kafka, стенд event_streaming),
# прогнано на стенде 2026-08-27
"""
Продюсер для демо потоковой обработки: шлёт события температурных датчиков
намеренно не по порядку event time, включая пару "опоздавших" событий,
чтобы процессор (processor.py) мог показать механизм watermark и tumbling-окна.

Топик stream_processing_events создаётся заранее (autocreate выключен на стенде):
    docker exec kafka /opt/kafka/bin/kafka-topics.sh \
        --create --topic stream_processing_events \
        --bootstrap-server localhost:9092 --partitions 1 --replication-factor 1
"""
import json
import sys
import time

from confluent_kafka import Producer

TOPIC = "stream_processing_events"
BOOTSTRAP = "localhost:9092"

# (sensor_id, event_time_sec, value). event_time, условная шкала в секундах от
# начала демо, а не время настенных часов: так прогон воспроизводим независимо
# от того, когда его реально запустили. Порядок в списке, порядок ОТПРАВКИ,
# то есть порядок прихода в топик, и он умышленно не совпадает с порядком
# event_time (сеть и разные датчики доставляют события вразнобой).
EVENTS = [
    ("s1", 2, 20.0),
    ("s1", 5, 21.0),
    ("s2", 1, 15.0),
    ("s1", 12, 22.0),
    ("s2", 8, 16.0),
    ("s1", 9, 23.0),
    ("s3", 15, 30.0),
    ("s1", 3, 19.5),   # опоздавшее: придёт после того, как окно [0,10) уже закроется по watermark
    ("s2", 18, 17.0),
    ("s1", 22, 24.0),
    ("s3", 25, 31.0),
    ("s2", 13, 16.5),  # опоздавшее: окно [10,20) к этому моменту уже закрыто
    ("s1", 45, 26.0),  # резкий скачок вперёд продвигает watermark и закрывает окно [20,30)
    ("s2", 41, 18.0),
]


def delivery_report(err, msg):
    if err is not None:
        print(f"ошибка доставки: {err}", file=sys.stderr)


def main():
    producer = Producer({"bootstrap.servers": BOOTSTRAP})
    t0 = time.time()
    for sensor_id, event_time, value in EVENTS:
        payload = json.dumps({
            "sensor_id": sensor_id,
            "event_time": event_time,
            "value": value,
        }).encode("utf-8")
        producer.produce(TOPIC, key=sensor_id.encode("utf-8"), value=payload,
                          callback=delivery_report)
        producer.poll(0)
    producer.flush(10)
    elapsed = time.time() - t0
    print(f"отправлено {len(EVENTS)} событий в '{TOPIC}' за {elapsed:.3f} с")


if __name__ == "__main__":
    main()
Процессор считает средний показатель датчика в tumbling-окнах по 10 условных секунд event time. Watermark в демо это максимальный увиденный event_time минус допустимое опоздание в 5 секунд (LATENESS_SEC), окно закрывается, как только watermark проходит его конец. После каждого сообщения offset, состояние окон и watermark атомарно пишутся в checkpoint.json, поэтому при рестарте процессор продолжает с сохранённой позиции. Флаг —crash-after детерминированно имитирует падение процесса после N сообщений.
# confluent-kafka 2.15.0, Kafka 4.3.0 (образ apache/kafka, стенд event_streaming),
# прогнано на стенде 2026-08-27
"""
Минимальный процессор потока с нуля (не обёртка вокруг Kafka Streams/Flink):
считает tumbling-агрегат (среднее по датчику) по event time, закрывает окно
только после прохождения watermark, периодически сбрасывает состояние в файл
и восстанавливается из него после "падения".

Механизм:
  - watermark = максимальный увиденный event_time минус допустимое опоздание
    (LATENESS_SEC). Событие с окном, чей конец уже <= watermark, считается
    опоздавшим и не учитывается в агрегате.
  - Окно закрывается (агрегат печатается и убирается из состояния), когда
    watermark проходит его конец. Однопартиционный топик даёт один глобальный
    watermark, с несколькими партициями в реальных системах берётся минимум
    watermark по всем партициям источника.
  - Чекпоинт (offset, состояние окон, watermark, счётчик опоздавших) пишется
    в JSON атомарно (tmp-файл + os.replace) после каждого сообщения. При
    старте, если чекпоинт есть, процессор восстанавливает состояние и
    продолжает читать топик с сохранённого offset+1, не пересчитывая уже
    закрытые окна заново.
  - Флаг --crash-after имитирует падение процесса после N обработанных
    сообщений С НАЧАЛА ВСЕГО ПРОГОНА (детерминированно, для воспроизводимой
    демонстрации восстановления вместо реального kill -9 в терминале).
  - Конец потока в этом демо определяется фиксированным числом событий
    (--expected-count), а не таймаутом простоя: источник конечен и заранее
    известен. В боевой системе конец обычно не наступает, и "закрытие всех
    окон" делается сдвигом watermark на +бесконечность при штатной остановке
    источника, а не по счётчику.
"""
import argparse
import json
import os
import sys

from confluent_kafka import Consumer, TopicPartition

TOPIC = "stream_processing_events"
BOOTSTRAP = "localhost:9092"
CHECKPOINT_PATH = "checkpoint.json"

WINDOW_SIZE_SEC = 10
LATENESS_SEC = 5


def load_checkpoint():
    if not os.path.exists(CHECKPOINT_PATH):
        return None
    with open(CHECKPOINT_PATH, "r", encoding="utf-8") as f:
        return json.load(f)


def save_checkpoint(offset, state, watermark, emitted, late_dropped, processed_count):
    data = {
        "offset": offset,
        "state": state,
        "watermark": watermark,
        "emitted": sorted(emitted),
        "late_dropped": late_dropped,
        "processed_count": processed_count,
    }
    tmp_path = CHECKPOINT_PATH + ".tmp"
    with open(tmp_path, "w", encoding="utf-8") as f:
        json.dump(data, f, ensure_ascii=False)
    os.replace(tmp_path, CHECKPOINT_PATH)


def close_windows(state, watermark, emitted):
    """Закрывает окна, чей конец уже пройден watermark. Возвращает число закрытых."""
    closed = 0
    for key in sorted(state.keys(), key=lambda k: (int(k.split("|")[1]), k.split("|")[0])):
        sensor_id, window_start_str = key.split("|")
        window_start = int(window_start_str)
        window_end = window_start + WINDOW_SIZE_SEC
        if window_end <= watermark and key not in emitted:
            agg = state.pop(key)
            avg = agg["sum"] / agg["count"]
            emitted.add(key)
            closed += 1
            print(f"[emit] sensor={sensor_id} window=[{window_start},{window_end}) "
                  f"count={agg['count']} avg={avg:.2f} watermark={watermark}")
    return closed


def process_event(payload, state, watermark, emitted):
    """Возвращает (новый watermark, опоздало ли событие)."""
    sensor_id = payload["sensor_id"]
    event_time = payload["event_time"]
    value = payload["value"]
    window_start = (event_time // WINDOW_SIZE_SEC) * WINDOW_SIZE_SEC
    window_end = window_start + WINDOW_SIZE_SEC
    key = f"{sensor_id}|{window_start}"

    if window_end  watermark:
        watermark = event_time - LATENESS_SEC
        close_windows(state, watermark, emitted)

    return watermark, False


def main():
    parser = argparse.ArgumentParser()
    parser.add_argument("--crash-after", type=int, default=None,
                         help="имитировать падение после N сообщений с начала всего прогона")
    parser.add_argument("--expected-count", type=int, default=14,
                         help="сколько всего событий в демо-потоке")
    args = parser.parse_args()

    checkpoint = load_checkpoint()
    if checkpoint is not None:
        state = checkpoint["state"]
        watermark = checkpoint["watermark"]
        emitted = set(checkpoint["emitted"])
        late_dropped = checkpoint["late_dropped"]
        processed_count = checkpoint["processed_count"]
        resume_offset = checkpoint["offset"] + 1
        print(f"восстановление из чекпоинта: offset={resume_offset}, "
              f"watermark={watermark}, обработано ранее={processed_count}")
    else:
        state, watermark, emitted = {}, -1_000_000, set()
        late_dropped, processed_count = 0, 0
        resume_offset = 0
        print("чекпоинта нет, старт с начала топика")

    consumer = Consumer({
        "bootstrap.servers": BOOTSTRAP,
        "group.id": "stream-processing-demo",
        "enable.auto.commit": False,
    })
    consumer.assign([TopicPartition(TOPIC, 0, resume_offset)])

    last_offset = resume_offset - 1
    idle_polls = 0
    try:
        while processed_count  15:
                    print("простой топика дольше ожидаемого, останавливаюсь", file=sys.stderr)
                    break
                continue
            idle_polls = 0
            if msg.error():
                print(f"ошибка consumer: {msg.error()}", file=sys.stderr)
                continue

            payload = json.loads(msg.value().decode("utf-8"))
            watermark, was_late = process_event(payload, state, watermark, emitted)
            if was_late:
                late_dropped += 1
            last_offset = msg.offset()
            processed_count += 1
            save_checkpoint(last_offset, state, watermark, emitted, late_dropped, processed_count)

            if args.crash_after is not None and processed_count >= args.crash_after:
                print(f"имитация падения после {processed_count} сообщений "
                      f"(чекпоинт уже на диске на offset={last_offset})")
                sys.exit(1)

        if processed_count >= args.expected_count:
            # конец потока: сдвигаем watermark на +бесконечность и закрываем всё, что осталось
            print("конец потока, финальный флаш оставшихся окон")
            close_windows(state, float("inf"), emitted)
            save_checkpoint(last_offset, state, float("inf"), emitted, late_dropped, processed_count)

        print(f"итого: обработано={processed_count}, опоздавших и отброшенных={late_dropped}, "
              f"окон закрыто={len(emitted)}, окон осталось открытыми={len(state)}")
    finally:
        consumer.close()


if __name__ == "__main__":
    main()
Ключевые строки прогона выглядят так.
отправлено 14 событий в 'stream_processing_events' за 0.010 с
[emit] sensor=s1 window=[0,10) count=3 avg=21.33 watermark=10
[emit] sensor=s2 window=[0,10) count=2 avg=15.50 watermark=10
[late-drop] sensor=s1 event_time=3 value=19.5 window=[0,10) уже закрыто при watermark=10
имитация падения после 8 сообщений (чекпоинт уже на диске на offset=7)
код возврата процессора (1 = ожидаемая имитация падения): 1
восстановление из чекпоинта: offset=8, watermark=10, обработано ранее=8
[emit] sensor=s1 window=[10,20) count=1 avg=22.00 watermark=20
[emit] sensor=s3 window=[20,30) count=1 avg=31.00 watermark=40
конец потока, финальный флаш оставшихся окон
[emit] sensor=s1 window=[40,50) count=1 avg=26.00 watermark=inf
итого: обработано=14, опоздавших и отброшенных=2, окон закрыто=9, окон осталось открытыми=0
Первый запуск падает по —crash-after=8 сразу после того, как закрылись первые два окна для датчиков s1 и s2, чекпоинт к этому моменту уже на диске на offset=7. Второй запуск стартует не с начала топика, а с восстановленного offset=8 и watermark=10, повторно эти окна не считает. Опоздавшее событие s1 с event_time=3 отбрасывается, потому что окно [0,10) для него уже закрыто watermark=10, а резкий скачок события с event_time=45 сразу поднимает watermark до 40 и закрывает окно [20,30), не дожидаясь отдельного тика. Тот же state backend, аллайнмент барьеров и оконный API на практике уже реализованы в Apache Flink, познакомиться с ними ближе поможет курс по потоковой обработке данных на Apache Flink.
Заключение
Потоковая обработка данных решает задачу, которую пакетная обработка решить не может по определению, даёт актуальный результат над входом, у которого нет конца. У этого есть цена, три механизма, разобранных выше. Состояние (state) помнит контекст между событиями, checkpointing и барьеры потока восстанавливают этот контекст после сбоя без потерь и дублей, а watermark решает, когда можно доверять результату, несмотря на то что события идут не по порядку. Современные движки вроде Flink стирают границу с batch на уровне API, но не на уровне цены эксплуатации, и заводить постоянно работающий кластер с состоянием имеет смысл там, где непрерывность результата действительно нужна.
Референсные ссылки
- Apache Flink Documentation, Stateful Stream Processing, состояние, state backends, checkpointing, барьеры, savepoints, восстановление после сбоя
- Apache Flink Documentation, Timely Stream Processing, event time, processing time, определение watermark и обработка опоздавших событий
- Confluent Documentation, Batch and Stream Processing, унификация batch и stream, bounded поток как частный случай unbounded
- Confluent Documentation, Apache Flink Concepts, базовая модель sources, transformations, sinks