 1
Содержание
- Что такое Exactly-Once Semantics и зачем она нужна
- Как устроена EOS в Kafka и во Flink
- Идемпотентный producer и транзакции в Kafka
- Checkpointing и двухфазный commit во Flink
- Принцип работы под капотом
- Границы применимости и подводные камни
- Сравнение гарантий доставки
- Когда применять EOS, а когда не стоит
- Практика
- Заключение
- Референсные ссылки
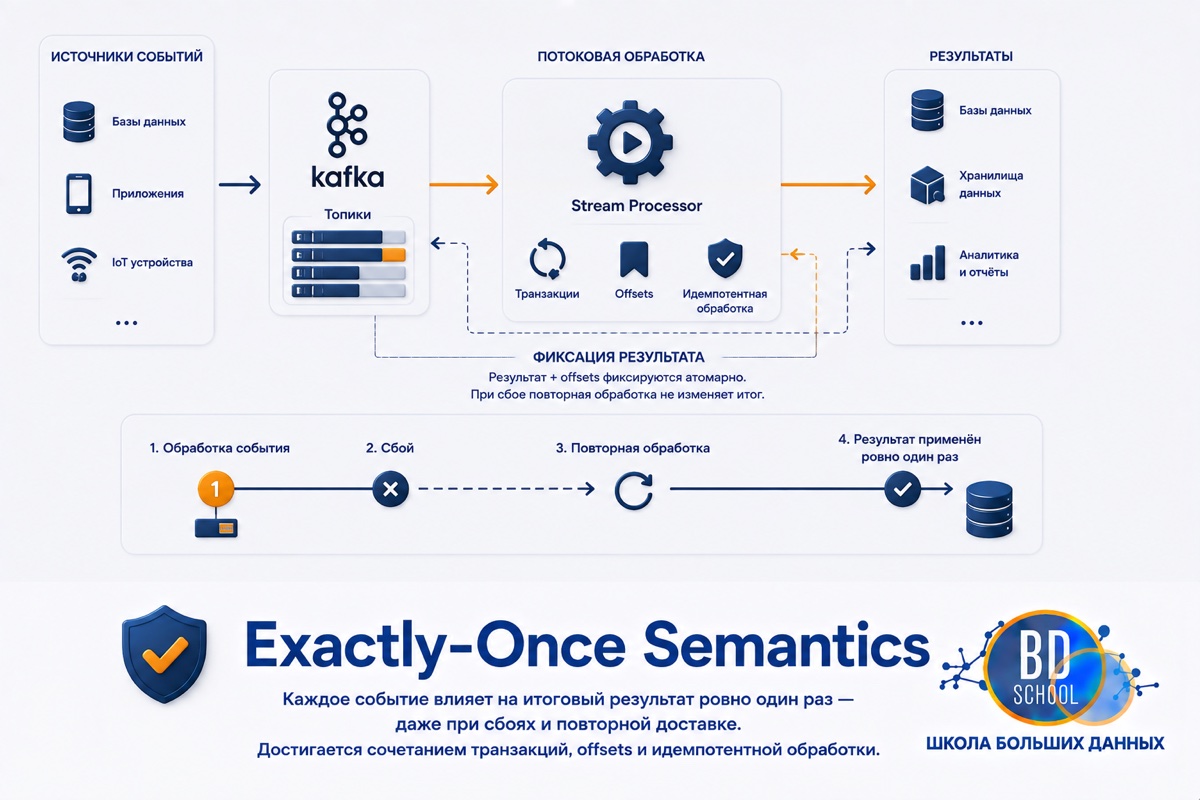
Exactly-Once (Exactly-Once семантика, EOS) это класс гарантий доставки в потоковых системах, при котором каждое сообщение обрабатывается ровно один раз, без потерь и без дублей, даже если часть системы падает в процессе. Термин описывает не отдельный продукт с версией, а свойство, которое разные системы реализуют по-разному. Apache Kafka строит его на идемпотентном producer и транзакциях, Apache Flink на checkpointing и двухфазном commit во внешний приёмник, разбор ниже смещён на эти два механизма как самые задокументированные и распространённые в конвейерах Big Data.
Что такое Exactly-Once Semantics и зачем она нужна
У доставки сообщений в распределённой системе есть три классических исхода. At-most-once сообщение может потеряться, но никогда не задвоится. At-least-once сообщение гарантированно дойдёт, но может прийти повторно при ретрае. Exactly-once убирает оба риска сразу, для этого система должна дедуплицировать повторные записи и координировать фиксацию через несколько узлов как одну операцию.
Официальная документация Confluent формулирует гарантию так: «each message is delivered once and only once, messages are never lost or read twice even if some part of the system fails». Та же страница предупреждает, что вендорские заявления об exactly-once не всегда означают сквозную гарантию через произвольные внешние системы: обычно она действует в границах самой системы, например только Kafka в Kafka, а end-to-end гарантия через сторонний приёмник требует поддержки транзакций на его стороне.
Как устроена EOS в Kafka и во Flink
Обе системы решают одну задачу тремя механизмами. Дедупликация на входе не пускает дубль в лог, атомарная фиксация на выходе делает запись в несколько мест неделимой операцией, а восстановление после сбоя возвращает систему в последнюю согласованную точку. Реализации разные, поэтому ниже они разобраны по отдельности.
Идемпотентный producer и транзакции в Kafka
Идемпотентность в Kafka построена на паре (producer ID, sequence number). Брокер выдаёт продюсеру уникальный producer ID при подключении, и на каждое сообщение продюсер добавляет порядковый номер по партиции. Если сообщение приходит на брокер повторно с уже виденным номером последовательности, брокер отбрасывает дубликат и не пишет его в лог второй раз, а порядок записи не нарушается. Механизм появился вместе с транзакциями в Kafka 0.11.0.0 и с тех пор остаётся базой EOS в Kafka.
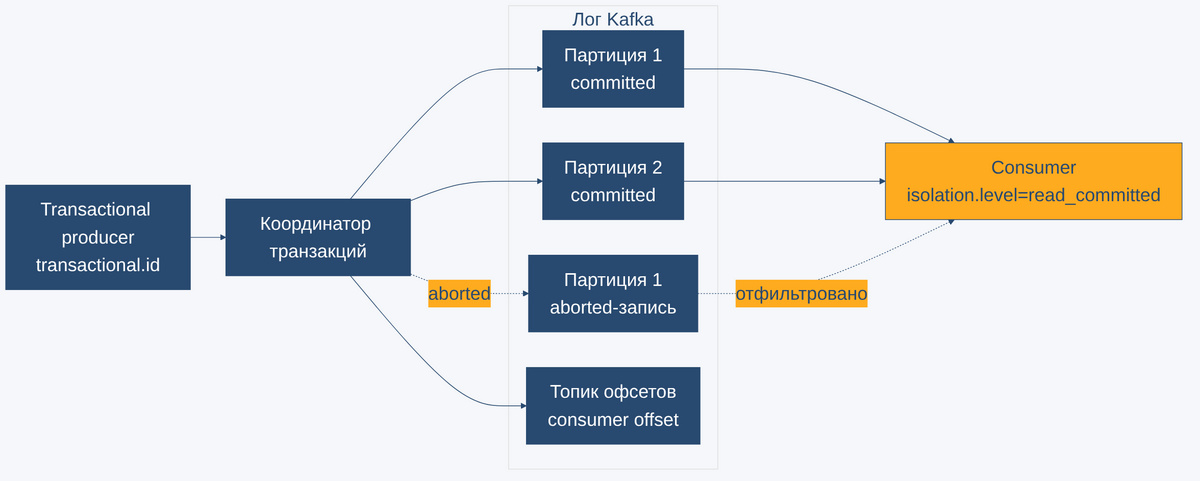
Транзакции добавляют вторую опору. Producer с заданным transactional.id может атомарно записать сообщения сразу в несколько партиций и топиков, коммит либо проходит целиком, либо откатывается целиком. Для сценария «прочитал из одного топика, обработал, записал в другой», характерного для Kafka Streams, offset читателя записывается в служебный топик офсетов в той же транзакции, что и результат обработки, поэтому чтение и запись не могут разойтись при сбое между ними. Практический разбор такой публикации собран в статье «Транзакции в Apache Kafka: атомарность публикации сообщений».
Прочитать результат транзакции можно двумя способами в зависимости от isolation.level у consumer’а. Read_committed отдаёт только записи из зафиксированных транзакций и пропускает отменённые (aborted). Read_uncommitted, поведение по умолчанию, отдаёт все физически записанные сообщения независимо от исхода. Разница видна в демо ниже по числу прочитанных записей на одном логе. Семантикам доставки посвящён курс «Apache Kafka для инженеров данных».
Apache Kafka для инженеров данных
Код курса
DEVKI
Ближайшая дата курса
12 октября, 2026
Продолжительность
24 ак.часов
Стоимость обучения
76 800
Checkpointing и двухфазный commit во Flink
Отказоустойчивость Flink держится на непрерывных распределённых снапшотах состояния, а не на журнале транзакций, как в Kafka. Checkpoint coordinator периодически вставляет в источники барьеры (checkpoint barriers), маркеры, которые двигаются по графу выполнения вместе с записями и никогда их не обгоняют. Оператор, дождавшийся барьера от всех входных каналов, делает снапшот своего состояния в state backend и пропускает барьер дальше. Когда барьер прошёл весь граф, checkpoint считается завершённым и становится точкой, к которой можно откатиться при сбое.
Этого достаточно для exactly-once внутри самого Flink, но не для сквозной гарантии через внешний приёмник, у которого своей истории снапшотов нет. Для end-to-end EOS Flink с версии 1.4.0 использует двухфазный commit (2PC) через абстрактный класс TwoPhaseCommitSinkFunction с четырьмя обязательными методами. beginTransaction открывает транзакцию во внешней системе, preCommit готовит транзакцию к фиксации при снапшоте, ещё допуская отмену, но уже гарантируя успешный повторный коммит, commit фиксирует её только после глобального подтверждения checkpoint, либо abort откатывает при сбое, а запись данных делает invoke, не входящий в эту четвёрку. Источником обычно выступает переигрываемая (replayable) система вроде Kafka, приёмником любое хранилище с транзакционной или идемпотентной записью. Пошаговый разбор такого пайплайна собран в статье «Строго однократная доставка сообщений в потоковой обработке данных с Apache Flink и Kafka».
TwoPhaseCommitSinkFunction отмечен в Javadoc актуальной ветки Flink как устаревший (deprecated) начиная с версии 2.0, документация прямо указывает, что интерфейс будет удалён в пользу нового Sink из пакета org.apache.flink.api.connector.sink2. Протокол из четырёх шагов при этом не изменился по сути, только переехал в другой программный интерфейс.

Потоковая обработка данных с помощью Apache Flink
Код курса
FLINK
Ближайшая дата курса
22 декабря, 2026
Продолжительность
16 ак.часов
Стоимость обучения
51 200
Принцип работы под капотом
Оба механизма отвечают на общий вопрос распределённых систем, как согласовать несколько независимых узлов так, чтобы либо все они зафиксировали изменение, либо ни один. У Kafka узел один, кластер брокеров с общим логом, поэтому координация сводится к атомарной записи через координатора транзакций. У Flink узлов много, это граф операторов на разных процессах, и координация требует согласованного снимка состояния всего графа сразу. Подход Flink здесь, по официальной документации, вариант алгоритма согласованных снапшотов Chandy-Lamport (K. Mani Chandy и Leslie Lamport, 1985), адаптированного под потоковую модель, барьеры движутся по тем же каналам, что и данные, поэтому граф вычислений не останавливается на время снимка.
Гарантия exactly-once не устраняет сбои и ретраи сама по себе, она делает их безопасными. Ретрай в Kafka не создаёт дубль благодаря дедупликации по sequence number, а перезапуск оператора Flink не создаёт дубль благодаря откату к последнему снапшоту и переигрыванию входа с той же позиции. Разница в реализации, а не в идее.
Границы применимости и подводные камни
EOS не бесплатна, документация обеих систем прямо очерчивает границы гарантии.
- Kafka работает в границах своего кластера. Базовая гарантия действует для записи Kafka в Kafka, для внешних систем нужен коннектор с собственной идемпотентностью на стороне приёмника, иначе заявленная «exactly-once» превращается в at-least-once на последнем шаге.
- Flink не даёт гарантию для итеративных джобов. Джобы с циклами в графе выполнения по умолчанию не получают processing guarantees. Чекпоинтинг для них можно включить принудительно флагом force=true, но записи «в полёте» на рёбрах цикла будут потеряны при сбое.
- Checkpoint во Flink ограничен по времени и параллелизму. Тайм-аут по умолчанию 10 минут, а в exactly-once режиме допускается только один одновременный checkpoint.
- Координация стоит латентности. Aligned checkpoint ждёт барьер от каждого входного канала и тормозит под backpressure, unaligned снимает это ценой сложности восстановления, а транзакции Kafka добавляют накладные расходы на каждый коммит. Там, где допустимы редкие дубли, чаще выбирают at-least-once с идемпотентным потребителем.
Ни одно из ограничений не делает EOS непригодной, но каждое сужает область, где гарантия работает «из коробки».
Сравнение гарантий доставки
Три гарантии доставки решают одну и ту же задачу с разным балансом цены и надёжности, таблица ниже сводит их по ключевым признакам.
| Критерий | At-most-once | At-least-once | Exactly-once |
|---|---|---|---|
| Риск потери сообщения | Есть, при сбое между отправкой и подтверждением | Отсутствует, отправитель повторяет до подтверждения | Отсутствует, как и в at-least-once |
| Риск дубля | Отсутствует, повтора нет в принципе | Есть, ретрай может доставить сообщение повторно | Отсутствует, ретраи дедуплицируются или откатываются |
| Механизм | Fire-and-forget, без ретраев и подтверждений | Ретраи с подтверждением (ack), без дедупликации | Идемпотентность и/или транзакции, координация фиксации |
| Латентность и цена координации | Минимальная | Низкая, ретраи почти не заметны | Выше, синхронизация и фиксация состояния стоят времени |
| Типичный сценарий | Метрики и логи, где потеря единичного значения не критична | Большинство пайплайнов с идемпотентной обработкой на потребителе | Финансовые операции, биллинг, любой счётчик, где дубль или потеря меняют итог |
Табличное сравнение показывает компромисс, а не превосходство. At-least-once с идемпотентным потребителем часто даёт тот же практический результат, что и exactly-once, но дешевле по координации, если потребителя несложно сделать идемпотентным самостоятельно.
Когда применять EOS, а когда не стоит
Exactly-once оправдана там, где дубль или потеря меняют бизнес-результат, а не просто засоряют лог. Биллинг и финансовые транзакции, где повторное списание или пропущенный платёж это инцидент. Счётчики и агрегаты, от остатков на складе до баланса счёта, где сложение одного события дважды даёт неверную цифру без явной ошибки в логах.
Там, где потребителя дёшево сделать идемпотентным самому, например upsert вместо insert по бизнес-ключу, транзакционные расходы Kafka или снапшоты Flink это цена без соразмерной выгоды. То же касается метрик и логов, где единичная потеря или дубль не влияют на агрегат за период.
Практика
По традиции весь код используемый в статье выкладываем на наш GitHub репозиторий
Демо показывает обе опоры EOS в Kafka на одном брокере apache/kafka 4.3.0 в режиме KRaft. Клиент confluent-kafka 2.15.0, топик exactly_once_semantics_events с тремя партициями создаётся явно командой kafka-topics.sh —create. Flink не поднимается, кластер ради одной демонстрации барьеров избыточен, а двухфазный commit уже разобран выше.
Первый скрипт показывает идемпотентность на реальном ретрае уровня протокола. Брокер замораживается командой docker pause на 6 секунд сразу после отправки, а таймаут запроса продюсера короче паузы, поэтому клиент гарантированно уходит в ретрай, а не просто ждёт отложенный ответ.
# confluent-kafka 2.15.0, Apache Kafka 4.3.0 в KRaft (стенд exactly_once_semantics_kafka), прогнано на стенде 2026-08-31
"""Идемпотентный producer: реальный ретрай на уровне протокола не создаёт дубль в логе."""
import subprocess
import threading
import time
from confluent_kafka import Consumer, Producer, TopicPartition

BROKER = "localhost:9092"
TOPIC = "exactly_once_semantics_events"
PARTITION = 0
CONTAINER = "exactly_once_semantics_kafka"
KEY = b"order-idempotent-demo"
FREEZE_SECONDS = 6.0  # дольше request.timeout.ms ниже, чтобы вызвать настоящий таймаут запроса


def freeze_broker() -> None:
    """`docker pause` останавливает процессы в контейнере: брокер не отвечает, но TCP-сессия жива -
    клиент не видит разрыв соединения, а именно таймаут ответа на конкретный запрос."""
    subprocess.run(["docker", "pause", CONTAINER], check=True)


def unpause_after(seconds: float) -> None:
    time.sleep(seconds)
    subprocess.run(["docker", "unpause", CONTAINER], check=True)


def produce_through_freeze() -> tuple[int, float]:
    freeze_broker()
    unfreeze = threading.Thread(target=unpause_after, args=(FREEZE_SECONDS,))
    unfreeze.start()

    producer = Producer({
        "bootstrap.servers": BROKER,
        "enable.idempotence": True,  # PID продюсера + порядковый номер на партицию защищают от дублей при ретрае
        "acks": "all",
        "message.timeout.ms": 25000,  # общий бюджет доставки, должен пережить заморозку
        "request.timeout.ms": 2000,   # короче заморозки: запрос гарантированно уйдёт в ретрай
        "retry.backoff.ms": 500,
    })

    delivered = []

    def on_delivery(err, msg):
        if err is not None:
            print(f"ОШИБКА доставки: {err}")
            return
        delivered.append((msg.partition(), msg.offset()))

    t0 = time.time()
    producer.produce(TOPIC, key=KEY, value=b"payload", partition=PARTITION, on_delivery=on_delivery)
    producer.flush(25)  # блокируется, пока брокер заморожен, и отпускает ретраи после разморозки
    elapsed = time.time() - t0

    unfreeze.join()
    if not delivered:
        raise RuntimeError("сообщение не доставлено - проверьте, поднят ли брокер")
    return delivered[0][1], elapsed


def count_records_with_key() -> int:
    """Читает партицию с начала и считает записи с нашим ключом - с идемпотентностью должна быть ровно одна."""
    consumer = Consumer({
        "bootstrap.servers": BROKER,
        "group.id": "idempotent-demo-check",
        "auto.offset.reset": "earliest",
        "enable.auto.commit": False,
    })
    consumer.assign([TopicPartition(TOPIC, PARTITION, 0)])
    count, idle = 0, 0
    while idle  None:
    print(f"замораживаем брокер на {FREEZE_SECONDS:.0f} с и отправляем сообщение с idempotence=True")
    offset, elapsed = produce_through_freeze()
    print(f"доставлено на оффсет {offset} за {elapsed:.2f} с "
          f"(время близко к {FREEZE_SECONDS:.0f} с - доставка ждала ретраев, пока брокер был заморожен)")

    count = count_records_with_key()
    print(f"записей с ключом {KEY.decode()!r} в логе: {count}")
    print("дублей нет - ретраи под капотом идемпотентны" if count == 1
          else f"ВНИМАНИЕ: обнаружены дубли ({count})")


if __name__ == "__main__":
    main()
Второй скрипт коммитит одну транзакцию и откатывает другую, а затем читает лог дважды с разным isolation.level.
# confluent-kafka 2.15.0, Apache Kafka 4.3.0 в KRaft (стенд exactly_once_semantics_kafka), прогнано на стенде 2026-08-31
"""Транзакционный producer: атомарная запись в несколько партиций, consumer с read_committed
не видит записи из отменённой транзакции - то, что в логе видно, зависит от isolation.level."""
from confluent_kafka import Consumer, Producer, TopicPartition

BROKER = "localhost:9092"
TOPIC = "exactly_once_semantics_events"
COMMITTED_PARTITIONS = (1, 2)  # одна транзакция атомарно пишет в обе партиции
ABORTED_PARTITION = 1


def run_transactions() -> None:
    producer = Producer({
        "bootstrap.servers": BROKER,
        "transactional.id": "exactly-once-demo-txn",
        "enable.idempotence": True,  # транзакции в Kafka построены поверх идемпотентного producer
    })
    producer.init_transactions()  # регистрирует producer в координаторе транзакций, получает PID

    # транзакция 1: атомарная запись в две партиции, фиксируется
    producer.begin_transaction()
    for partition in COMMITTED_PARTITIONS:
        producer.produce(TOPIC, key=b"committed", value=f"committed-p{partition}".encode(), partition=partition)
    producer.flush()
    producer.commit_transaction()
    print(f"транзакция 1 закоммичена: записи в партициях {COMMITTED_PARTITIONS}")

    # транзакция 2: имитация сбоя обработки после записи - откатываем
    producer.begin_transaction()
    producer.produce(TOPIC, key=b"aborted", value=b"aborted-message", partition=ABORTED_PARTITION)
    producer.flush()
    producer.abort_transaction()
    print(f"транзакция 2 отменена: запись в партиции {ABORTED_PARTITION} помечена aborted")


def read_partitions(isolation_level: str) -> list[tuple[int, bytes, bytes]]:
    """Партиции читаются с нуля отдельной группой на каждый isolation.level, чтобы прогоны не влияли друг на друга."""
    consumer = Consumer({
        "bootstrap.servers": BROKER,
        "group.id": f"txn-demo-check-{isolation_level}",
        "auto.offset.reset": "earliest",
        "enable.auto.commit": False,
        "isolation.level": isolation_level,
    })
    consumer.assign([TopicPartition(TOPIC, p, 0) for p in set(COMMITTED_PARTITIONS + (ABORTED_PARTITION,))])
    seen, idle = [], 0
    while idle  None:
    run_transactions()

    for level in ("read_committed", "read_uncommitted"):
        records = read_partitions(level)
        keys = sorted(k.decode() for _, k, _ in records)
        print(f"\nisolation.level={level}: прочитано записей {len(records)}, ключи {keys}")
        has_aborted = any(k == b"aborted" for _, k, _ in records)
        print(f"  запись из отменённой транзакции видна: {has_aborted}")


if __name__ == "__main__":
    main()
Ключевые строки прогона выглядят так.
замораживаем брокер на 6 с и отправляем сообщение с idempotence=True
доставлено на оффсет 0 за 7.07 с (время близко к 6 с - доставка ждала ретраев, пока брокер был заморожен)
записей с ключом 'order-idempotent-demo' в логе: 1
дублей нет - ретраи под капотом идемпотентны

транзакция 1 закоммичена: записи в партициях (1, 2)
транзакция 2 отменена: запись в партиции 1 помечена aborted
isolation.level=read_committed: прочитано записей 2, ключи ['committed', 'committed']
  запись из отменённой транзакции видна: False
isolation.level=read_uncommitted: прочитано записей 3, ключи ['aborted', 'committed', 'committed']
  запись из отменённой транзакции видна: True
Доставка заняла 7.07 с, близко к 6-секундной заморозке, потому что flush() ждал разморозки и ретраев. В логе ровно одна запись с ключом order-idempotent-demo, дублей нет. Демо показывает, что реальный ретрай не создаёт дубль благодаря идемпотентности, а не то, что дубль обязательно возник бы без неё. Настоящий дубль появляется, когда подтверждение брокера теряется уже после физической записи в лог, а это манипуляция на сетевом уровне ниже TCP-таймаута, которую стенд не воспроизводит.
Во втором скрипте isolation.level=read_committed вернул две записи с ключом committed и не увидел запись из отменённой транзакции. isolation.level=read_uncommitted вернул все три, включая запись с ключом aborted, физически она в логе, но помечена как часть отменённой транзакции. Разница в одну запись на одном логе при разных настройках consumer’а и есть весь механизм read_committed в действии.
Заключение
Exactly-once семантика не система с собственной версией, а гарантия, которую Kafka и Flink реализуют разными средствами поверх общей идеи. Дедупликация убирает дубли на входе, атомарная фиксация через транзакции или checkpoint убирает половинчатые состояния на выходе, а восстановление из согласованного снимка возвращает систему в целую точку после сбоя. Ни один из механизмов не бесплатен, поэтому EOS стоит проверять по цене ошибки, а не включать по умолчанию. Там, где дубль или потеря меняют реальную цифру, цена оправдана, там, где потребителя легко сделать идемпотентным самому, at-least-once даёт тот же результат дешевле.
Референсные ссылки
- Confluent Documentation, Message Delivery Guarantees, определение EOS, идемпотентный producer, транзакции, isolation.level
- Apache Flink Documentation, Checkpointing, checkpoint coordinator, барьеры, ограничение для итеративных джобов, тайм-ауты
- Apache Flink Blog, An Overview of End-to-End Exactly-Once Processing, двухфазный commit и TwoPhaseCommitSinkFunction для end-to-end EOS с Kafka
- Apache Flink 2.0 Javadoc, Deprecated List, статус TwoPhaseCommitSinkFunction, замена на интерфейс Sink
- Apache Flink 1.16 Javadoc, TwoPhaseCommitSinkFunction, методы beginTransaction, preCommit, commit, abort